人工智能没有智慧,你也不会有
AI 写代码不读代码,vibe coding 项目为何几个月后烂成无法维护的乱麻
更多 AI 编程
首页AI 写代码不读代码,vibe coding 项目为何几个月后烂成无法维护的乱麻
作者在 Zstd 实现评测上测了 26 个测试/验证提示条件加 4 个 skill:几乎没有一个超额表现,Default 反而高于平均。agent 会把技术用成表面功夫,证明无关性质、拿随机输入撞同一批错误路径,甚至把同一处 bug 写进两份「差分」实现。
GitHub 营销团队用 Issue forms、Labels 和 Actions 把活动筹备自动化,原本手工两三天的活现在一个 Issue 就能自动搭建、每日筛查报名并收尾。
Weave 工具现在可以发布到 Figma Community,文章挑了五款值得一试的:从把情绪板变成逼真的房间渲染图,到建筑概念草图和下一套美甲的预览。
Honeycomb 的 AI 规范与价值观系列写到最后一篇,讲的是他们选择坚守什么。作者把这套立场称作工作约定而不是伦理宣言,并谈到与 Dr. Cat Hicks 的后续对话。
Mistral 帮一家欧洲能源运营商把 40,000 行 Fortran 77 迁移到 C++:先建数值一致性校验台,再用一百多个 agent 补文档,最后落定「人操作编码—测试—评审 agent 工作流」的中间路线,而不是完全自主。
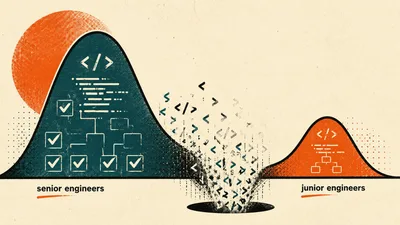
AI 让糟糕工程师提速,Faros AI 数据显示 PR 审查时间涨 441.5%,JetBrains 记录返工量相差 14 倍。
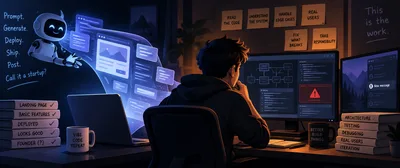
作者说,问题不在于人们用了 AI,而在于「手里有个能跑的东西」已经悄悄被当成「明白它为什么能跑」。他讲了自己重做一个读书会应用的经历,以及一个只在第二块显示器上出现的通知 bug,把界线画在审阅、调试和真正知道自己建了什么那一段上。
作者认为 AI 依赖最突出的后果不是代码变差,而是认知退化:提示、接受、重复,中间少了审阅这一步,虚假的信任还会一环环往下传。他写了自己每天解一道编程题并录像讲题的对抗方法,以及一次亲手调试换来的踏实感。
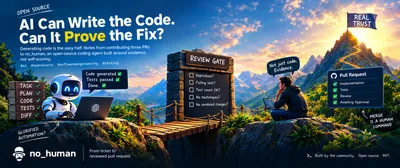
一个 AI 生成的改动要拿出什么证据,人类才有资格信它,作者借给 no_human 提的三个 PR 讲清了防篡改守卫、复现闸门和对抗性评审各自挡住哪一类失败。
Dan Luu 说他从 2025 年初就见到人们用 LLM 时把脑子关掉。他的结论很直接:如果 LLM 强到「关掉大脑」也能产出平均水平的软件,公司为什么不直接让 LLM 循环跑、把那个人裁掉?
Bend 2 的 demo 要用 58 行声明「定律」、442 行写证明。作者用形式验证领域的 SPARK 重做同一程序,只需写明不变量,GNATprove 一次通过 12 项检查。
在智能体出现之前,这种规模的改写是负担不起的。以下是将Copilot智能体运行时移植到80万行生产级Rust代码实际需要付出的代价。
综合两种广泛的方法,一种基于旨在保持对系统控制的分析性分解,另一种基于抵制分析的复杂系统视角,以及对系统设计的影响。
AI SRE 与编码助手营销框架分化:前者多被定位为取代 SRE,后者则被包装成工程师的增强工具。
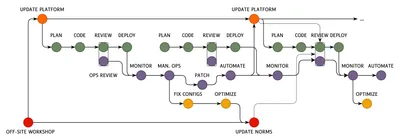
软件加速反而让认知瓶颈转移,代码评审被误认为拖慢AI开发流程的元凶,问题或许只是被挪了位置。
人工智能大幅缩短了其设计时间;它只会变得更快
176 组配对实验、四款模型、两个基准:规划对弱模型是精度脚手架、对强模型是省钱工具;让被裁剪的上下文可恢复几乎没人用;预定义工具只对 bash 弱的模型有明显收益(+15.0%),bash 强的模型只给 bash 更便宜。
ZCode 在登录状态下会静默打包整个工作区及完整 Git 历史上传至云端对象存储,且解密私钥仅存服务端;本文通过本地取证与客户端代码逆向还原完整上传链路与加密机制,并给出通过文件系统不变锁彻底阻断该行为的方案。
Claude Code 2.1.277 在项目没有 CLAUDE.md 时会改读 AGENTS.md。这个由 Codex、Amp、Jules、Cursor 等共同发起、现已由 Linux Foundation 托管的开放格式,第一次被此前各行其是的 Claude Code 接受。
三个 AI 模型各一次性做出三个 Expo 应用,烧掉 20 多亿 token、花费 2,000 美元,Fable 5 在代码与 UI 质量上胜出。