AI能写代码,但能证明修复有效吗?
一个 AI 生成的改动要拿出什么证据,人类才有资格信它,作者借给 no_human 提的三个 PR 讲清了防篡改守卫、复现闸门和对抗性评审各自挡住哪一类失败。
中文
复制
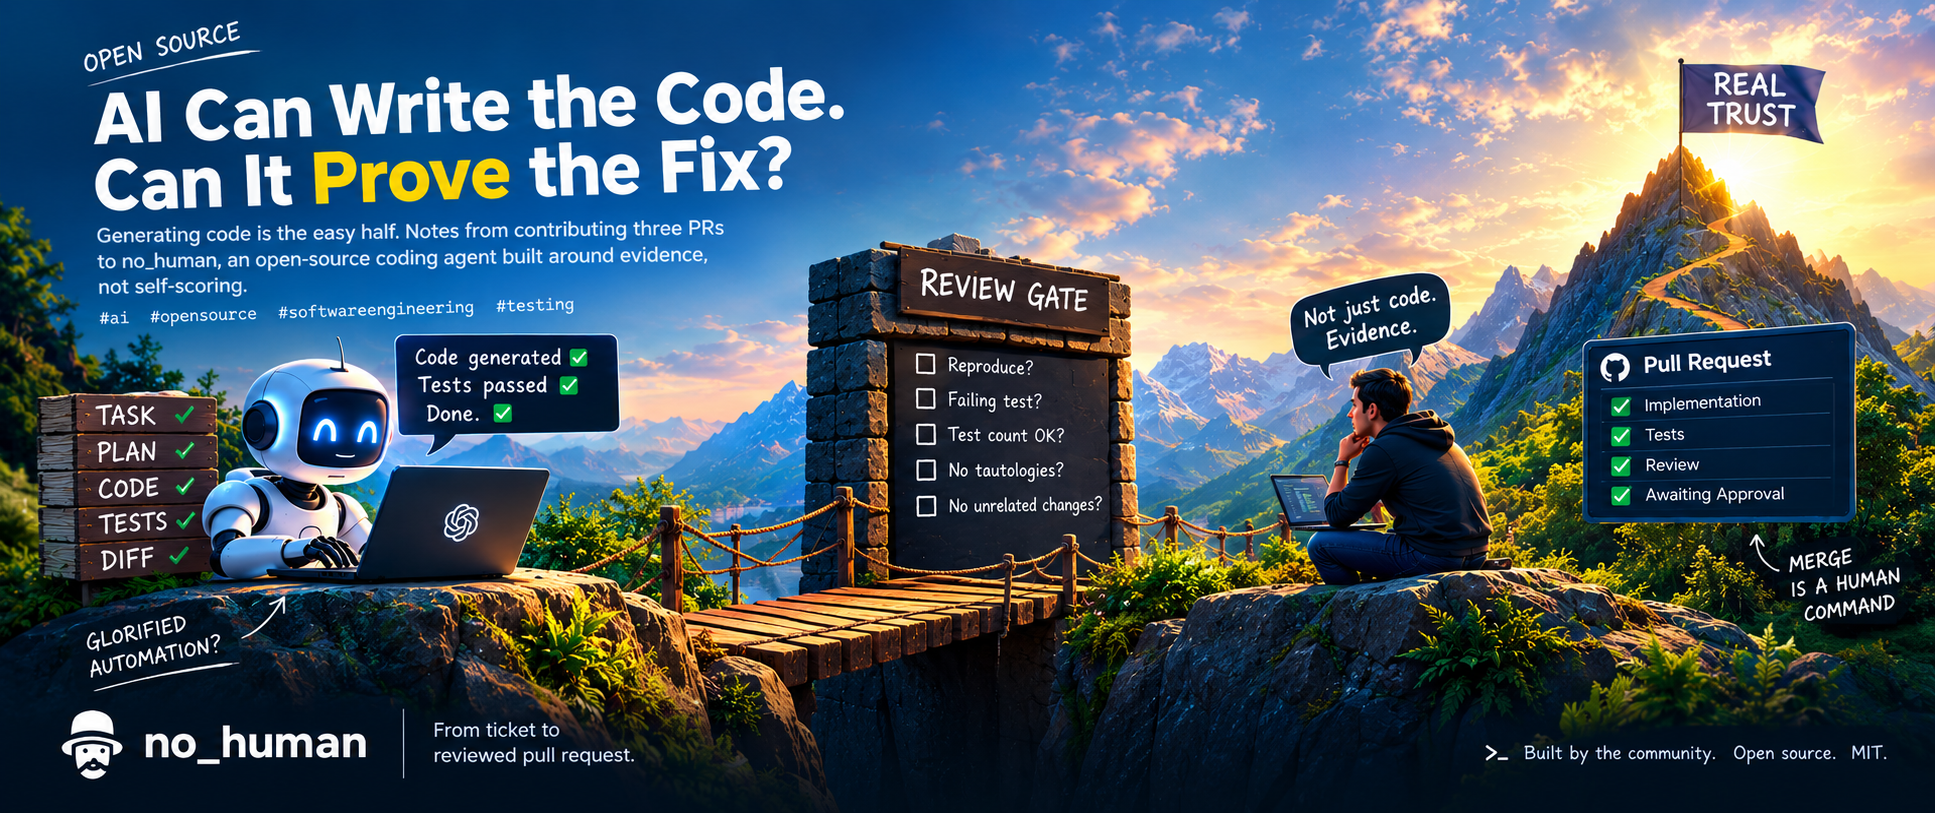
自主编码智能体最贵的产出不是构建失败。构建失败是免费的:CI 变红,你继续干活。
贵的是那个绿色的、但错误的 diff。它消耗掉评审、合并、部署,然后三周后的某个下午,有人 bisect 到它,再消耗一遍。
而智能体制造这种产物的方式简单得令人沮丧。它写一个改动,跑测试。有一个测试碍事。它改测试。全绿。它说 done。
这一串动作里,严格来说没有哪一步是谎言。每一步疲惫的人类也会做。区别在于,人这么做的时候,会有另一个人读 diff,问一句这个断言为什么改了? 而智能体凌晨三点在任务队列里这么做的时候,没人问。
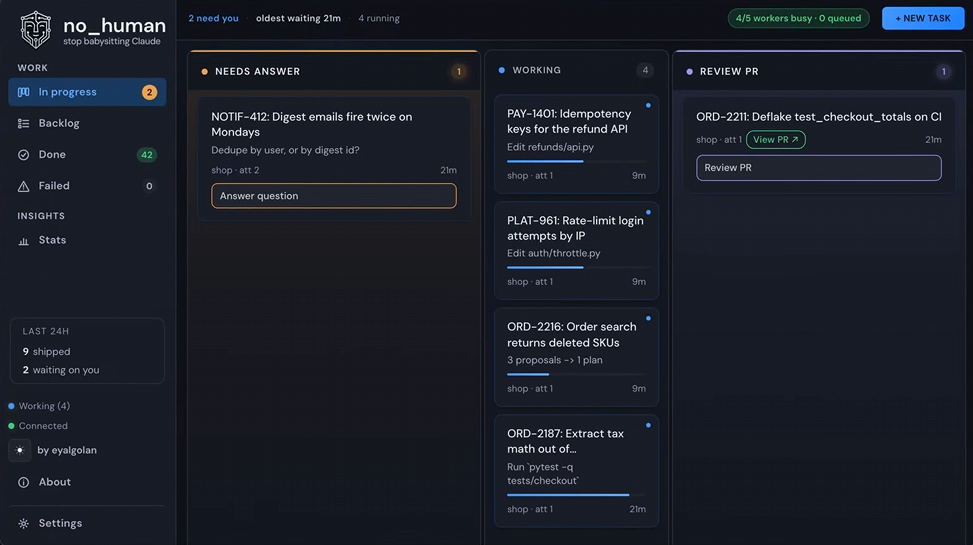
所以我感兴趣的问题不是「AI 能不能写代码」。这已经有答案了。问题是:
AI 生成的改动要拿出什么,人类才有资格信任它?
我找到一个试图具体回答这个问题的项目,给它提了三个 PR,在评审里被拆得体无完肤,到现在还在想这件事。以下是我的收获。
代码生成不等于验证
真实工程工作的形状是这样的:
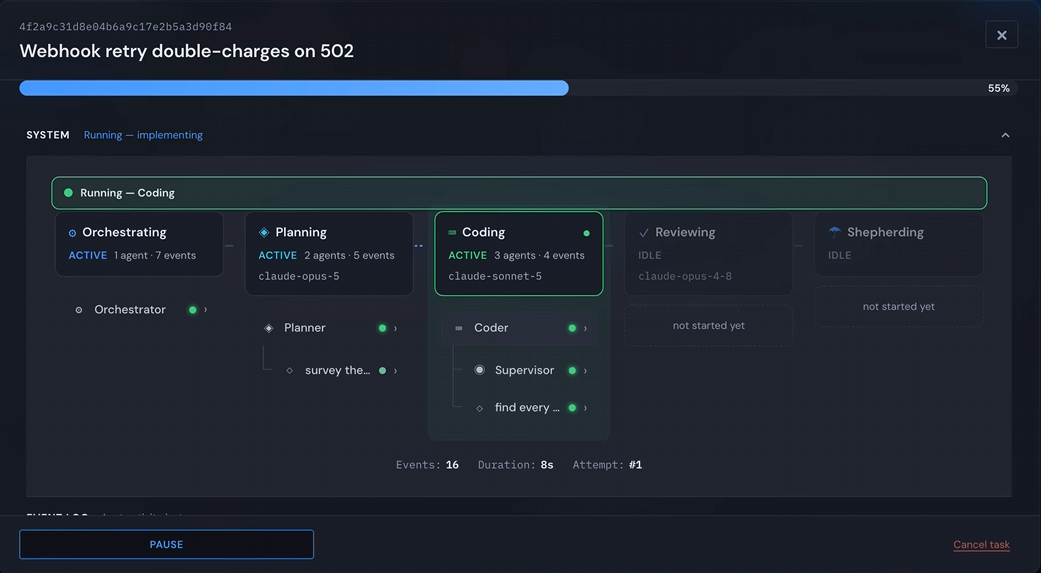
中间那些环节不是仪式。每跳过一步,就有一类特定的缺陷没人接住。
设想一个工单:「修复任务标题包含非拉丁字符时的崩溃。」(这是一类真实存在的 bug——我要描述的这个项目,v0.2.4 在 Windows 上修的正是这个。)
智能体产出一个 diff。diff 碰了编码路径。测试通过。能发吗?
你答不了,因为你不知道:
- 有没有一个测试复现了这个崩溃? 如果没有,那到底什么证明了修复?
- 这个测试在旧代码上会失败吗? 如果两棵树上都通过,它对 bug 没有任何证明力。
- 测试数量减少了吗? 一个修了 bug 又悄悄删掉四个无关测试的改动,是两个改动。
- 有没有断言变成了恒真式?
assert result == result永远绿。 - 有没有无关行为被改变? 编码修复最爱顺手改行尾。
注意,这些问题没有一个是关于代码本身的。它们问的是代码周边的证据。而一个给自己的产出打分的 agent,存在结构性的动机问题:做出改动的东西,同时又是为改动背书的东西。
一个看起来合理的 diff 不是证据。它只是一个语法高亮很漂亮的假设。
认识 no_human
no_human 是一个开源(MIT)、本地运行的工作流,把一张工单一路推进到实现和评审,最后停在一个开放的 pull request 上。它跑在你的机器上,用你自己的 Claude 凭据,对着你自己的 checkout。整个循环中间没有托管服务。
它的 README 用一句话说明了自己是什么:从工单到已评审的 pull request。更有意思的是它拒绝做什么——它从不 merge。编排器打开一个 PR,然后停在 awaiting_approval。Merge 永远是人的命令。
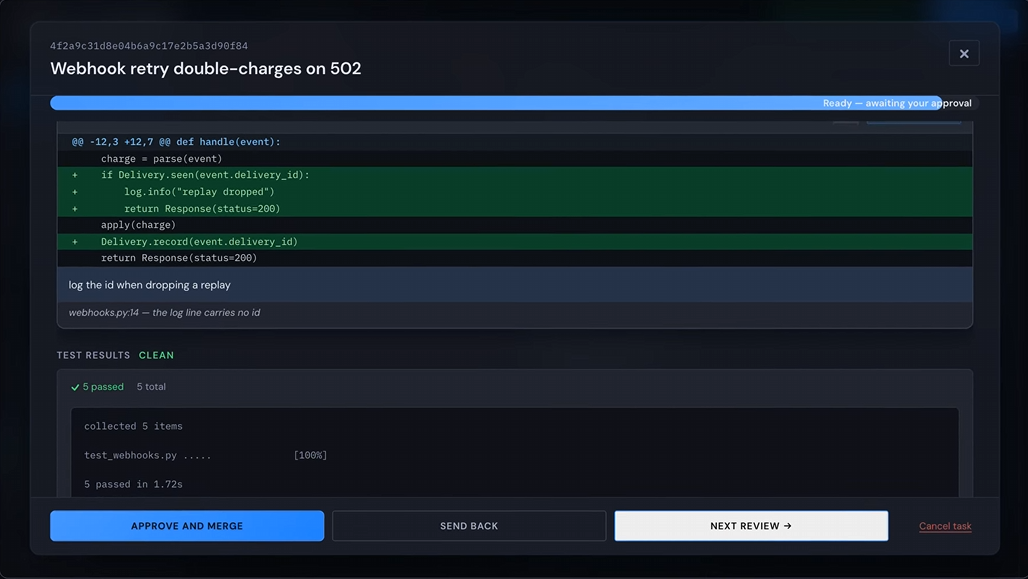
项目自己记录的流水线:
ticket ──► context ──► plan ──► implement ──► review ──► test ──► PR ──► you merge
              │                      │           │         │
              │                      │           │         └── local runner + optional CI
              │                      │           └── fresh-context reviewer, edit tools refused
              │                      └── Agent SDK, your credentials, your checkout
              └── grep, git log, past sessions
这张图里有两处是承重结构,而且很容易被一眼扫过去。
Git 不归模型管。 建分支、提交、推送都由 no_human 自己的 git 代码完成,不是 agent。实现跑在一个 PreToolUse hook 后面,这个 hook 强制执行禁用路径、受保护分支、禁止 merge,以及破坏性 shell 的熔断。agent 写文件;它不驱动版本控制。
评审者不是作者。 它是一个独立的 Agent SDK 会话,上下文是全新的,默认使用不同层级的模型,并且拒绝文件编辑工具。
各道关卡,以及每一道究竟是为了什么
即使你从不安装这东西,这部分也值得一读,因为每一道关卡都是为了击破自主工作的某一种特定失败模式。
防篡改守卫——确定性的,不涉及模型
testing/tamper_guard.py 把测试文件与产品代码分开做 diff,并在以下情况失败:
- 测试数量或断言数量净减少
skip/xfail标记净增加- 真实断言被替换成同义反复
- 在
conftest.py里出现伪造行为的autousefixture
不做模型判断。它跑在昂贵审查之前,所以一个被掏空的测试套件在花掉一个 reviewer token 之前就会被拦下。覆盖 Python、JS/TS、Java 和 e2e/ 树。
为什么这件事普遍重要:如果你的验证机制位于 agent 的写入面之内,它就不是验证机制。 任何能改自己测试的自主系统,都需要一个循环之外的东西盯着测试本身。
复现闸门——证明 bug 曾经存在
testing/repro_gate.py 把 coder 作为证据提交的测试复制进一个位于 merge base 的 worktree,并要求它们在那里失败、在新树上通过。
reproduction test
  OLD TREE (merge base) → FAIL
  NEW TREE (the change) → PASS
一个 bugfix 的测试如果在未修复的代码上也能通过,那它关于这个 bug 什么都没证明。这是整个项目里最便宜的一个想法,也是我明天就会偷给人类团队的那个。
准确性说明:默认模式是 advisory,对于 coder 的改动通过编辑工具触达了 .py 文件的 Python bugfix,它仍然会强制执行。repro_gate.mode: required 去掉这些条件,对每一处改动都强制执行。这个细微差别写在文档里,而且很重要——一个由 sed 写出的 .py 文件不受默认模式约束。
独立对抗性审查
review/reviewer.py 开一个全新会话——它没见过 coder 的推理、它的自我辩解,也没见过它的计划。它的 Write、Edit、NotebookEdit 和 MultiEdit 工具被拒绝,直接的 git 和 forge 写命令也一样。默认情况下,它跑在比实现者更高一档的模型上。它被要求去反驳「done」。
它返回的东西才是我在意的:一份带文件、行号和严重程度的发现清单。一个布尔判定。绝不是一个数字自评分。
有三个性质让这个判定难以被钻空子,而这三个都是代码,不是提示词文本:
- 每一处被引用的位置都会对照实际的树检查;引用不存在的行号的发现会被降级为建议。
- 通过/失败是从清单确定性地重新计算出来的,不是听模型怎么说。
- 崩溃、超时或输出无法解析的 reviewer 失败关闭。
最后一条才是关键。一个在评审器坏掉时就自动放行的系统,根本没有评审器,只有一个形式。
留出测试、验证器与合并策略
tests/held_out/由编排器运行,并作为证据交给评审器,实现者从未见过这些证据。.no_human/verifiers.yaml让你用自然语言写项目规则,按路径 glob 限定作用范围;每条规则都会触发一次独立的、有边界的评审调用,而且每个结论都会被记录——通过或失败,绝不只记失败。评审器重试一次后仍未给出结论的,记为unavailable并按建议性意见处理,理由说得很明确:闸门上的缺口不能作为关于这次改动的证据。core/merge_policy.py把一组固定规则(评审通过、测试通过、无篡改、复现通过或不要求、验证器满足、CI 成功或未知)汇成一个ready: bool,并附上逐条规则的明细。如果 diff 改动了合并策略文件本身,会被标记并强制ready: false——写代码的不能自己给自己造合并闸门。
诚实地停下
循环是有边界的:每个循环 3 次尝试,每次尝试 500 轮,跨恢复累计 9 次尝试。重复一次完全相同的工具调用,或同一个错误特征出现两次,就会触发卡死检测,此时重置上下文,而不是在一个已经混乱的会话上继续叠加修正。
用尽之后,它不会编一个看起来合理的 diff。它把阻塞归入十一个类别之一(MISSING_ACCESS、AMBIGUITY、SCOPE_EXPLOSION、IMPOSSIBLE、QUOTA、BUDGET_EXHAUSTED,以及另外五个),然后要么挂起并给出唤醒条件,要么升级,附上一份结构化报告和一个具体的问题。
文档里的说法比我写得好:
一次诚实的升级,分诊要花一分钟。一个自信的错误 diff,评审要花一小时。
两条工作流,并排看
常见的形态:
Ticket
  ↓
Agent generates code
  ↓
Agent runs tests  ←──── agent can edit these
  ↓
Agent says "Done" ←──── agent grades itself
  ↓
You review a diff with no evidence attached
失效模式:删测试、新增 skip、同义反复、修了但从没复现过 bug、在本该回答“我不知道”的地方给出自信的答案。
no_human 的形态:
Ticket
  ↓
Context (grep, git log, past sessions)
  ↓
Plan
  ↓
Implement          (git owned by orchestrator, not the model)
  ↓
Tests + held-out tests
  ↓
Tamper guard       ← deterministic, before any reviewer spend
  ↓
Reproduction gate  ← fails at base, passes on head
  ↓
Deterministic evidence (lint, wiring, net-new types)
  ↓
Independent reviewer, fresh context, edit tools refused
  ↓
Merge policy → ready: bool + per-rule breakdown
  ↓
PR opens, task parks at awaiting_approval
  ↓
YOU approve
在这条链上,agent 对自己工作的评价不作为任何一道闸门出现。
我一直在琢磨的那部分:置信度与证据
我用过的每个 agent 都会告诉你它很有把握。有些还会给你一个数字。
那个数字是模型的输出。它由生成代码的同一个过程生成,基于同一份上下文,带着同样的盲区。问它有多确定,等于问被告要判决结果。
对比一下:
Reproduction test
  OLD TREE → FAIL
  NEW TREE → PASS

Test integrity
  tests: +58   assertions: +0 net loss
  skips: +0    tautologies: 0
  → CLEAN

Reviewer (fresh context, different model, edit tools refused)
  findings: 0 blocking, 2 advisory (file:line cited, verified against tree)
  → PASS

Merge policy
  review ✅  tests ✅  tamper ✅  repro ✅  verifiers ✅  ci ✅
  → ready: true
上面每一行都是另一个工程师可以重新跑一遍的东西。没有一行需要你相信 agent 关于自己的任何说法。
置信度是一种主张。证据是别人能核查的主张。
整个想法就是这样,而且它其实跟 AI 没多大关系。
给一个本身就是关于可信 AI 的项目做贡献
有意思的地方在于它的递归性:当项目本身是一个验证系统时,你的 PR 会被它所实现的那套理念验证。
我提交了三处改动,全部合并,都挂在 issue #114 下——“将净新增的类型检查诊断作为审查证据附上;在采用 LSP 导航前先做测量。” 这个 issue 的前提是:审查关卡依赖机器可核查的信号,而类型诊断正是缺失的那一类。
PR #164 —— 将净新增类型诊断作为审查证据(已合并)
问题。 审查者看一个 diff 时,无从知道这次改动有没有引入类型错误。在 head 树上跑类型检查器没有用:一个已有 400 个错误的仓库会报出 400 个,信号被淹没。
我做了什么。 如果被审查的仓库配置了检查器(pyrightconfig.json / [tool.pyright]、[tool.mypy] / mypy.ini / setup.cfg [mypy],或 tsconfig.json),就用同一个检查器、同一套 argv 对整个项目跑两遍——一遍在 merge base,一遍在被审查的 commit——然后减去 base 的结果。一个已有 400 个错误的仓库会报出 net-new: 0。
四个设计决策,每一个都是为了避开某个具体缺陷,而不是为了增加功能:
- 不限定在改动行。 这一点与 lint 证据不同。典型的净新增类型错误出现在 diff 从未碰过的调用点上——把某个参数收窄,所有调用方都会亮起来。按改动行过滤,恰好会丢掉最值得要的那些诊断。
- 指纹忽略行号。 插入一个 import 就会把它下面的一切都挪位。键是作为多重集的
(path, code, digit-normalised message)。 - 沉默意味着“没跑”,绝不意味着“干净”。 二进制缺失、检查器崩溃、输出无法解析——全都产出
ran=False,不渲染任何区块。跑过了但什么都没找到,产出的是net-new: 0,那是一个不同且可用的事实。 - 覆盖率要报告,不能假定。 一次性的 worktree 里没有安装依赖,所以
tsc和pyright会把未解析的符号降级为Any。unresolved_imports会渲染成一行COVERAGE LIMIT,因此net-new: 0永远不会被读成无条件的“干净”。
评审反馈——三个阻塞问题,全都属实。 这个项目正是在这里教会了我一些东西。
-
出口门禁变红了。 仓库里每个 exec 或网络通道都在
tests/test_egress_allowlist.py中声明。我的检查器从shutil.which构建 argv,所以扫描器无法指出程序名。维护者的意思不是“加一条记录”,而是:PyPI 上的pyright包是个启动器,首次运行时会下载 Node,因此一次评审就可能发起网络调用,那条记录必须写明这一点。写这条记录时,暴露出我自己模块 docstring 里的一个矛盾——它声称“永远不会安装任何东西”。 -
我的检查器写进了被评审的目录树。
mypy会在运行处丢下.mypy_cache/;tsc会写入*.tsbuildinfo。收集器正好位于编排器用reviewer_worktree.snapshot/.compare括起来的窗口内——于是一次缓存写入会让那次比较报告出一个新增路径,编排器据此判定reviewer_wrote、回滚,并用一个谁都没造成过的完整性失败,替换掉一个真实的判定结果。 我之前是孤立地推理收集器,而没有考虑它在编排器中所处的位置。问题恰恰就出在这里。修复方案是对称的,而不是逐个检查器处理:
_run_at_commit现在同时服务两边,因此检查器写入的任何东西都到不了本次尝试的目录树,未跟踪文件也不再会被读成净新增。用一个假检查器写了测试来钉住这一点,那个假检查器确实会在运行处创建.mypy_cache/missing_stubs。把运行后的目录树回退成被评审的目录树,会让六个测试变红。 -
成本。 整个收集过程只设一个截止时间,而不是每次运行设上限(后者的真实最坏情况是检查器数 × 边数 × 上限),通过
asyncio.to_thread移出事件循环,在单轮路径上完全跳过。
我最引以为傲的,是那个没人要求的东西。 让运行对称并没有修复 TypeScript 覆盖率问题——它改变了问题的形态。现在两边同等退化,于是可比性检查通过,减法就在两份盲分析上进行。算术上没问题。但 net-new: 0 会是一个虚假的干净结果,而那个模块存在的意义,恰恰就是不输出这种东西。所以 COVERAGE LIMIT 那一行保留了下来,删掉它会让一个测试变红。
我把那个不好看的数字报上去了。 在 130 个本地仓库上做检测:32 个能跑起来(25%),其中 94% 走的是退化的 TS 路径,而在这条路径上报出的问题里,有三分之一到三分之二是 unresolved-import 噪声。我也写明了这个样本的两个局限——只来自一个开发者的机器,且偏向 TS 前端工作,所以 25% 不是总体数字。它最终被当作参考性证据,正是因为覆盖率那一行把话说在了明处。
PR #221 — 向 coder 提供逐次编辑的类型反馈(已合并)
想法。 Phase 1 告诉 reviewer。Phase 2 告诉 coder,而且是在产生该诊断的同一轮里。在现有 lint hook 旁边加一个 PostToolUse hook:对 .py/.pyi 文件执行 Edit/Write 之后,对这一个文件运行配置好的检查器,并报告它在上一次成功检查时没有在该文件上报告的内容。默认关闭。
最要命的阻塞点是一句话,不是代码。 我的 header 写的是 “你对 X 的编辑引入了 N 条诊断。” maintainer 复现了两种它不成立的情况:
mypy <file>会跟随 import。他用一个 md5 前后完全相同的app.py驱动这个 hook,而lib.py多了一个错误——结果被告知是他对app.py的编辑引入了它。Bash不在_EDIT_TOOLS里,所以sed -i、patch、ruff --fix和black都不可见,它们弄坏的东西会在下一次Edit时冒出来,并被归到那次编辑头上。
这两种都不是 false clean,所以都不是那个不可接受的结果。但这是一个带着命令语气的假信号,在轮次中途发出,而真实尝试会不断产生这类序列。coder 花好几轮去修一个不是它造成的问题,正是这个项目想避免的尝试成本。
现在这段话写的是 “X 上或从 X 可达的、在该文件上次检查时未被报告的 N 条诊断”——在 coder 实际看到的文本里,把它可能误导人的两种方式都点了出来。
那一轮 review 教会我的: lint hook 可以诚实地说“你对 X 的编辑引入了”,因为 ruff 只看一个文件。对某个组件成立的一句话,不会自动对它的邻居也成立。 我连同架构一起把这套措辞继承了下来。
还有两件事,没人要求我做:
- 凭据清理。 检查器子进程会继承进程环境,而
mypy会导入仓库的plugins =行里写明的任何东西——也就是说,一个被审查的仓库可以在环境里带着我们的 OAuth token 运行自己的代码。_checker_env会丢掉所有形似密钥的变量,只保留PATH、HOME和代理。这一改动同样覆盖已经合入的 Phase 1。而且因为这次清理有实实在在的代价(读取DATABASE_URL的插件不再加载),失败时会输出一行TYPE EVIDENCE: NOT COLLECTED,写明原因,并以这句话结尾:“这并不能说明 diff 是否类型干净;它只说明这项检查没有运行。” - 缓存目录加固。 每次尝试在系统临时根目录下建一个目录,用
0700创建,只要不是我们独占就拒绝,靠 owner-pid 存活检测回收。os.makedirs(exist_ok=True)会跟随符号链接到某个目录并高高兴兴地返回;真正抓住它的是os.lstat。把判定条件强制为真,五个测试立刻变红。
那个 hook 里有十一条路径返回静默。只有一条会说话。
PR #229——先测量,再动手(已合并)
#114 的 Phase 3 原本应该是“加一个 symbol server,让 coder 能导航,而不是读整个文件”。我把它理解成一道闸门,而不是一个功能:先测量导航到底能不能回本,再决定要不要动手。
于是 scripts/navigation_value.py 测量的是:coder 读文件的总量里,有多大比例落在 definition / references / hover 调用本可以回答的读取上,并扣除符号答案自身的开销——对照一个预先登记的 15% 阈值,这个阈值在数字出来之前就定好了,免得事后照着答案调。
第一次跑的结果是 PROCEED,27.6%。它是错的。按读取量算,.md 是语料库里占比最大的扩展名,而没有任何符号调用能回答一个关于 README 的问题。换成一份符号服务器真正支持的封闭语言白名单,同一份语料读出来是 10.4% / 13.7%,结论直接反转。一个常量就能翻转整道 phase gate,所以现在有一对 fixture,除了文件扩展名之外完全相同,专门钉住这个常量。
然后维护者找到了同一个 bug 更深的那一层。 我的 SYMBOL_QUERY_TOOLS 是 {Grep, Search}。no_human 的 coder 两个都不发——它通过 Bash 搜索。来自 fleet 数据库:
Bash 115,776 | Read 35,557 | Edit 18,425 | Write 3,010
Grep 0 | Glob 0 | Search 0
Bash calls containing grep/rg/ag/ack: 50,459我的脚本称为最强信号的那个类别,在结构上是空的,而脚本却欣然在它自己最强的信号根本不可能存在的证据上给出了一个自信的 HALT。
修复方式:按二进制把搜索从 shell 命令中提取出来(每个二进制有自己的选项表,因为 -r 在 grep 中不取值,在 ripgrep 中是 --replace),并让零值失败关闭——NoSearchChannel 会拒绝一个只有读取、没有搜索的语料库,因为缺失的通道是仪器上的缺口,绝不是关于 agent 的证据。
在修复之后,对完整的 fleet 数据库:symbol_lookup 从占读取总量的 0 上升到 15.6%,**结论从 HALT 反转为 PROCEED。**那个结构上为空的类别成了最大的单一贡献者。
输出中仍然带着一条警告,因为结果变得更不稳健,而不是更稳健:在 6,000 字符处重新判定得到 PROCEED,在 24,000 字符处得到 HALT。
我实际学到的东西
1. 写代码之前先理解约束。#164 的两个硬性阻塞都来自孤立地推理我的模块,而不是推理它在 orchestrator 完整性窗口中的位置。架构就是约束。
**2. 好的 PR 解释行为,而不是实现。**通过评审的正文,都是那些说清楚这确立了什么、又没有确立什么的。那些「未覆盖」和「我无法在本地验证」的部分,比设计部分起了更大的作用。
**3. 报告诚实的数字,而不是好看的数字。**25% 的仓库、94% 的降级路径、三分之一到三分之二的噪声。把这一点说出来,才让它能作为参考性证据落地。
**4. 测试是产品的一部分。**我加的每一道防护都带一个阳性对照:在自身缺陷上变红,恢复后变绿。#229 中有二十四个单行变异;二十三个被捕获,唯一存活的那个被记录为等价代码,而不是悄悄忽略。
**5. 去测量,而不是去争论。**三轮严格评审,我最不反对的那个发现,恰恰是我如果去争论就会输掉的那个。重新测量维护者给我的一个数字——用三种方式,结果全都一致——结果证明很重要,因为他的依据已经变了。
6. 自动化越多,可靠性未必越高。 加入自动化的类型证据信号,反而引入了一条摧毁真实审查结论的路径。每加一道关卡,就多一个攻击面。
7. 人工审批不是瓶颈,而是信任边界。 这是责任真正落到某个人身上的唯一位置,而且相比一次糟糕合并在下游造成的所有代价,它便宜得多。
v0.2.4 中值得注意的地方
发布:https://github.com/no-human-ai/no_human/releases/tag/v0.2.4
approve-and-merge 修复——一堂关于「能用」在哪里被衡量的课
在 0.2.1–0.2.3 中,打包后的桌面应用能打开 pull request,却无法将其合入。合并关卡通过冻结的二进制文件调用外部命令时,把它当成了 Python 解释器,于是每一次 nh approve 和看板上的每一次 Approve 都在测试步骤失败。现在关卡会解析出真正的解释器,并从头到尾按 UTF-8 解码输出。
为什么重要: 人的决策点是这个产品最重要的界面。一条能开 PR 却合不进去的流水线不是完成了 90%,而是在唯一需要人参与的那一步上坏掉了。
对开发者的影响: 如果你用的是打包版 0.2.x,在评估这个闭环之前先升级——你之前评估的是一条被切断的审批路径。
审查关卡可以在没有运行中服务器的情况下复用
现在你可以在会话中把它作为插件 skill 运行,也可以在你自己的仓库里作为 GitHub Action 对 pull request 运行——而来自 fork 的 pull request 会在读取任何凭据之前就被跳过。
为什么重要: 这是最影响团队而非个人的一项改动。验证这一半不再绑定于「我本地跑着 daemon」,而变成了 CI 可以对人类编写的 PR 调用的东西。
对开发者的影响: 基于证据的审查关卡现在可以用于 agent 从未碰过的代码。这是一个实质不同的产品。
示例: 对合入共享分支的 PR 运行它,让篡改/复现/审查者的输出作为一份清单,落在你现有 CI 旁边。
Windows 修复:这是一个类别,不是脚注
标题或输出里含希伯来文、西里尔文或日文的任务,不再在提交时崩溃、把工作搁死。用 Windows 换行符保存的 .env 不再被读成空文件、悄悄吞掉你的凭据。coder 不再因为一个盘符路径就丢掉全部代码库上下文。
为什么重要: 这几件事都属于看不见的失败。凭据文件明明是空的,却被当成不存在;coder 在没有仓库上下文的情况下照跑不误——结果出了问题,却没有任何报错。这和验证门要拦的是同一类失败,只不过发生在基础设施层。
本次发布还包含
- About 里的运行版本号来自同一个来源。
nh task add --follows会记录一个任务取代了另一个任务。- 签名情况,直说:macOS 已签名、公证并 stapled。Windows 没有代码签名——产物带
-UNSIGNED,SmartScreen 会报警,请自行对照SHA256SUMS-windows.txt核对。Linux 提供.deb和带校验和的 AppImage。 - 发布说明里列出了自己的已知问题,包括一条遗留的 Windows 非 UTF-8 代码页读取路径,计划在 0.2.5 修掉。
一个愿意公布自己已知问题的发布,算不上什么大信号,但它和这个项目其余部分发出的信号是一致的。
自己试一下
你需要一个 Claude 凭据和 Claude Code CLI,无论用哪种方式安装——后端每个任务都要调用这个 CLI。
# prerequisites
npm install -g @anthropic-ai/claude-code
claude setup-token
# install (CLI + board)
uv tool install no-human # or: pipx install no-human
# initialise, then prove the install is real
nh init && nh doctor# run
nh start # board + worker on 127.0.0.1:8420
nh task add https://github.com/org/repo/issues/42 --repo ~/git/repo
nh status # needs-you / working / waiting / done
nh review <id> # the reviewer's evidence checklist
nh diff <id> # the diff it wants to ship
nh approve <id> # your approval squash-lands the PR
nh reject <id> --reason "..." # send it back with feedback从源码运行时,你还需要 Python 3.12+、uv、git,以及带 npm 的 Node——看板是独立的 npm run build,源码检出里不带 web/dist。
预期会看到什么: 一个任务出现在看板上,拿到计划,被实现,跑你的测试,过验证门,最后作为 open PR 停在 awaiting_approval。先跑 nh review <id>,再看 nh diff <id>——先读证据清单、后看 diff,这正是整套设计想养成的习惯。
已经在 agent 里了? 有个 MCP server——基于官方 Python MCP SDK 的 stdio 桥——只暴露两个工具:task_add 和 task_status。它只跟你自己的 no_human 通信,地址是 127.0.0.1:8420,不碰别的。
nh mcp-serve{
"mcpServers": {
"no_human": { "command": "nh", "args": ["mcp-serve"] }
}
}对 Claude Code 来说,这个仓库本身就是它自己的插件市场:
/plugin marketplace add no-human-ai/no_human
/plugin install no-human@no-human-ai在依赖其中任何东西之前,值得先读的文档:verification.md(那些关卡以及它们的局限)和 security.md。
这种方法什么时候说得通
项目明确表示,目标不是那些宏大的任务,而是范围清晰的工作:修 bug、补测试缺口、小功能、调研。含糊的工单会触发升级,这是设计好的行为,不是需要绕开的障碍。
适合的场景:
- 有可复现失败路径的 bug 修复——复现关卡在这里确实在干活
- 测试缺口和覆盖率相关的工单
- 跨仓库的重复性维护
- 调研类任务,此时一句诚实的“这是我查到的,这是我无法确定的”就是合格的交付物
- 想试验 agent 工作流、但不愿放弃人工合并关卡的团队
- 与 CI 集成的工作流,尤其是现在审查关卡已经能作为 Action 运行
仍然必须有人参与的地方:
- 架构级改动,验收标准没法写成测试
- 安全敏感的代码——注意,一个会执行仓库内任何内容的审查关卡本身就是暴露面,项目自己的文档里也是这么说的
- 依赖变更,影响范围不在 diff 里
- 任何工单本身就是问题的情况。验收标准写不完整,没有哪个关卡能补救。
我会特别留意的地方
要给出平衡的评价,就得把不舒服的部分说出来,而值得肯定的是,这些大多是项目自己写在文档里的。
- 审查者是一个模型,而模型会漏东西。 已公布的确认运行(2026-08-11,
claude-opus-4-8,19 个植入缺陷 + 10 个对照)测得召回 15/19(79%)、特异度 7/10。这是个有用的关卡,不是证明。这也意味着误报是常态——要预留分诊的人力。 - **不同模型可能共享盲区。**会话的独立性是结构性的,推理的独立性不是。两个在重叠数据上训练的模型可以自信地一起犯错。
- “不同模型”是默认值,不是不变量。 你可以把审查者和实现者配成同一个模型,没有任何东西拦着你。那样会悄无声息地抹掉整个设计所依赖的那个性质。
- 只读的审查者并不是结构上只读。 文档说得很直白:编辑类工具会被拒绝,但
Bash不会,所以 shell 重定向仍然能写文件。拒绝发生在工具调用这一层,靠的是一个读取命令行的守卫——这是成本,不是证明,而且它建模的写法集合并不封闭。 - 基准测试是自己跑的,你复现不了。 测试框架可以复用,语料却钉死在作者本地的路径上。同样的规格,多次运行之间成功率会浮动几个百分点,因为编码器是非确定性的。
- 没有任何美元数字是账单上的数字。 支出以成本加权 token 为上限;在项目自己的生命周期测量中,缓存读取占烧掉 token 的 95.6%。任何成本估算都只能当估算看。
- 自动化测试是一个上限。 这里的一切都是对照现有测试来验证的。关卡能证明某个测试在基线时失败、现在通过;它无法证明这个测试是正确的测试。
- 语言覆盖不均衡。 篡改守卫能读 Python、JS/TS 和 Java。复现关卡默认用 pytest。
- 没有部署步骤。 流水线止于一个打开的 PR,这是有意为之。
这些都不影响这套方法的价值,反而让它更清晰——而清晰正是这些 gate 追求的东西。
更大的问题
眼下业界的问题是:*AI 到底能写多少代码?*答案已经有了:很多,很快,而且越来越快。
我认为更有用的问题是:
AI 能承担多少工程工作,同时产出人类可以独立核查的证据?
因为第二个问题才决定了这套东西能否扩展到一个有动力的开发者盯着每一份 diff 之外的规模。生成代码的量受限于审查能力。而审查能力不受阅读速度限制——它受限于你在做出判断之前必须重建多少东西。
一个只丢给你 diff 的 agent,会让你重建一切。一个丢给你 diff、一个在 merge base 上失败而在 head 上通过的复现、一份测试完整性增量、一份带已验证 file:line 引用的全新上下文审查者清单,以及逐规则的合并裁决的 agent,已经替你做了你的一部分工作,而不只是它自己那部分。
这正是 no_human 实际在做的事,也是我愿意为它开三个 PR、经历三轮比大多数人类代码审查还难的审查的原因。
顺便说一句,这个名字是个玩笑。整个架构都是围绕人类说“是”来组织的。
如果你对可信的 AI 辅助开发感兴趣
这个项目是 MIT 许可,本地运行,并且真心欢迎外部贡献——v0.2.4 包含了来自核心项目之外五个人的贡献,每个人都在 contributors/ 下有 CLA 记录,提交上也署了自己的名字。
除了“写代码”之外的入手方式:
- 读
docs/verification.md。即使你从不安装它,*“以及它不覆盖什么”*那一半也是我读过的关于自动化验证局限性的最好的短文档。 - 读一个开放的 PR 讨论串。审查文化就是产品本身。
- 在你熟悉的仓库里拿一个小 bugfix 跑一遍,先读
nh review <id>再看 diff。 - 提一个 issue,说说你的代码库里有哪些失败模式是这些 gate 抓不到的。这是你能给一个验证项目做的最有用的贡献。
- 如果你自己也在做 agent 工具:把复现 gate 抄走。概念上只有二十行,却是这里价值最高的想法。
项目主页与文档: https://getnohuman.com/
GitHub: https://github.com/no-human-ai/no_human
v0.2.4 版本发布: https://github.com/no-human-ai/no_human/releases/tag/v0.2.4
如果你试用了,我很想知道你的仓库里第一个触发的是哪道关卡——以及它判断得对不对。
致谢
no_human 由 Eyal Golan(@eyalgolan)构建和维护。感谢他邀请我写这篇文章,也感谢他三轮审阅——审得比被审的代码还严。文中对项目的描述若有错误,责任在我;凡是写对的地方,都是因为文档和审阅意见写得足够直白,包括那些不太好看的部分。