AIはコードを書けるが、修正が有効だと証明できるのか?
AI が生成した変更を人間が信頼するにはどんな証拠が必要か。著者は no_human に出した3つの PR を通じ、改ざん防止ガード、再現ゲート、敵対的レビューがそれぞれどの種類の失敗を防ぐかを明らかにした。
日本語
コピー
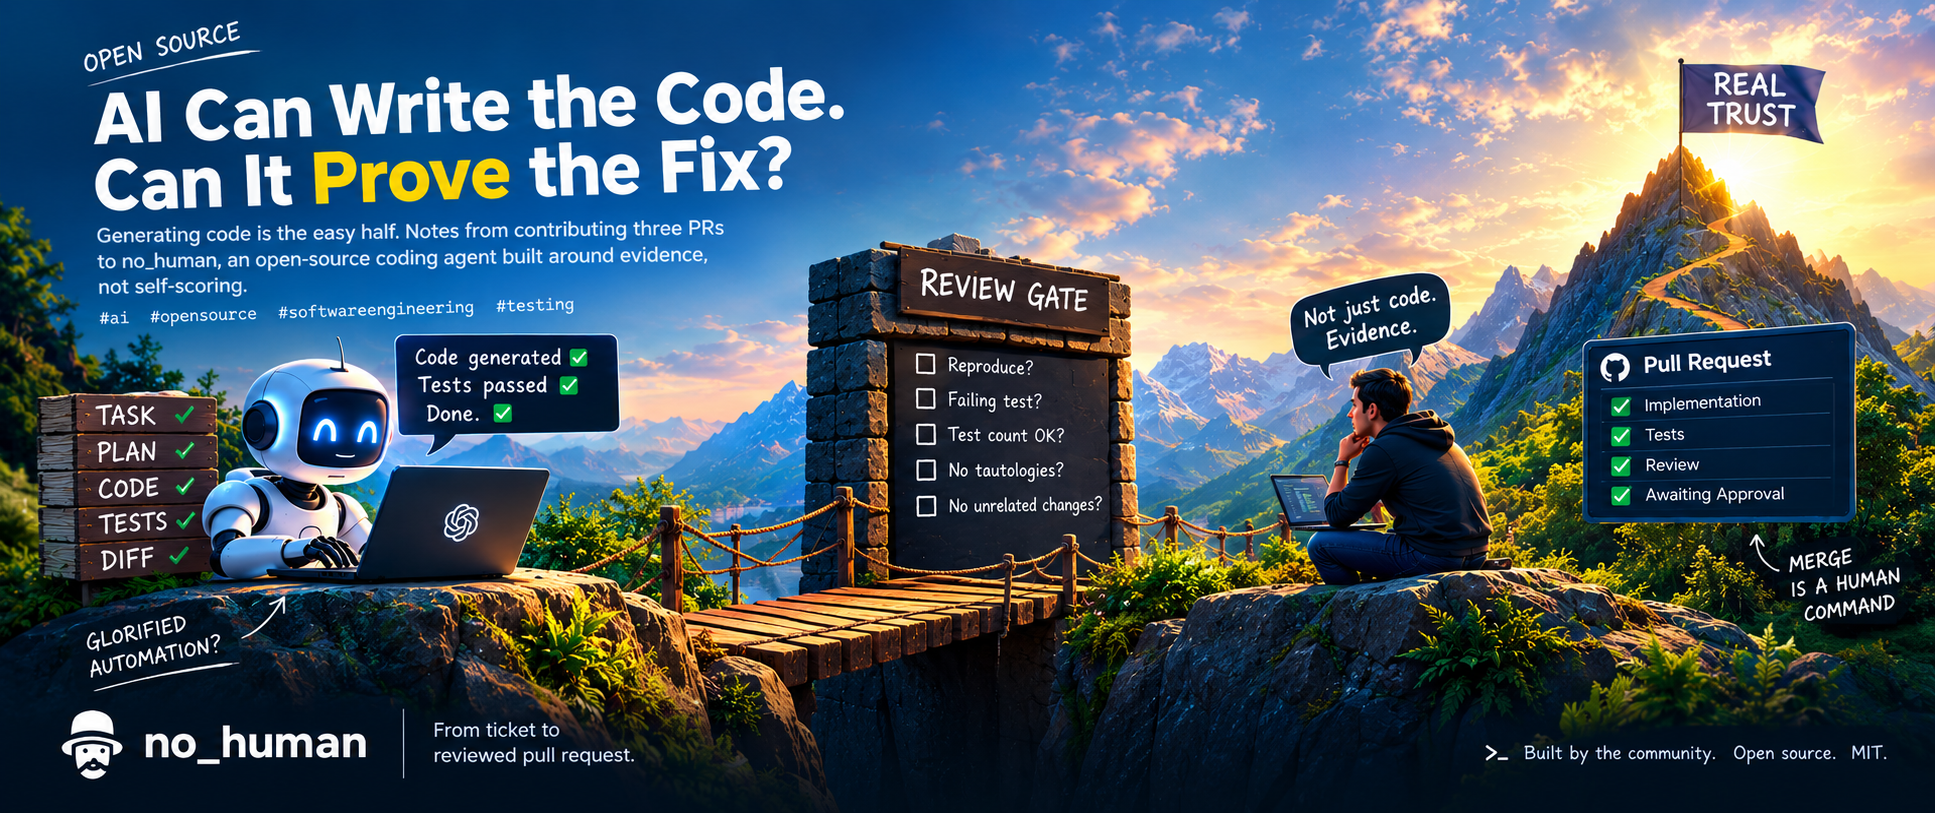
自主コーディングエージェントで最も高くつく成果物は、ビルド失敗ではない。ビルド失敗はタダだ。CIが赤くなって、あなたは作業を続ける。
高いのは、緑なのに間違っているdiffだ。こいつはレビュー、マージ、デプロイを食い尽くし、三週間後のある午後、誰かがbisectでたどり着いて、もう一度食い尽くす。
そしてエージェントがこの手の産物を生み出す手順は、腹が立つほど単純だ。変更を書いて、テストを走らせる。邪魔なテストが一つある。テストを書き換える。全部緑。done と言う。
この一連の動作のどこにも、厳密には嘘はない。疲れた人間も同じことをする。違うのは、人間がやる場合にはdiffを読む別の人間がいて、なんでこのassertion書き換えたの? と聞く。エージェントが午前三時にタスクキューの中でやる場合、誰も聞かない。
だから自分が興味あるのは「AIはコードを書けるのか」ではない。それはもう答えが出ている。問いはこうだ:
AIが生成した変更は、何を提示すれば人間が信頼していいことになるのか?
この問いに具体的に答えようとしているプロジェクトを見つけて、PRを三本出し、レビューで粉々にされて、今も考え続けている。以下がそこから得たものだ。
コード生成は検証ではない
実際のエンジニアリング作業はこういう形をしている:
間にある工程は儀式ではない。一段飛ばすたびに、特定の種類の欠陥が誰にも拾われないまま残る。
あるチケットを考えてみる:「タスクタイトルに非ラテン文字が含まれるとクラッシュするのを修正」(これは実在する類のバグだ。これから説明するプロジェクトは、v0.2.4でWindows上のまさにこれを直している。)
エージェントがdiffを出す。エンコード経路に触っている。テストは通る。出していいか?
答えられない。なぜなら分かっていないからだ:
- クラッシュを再現するテストはあるのか? なければ、修正を証明しているものは一体何なのか?
- そのテストは古いコードで落ちるのか? 両方のツリーで通るなら、バグに対して何の証明力もない。
- テストの数は減っていないか? バグを直しつつ無関係なテストを四つ黙って消した変更は、二つの変更だ。
- 恒真式になったassertionはないか?
assert result == resultは永遠に緑だ。 - 無関係な挙動が変わっていないか? エンコード修正は行末を道連れに変えがちだ。
ここに挙げた問いのどれも、コードそのものについてではないことに注意してほしい。問うているのはコードの周りにある証拠だ。そして自分の成果物を自分で採点するagentには、構造的な利害の衝突がある。変更を生み出すものが、同時にその変更を保証するものにもなっている。
もっともらしく見えるdiffは証拠ではない。シンタックスハイライトが綺麗な仮説にすぎない。
no_humanを知る
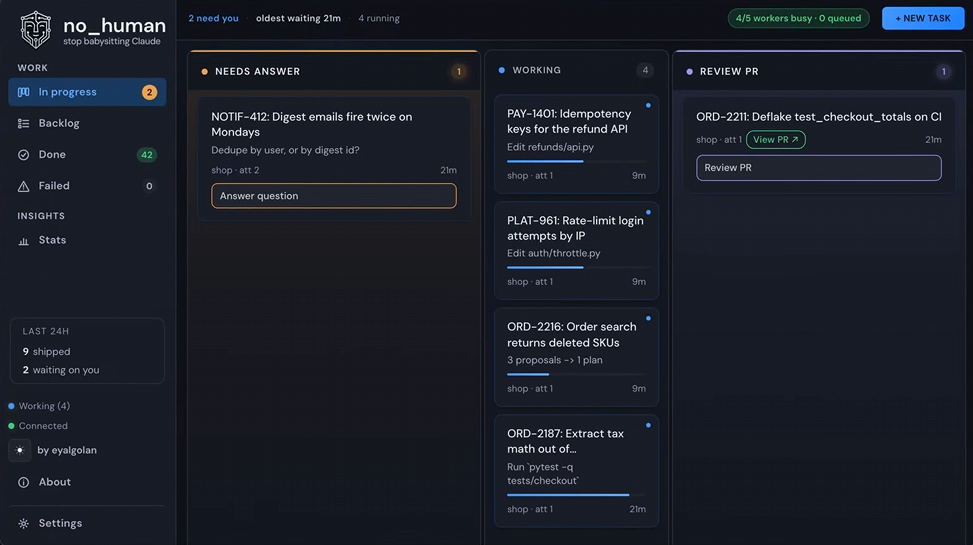
no_human はオープンソース(MIT)でローカル動作のワークフローで、チケットを実装とレビューまで一気に進め、最後はオープンなpull requestで止まる。あなたのマシン上で、あなた自身のClaude資格情報を使い、あなた自身のcheckoutに対して動く。ループの途中にホスト型サービスは一切ない。
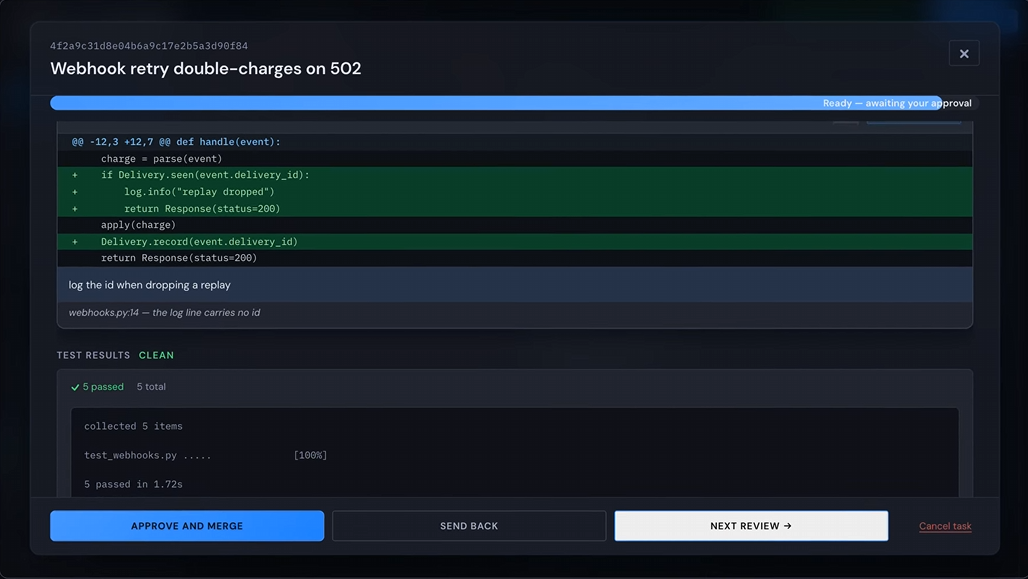
READMEは一行で自分が何かを言い切っている:チケットからレビュー済みpull requestまで。もっと面白いのは、何をやらないかだ。決してmergeしない。オーケストレーターはPRを開いて、awaiting_approval で止まる。Mergeは常に人間の命令だ。
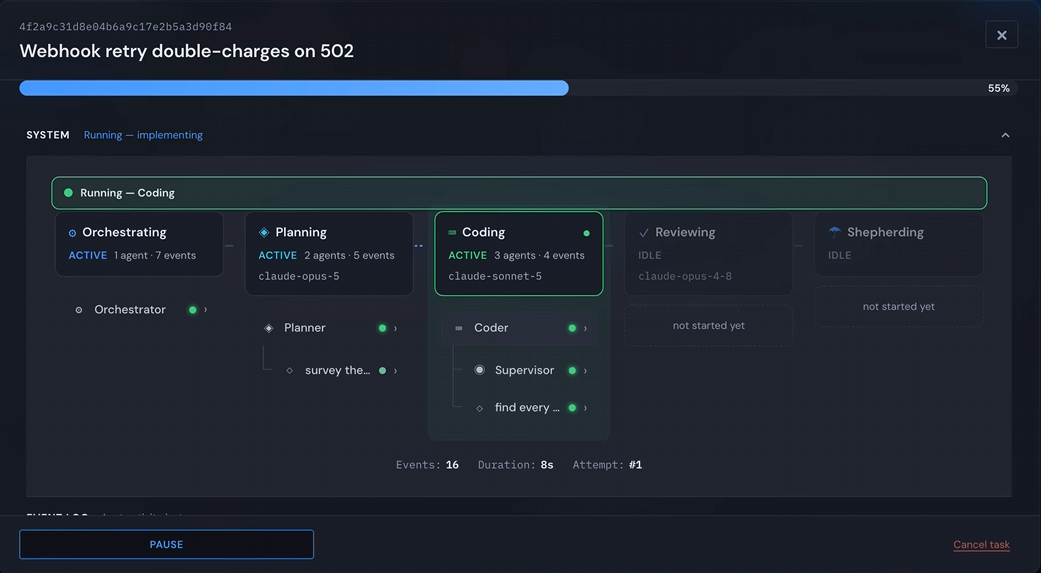
プロジェクトが記録しているパイプライン:
ticket ──► context ──► plan ──► implement ──► review ──► test ──► PR ──► you merge
              │                      │           │         │
              │                      │           │         └── local runner + optional CI
              │                      │           └── fresh-context reviewer, edit tools refused
              │                      └── Agent SDK, your credentials, your checkout
              └── grep, git log, past sessions
この図には耐力壁が二本あり、どちらも流し読みで見落としやすい。
Gitはモデルの管轄外だ。 ブランチ作成、コミット、プッシュはすべてno_human自身のgitコードが行う。agentではない。実装は PreToolUse hookの後ろで走り、このhookが禁止パス、保護ブランチ、merge禁止、破壊的shellのサーキットブレーカーを強制する。agentはファイルを書く。バージョン管理は動かさない。
レビュアーは作者ではない。 独立したAgent SDKセッションで、コンテキストはまっさら、デフォルトで別階層のモデルを使い、ファイル編集ツールを拒否する。
各ゲートと、それぞれが何のためのものか
これをインストールする気がなくても、この部分は読む価値がある。どのゲートも、自律作業の特定の失敗モードを一つずつ潰すためにある。
改ざんガード——決定的、モデル関与なし
testing/tamper_guard.py はテストファイルとプロダクションコードを分けてdiffし、次の場合に失敗する:
- テスト数またはassertion数が純減している
skip/xfailマーカーが純増している- 本物のassertionが同語反復に置き換えられている
conftest.pyの中に挙動を偽装するautousefixtureがある
モデルの判断は入らない。高価なレビューの前に走るので、中身を抜かれたテストスイートはreviewer tokenを一つも消費せずに止まる。Python、JS/TS、Java、e2e/ のツリーをカバーする。
なぜこれが一般に重要か:検証機構がagentの書き込み面の内側にあるなら、それは検証機構ではない。 自分のテストを書き換えられる自律システムには、テストそのものを外から見張る何かが必要だ。
再現ゲート——バグがかつて存在したことを証明する
testing/repro_gate.py coder が証拠として提出したテストを、merge base にある worktree にコピーし、そこで失敗すること、新しいツリーでは通ることを要求する。
reproduction test
  OLD TREE (merge base) → FAIL
  NEW TREE (the change) → PASS
bugfix のテストが、未修正のコードでも通ってしまうなら、そのテストはこのバグについて何も証明していない。プロジェクト全体で一番安上がりなアイデアであり、明日にでも人間のチームから盗んでくるやつだ。
正確性の補足:デフォルトモードは advisory で、coder の変更が編集ツール経由で .py ファイルに触れた Python の bugfix に対しては、これが依然として強制される。repro_gate.mode: required はこれらの条件を外し、あらゆる変更に対して強制する。この違いはドキュメントに書かれていて、しかも重要だ——sed が書いた .py ファイルはデフォルトモードの対象外になる。
独立した敵対的レビュー
review/reviewer.py はまっさらなセッションを開く——coder の推論も、自己弁護も、計画も見ていない。Write、Edit、NotebookEdit、MultiEdit のツールは拒否され、直接の git や forge の書き込みコマンドも同様だ。デフォルトでは、実装者より一段上のモデルで動く。「done」に反論するよう求められる。
返ってくるものこそが、私が気にしているものだ:ファイル、行番号、深刻度を伴う所見のリスト。真偽の判定。数字による自己採点は決してない。
この判定をすり抜けにくくしている性質が三つあり、いずれもプロンプトの文章ではなくコードだ:
- 引用された位置はすべて実際のツリーと照合される。存在しない行番号を引用した所見は、提案へと格下げされる。
- 合否は所見リストから決定論的に再計算される。モデルの言い分を聞くのではない。
- クラッシュ、タイムアウト、出力がパースできない reviewer はフェイルクローズする。
最後の一つが肝だ。レビュアーが壊れたら自動的に通してしまうシステムには、レビュアーなどいない。形式があるだけだ。
ホールドアウトテスト、バリデータ、マージポリシー
tests/held_out/はオーケストレーターが実行し、証拠としてレビュアーに渡す。実装者はこの証拠を一度も見ない。.no_human/verifiers.yamlを使うと、プロジェクトのルールを自然言語で書き、パス glob で適用範囲を限定できる。各ルールは独立した境界付きのレビュー呼び出しを一つ起動し、すべての結論が記録される——合格でも不合格でも。失敗だけを記録することは決してない。レビュアーが一度リトライしても結論を出せなかった場合はunavailableとして記録し、提案的な意見として扱う。理由は明快だ:ゲートの穴は、この変更についての証拠にはならない。core/merge_policy.pyは固定のルール群(レビュー合格、テスト合格、改ざんなし、再現合格または不要、バリデータ充足、CI 成功または不明)を一つのready: boolにまとめ、ルールごとの内訳を添える。diff がマージポリシーのファイル自体を変更していた場合は、フラグが立ち、ready: falseが強制される——コードを書く者が自分のマージゲートを自分で作ることはできない。
正直に止まる
ループには境界がある:1ループあたり3回の試行、1回の試行あたり500ターン、復帰をまたいで累計9回の試行。まったく同じツール呼び出しの繰り返し、あるいは同じエラーシグネチャの二度目の出現でスタック検出が発動し、そのときはすでに混乱したセッションに修正を積み重ねるのではなく、コンテキストをリセットする。
使い切ったあとも、それらしい diff をでっち上げたりはしない。ブロッカーを11のカテゴリのいずれかに分類し(MISSING_ACCESS、AMBIGUITY、SCOPE_EXPLOSION、IMPOSSIBLE、QUOTA、BUDGET_EXHAUSTED、および残り五つ)、その後は条件付きで待機して再開条件を示すか、エスカレーションして構造化レポートと具体的な問いを一つ添える。
ドキュメントの言い回しのほうが私よりうまい:
正直なエスカレーションなら、トリアージは1分で済む。自信満々の間違った diff は、レビューに1時間かかる。
二つのワークフローを並べて見る
よくある形:
Ticket
  ↓
Agent generates code
  ↓
Agent runs tests  ←──── agent can edit these
  ↓
Agent says "Done" ←──── agent grades itself
  ↓
You review a diff with no evidence attached
失敗のパターン:テストを消す、skip を足す、トートロジー、直したのにバグを一度も再現していない、本来「わからない」と答えるべきところで自信満々の答えを出す。
no_human の形:
Ticket
  ↓
Context (grep, git log, past sessions)
  ↓
Plan
  ↓
Implement          (git owned by orchestrator, not the model)
  ↓
Tests + held-out tests
  ↓
Tamper guard       ← deterministic, before any reviewer spend
  ↓
Reproduction gate  ← fails at base, passes on head
  ↓
Deterministic evidence (lint, wiring, net-new types)
  ↓
Independent reviewer, fresh context, edit tools refused
  ↓
Merge policy → ready: bool + per-rule breakdown
  ↓
PR opens, task parks at awaiting_approval
  ↓
YOU approve
この連鎖のどこにも、agent 自身の仕事に対する評価はゲートとして現れない。
私がずっと考えている部分:確信度と証拠
私が使ったことのある agent はどれも、自信があると教えてくれる。数字を出してくるものもある。
その数字はモデルの出力だ。コードを生成したのと同じプロセスが、同じコンテキストで、同じ盲点を抱えて生成している。どれだけ確かかと尋ねるのは、被告に判決を尋ねるのと同じだ。
比べてみてほしい:
Reproduction test
  OLD TREE → FAIL
  NEW TREE → PASS

Test integrity
  tests: +58   assertions: +0 net loss
  skips: +0    tautologies: 0
  → CLEAN

Reviewer (fresh context, different model, edit tools refused)
  findings: 0 blocking, 2 advisory (file:line cited, verified against tree)
  → PASS

Merge policy
  review ✅  tests ✅  tamper ✅  repro ✅  verifiers ✅  ci ✅
  → ready: true
上の行はどれも、別のエンジニアがもう一度実行できるものだ。agent の自己申告を信じる必要がある行は一つもない。
確信度は主張だ。証拠は、他人が検証できる主張だ。
アイデアとしてはこれで全部で、しかも実のところ AI とはあまり関係がない。
それ自体が信頼できる AI についてのプロジェクトに貢献する
面白いのはその再帰性だ。プロジェクト自体が検証システムであるとき、あなたの PR は、そのプロジェクトが実装している理念によって検証される。
私は三つの変更を提出し、すべてマージされた。どれも issue #114 の下にぶら下がっている——「純増の型チェック診断をレビュー証拠として添付する。LSP ナビゲーションを採用する前に計測する。」 この issue の前提はこうだ:レビューゲートは機械的に検証可能なシグナルに依存しており、型診断はまさに欠けているカテゴリである。
PR #164 —— 純増の型診断をレビュー証拠として(マージ済み)
問題。 レビュアーは diff を見ても、その変更が型エラーを持ち込んだかどうかを知る手立てがない。head ツリーで型チェッカーを走らせても無意味だ。すでに 400 個のエラーを抱えるリポジトリは 400 個を報告するだけで、シグナルは埋もれてしまう。
やったこと。 レビュー対象のリポジトリがチェッカー(pyrightconfig.json / [tool.pyright]、[tool.mypy] / mypy.ini / setup.cfg [mypy]、または tsconfig.json)を設定していれば、同じチェッカーと同じ argv でプロジェクト全体を2 回走らせる。1 回は merge base で、もう 1 回はレビュー対象の commit で。そして base の結果を差し引く。400 個のエラーを抱えるリポジトリは net-new: 0 を報告する。
設計上の判断は 4 つ、いずれも機能を足すためではなく、特定の欠陥を避けるためのものだ。
- 変更行に限定しない。 ここが lint の証拠とは違う。典型的な純増の型エラーは、diff が一度も触っていない呼び出し側に現れる。ある引数を狭めれば、呼び出し元が一斉に光る。変更行でフィルタすると、最も価値のある診断をちょうど取りこぼす。
- フィンガープリントは行番号を無視する。 import を 1 行挿入すれば、その下はすべてずれる。キーは多重集合としての
(path, code, digit-normalised message)だ。 - 沈黙は「走っていない」を意味し、「クリーン」を意味しない。 バイナリが無い、チェッカーがクラッシュする、出力がパースできない——どれも
ran=Falseを返し、ブロックを一切描画しない。走ったが何も見つからなかった場合はnet-new: 0を返す。それは別の、使える事実だ。 - カバレッジは報告するもので、仮定するものではない。 使い捨ての worktree には依存関係が入っていないので、
tscとpyrightは未解決のシンボルをAnyに格下げする。unresolved_importsはCOVERAGE LIMITの 1 行として描画される。だからnet-new: 0が無条件の「クリーン」と読まれることはない。
レビューのフィードバック——3 つのブロッカー、いずれも正しかった。 このプロジェクトが私に何かを教えてくれたのは、まさにここだ。
-
出口ゲートが赤くなった。 リポジトリ内の exec もネットワーク経路も、すべて
tests/test_egress_allowlist.pyで宣言する。私のチェッカーはshutil.whichから argv を組み立てるので、スキャナはプログラム名を指し示せない。メンテナの言いたいことは「記録を 1 行足せ」ではなかった。PyPI のpyrightパッケージはランチャーで、初回実行時に Node をダウンロードする。つまりレビュー 1 回でネットワーク呼び出しが起きうる、その記録はそう書かねばならない、ということだ。その記録を書いている最中に、自分のモジュールの docstring の矛盾が露呈した——「何もインストールしない」と書いてあった。 -
私のチェッカーが、レビュー対象のツリーに書き込んでいた。
mypyは実行場所に.mypy_cache/を残すし、tscは*.tsbuildinfoに書き込む。コレクタは、オーケストレータがreviewer_worktree.snapshot/.compareで囲むウィンドウのちょうど内側にある——だからキャッシュ書き込み 1 回で、その比較は新しいパスを報告し、オーケストレータはそれを根拠にreviewer_wroteと判定してロールバックし、誰も引き起こしていない完全性の失敗で、本物の判定結果を置き換えてしまう。 私はコレクタを単体で考えていて、オーケストレータの中での位置を見ていなかった。問題はまさにそこにある。修正はチェッカーごとの対処ではなく、対称な形にした。
_run_at_commitが両側を担うようになったので、チェッカーが書き込むものは今回の試行のツリーには届かず、未追跡ファイルが純増として読まれることもなくなった。実行場所に実際に.mypy_cache/missing_stubsを作る偽チェッカーを書いてテストで固定した。実行後のツリーをレビュー対象のツリーに戻すと、6 つのテストが赤くなる。 -
コスト。 収集プロセス全体で締め切りを 1 つだけにし、実行ごとの上限は設けない(後者の現実の最悪ケースはチェッカー数 × エッジ数 × 上限になる)。
asyncio.to_threadでイベントループの外に出し、単一パスでは完全にスキップする。
一番誇りに思っているのは、誰も求めていないあれだ。 実行を対称にしたことは TypeScript のカバレッジ問題を直していない——問題の形を変えた。両側が同じように劣化するので、比較可能性のチェックは通り、引き算は 2 つの盲目の分析の上で行われる。算術としては正しい。だが net-new: 0 は偽のクリーン結果になる。そしてこのモジュールが存在する意味は、まさにそういうものを出力しないことにある。だから COVERAGE LIMIT の行は残った。消せばテストが 1 つ赤くなる。
みっともない数字も報告した。 ローカルの 130 リポジトリで検出を試したところ、動いたのは 32 個(25%)。そのうち 94% が劣化した TS パスを通り、このパスで報告された問題の 3 分の 1 から 3 分の 2 が unresolved-import のノイズだった。サンプルの限界も 2 つ書いた——開発者 1 人のマシン由来であること、TS のフロントエンド作業に偏っていること。だから 25% は母集団の数字ではない。これが参考証拠として扱われたのは、まさにカバレッジの行がそれを明示していたからだ。
PR #221 — coder に編集ごとの型フィードバックを返す(マージ済み)
アイデア。 Phase 1 は reviewer に伝える。Phase 2 は coder に、しかもその診断を生んだ同じターンで伝える。既存の lint hook の隣に PostToolUse hook を足す。.py/.pyi ファイルに対して Edit/Write を実行した後、この 1 ファイルに対して設定済みのチェッカーを走らせ、前回成功したチェックではそのファイルで報告されなかったものを報告する。デフォルトはオフ。
最大のブロッカーはコードではなく、一文だった。 私の header には 「X へのあなたの編集が N 件の診断を持ち込みました」 と書いてあった。メンテナは、これが成り立たない 2 つのケースを再現した。
mypy <file>は import をたどる。彼は md5 が前後で完全に一致するapp.pyでこの hook を動かし、lib.pyにはエラーが1つ多い——その結果、app.pyへの自分の編集がそれを招いたと言い渡された。Bashは_EDIT_TOOLSの中にない。だからsed -i、patch、ruff --fix、blackはどれも見えず、それらが壊したものは次のEditのときに現れ、その編集のせいにされる。
どちらも false clean ではないので、許容できない結果ではない。だがこれは命令形の口調で、ターンの途中に発せられる偽のシグナルであり、実際の試行ではこの種の系列が延々と生まれる。coder が自分が原因でない問題の修正に何ターンも費やす——それこそこのプロジェクトが避けようとしている試行コストだ。
いまこの文言は*「X 上、または X から到達可能な、そのファイルの前回チェック時に報告されなかった N 件の診断」*となっている——coder が実際に目にするテキストの中で、誤解を招きうる2つの方向を明示している。
あのレビューで学んだこと: lint hook は「X へのあなたの編集が招いた」と正直に言える。ruff は1ファイルしか見ないからだ。あるコンポーネントについて成り立つ一文が、その隣人についても自動的に成り立つわけではない。 私はこの言い回しをアーキテクチャごと受け継いでしまった。
他に2つ、誰にも頼まれていないことをした:
- 資格情報の除去。 チェッカーのサブプロセスはプロセス環境を継承し、
mypyはリポジトリのplugins =行に書かれたものを何でも import する——つまり、審査対象のリポジトリが環境に載った私たちの OAuth token を使って自分のコードを実行できてしまう。_checker_envは鍵らしき変数をすべて捨て、PATH、HOME、プロキシだけを残す。この変更はすでにマージ済みの Phase 1 にも及ぶ。しかもこの除去には実質的なコストがある(DATABASE_URLを読むプラグインが読み込まれなくなる)ので、失敗時にはTYPE EVIDENCE: NOT COLLECTEDを1行出力して理由を書き、こう締めくくる:「これは diff が型クリーンかどうかを示すものではない。このチェックが走らなかったことだけを示す。」 - キャッシュディレクトリの堅牢化。 試行ごとにシステムの一時ルート下にディレクトリを作り、
0700で作成し、私たちが独占していなければ拒否し、owner-pid の生存検出で回収する。os.makedirs(exist_ok=True)はシンボリックリンクをたどってあるディレクトリへ行き、平然と返してくる。実際に捕まえるのはos.lstatだ。判定条件を強制的に真にすると、5つのテストが即座に赤くなる。
あの hook には黙って返る経路が11本ある。口を開くのは1本だけ。
PR #229——まず測る、それから動く(マージ済み)
#114 の Phase 3 は本来「symbol server を足して、coder がファイル全体を読む代わりにナビゲートできるようにする」はずだった。私はこれを機能ではなくゲートとして捉えた:ナビゲーションがそもそも元を取れるのかを先に測り、それからやるかどうかを決める。
そこで scripts/navigation_value.py が測るのは、coder がファイルを読んだ総量のうち、definition / references / hover の呼び出しで答えられたはずの読みが占める割合で、そこからシンボル回答自体のオーバーヘッドを差し引く——事前登録した 15% のしきい値と比較する。このしきい値は数字が出る前に決めてあり、結果を見てから調整できないようにしてある。
最初の実行結果は PROCEED、27.6%。これは間違っていた。読み量で見ると .md はコーパス中で最も割合の大きい拡張子だが、README についての問いに答えられるシンボル呼び出しは存在しない。symbol server が実際にサポートする閉じた言語のホワイトリストに切り替えると、同じコーパスが 10.4% / 13.7% と読めて、結論はきれいに反転する。定数1つで phase gate 全体がひっくり返るので、いまではファイル拡張子以外が完全に同じ fixture を1組用意し、この定数を固定している。
そしてメンテナは同じバグのもっと深い層を見つけた。 私の SYMBOL_QUERY_TOOLS は {Grep, Search} だった。no_human の coder はどちらも使わない——Bash 経由で検索する。fleet データベースから:
Bash 115,776 | Read 35,557 | Edit 18,425 | Write 3,010
Grep 0 | Glob 0 | Search 0
Bash calls containing grep/rg/ag/ack: 50,459私のスクリプトが最強のシグナルと呼んだカテゴリは構造的に空で、それにもかかわらずスクリプトは、自分にとって最強のシグナルが存在しえない証拠の上で、自信満々に HALT を返していた。
修正:検索をバイナリごとにシェルコマンドから抽出し(バイナリごとにオプション表が違う。-r は grep では値を取らず、ripgrep では --replace になる)、ゼロ値をフェイルクローズにする——NoSearchChannel は読み取りだけで検索のないコーパスを拒否する。欠けたチャネルは計器の穴であって、agent についての証拠には決してならないからだ。
修正後、fleet データベース全体に対して:symbol_lookup は読み取り総量の 0 から 15.6% に上がり、結論は HALT から PROCEED へ反転した。 あの構造的に空だったカテゴリが、最大の単一寄与者になった。
それでも出力には警告が1つ残る。結果がより頑健になったのではなく、より頑健でなくなったからだ:6,000 文字で判定し直すと PROCEED、24,000 文字では HALT になる。
実際に学んだこと
1. コードを書く前に制約を理解する。#164 の2つの硬いブロッカーはどちらも、私のモジュールを孤立して推論したことから来ていた。orchestrator の整合性ウィンドウの中での位置を推論していなかった。アーキテクチャこそ制約だ。
2. 良い PR は実装ではなく振る舞いを説明する。 レビューを通った本文はどれも、何が確立され、何が確立されていないかをはっきり書いていた。「未カバー」と「ローカルで検証できなかった」の部分は、設計の説明よりも大きな役割を果たした。
3. 見栄えのいい数字ではなく、正直な数字を報告する。 リポジトリの 25%、デグレード経路の 94%、ノイズは 3分の1 から 3分の2。これを口に出すことで、はじめて参考証拠として成立する。
4. テストは製品の一部。 追加したガードにはすべて陽性対照を付けた。自分の欠陥で赤くなり、復旧すると緑に戻る。#229 には 24 個の単行変異があり、23 個が捕捉された。唯一生き残ったものは、黙って無視するのではなく等価コードとして記録した。
5. 議論するのではなく測定する。 厳格なレビューを 3 巡して、いちばん反論しなかった指摘は、議論していれば負けていた指摘だった。メンテナからもらった数字を測り直した——3 通りの方法で、結果はすべて一致——これが重要だったのは、彼の根拠がすでに変わっていたからだ。
6. 自動化が増えても、信頼性が上がるとは限らない。 自動化された型証拠シグナルを加えたことで、かえって本物のレビュー結論を破壊する経路を導入してしまった。関門を一つ足すたびに、攻撃面が一つ増える。
7. 人手による承認はボトルネックではなく、信頼境界。 ここだけが責任が実際に誰かに落ちる場所であり、まずいマージが下流で生むあらゆるコストに比べれば、はるかに安い。
v0.2.4 で注目すべき点
リリース: https://github.com/no-human-ai/no_human/releases/tag/v0.2.4
approve-and-merge の修正——「動く」がどこで測られるかについての教訓
0.2.1〜0.2.3 では、パッケージ済みデスクトップアプリは pull request を開けてもマージできなかった。マージ関門が凍結バイナリ経由で外部コマンドを呼ぶとき、それを Python インタプリタとみなしていたため、nh approve のたびに、ボード上の Approve のたびに、テストステップで失敗していた。関門は正しいインタプリタを解決し、出力を最初から最後まで UTF-8 でデコードするようになった。
なぜ重要か: 人間の意思決定点は、この製品で最も重要なインターフェースだ。PR を開けるのにマージできないパイプラインは 90% 完成しているのではなく、人間が関与する唯一のステップで壊れている。
開発者への影響: パッケージ版 0.2.x を使っているなら、このループを評価する前にアップグレードすること——それまで評価していたのは、断ち切られた承認経路だ。
レビュー関門が、稼働中サーバーなしで再利用できる
セッション内でプラグイン skill として動かせるし、自分のリポジトリで GitHub Action として pull request に対して動かすこともできる。fork からの pull request は資格情報を読む前にスキップされる。
なぜ重要か: これは個人よりもチームに効く変更だ。この半分の検証は「ローカルで daemon を動かしている」ことに縛られず、CI が人間の書いた PR に対して呼び出せるものになった。
開発者への影響: 証拠ベースのレビュー関門が、agent が一度も触っていないコードにも使える。これは実質的に別の製品だ。
例: 共有ブランチにマージする PR に対して実行し、改ざん/再現/レビュアーの出力を、既存の CI の隣に並ぶチェックリストとして残す。
Windows 修正: これは脚注ではなくカテゴリだ
タイトルや出力にヘブライ語、キリル文字、日本語を含むタスクが、コミット時にクラッシュして作業を止めなくなった。Windows の改行で保存された .env が空ファイルとして読まれ、資格情報を黙って飲み込むことがなくなった。coder がドライブレター付きパス一つでリポジトリのコンテキストをすべて失うことがなくなった。
なぜ重要か: どれも見えない失敗の類だ。資格情報ファイルは明らかに空なのに存在しないものとして扱われ、coder はリポジトリのコンテキストなしで平然と走る——何かおかしくなっても、エラーは何も出ない。検証ゲートが止めようとしているのと同じ種類の失敗が、インフラ層で起きている。
今回のリリースに含まれるもの
- About の実行バージョン番号は同じソースから取得する。
nh task add --followsは、あるタスクが別のタスクを置き換えたことを記録する。- 署名の状況は正直に言う。macOS は署名・公証済みで stapled。Windows はコード署名なし——成果物には
-UNSIGNEDが付き、SmartScreen が警告を出すので、SHA256SUMS-windows.txtと自分で突き合わせて確認すること。Linux は.debとチェックサム付き AppImage を提供する。 - リリースノートには既知の問題が載っている。0.2.5 で修正予定の、Windows の非 UTF-8 コードページ読み取り経路の残存も含む。
既知の問題を自分から公表するリリースは、大したシグナルではない。だが、このプロジェクトの他の部分が発しているシグナルとは一致している。
自分で試す
Claude の資格情報と Claude Code CLI が必要で、インストール方法は問わない——バックエンドはタスクごとにこの CLI を呼ぶ。
# prerequisites
npm install -g @anthropic-ai/claude-code
claude setup-token
# install (CLI + board)
uv tool install no-human # or: pipx install no-human
# initialise, then prove the install is real
nh init && nh doctor# run
nh start # board + worker on 127.0.0.1:8420
nh task add https://github.com/org/repo/issues/42 --repo ~/git/repo
nh status # needs-you / working / waiting / done
nh review <id> # the reviewer's evidence checklist
nh diff <id> # the diff it wants to ship
nh approve <id> # your approval squash-lands the PR
nh reject <id> --reason "..." # send it back with feedbackソースから動かすなら、Python 3.12+、uv、git、npm 付きの Node も必要だ——ボードは独立した npm run build で、ソースチェックアウトには web/dist が含まれない。
何が起きるか: タスクがボードに現れ、計画を受け取り、実装され、テストを走らせ、検証ゲートを通り、最後に open PR として awaiting_approval に止まる。まず nh review <id> を走らせ、それから nh diff <id> を見る——証拠リストを先に読み、diff を後に見る。これこそ、この設計全体が身につけさせようとしている習慣だ。
すでに agent の中にいる? 公式 Python MCP SDK を使った stdio ブリッジの MCP server があり、公開しているツールは task_add と task_status の2つだけ。通信先は自分の no_human、アドレスは 127.0.0.1:8420 だけで、他には触らない。
nh mcp-serve{
"mcpServers": {
"no_human": { "command": "nh", "args": ["mcp-serve"] }
}
}Claude Code にとっては、このリポジトリ自体がプラグインマーケットになる:
/plugin marketplace add no-human-ai/no_human
/plugin install no-human@no-human-ai何かに依存する前に読んでおくべきドキュメント:verification.md(ゲートそのものと、その限界)と security.md。
このやり方が筋の通る場面
プロジェクトが明言しているのは、狙いが大きなタスクではないということだ。対象は範囲の明確な作業——バグ修正、テストの穴埋め、小さな機能、調査。曖昧なチケットはエスカレーションを引き起こすが、それは設計通りの挙動であって、避けるべき障害物ではない。
向いている場面:
- 再現可能な失敗経路があるバグ修正——再現ゲートが実際に機能する
- テストの穴やカバレッジに関するチケット
- リポジトリをまたぐ定型的なメンテナンス
- 調査タスク。「調べたのはこれ、確信が持てないのはこれ」という正直な報告がそのまま成果物になる
- agent ワークフローを試したいが、人間のマージゲートは手放したくないチーム
- CI と統合されたワークフロー。特にレビューゲートが Action として動くようになった今はなおさら
人が関わり続けなければならない場面:
- 受け入れ基準をテストに書き下せないアーキテクチャ級の変更
- セキュリティに敏感なコード——リポジトリ内のあらゆるものを実行するレビューゲートは、それ自体が攻撃面になる。プロジェクト自身のドキュメントにもそう書かれている
- diff に現れない範囲に影響する依存関係の変更
- チケット自体が問題である場合。受け入れ基準が不完全なら、どんなゲートでも埋め合わせはできない。
特に気に留めておきたい点
バランスの取れた評価をするには、居心地の悪い部分も口にする必要がある。そして評価すべきことに、そのほとんどはプロジェクト自身がドキュメントに書いている。
- レビュアーはモデルであり、モデルは見落とす。 公開されている確認実行(2026-08-11、
claude-opus-4-8、埋め込んだ欠陥19件+対照10件)で測定された再現率は 15/19(79%)、特異度は 7/10。有用なゲートではあるが、証明ではない。つまり偽陽性は常態であり、トリアージの人手を見込んでおく必要がある。 - **異なるモデルは盲点を共有しうる。**セッションの独立性は構造的なものだが、推論の独立性はそうではない。重なったデータで訓練された2つのモデルは、自信満々にそろって間違えられる。
- 「異なるモデル」はデフォルトであって不変条件ではない。 レビュアーと実装者を同じモデルにしても、止めるものは何もない。そうすると、設計全体が依存している性質が静かに消える。
- 読み取り専用のレビュアーは、構造的に読み取り専用ではない。 ドキュメントに率直に書かれている。編集系ツールは拒否されるが
Bashは拒否されないので、shell のリダイレクトでファイルを書けてしまう。拒否はツール呼び出しの層で、コマンドラインを読むガードによって行われる——これはコストであって証明ではないし、モデル化している記法の集合も閉じていない。 - ベンチマークは自分で走らせたもので、あなたには再現できない。 テストハーネスは再利用できるが、コーパスは作者のローカルパスに固定されている。同じ仕様でも、実行ごとに成功率は数ポイント変動する。エンコーダが非決定的だからだ。
- ドル建ての数字はどれも請求額ではない。 支出はコスト加重トークンで上限を切っている。プロジェクト自身のライフサイクル測定では、キャッシュ読み取りが消費トークンの95.6%を占めた。コスト見積もりは見積もりとしてしか扱えない。
- 自動テストは上限を与えるだけ。 ここでの検証はすべて既存のテストを基準にしている。ゲートが示せるのは、あるテストがベースラインで失敗し今は通ることまで。そのテストが正しいテストであることまでは示せない。
- 言語カバレッジは偏っている。 改ざんガードが読めるのは Python、JS/TS、Java。再現ゲートのデフォルトは pytest。
- デプロイ手順はない。 パイプラインは開いた PR で止まる。意図的にそうしている。
どれもこの手法の価値を損なうものではない。むしろ輪郭をはっきりさせる——そしてそのはっきりさこそ、これらの gate が求めているものだ。
もっと大きな問い
今の業界の問いはこうだ。AI はいったいどれだけのコードを書けるのか? 答えはもう出ている。たくさん、速く、しかもどんどん速く。
もっと有用な問いはこれだと思う:
AI はどれだけのエンジニアリング作業を担えるか——しかも、人間が独立に検証できる証拠を出しながら?
2つ目の問いこそが、やる気のある開発者が毎回の diff を睨みつける以上の規模に、この仕組みを広げられるかどうかを決めるからだ。生成できるコードの量は、レビュー能力で頭打ちになる。そしてレビュー能力は読む速さでは決まらない。判断を下す前にどれだけ再構築しなければならないかで決まる。
diff だけを投げてくる agent は、あなたにすべてを再構築させる。diff に加えて、merge base では失敗し head では通る再現、テスト完全性の差分、検証済みの file:line 参照を伴う新しい文脈のレビュアーによるチェックリスト、そしてルールごとのマージ判定を投げてくる agent は、自分の分だけでなくあなたの分の仕事も片付けている。
これが no_human の実際の中身であり、私が喜んで3つの PR を出し、ほとんどの人間のコードレビューより厳しいレビューを3巡受けた理由でもある。
ちなみに、この名前は冗談だ。アーキテクチャ全体が、人間が「はい」と言うことを中心に組み立てられている。
信頼できる AI 支援開発に興味があるなら
このプロジェクトは MIT ライセンスで、ローカルで動き、外部からのコントリビューションを本気で歓迎している。v0.2.4 にはコアプロジェクト以外の 5 人からの貢献が含まれていて、それぞれが contributors/ に CLA を記録し、コミットにも自分の名前を残している。
「コードを書く」以外の参加のしかた:
docs/verification.mdを読む。インストールするつもりがなくても、*「そして何をカバーしていないか」*の半分は、自動検証の限界について読んだ中で一番優れた短い文書だ。- オープンな PR の議論スレッドを読む。レビューの文化そのものがこのプロダクトだ。
- よく知っているリポジトリで小さなバグフィックスを一つ走らせ、
nh review <id>を先に読んでから diff を見る。 - issue を立てて、自分のコードベースでこれらの gate が拾えない失敗モードを教える。検証プロジェクトにできる一番役に立つ貢献だ。
- 自分も agent ツールを作っているなら、再現 gate をそのまま持って行くといい。概念としては 20 行しかないが、ここで一番価値のあるアイデアだ。
プロジェクトページとドキュメント: https://getnohuman.com/
GitHub: https://github.com/no-human-ai/no_human
v0.2.4 リリース: https://github.com/no-human-ai/no_human/releases/tag/v0.2.4
試した人がいたら、自分のリポジトリで最初に引っかかったのはどの gate だったか、そしてその判定が正しかったかどうかを知りたい。
謝辞
no_human は Eyal Golan(@eyalgolan)が作り、メンテナンスしている。この記事を書く機会をくれたこと、そして 3 回のレビューに感謝する——レビュー対象のコードより厳しくチェックされた。プロジェクトについての記述に誤りがあれば責任は私にあり、正しく書けている部分はすべて、ドキュメントとレビューが十分に率直だったおかげだ。あまり格好よくない部分も含めて。