OpenAI 用自家 LLM 设计 Jalapeño 芯片:不到 100 人,9 个月从 RTL 到流片
人工智能大幅缩短了其设计时间;它只会变得更快
中文
复制
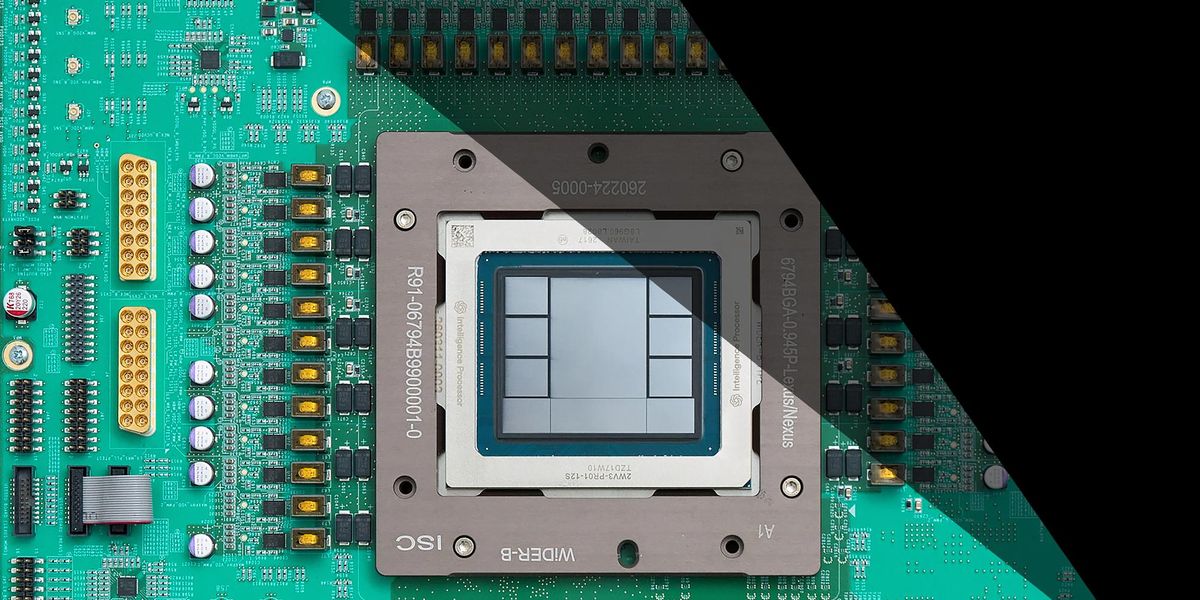
8月25日,OpenAI完整揭晓了Jalapeño——该公司首款AI加速芯片。Jalapeño提供最高13.4 petaflops的4-bit算力,可访问232 GB的当前最先进内存,连接带宽高达15.4 TB/s。OpenAI引用的基准测试显示,与英伟达的GB300相比——后者是该公司目前依赖的芯片——Jalapeño可将端到端延迟(从提示到最后一个token的时间)最多缩短3.6倍,且功耗更低。这些数字在Jalapeño大规模部署到OpenAI推理集群后能否转化为实际收益,尚待观察,但性能只是故事的一半。另一半是这颗芯片的设计方式——正如你所料,这一过程由OpenAI的大语言模型(LLM)加速。Jalapeño从首个架构概念到首次流片不到20个月。从第一版RTL——定义芯片逻辑的寄存器传输级代码——到tape-out(完成的设计交付制造),中间只隔了9个月。这个节奏已经很快,但专家认为,随着LLM不断进步并更深入地融入芯片设计工具,这样的速度很快就会显得慢。OpenAI对其中机会的乐观并不令人意外。“模型正在赋予我们的工程师超能力,”OpenAI硬件副总裁Richard Ho说。“工程师仍然主导工作。他们仍然是最终拍板的人。但他们能做的事快得多。他们能探索的路径多得多。”
OpenAI用一支小规模设计团队快速拿到成果
Ho说,设计Jalapeño的团队在整个项目期间平均不到100人,如今团队推进第二代和第三代设计,规模仍大致维持在100人。这个数字涵盖硬件团队中从系统设计到软件和供应链的各类岗位,但不包括与OpenAI合作该项目的博通人员。
OpenAI 与 Broadcom 的分工大体上按设计与实现划分。OpenAI 团队负责端到端系统设计,包括推理加速器、内存层次结构和网络。Ho 说,Broadcom 负责“从门级开始的物理设计”。
与 Broadcom 的合作让一些人对 OpenAI 的速度有所保留。David Chin 是芯片设计智能体初创公司 Verkor.io 的联合创始人,他说“他们给出的时间表相当可信”,但认为 Broadcom 的帮助对 Jalapeño 的快速推进不可或缺。“如果换成别人从零开始,根本不可能做到,”他说。同样在 Verkor 任联合创始人的 Ravi Krishna 称 OpenAI 的速度“是一个相当亮眼的成果”,但他补充说,如果这个项目今天才启动,LLM 能力的提升可能会让时间表进一步缩短。
加州大学圣地亚哥分校杰出教授 Andrew Kahng 也认为 OpenAI 的速度值得注意,称其“很可能是当今业界最好的”。Kahng 回忆起他参与组织的 2016 年 IEEE Design Automation Futures 研讨会。那场研讨会的主讲嘉宾是 Richard Ho,当时他还是 Google 的工程师。Ho 对设计自动化有很强的看法,他把完成一颗芯片设计所需的时间表述为团队一天能完成多少次迭代的函数。
OpenAI 的 LLM 如何加速 Jalapeño 的设计
“自动化本身在芯片设计领域已经存在了几十年,这不是什么新问题,”马里兰大学帕克分校半导体计划与创新主任 Ankur Srivastava 说。但 LLM 与以往的自动化工具不同之处在于,它们能理解语言和代码。他说,这让它们特别适合那些“仍处于问题的语言范畴内”的芯片设计任务。
OpenAI 团队设计了一套发挥这一优势的工作流。OpenAI 的前端工作流围绕 Accelerated Hardware Synthesis(XLS)构建,这是一套开源的高层次综合工具链,最初由 Google 开发。高层次综合是一种芯片设计自动化形式,让工程师能在更熟悉的编程环境中设计芯片。就 XLS 而言,芯片设计者可以用 DSLX(一种受 Rust 启发的领域特定语言)和 C++ 等语言编写,XLS 再将其转换为 Verilog——一种用于描述电子系统的硬件描述语言。
“我们当时在想怎么利用 AI 让项目跑得更快,而 AI 在看起来像软件的东西上表现好得多,”OpenAI 的技术团队成员 Chris Leary 说。“XLS 在某种程度上看起来就像软件,所以它也沾了这个光。”Leary 对 XLS 应该怎么运作极为熟悉,这也帮了忙——XLS 正是他在 Google 期间启动的。
Kahng 也认为,用 AI 加速 XLS 这类高层次综合是合理的,因为这“对 LLM 来说更自然”,也提供了快速迭代的机会。“我认为这是一种普遍有用的工作流,而且它在未来‘站得住脚’,”他说。
同样的逻辑让 Jalapeño 团队把重点放在了软件优化上。5 月第一批芯片从代工厂回来时,团队把内部的 AI 模型用于设计软件,来跑 SemiAnalysis 的 InferenceX 等基准测试。在 DeepSeek 的多头潜在注意力 kernel 基准上,性能从理论天花板(由芯片的算力和内存带宽决定)的 0.31% 攀升到 88.94%,用时约 40 小时。Ho 说这个结果可以复现,因此从代工厂交付首批芯片到量产爬坡之间的时间可以缩短。“我们所有的进度假设,都将建立在我们现在拥有这项能力这一事实之上,”他说。
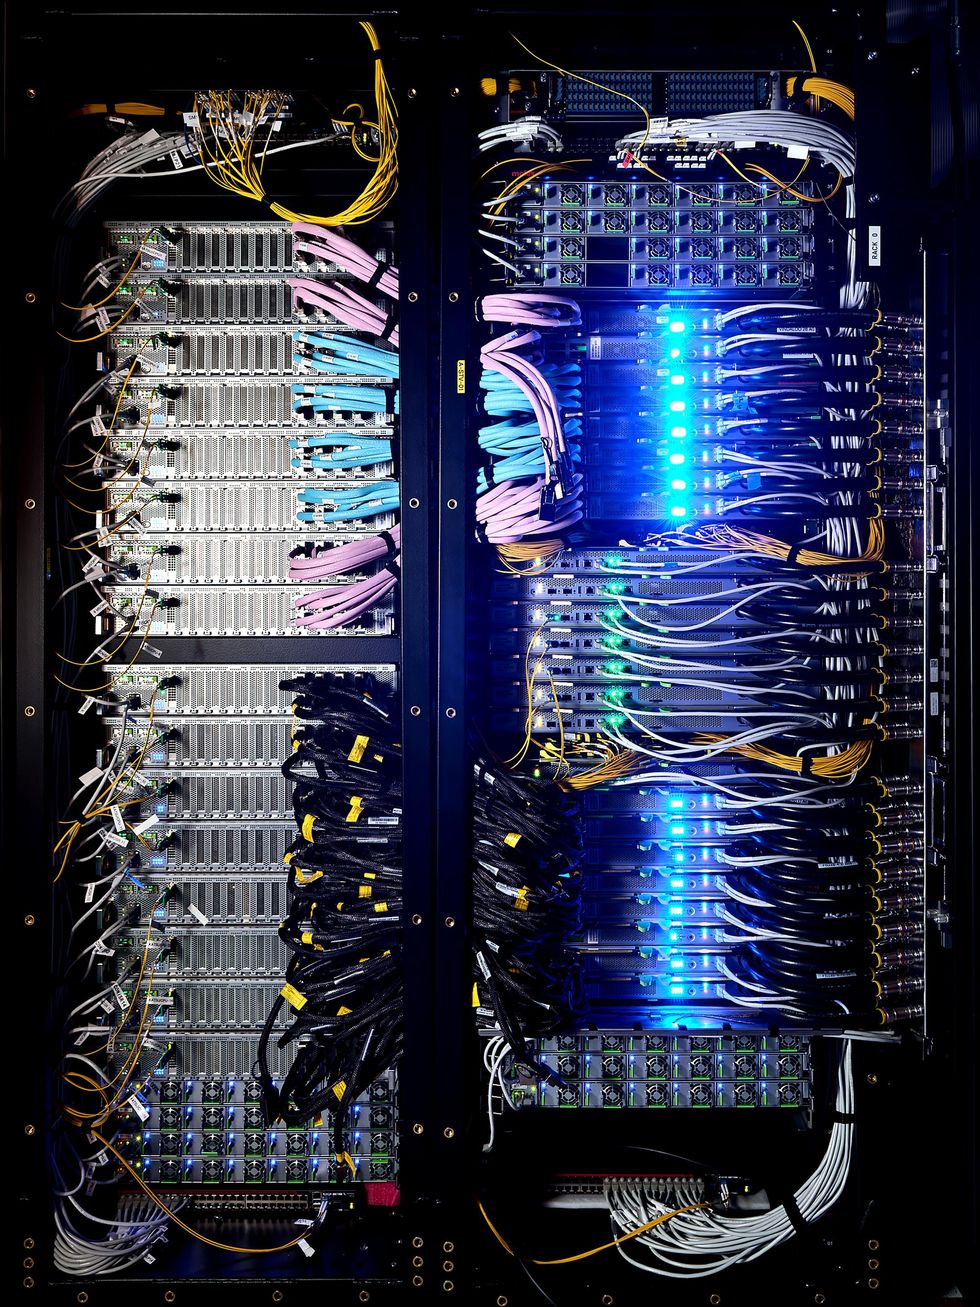
Jalapeño 面向包含 2,048 颗芯片的 pod 部署设计。OpenAI
Jalapeño 团队这套 AI 辅助工作流的大致轮廓,Ho 和 Leary 一开始就猜到了,但 OpenAI 模型的进步还是带来了一些意外。
Leary 说,项目起步时靠的是 OpenAI o3 这类模型的辅助,o3 于 2025 年 4 月公开发布(但 Jalapeño 团队更早就用上了)。到项目收尾时,团队已经能用上 GPT-6 Astra 的前身模型,而 GPT-6 Astra 直到 2026 年 9 月 3 日才公开发布。Leary 说,新模型可以直接在 Verilog 里工作,不再需要 XLS 从普通编程语言做转换,而且已经接近能自行操作专有设计工具。
Ho 还确认,团队可以使用经过芯片设计微调、不对外公开的内部 LLM。但他拒绝透露具体用了哪些模型,只补充说,Jalapeño 团队与 OpenAI 的研究团队有合作。设计 Jalapeño 所用的具体模型并非全部对外公开,但 Ho 表示,目标是把这个项目积累的经验带进公司的商用 LLM。“可以肯定地说,Astra 及其后续模型会非常擅长芯片设计,”他说。
AI 在后端优化上作用较小,但这种情况可能改变
如前所述,OpenAI 在 Jalapeño 上的大部分工作集中在芯片设计的“前端”,涵盖从最初概念、编写 RTL 代码定义设计,到验证设计在物理实现后能否正常工作的各个环节。后端设计的很大一部分——包括互连布线、完成并验证时钟与电源规格、向代工厂提交所需设计信息等任务——交给了 Broadcom,由后者将芯片推进到量产。
但这并不意味着 OpenAI 的工作流忽略了后端。Jalapeño 团队中有物理设计工程师,他们与 Broadcom 的对应人员协作,就芯片的布局规划和布线等事项提供指导。
在 IEEE Hot Chips 2026 上,Ho 和 Leary给出了 AI 引导物理设计优化所带来的具体收益:以经过优化的人工基线为参照,矩阵乘法单元的面积减少了 10%。换句话说,OpenAI 声称 AI 引导的优化帮助在同样的硅片面积内塞进了更多电路,这是此前做不到的。
Broadcom 使用的是自己的内部工作流。其团队无法访问 OpenAI 用于辅助设计 Jalapeño 的内部模型,但可以使用 OpenAI 公开的商用模型。
Verkor 的 Ravi Krishna 表示,OpenAI 在后端设计上的做法如今看来已经有些保守。他认为这是项目启动时间造成的——该项目始于 2024 年 10 月。“过去四到五个月的模型已经有了进步。从 [2026 年] 4 月起……它们才真正开始能更好地处理这些任务,”他说。Verkor 联合创始人 Suresh Krishna 也认同这一看法:“没有理由不能用一个 agentic loop 来大幅加速流程的后端部分。”
Ho 和 Leary 还暗示,与团队接下来的工作相比,设计 Jalapeño 所用的工作流可能显得过时。
“你可以想象,做 [Jalapeño] 的时候,我们想尽可能快。所以这里有个取舍:‘我们是花时间做点创新,还是做历史上已知可行的事?’”Leary 说。“到了第二代,我们有了某种重置的机会,可以重新审视所有我们想搭建起来的东西。”
Ho 说,第二代芯片的工作流“有很多地方我们正在引入 [AI]”。他提到在验证和物理设计上有更多借助 AI 的空间。Leary 补充说,团队现在有了自动处理波形和查看波形的工具。这可以自动分析,找出与故障相关的芯片时钟信号,从而在硬件还在设计阶段时就改进调试。
尽管有这些预期中的改进,Ho 和 Leary 明确表示,他们并不认为芯片设计可以完全自动化。“我们不是说,任何人都能只靠 [OpenAI 的编程平台] Codex 就造出最先进的前沿 AI/ML 加速器芯片,”Ho 解释道。“我们说的是非常具体的一些事:如何在 Codex 上做得更好,以及我们如何聚焦于小团队和快节奏,以取得高质量的结果。”
来自本站文章