OpenAIが自社LLMでJalapeñoチップを設計:100人未満、9か月でRTLからテープアウト
人工知能は設計時間を大幅に短縮した。それはさらに速くなるだけだ
日本語
コピー
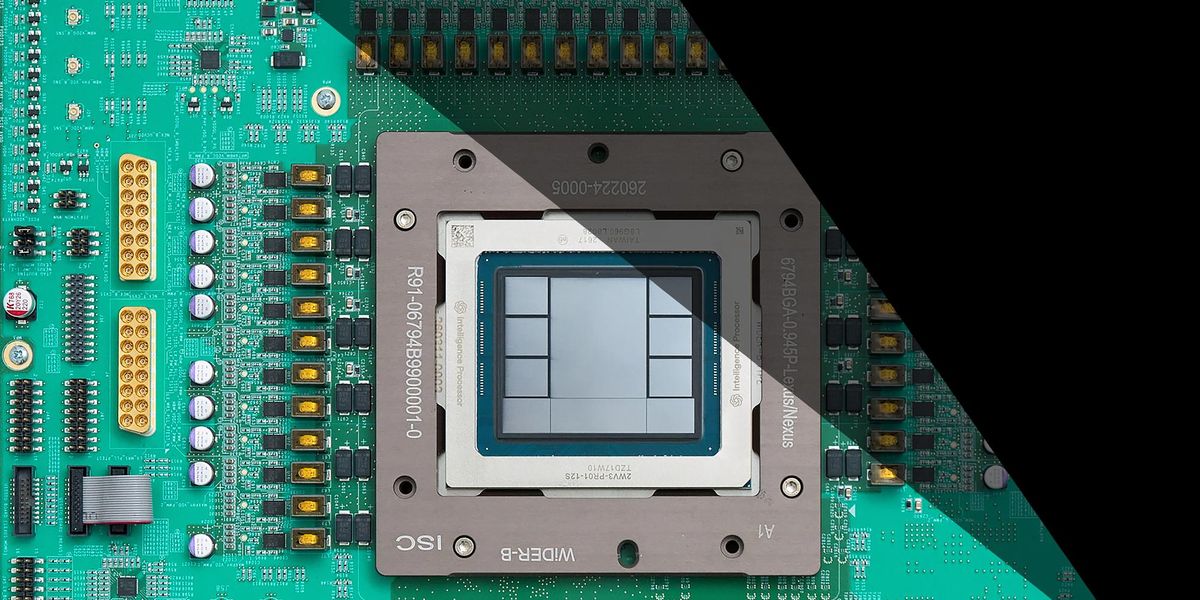
8月25日、OpenAIはJalapeñoの全貌を明らかにした。同社初のAIアクセラレータチップである。Jalapeñoは最大13.4ペタフロップスの4ビット演算性能を備え、232 GBの最先端メモリにアクセスでき、接続帯域は最大15.4 TB/sに達する。OpenAIが引用したベンチマークによれば、同社が現在依存しているNVIDIAのGB300と比べて、Jalapeñoはエンドツーエンドのレイテンシ(プロンプトから最後のトークンまでの時間)を最大3.6分の1に短縮し、しかも消費電力はより少ない。この数字が、JalapeñoをOpenAIの推論クラスタに大規模展開した後も実際の成果につながるかは未知数だが、性能は物語の半分にすぎない。もう半分は、このチップの設計手法だ。ご想像のとおり、そのプロセスはOpenAIの大規模言語モデル(LLM)によって加速されている。Jalapeñoは最初のアーキテクチャ構想から初回テープアウトまで20か月足らずだった。チップの論理を定義するRTL(レジスタ転送レベル)コードの初版から、テープアウト(完成した設計を製造へ引き渡すこと)まではわずか9か月しかない。このペースはすでに速いが、LLMが進歩を続け、チップ設計ツールにいっそう深く組み込まれるにつれ、こうした速度はまもなく遅く見え始めると専門家は見る。OpenAIがそこにチャンスを見ているのは不思議ではない。「モデルはエンジニアに超能力を与えつつある」とOpenAIのハードウェア担当バイスプレジデント、Richard Hoは言う。「主導権は依然としてエンジニアにある。最終判断を下すのも彼らだ。だが、できることははるかに速くなり、探索できる道もはるかに増えた」
OpenAIは小規模な設計チームで素早く成果を上げた
Hoによれば、Jalapeñoを設計したチームはプロジェクト期間を通じて平均100人未満で、第2世代・第3世代の設計を進める現在も規模はほぼ100人のままだという。この数字はシステム設計からソフトウェア、サプライチェーンまでハードウェアチームの各種職種を含むが、このプロジェクトでOpenAIと協業したBroadcomの人員は含まない。
OpenAIとBroadcomの役割分担は、おおむね設計と実装で分かれている。OpenAIのチームが推論アクセラレータ、メモリ階層、ネットワークを含むエンドツーエンドのシステム設計を担う。Hoによれば、Broadcomは「ゲートレベルからの物理設計」を担当する。
Broadcomとの協業があるだけに、OpenAIの速度を割り引いて見る向きもある。チップ設計エージェントのスタートアップVerkor.ioの共同創業者であるDavid Chinは、「彼らが示したスケジュールはかなり信憑性がある」としつつ、Jalapeñoの迅速な開発にBroadcomの助力が不可欠だったと見る。「他の誰かがゼロから始めていたら、到底不可能だった」と彼は言う。同じくVerkorの共同創業者であるRavi KrishnaはOpenAIの速度を「かなり際立った成果」と評する一方、このプロジェクトが今始まっていたら、LLMの能力向上によってスケジュールはさらに短くなり得ただろうと付け加えた。
カリフォルニア大学サンディエゴ校の特別教授Andrew KahngもOpenAIの速度は注目に値するとし、「おそらく現在の業界で最速」と評した。Kahngは自身が組織に関わった2016年のIEEE Design Automation Futuresワークショップを思い起こす。そのワークショップの基調講演者は、当時GoogleのエンジニアだったRichard Hoだった。Hoは設計自動化について強い意見を持ち、チップ設計を完了するまでの時間を、チームが1日に何回イテレーションを回せるかの関数として表現していた。
OpenAIのLLMはJalapeñoの設計をどう加速したか
「自動化そのものはチップ設計の世界に何十年も前からあり、新しい問題ではない」と、メリーランド大学カレッジパーク校で半導体プログラム・イノベーションの責任者を務めるAnkur Srivastavaは言う。だがLLMが従来の自動化ツールと違うのは、言語とコードを理解できる点だ。そのおかげで、依然として「問題が言語の範疇にとどまっている」チップ設計のタスクに特に向いていると彼は話す。
OpenAIのチームは、この強みを活かすワークフローを組み上げた。OpenAIのフロントエンドのワークフローは、もともとGoogleが開発したオープンソースの高位合成ツールチェーン、Accelerated Hardware Synthesis(XLS)を軸にしている。高位合成とはチップ設計自動化の一形態で、エンジニアはより馴染みのあるプログラミング環境でチップを設計できる。XLSの場合、設計者はRustにヒントを得たドメイン固有言語DSLXやC++などで記述し、XLSがそれを電子システムを記述するためのハードウェア記述言語Verilogへ変換する。
「AIを使ってプロジェクトを速く進める方法を考えていたが、AIはソフトウェアに見えるもののほうがはるかに得意だ」と、OpenAIの技術チームメンバーであるChris Learyは言う。「XLSはある意味ソフトウェアのように見えるので、その恩恵を受けた」。LearyがXLSの仕組みを極めてよく知っていたことも助けになった。XLSは彼がGoogle時代に立ち上げたものだからだ。
Kahngも、XLSのような高位合成をAIで加速するのは理にかなっていると見る。これは「LLMにとってより自然」であり、高速にイテレーションを回す機会も生むからだ。「普遍的に有用なワークフローだと思うし、今後も『通用し続ける』だろう」と彼は言う。
同じ論理で、Jalapeño チームはソフトウェア最適化に重点を置いた。5 月に最初のチップがファウンドリから戻ってくると、チームは社内の AI モデルを設計ソフトウェアに組み込み、SemiAnalysis の InferenceX などのベンチマークを走らせた。DeepSeek の multi-head latent attention kernel のベンチマークでは、性能は理論上の天井(チップの演算性能とメモリ帯域で決まる)の 0.31% から 88.94% まで、約 40 時間で伸びた。Ho によればこの結果は再現可能で、ファウンドリからの初回チップ納入から量産立ち上げまでの期間を短縮できる。「私たちのスケジュール前提はすべて、今この能力を手にしているという事実の上に立つことになります」と彼は言う。
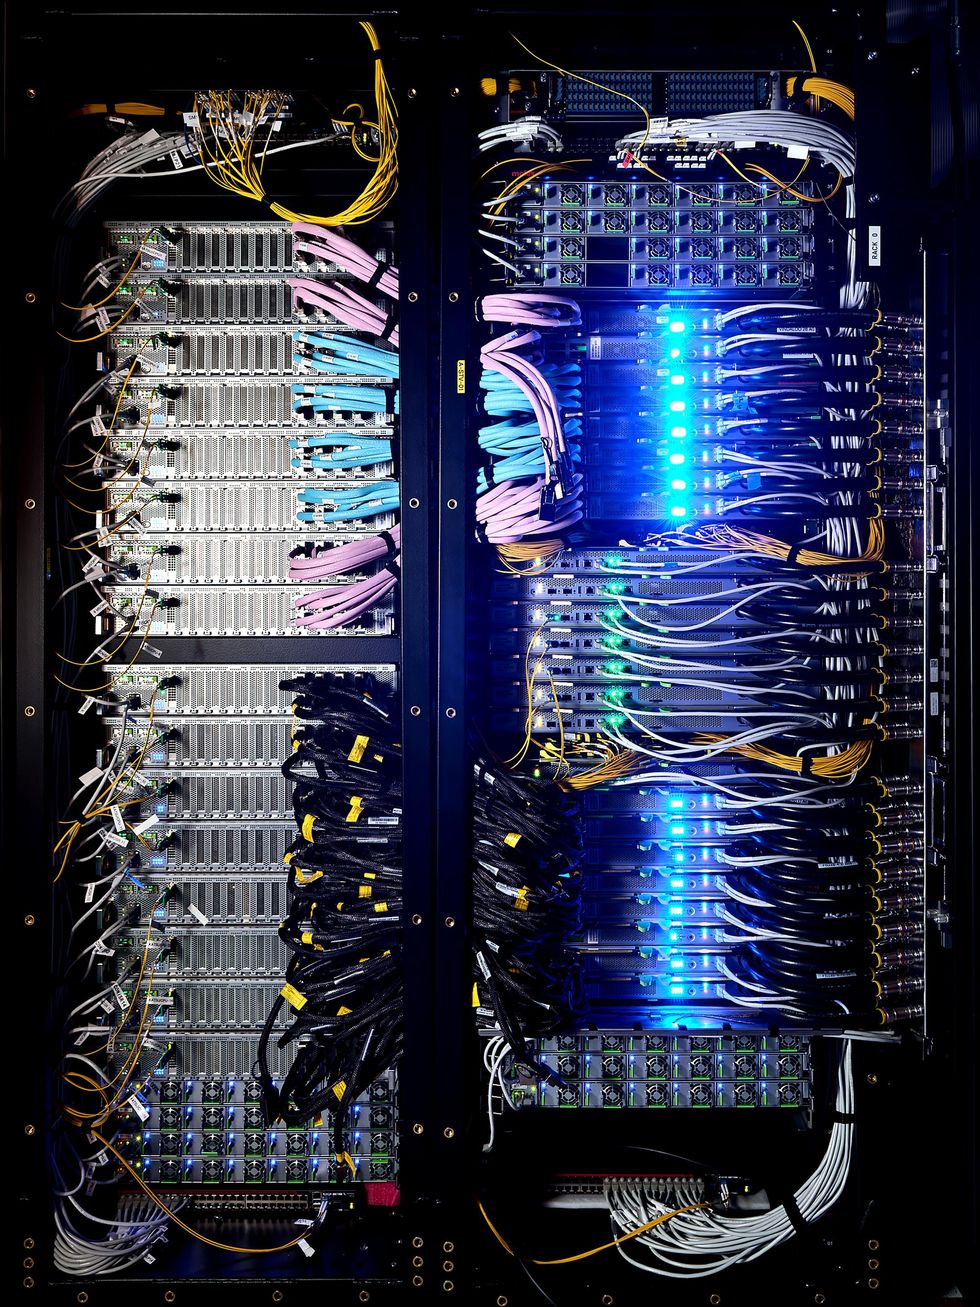
Jalapeño は 2,048 個のチップを含む pod への配備を想定して設計されている。OpenAI
Jalapeño チームのこの AI 支援ワークフローの大まかな輪郭は、Ho と Leary が当初から予想していた。それでも OpenAI のモデルの進歩は、いくつかの意外をもたらした。
Leary によれば、プロジェクトの立ち上げ時は OpenAI o3 のようなモデルの支援に頼っていた。o3 が公開されたのは 2025 年 4 月だが(Jalapeño チームはそれより早く使っていた)、プロジェクトの終盤には GPT-6 Astra の前身モデルを使えるようになっていた。GPT-6 Astra の公開は 2026 年 9 月 3 日だ。Leary は、新しいモデルは Verilog で直接作業できるようになり、通常のプログラミング言語から変換する XLS は不要になったと話す。専有の設計ツールを自分で操作するのも間近だという。
Ho は、チップ設計で微調整された非公開の社内 LLM も使えたと認めている。ただし具体的にどのモデルを使ったかは明かさず、Jalapeño チームは OpenAI の研究チームと協力していると付け加えた。Jalapeño の設計に使ったモデルのすべてが公開されているわけではないが、Ho いわく、狙いはこのプロジェクトで蓄積した知見を同社の商用 LLM に持ち込むことにある。「Astra とその後継モデルがチップ設計を非常に得意にするだろうとは、はっきり言えます」と彼は述べた。
AI の貢献はバックエンド最適化では小さいが、それは変わりうる
前述のとおり、Jalapeño に関する OpenAI の作業の大半は、チップ設計の「フロントエンド」に集中している。初期構想から、設計を定義する RTL コードを書き、物理実装後に設計が正しく動くかを検証するまでの各段階だ。バックエンド設計の大部分——配線、クロックと電源仕様の確定と検証、ファウンドリへの必要な設計情報の提出など——は Broadcom に委ねられ、同社がチップを量産へと進めた。
とはいえ、OpenAI のワークフローがバックエンドを無視しているわけではない。Jalapeño チームには物理設計エンジニアがおり、Broadcom の担当者と協力して、チップのフロアプランや配線などについて指示を出した。
IEEE Hot Chips 2026 で、Ho と Learyは AI に導かれた物理設計最適化の具体的な成果を示した。最適化済みの手作業ベースラインを基準に、行列乗算ユニットの面積が 10% 減ったのだ。言い換えれば、AI に導かれた最適化によって、同じシリコン面積により多くの回路を詰め込めるようになった——これまではできなかったことだと OpenAI は主張している。
Broadcom は自社の社内ワークフローを使っている。同社のチームは Jalapeño の設計支援に使われた OpenAI の社内モデルにはアクセスできないが、OpenAI の公開商用モデルは利用できる。
Verkor の Ravi Krishna は、バックエンド設計に対する OpenAI のアプローチは今となってはやや保守的に見えると語る。原因はプロジェクトの開始時期にあると彼は見る。プロジェクトが始まったのは 2024 年 10 月だ。「この 4、5 か月のモデルは進歩しています。[2026 年] 4 月以降は……こうしたタスクを本当にうまく扱えるようになってきました」と彼は言う。Verkor の共同創業者 Suresh Krishna も同調する。「agentic loop を使ってプロセスのバックエンド部分を大幅に加速できない理由はありません」。
Ho と Leary はさらに、Jalapeño の設計に使ったワークフローが、チームの次の仕事に比べれば時代遅れに見えるかもしれないと示唆した。
「[Jalapeño] を作っているときは、できるだけ速く進めたいわけです。そこにはトレードオフがあります。『時間をかけて何か新しいことをやるか、歴史的にうまくいくと分かっていることをやるか』という」と Leary は言う。「第 2 世代では、ある種のリセットの機会が得られ、作りたいと思っていたものをすべて見直せます」。
Ho によれば、第 2 世代チップのワークフローでは「多くの箇所に [AI] を導入しつつある」。検証と物理設計には、AI をもっと活用する余地があるという。Leary は、波形を自動で処理し、確認するツールができたと付け加えた。これにより、障害に関係するチップのクロック信号を自動で分析し、ハードウェアがまだ設計段階にあるうちにデバッグを改善できる。
こうした改善を見込んでいるとはいえ、Ho と Leary はチップ設計を完全に自動化できるとは考えていないと明言する。「誰でも [OpenAI のコーディングプラットフォーム] Codex だけで最先端のフロンティア AI/ML アクセラレータチップを作れる、と言っているのではありません」と Ho は説明する。「言っているのはごく具体的なことです。Codex 上でどうすればもっとうまくやれるか、そして小さなチームと速いペースに集中して高品質な結果をどう得るか、ということです」。
本站の記事より