Fable 5 对 GPT-5.6 Sol:花掉 2,000 美元、烧掉 20 亿 token,谁更会写 Expo 应用
三个 AI 模型各一次性做出三个 Expo 应用,烧掉 20 多亿 token、花费 2,000 美元,Fable 5 在代码与 UI 质量上胜出。
中文
复制
我给三个 AI 模型同一个 prompt,让它们各自一次性做出三个 Expo 应用。代码和 UI 质量上,Fable 5 赢了。
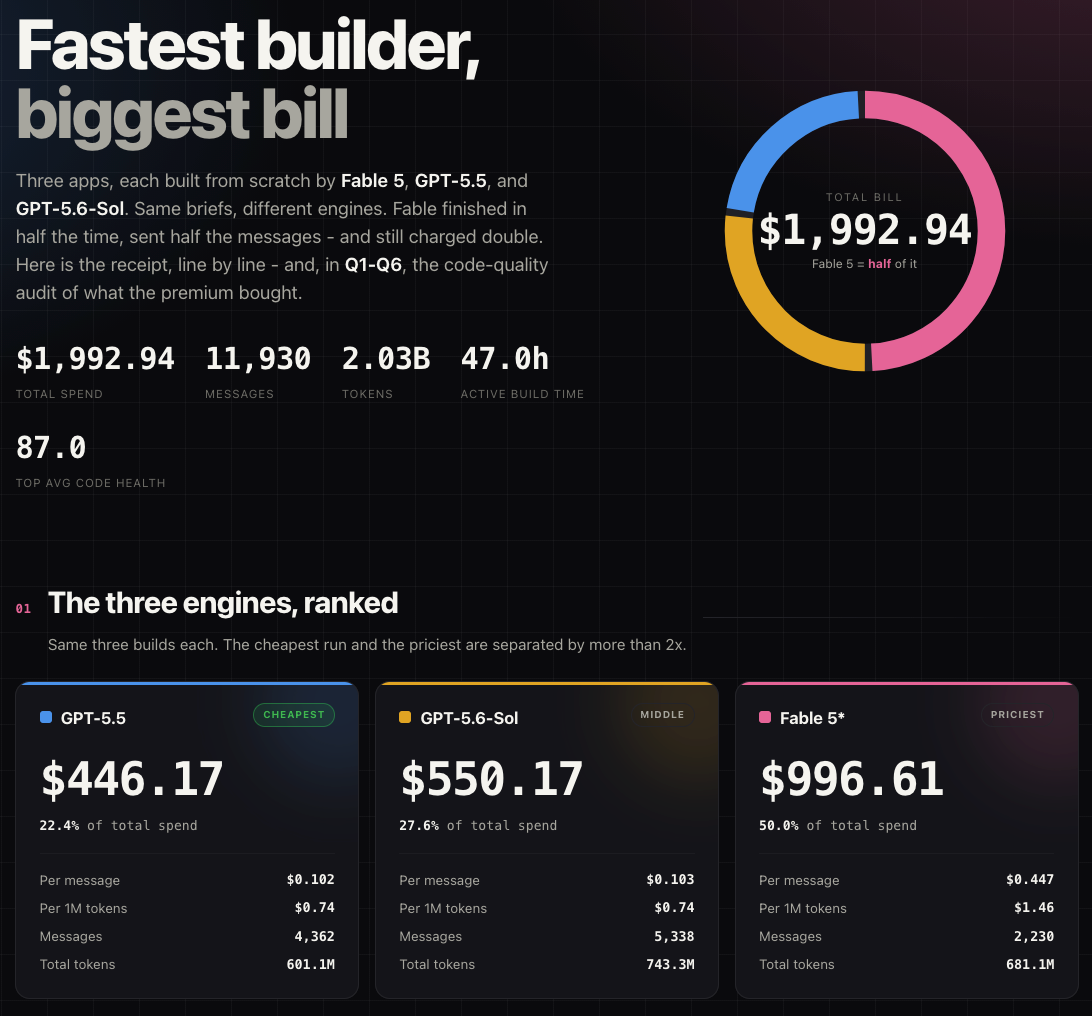
为了搞清楚谁才是移动应用开发之王,我烧掉了 20 多亿 token、花了 2,000 美元,用三个不同的 AI 模型各自一次性做出三个不同的 Expo 应用。
整个流程模型都走了一遍:创意、开发、自主测试、验证、调试,中间所有环节。三个应用都用 Expo 和 React Native 构建,我没碰过一行代码。
读完这篇你就知道该用哪个模型来一次性做出自己的应用。下面是这次实验的关键数字:
更想看视频?完整视频在这里:
规则
参赛选手:
- Fable 5(Claude Code)
- GPT-5.6 Sol(Codex)
- GPT-5.5(Codex),作为对照
每个模型都开到 high effort,拿到的是完全相同的 prompt——用规格驱动开发 skill 生成的。相同的起始模板、相同的工具、相同的规则。
如果你好奇我是怎么让 AI 一次性做出整个应用、还没有 bug、代码质量也不错的:靠循环和验证。规格要求每个模型:每一项实现任务在提交之前都必须达到一条固定的门槛。其中一条是:每个功能都必须在 iOS 模拟器上验证过才能往下走。
剧透一下:后来最烧 token 的恰恰就是这个模拟器验证。文末再说。
应用 1:AI 卡路里记录
第一个测试:做一个 AI 卡路里记录应用,设计参照 Cal AI(顺带一提,它本身就是 React Native 写的)。左边是 GPT 5.5,中间是 5.6 Sol,右边是 Fable 5。
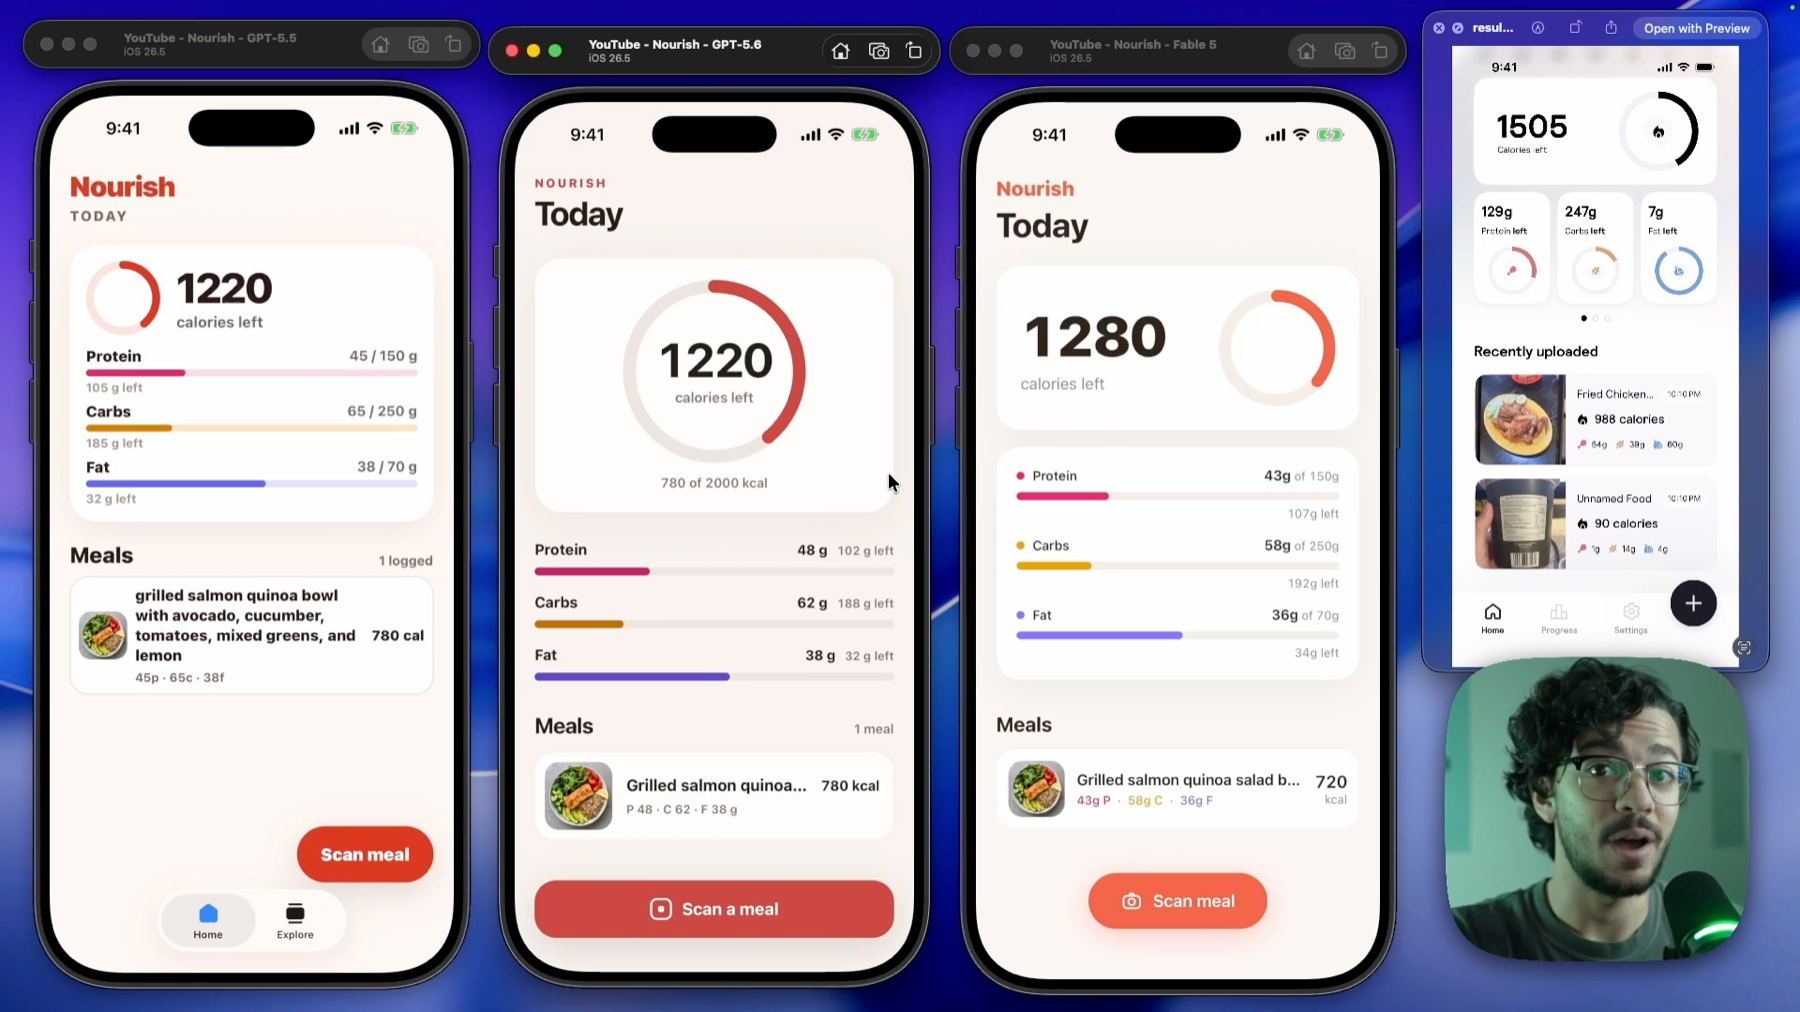
三者的产出都很接近。我喜欢 GPT 5.5 显示 94% 置信度这一点,另外两个没有。但我不喜欢它的标签。非要选一个的话,我选 Fable 5,5.6 紧随其后。
整体 UI 上:Fable 5 的一致性做得很到位,阴影、边框,一切都干净、连贯;GPT 两个模型看起来更割裂。GPT 5.5 还从 Expo 起始模板里带出来一个没用的 “explore” 页面——样板代码还留在应用里,不知道为什么不删。
该夸就夸:首页的细节上 5.6 做得最好。它精确显示了你今天用掉了多少预算、吃了几餐。Fable 5 没做到,真正的 Cal AI 也没做到。
应用 1 指标
| Fable 5 | GPT-5.6 Sol | GPT-5.5 | |
|---|---|---|---|
| cost | $276.95 | $170.16 | $157.23 |
| active time | 3h 45m | 5h 17m | 5h 20m |
| cost per hour | $74/h | $32/h | $29/h |
| messages | 1,061 | 1,724 | 1,512 |
| lines of code | 3.7k | 4.3k | 4.7k |
| code health (0-100) | 88 | 79 | 79 |
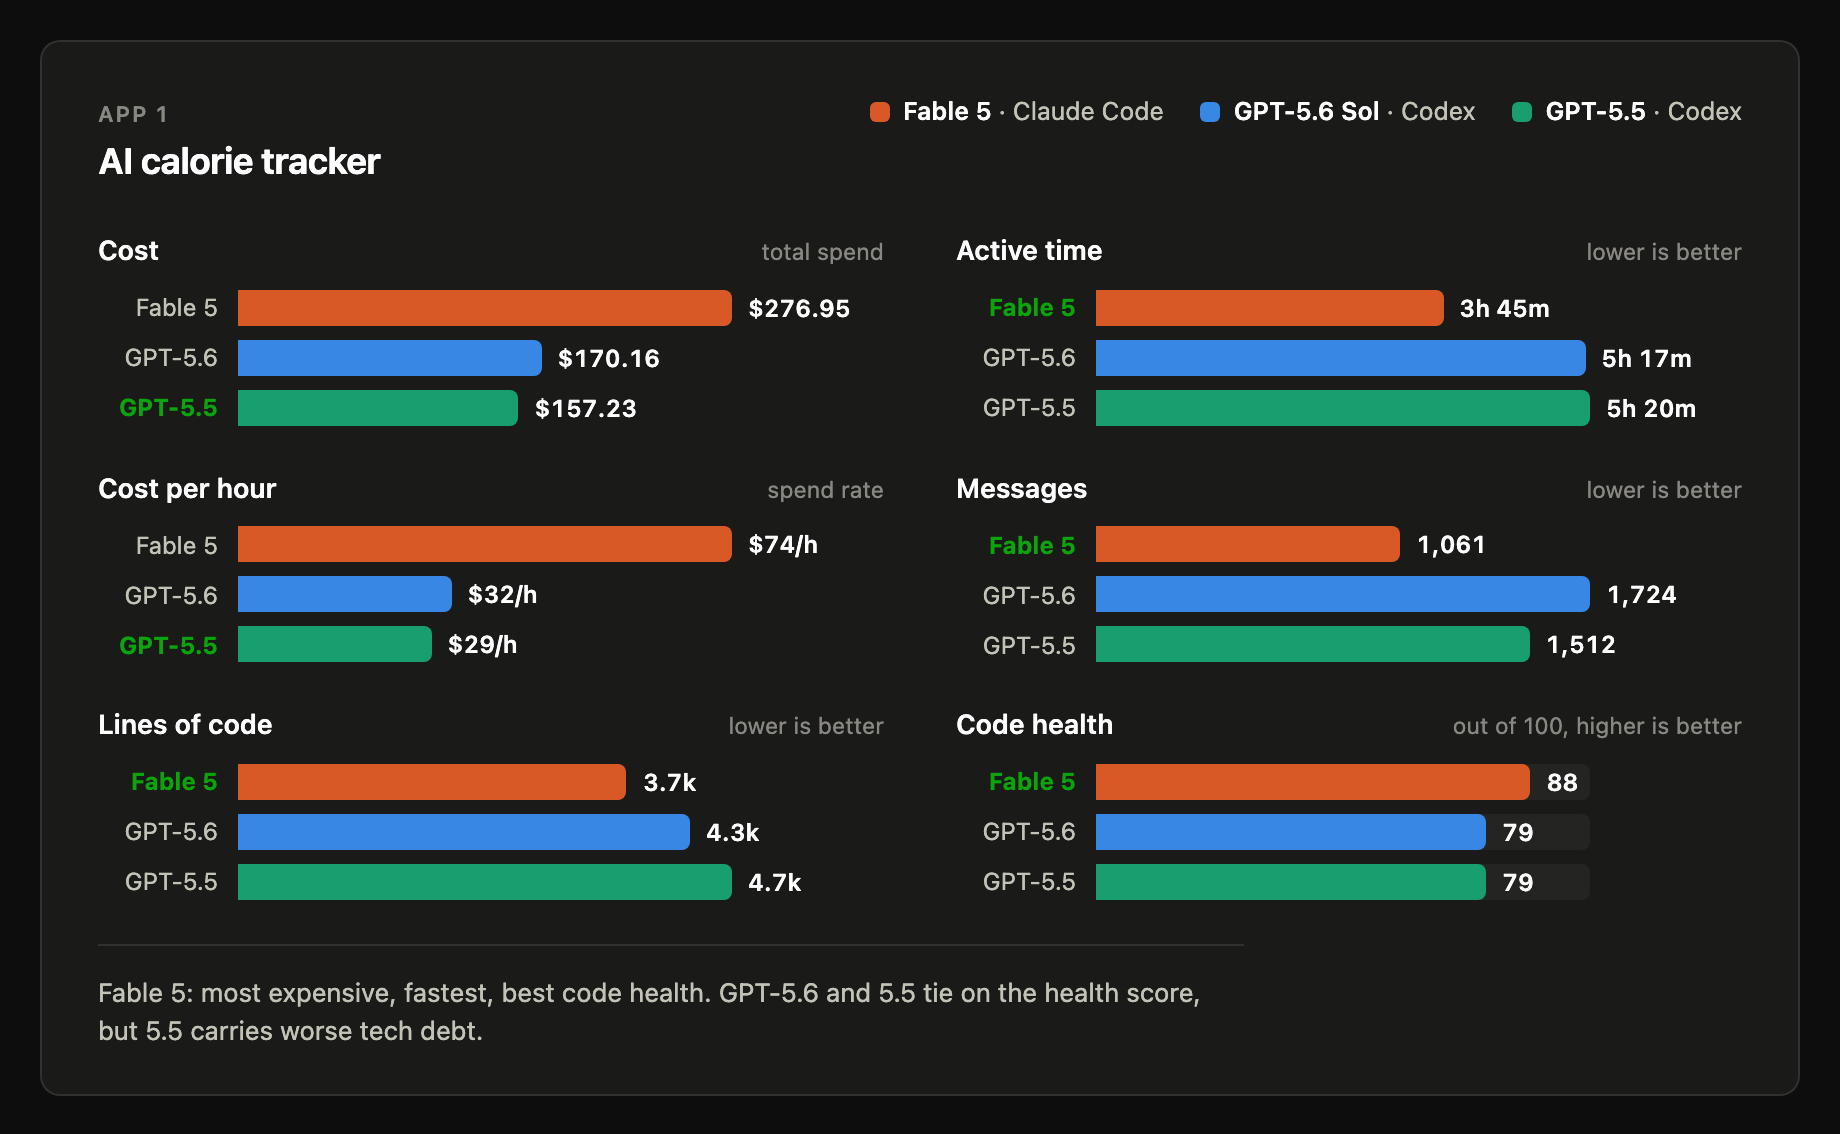
Fable 5 最贵,也最快:每小时 74 美元,GPT 两个模型分别是 32 和 29 美元。这个应用上代码行数差不多,但胜利还是 Fable 5 的。
代码质量就有意思了。这项也是 Fable 5 赢;5.5 和 5.6 健康分打平,但 5.5 的技术债更重——这是你在三个应用里都会反复看到的规律。这些审计我用了代码质量评分 skill,全部代码和 codebase skill 都在这个仓库里。
如果你好奇后端用的什么:一条 Expo API route。80 行后端。做 Expo 应用有时候就这么点东西。它用 OpenAI Agents SDK,接收一个 POST 请求来扫描图片。如果你还没试过,这里是 Expo API routes 文档。
应用 2:ChatGPT 克隆
第二个测试:克隆 ChatGPT。后端思路一样(Expo API route + OpenAI Agents SDK),这次的设计参照就是 ChatGPT 应用本身——我觉得它的设计挺不错。
第一个问题:AI 真的能跑吗?
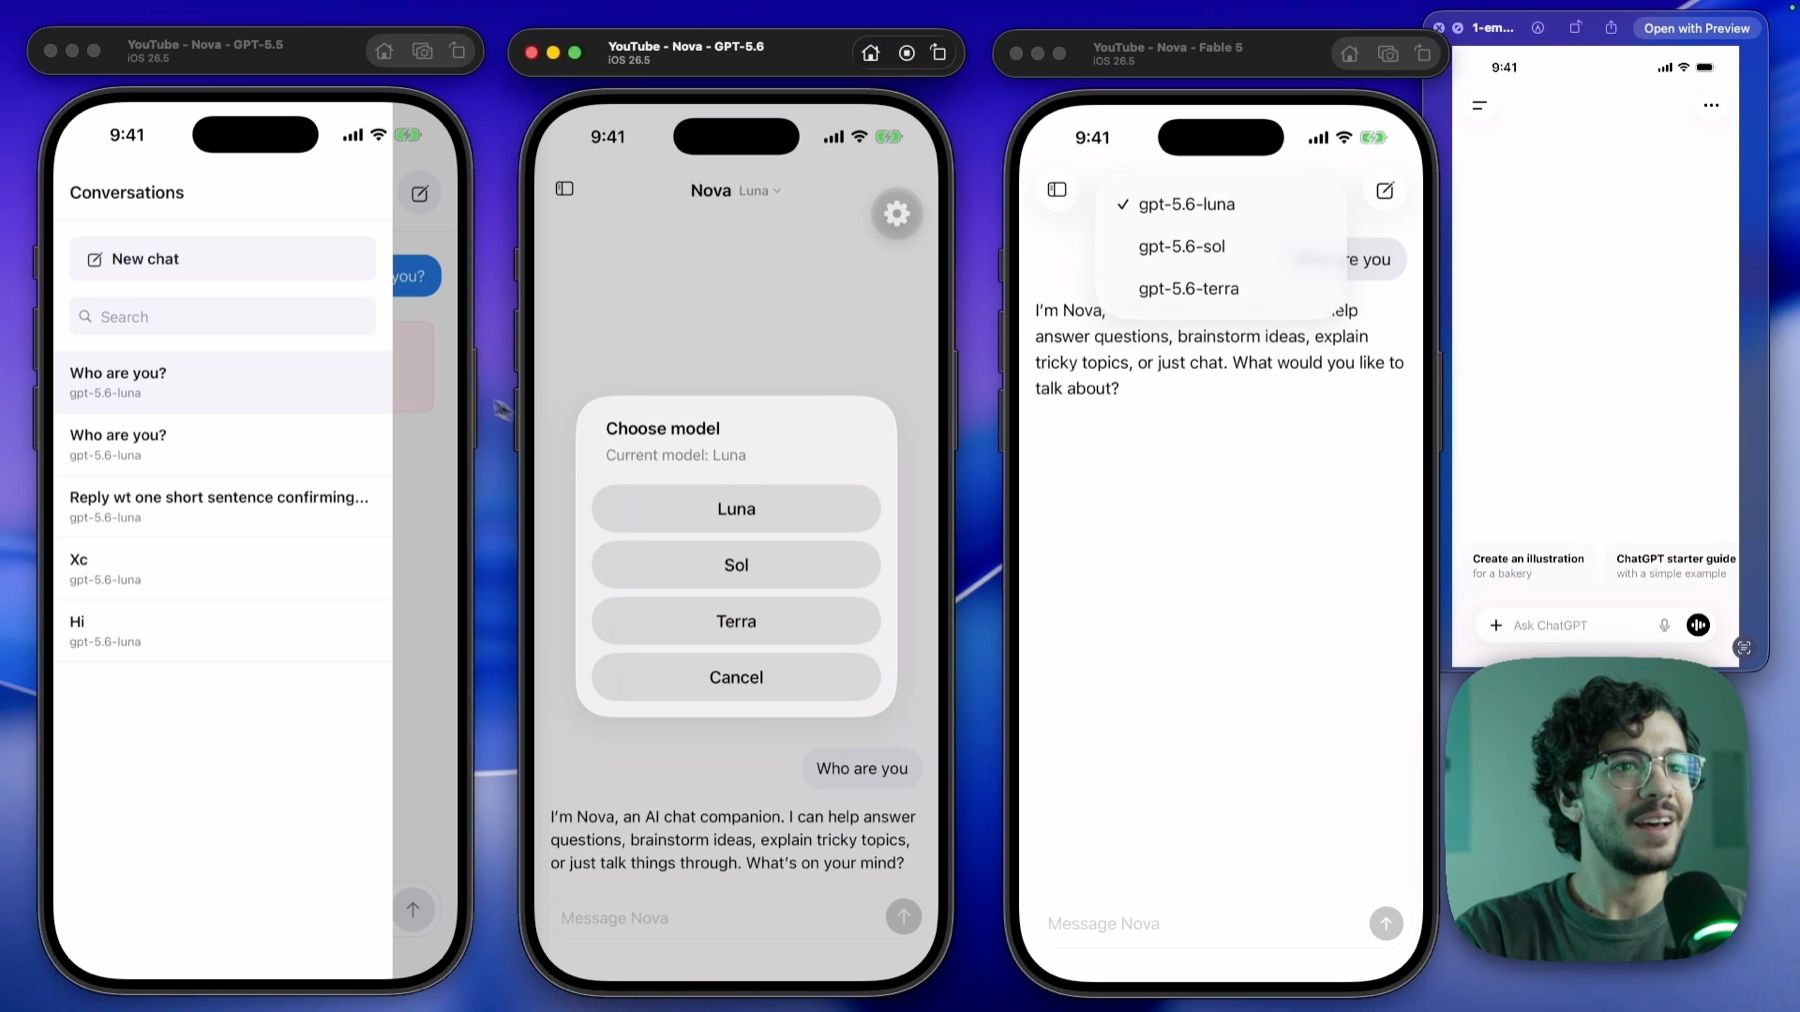
5.5 跑不起来,没有任何回复。另外两个能跑,流式输出也正常。
UI 上也很明显,Fable 5 做得更好:顶部用了原生按钮、侧边栏是原生的,另外两个模型都没用。
应用 2 指标
| Fable 5 | GPT-5.6 Sol | GPT-5.5 | |
|---|---|---|---|
| cost | $160.82 | $125.50 | $128.29 |
| active time | 2h 0m | 3h 24m | 4h 26m |
| messages | 396 | 1,175 | 1,311 |
| lines of code | 2.0k | 3.5k | 3.6k |
| code health (0-100) | 85 | 78 | 77 |
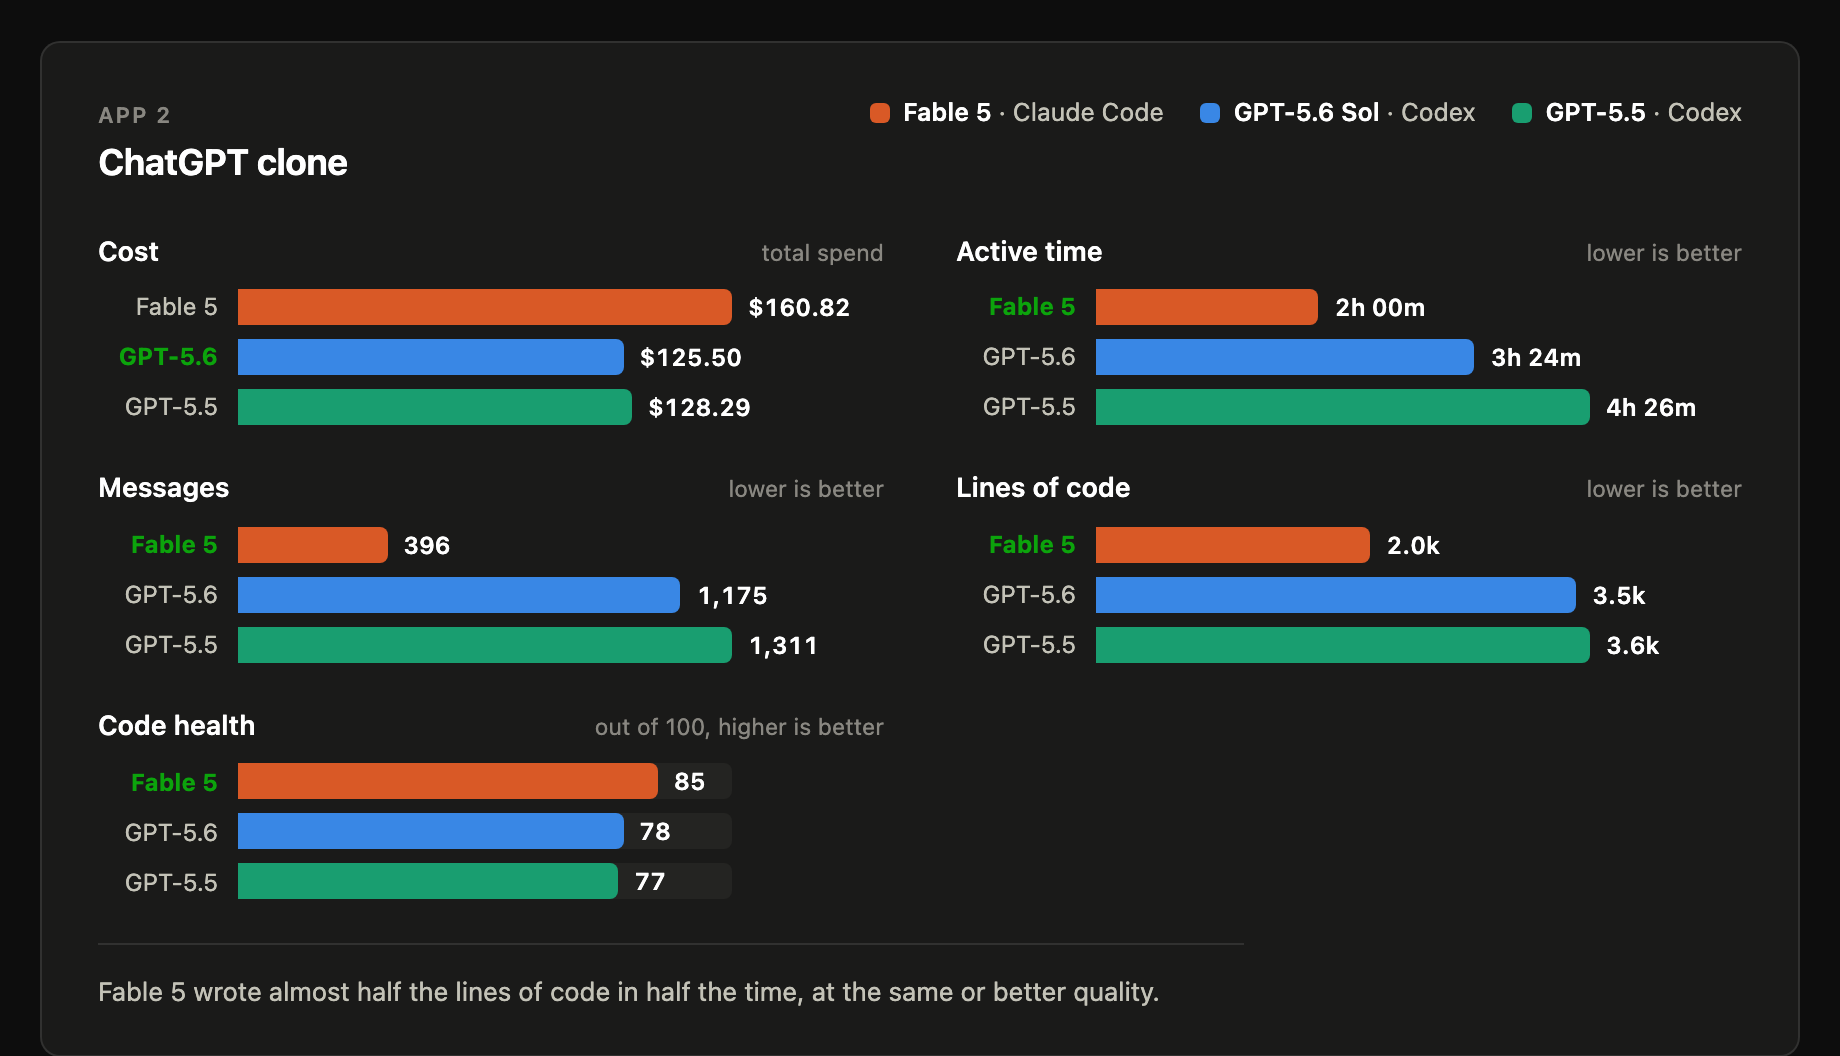
同样的故事,更极端。Fable 5 最快,用一半的时间写出几乎一半的代码行数,质量还持平或更好。很有意思。到了应用 3 更有意思。
顺便说一句,如果你想要一个已经做完、久经考验的聊天应用,直接看 Evan Bacon 的聊天模板。
应用 3:把 SwiftUI 应用整体重写成 Expo
这个是我最紧张的。Twilight 是一个 SwiftUI 写的睡眠追踪应用。我想看看:模型能不能一次性把整个代码库从 SwiftUI 重写成 Expo + React Native,包括 Live Activities。
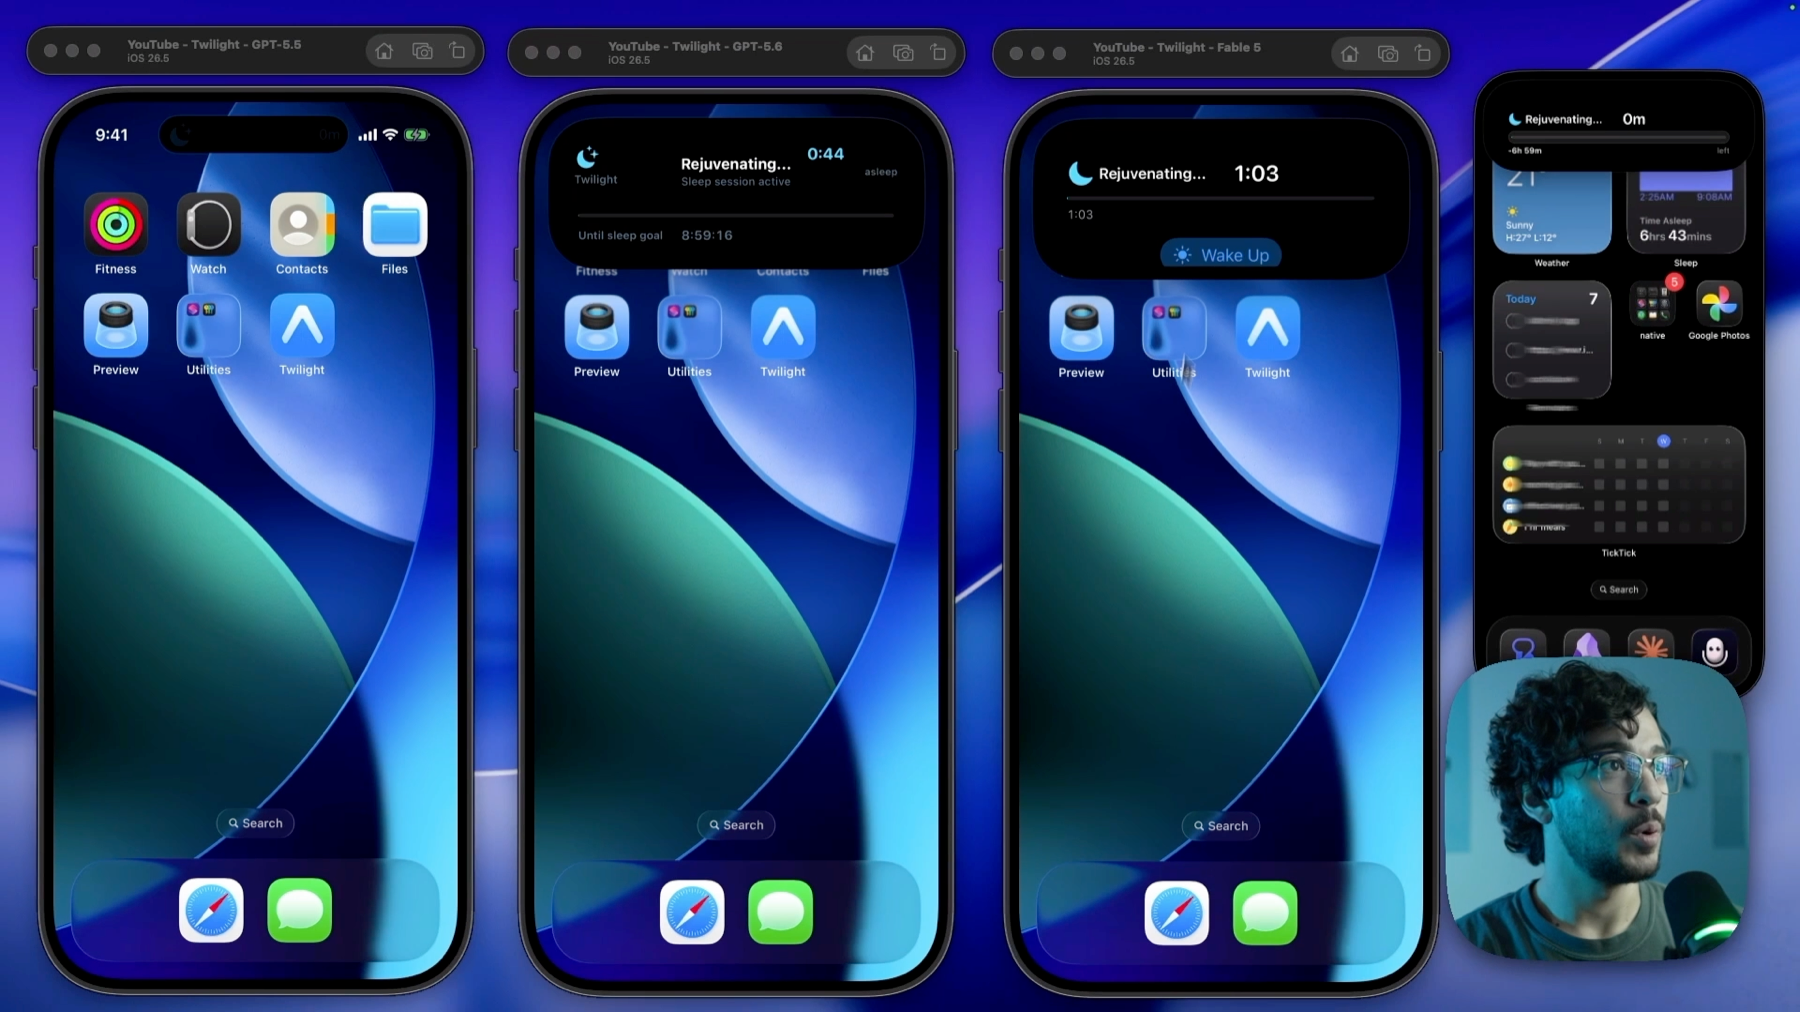
Live Activity 这一项:Fable 5 完全正确,就是它该有的样子。5.6 占了多余的空间——理想情况下我不想要——但也做对了。5.5 的不知道为什么很暗。老实说,这一项它们做得都不错,各自有各自的风格。
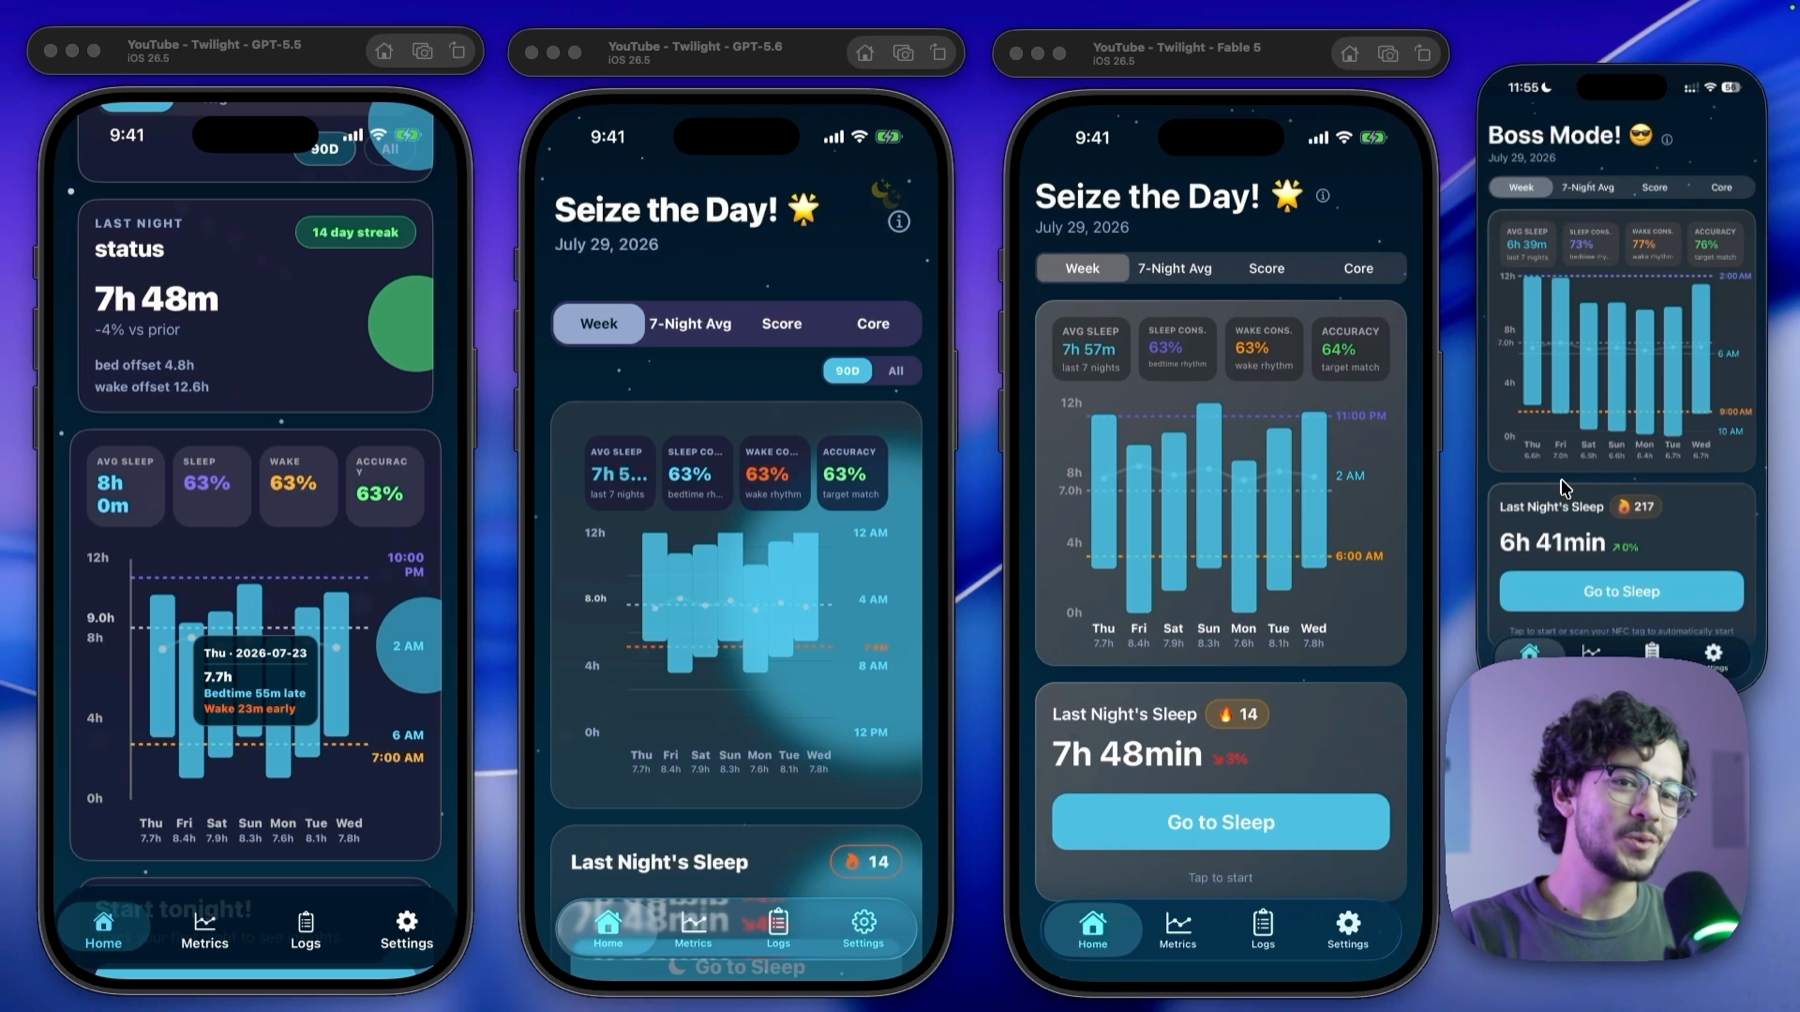
然后是应用本体,这里我是真的惊讶了。
我本来预期只是一个粗糙的近似。结果看起来就是同一个应用:移动平均曲线、睡眠评分、睡眠债与睡眠余额,甚至设置里的紫水晶主题——都和 SwiftUI 原版基本一致。一样的图表、一样的配色、什么都一样。
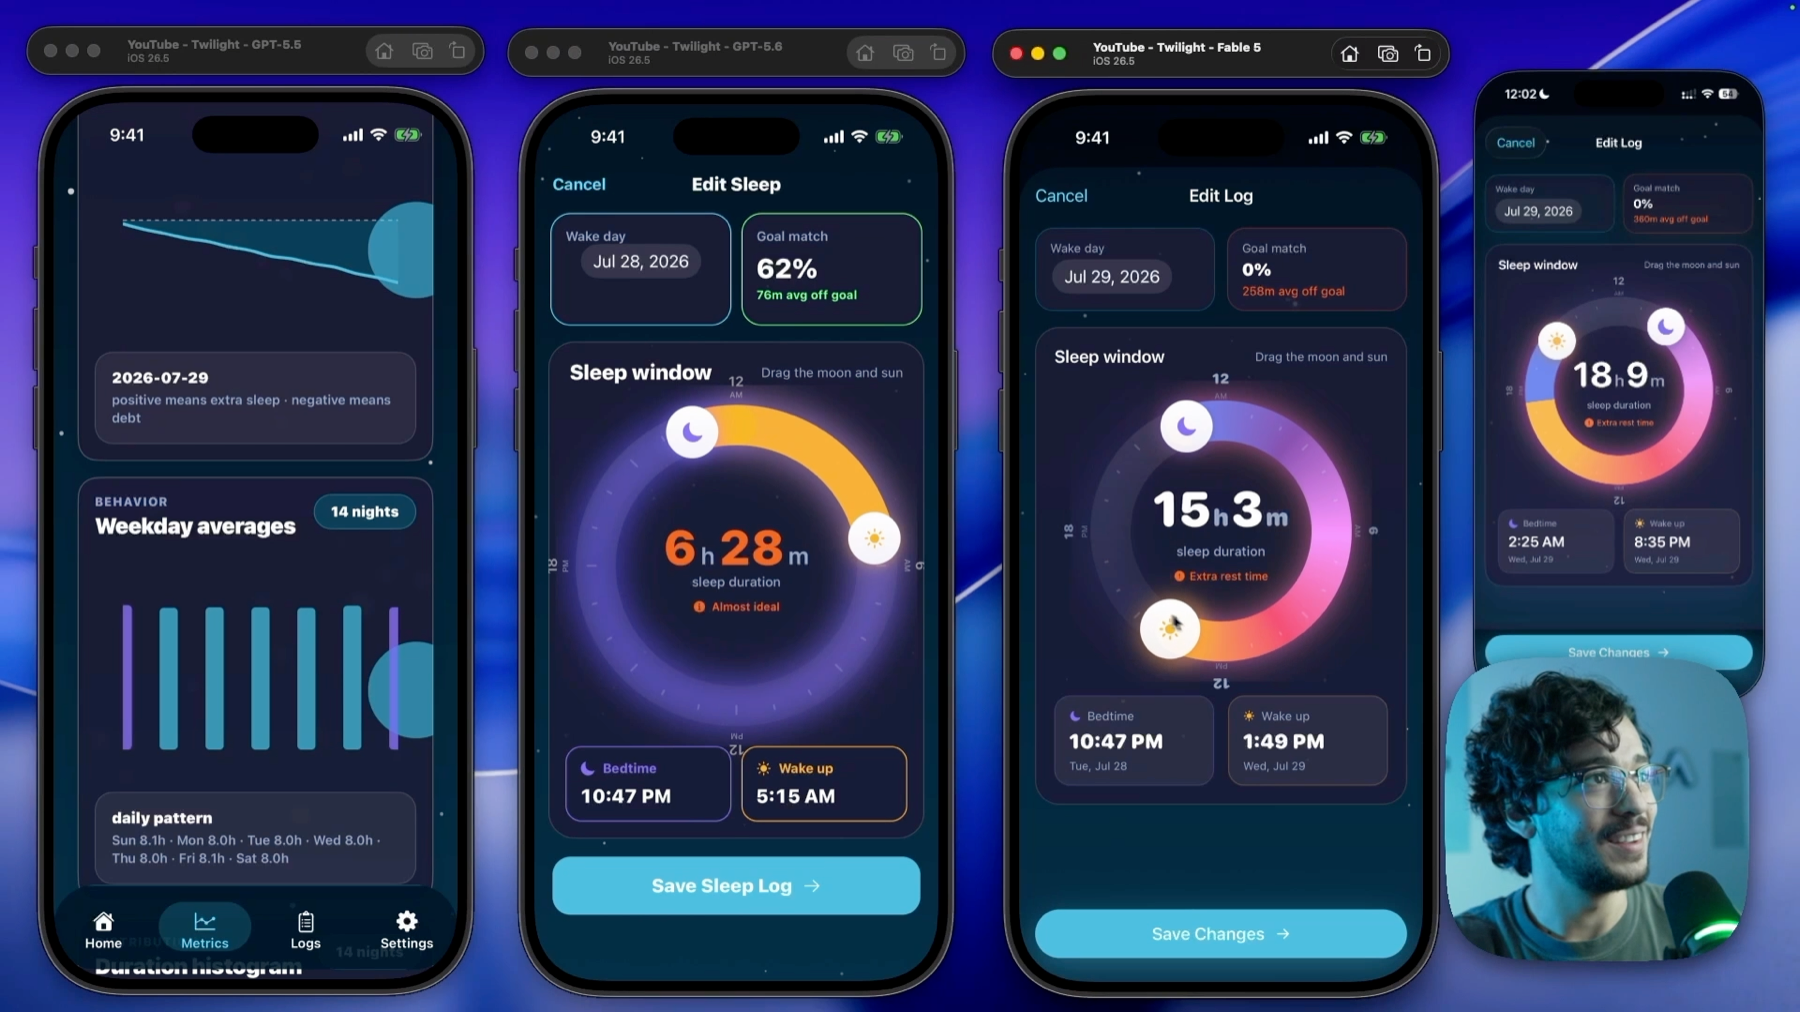
记录页用的是真正的原生 slider、真正的 bottom sheet。Expo 对接的就是 SwiftUI 对接的同一层原生层。所以如果你一直因为怕丢掉原生手感而不敢重写,这就是它不会丢的证据。
最后我还发现 Swift 原版里有个 bug,Fable 5 在 Expo 版里把它修好了。你知道吗,我本来打算录一个把 SwiftUI 应用转成 Expo 的视频,但现在没什么可讲的了——它一次性把整件事做完了。
应用 3 指标
这完全是另一个故事。
| Fable 5 | GPT-5.6 Sol | GPT-5.5 | |
|---|---|---|---|
| cost | $558.83 | $254.50 | $160.65 |
| active time | 3h 25m | 13h 34m | 5h 48m |
| cost per hour | $163/h | $19/h | $28/h |
| messages | 773 | 2,439 | 1,539 |
| lines of code | 10.7k | 15.3k | 14.0k |
| code health (0-100) | 88 | 86 | 76 |
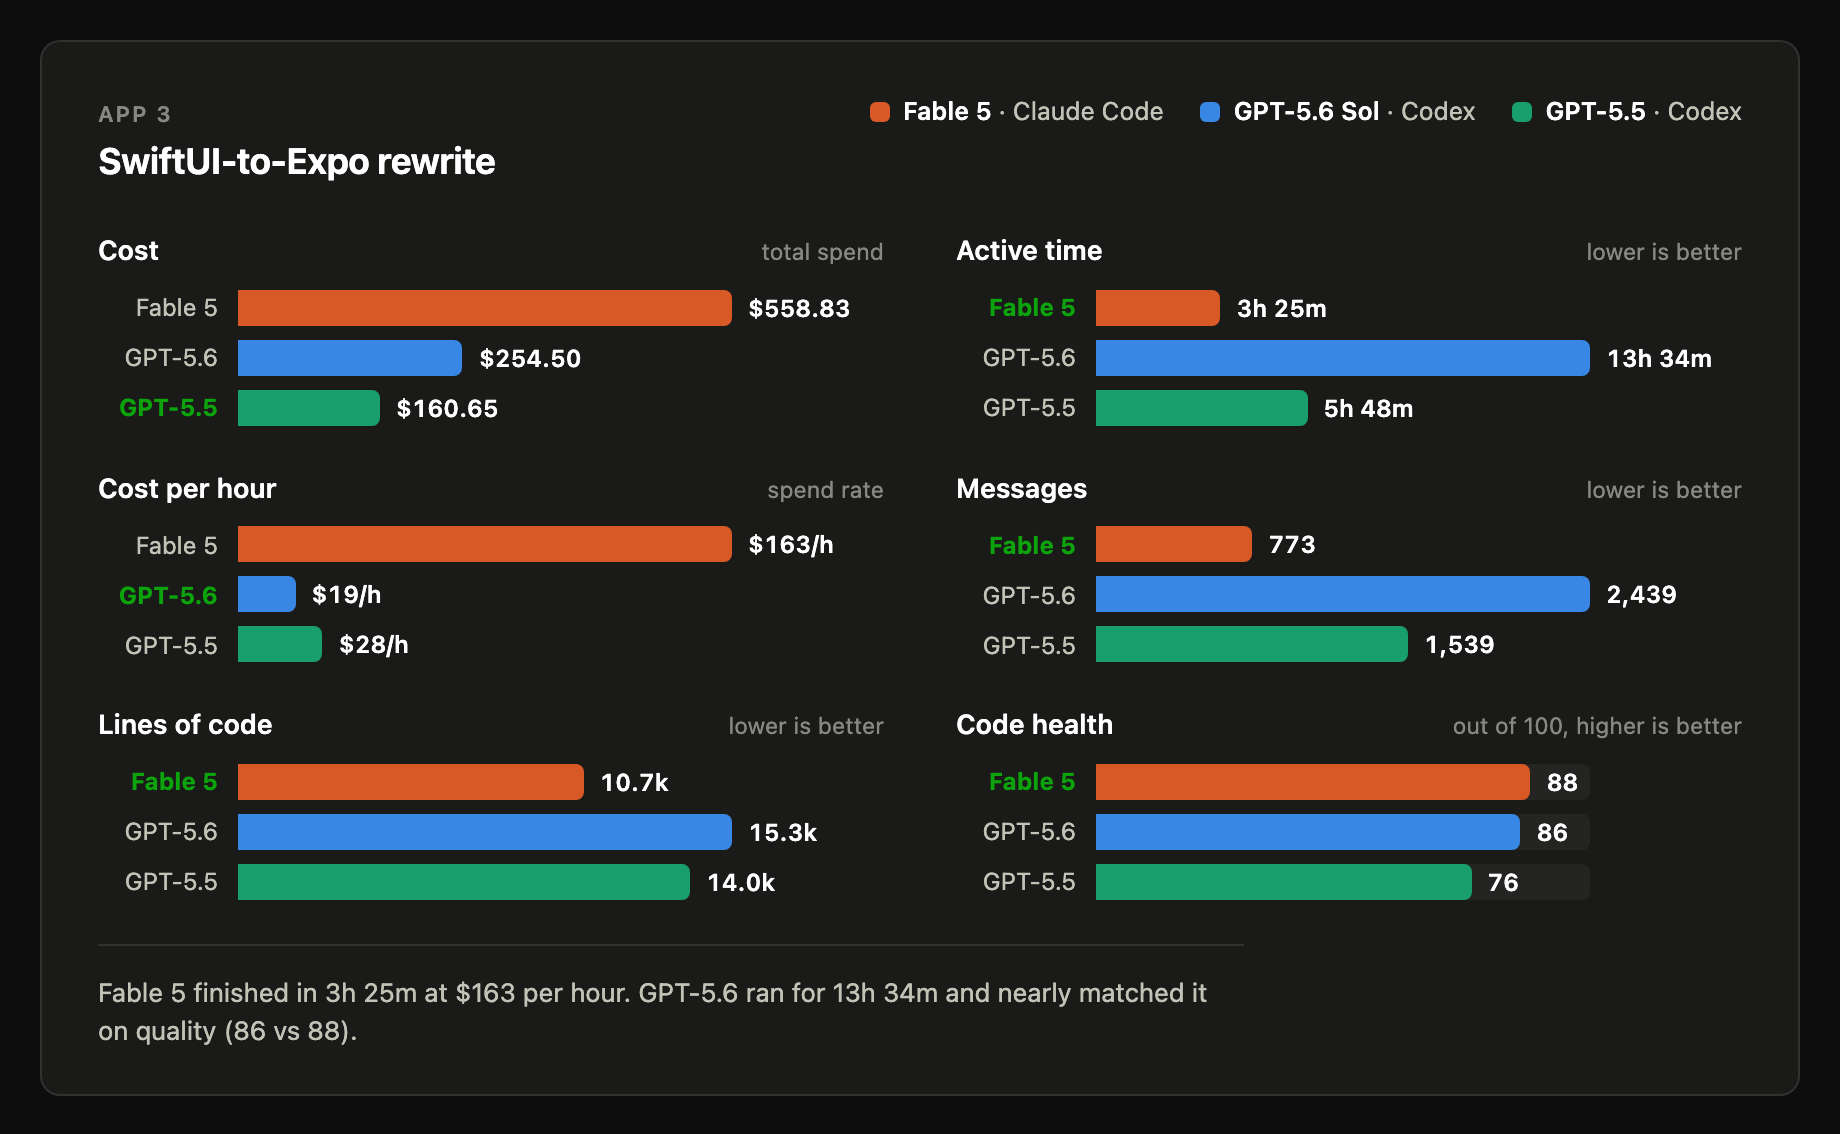
Fable 5 三个半小时做完,但单价每小时 163 美元——这一个应用就超过 550 美元。
而 5.6 花了十三个半小时。我不确定具体原因,猜是它陷进了某个循环,反复验证什么,大概是 Live Activity:问题不解决它就不停。记住这一点,等下结论要用。
质量上 Fable 5 再次胜出,但这次 5.6 非常接近(88 对 86)——考虑到价格差,这是全场最夸张的数字。而 5.5 交付的是肉眼可见的劣质品:它自己造了一个假的 tab bar,而不用现成的原生 liquid glass 那个。而且它的技术债还是三者里最重的。
20 亿 token 到底花在哪了
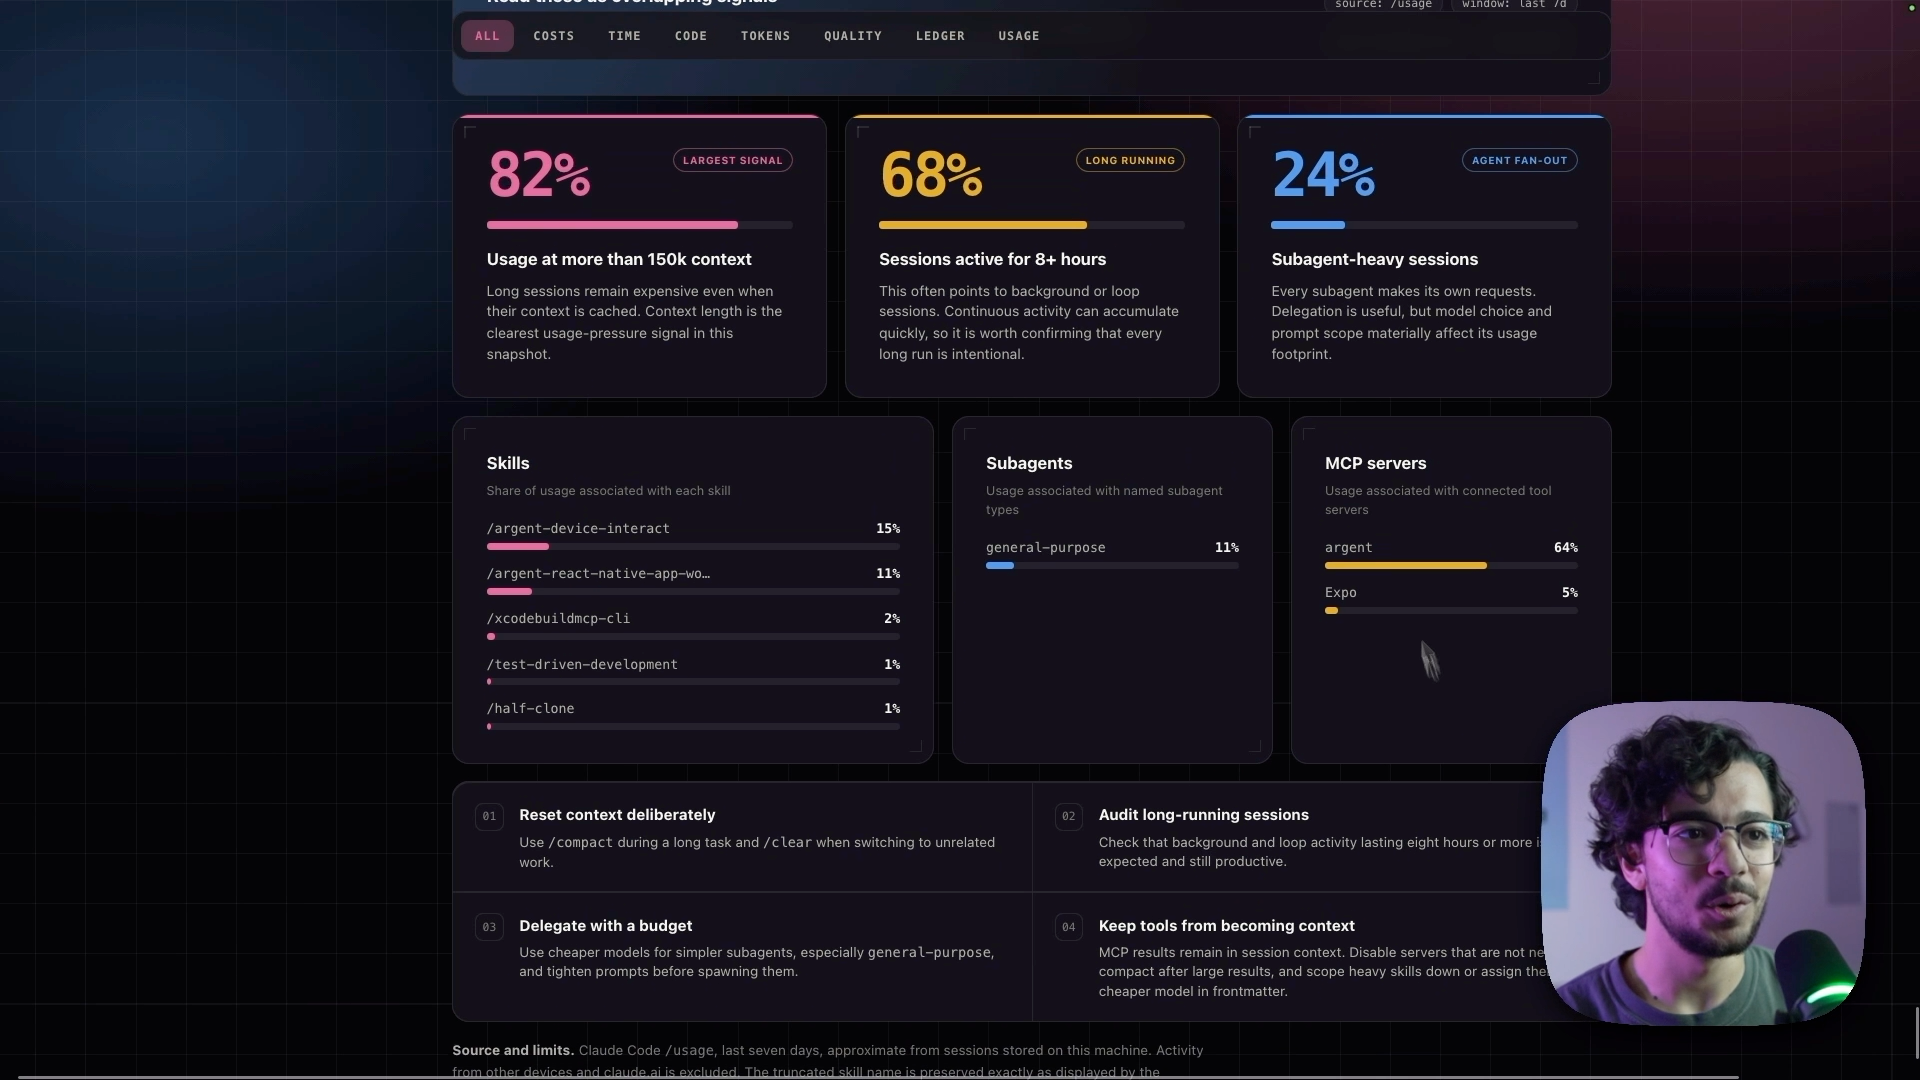
很大一部分是 Argent 和那些 MCP server。Argent 是模型用来在模拟器上验证工作的工具——每次实现一个功能都要验证一遍。每张截图、每次点击,所有这些元数据都会进入上下文窗口,再乘以每个应用 17 个任务、每个模型、每一轮修复。
这正是必须要用 subagent 去做验证和测试的原因:它们在自己的上下文里烧掉这些 token,而不是污染主上下文窗口。
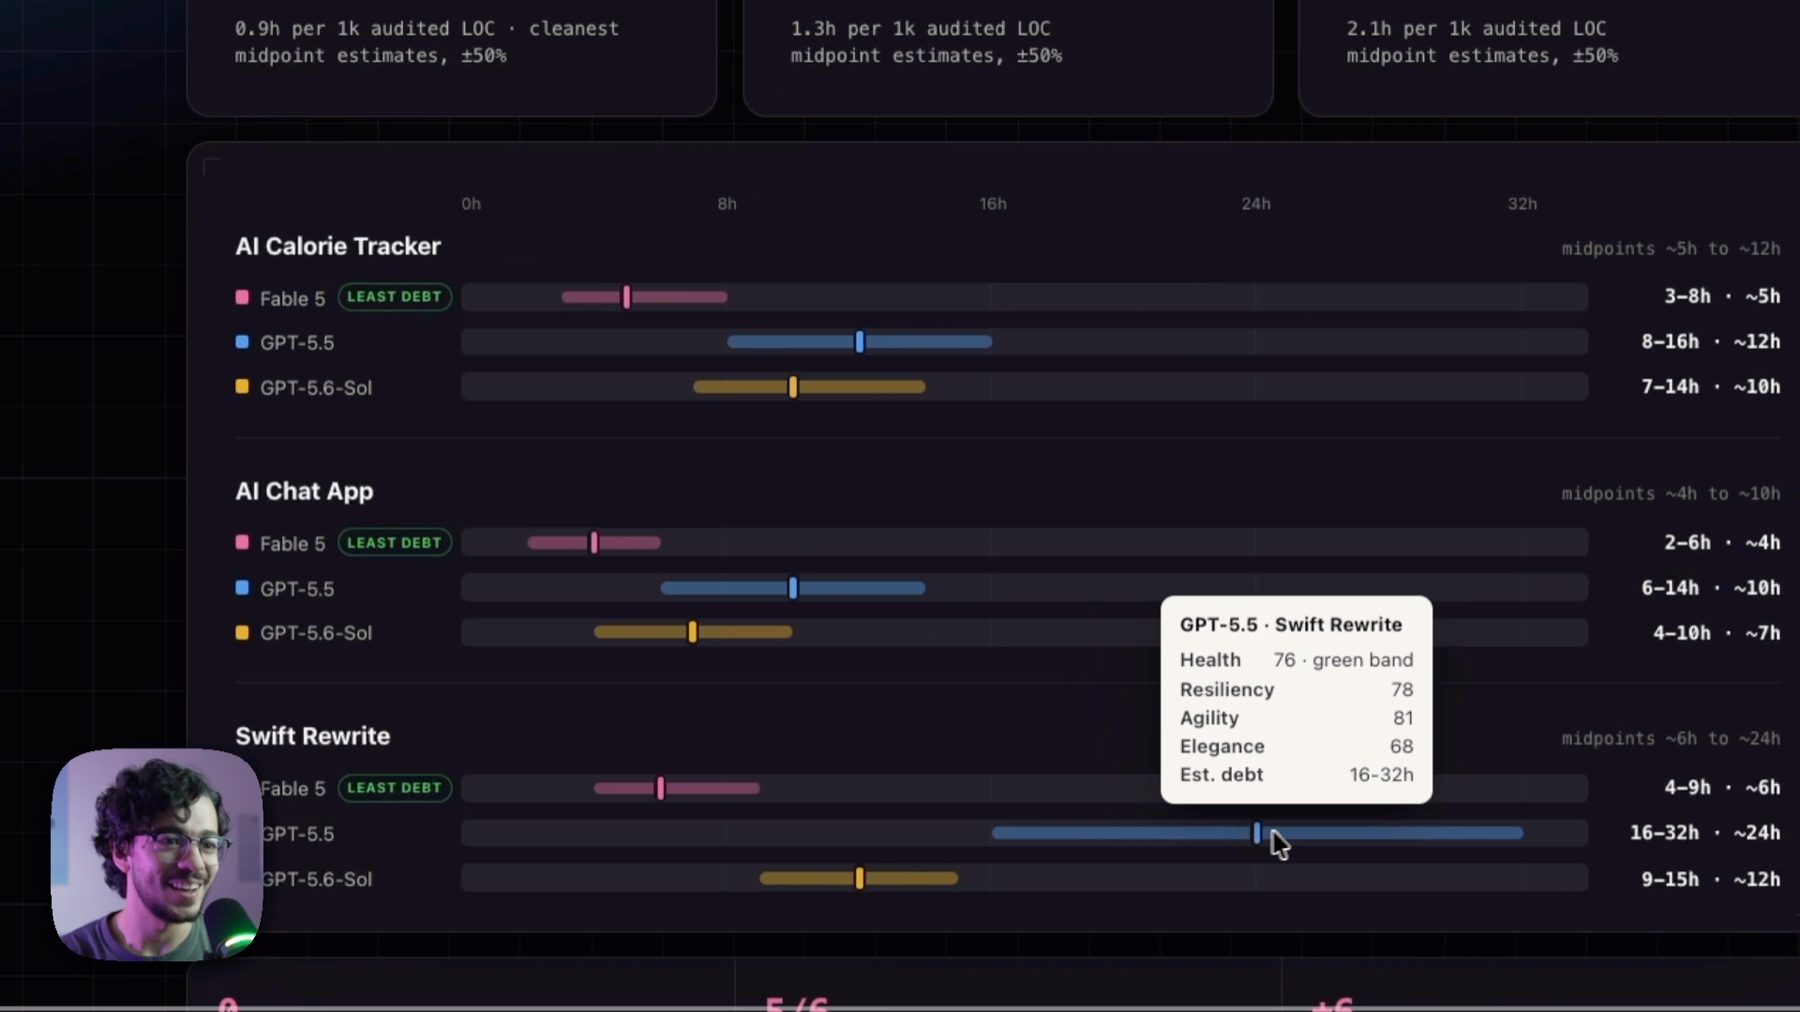
这篇里每个指标的完整可交互拆解:看板。
结论:什么活该用哪个模型
是的,几乎所有场景下 Fable 5 都是最好的。但故事不止于此。
GPT-5.6 是个苦工。 你给它一个问题,它会用尽自己的一切能力去解决,包括连着跑十三个半小时;问题不解决它不停。这让它成为处理定义明确的问题和自动化任务的绝佳工具。
Fable 5 像个资深同事。 它就是显得更聪明。而因为更聪明,它写更少的代码、用更少的时间,质量还更高。上面每张表里都能看到:消息最少、代码行数最少、最快、代码质量分最高——三战全胜。
所以我会这么分:
- 你是创业者,在做应用、验证想法、想要一个思考伙伴:Fable 5。
- 你是构建者,在自动化各种事情,包括 computer use:5.6 在这方面非常强。
- 快速技术任务,“给我写个脚本”“把这个简单功能做出来”:5.6。
- 更大的东西,比如一整个 PR:Fable 5,主要因为代码质量好得多,前面都看到了。
我自己两个都用,用在不同的事情上。(顺带说,验证那部分我其实可以用 computer use 替代 Argent;比较验证工具可能是以后可以做的实验。)
下一步
你同意吗?不同意?下次对比要不要把 Kimi 也拉进来?到视频下面留言告诉我。
我本来很期待录一个「把 SwiftUI 应用转成 Expo」的教程,但看起来不需要了:只要有对的工具,AI 能一次性做完。
至于这些工具本身(MCP server、skill、让这一切成立的配置),可以看这篇博客或者YouTube 视频,讲怎么用 AI 构建移动应用。
下面是这次实验里所有有用的链接:
- 全部代码、prompt 和 codebase skill:github.com/rami-maalouf/fable-5-vs-gpt-5-6
- 所有指标和图表:看板
- 规格驱动开发 skill:SKILL.md
- 代码质量审计 skill:code-quality-scoring
- Expo API routes 文档:docs.expo.dev
- OpenAI Agents SDK(JS):openai-agents-js
- Argent:argent.swmansion.com
- Twilight,那个睡眠追踪应用:App Store