Fable 5 対 GPT-5.6 Sol:2,000 ドルと 20 億トークンを費やして、Expo アプリをうまく書けるのはどっちだ
3つのAIモデルがそれぞれ一度に3つのExpoアプリを作成し、20億以上のトークンを消費して2,000ドルを費やし、Fable 5がコードとUIの品質で勝利した。
日本語
コピー
3つのAIモデルに同じプロンプトを1つ与え、それぞれに3つのExpoアプリを一発で作らせた。コードとUIの品質ではFable 5が勝った。
モバイルアプリ開発の王は誰なのか。それを突き止めるために20億トークン以上を燃やし、2,000ドルを費やして、3つの異なるAIモデルにそれぞれ3つの異なるExpoアプリを一発で作らせた。
モデルはすべての工程を走り切った。アイデア出し、開発、自律テスト、検証、デバッグ、その間のすべて。3つのアプリはどれもExpoとReact Nativeで構築し、私はコードを一行も触っていない。
これを読み終えれば、自分のアプリを一発で作るのにどのモデルを使うべきか分かるはずだ。以下が今回の実験のキーナンバー。
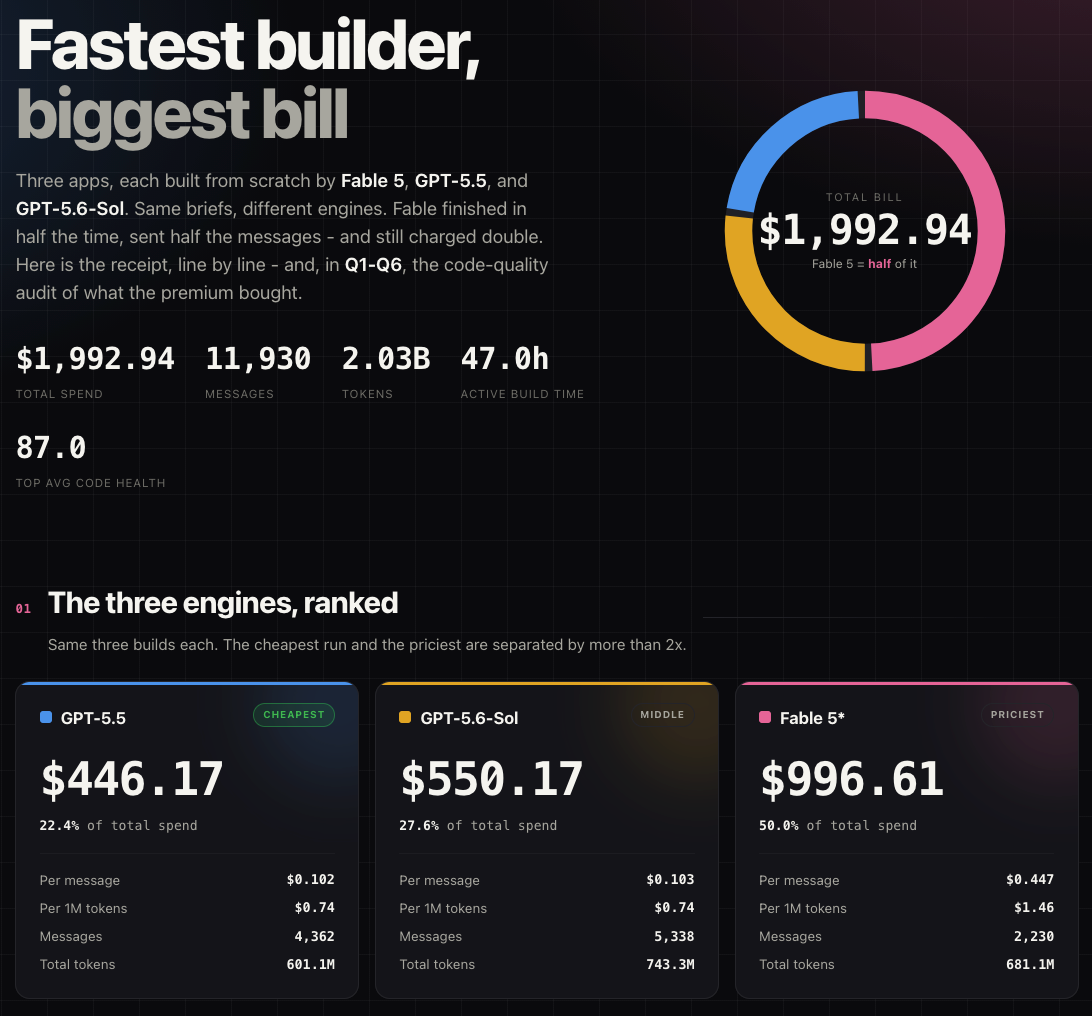
動画で見たい人はこちら。フル動画はここにある。
ルール
参加者:
- Fable 5(Claude Code)
- GPT-5.6 Sol(Codex)
- GPT-5.5(Codex)、対照用
どのモデルもhigh effortに設定し、渡したプロンプトは完全に同一——仕様駆動開発skillで生成したものだ。開始テンプレートもツールもルールも同じ。
AIにアプリ全体を一発で、バグもなく、コード品質もそこそこで作らせる方法が気になるなら:ループと検証だ。仕様は各モデルに対して、実装タスクはどれもコミット前に決まった基準を満たすことを求めている。その一つが、各機能はiOSシミュレータで検証を通ってから次に進むこと。
先に言っておくと、後で最もトークンを焼いたのはまさにこのシミュレータ検証だった。話は記事の最後でする。
アプリ1:AIカロリー記録
最初のテスト:AIカロリー記録アプリを作る。デザインはCal AIを参照(ちなみにこれ自体React Nativeで書かれている)。左がGPT 5.5、中央が5.6 Sol、右がFable 5。
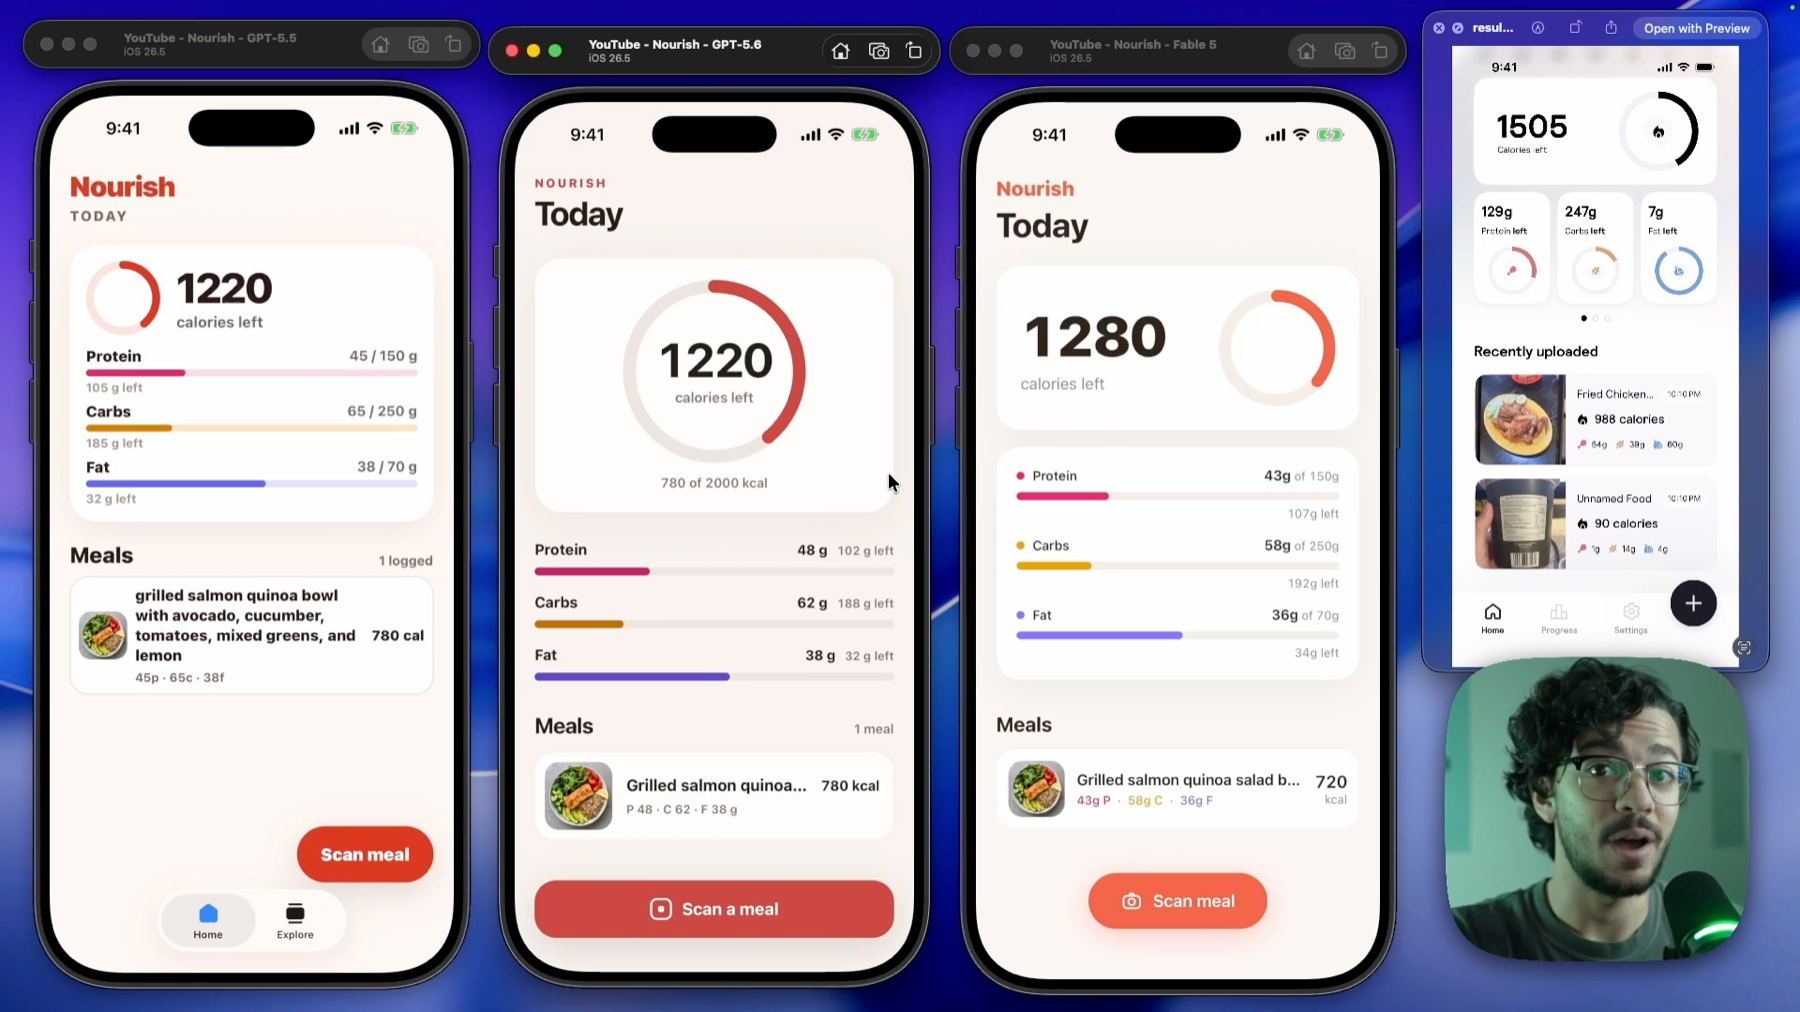
3つともかなり近い出来だ。GPT 5.5が信頼度94%を表示している点は良い。他の2つにはない。ただラベルは気に入らない。どれか一つを選ぶならFable 5、5.6がすぐ後ろに続く。
UI全体で言えば、Fable 5は一貫性が際立っている。影、ボーダー、すべてがクリーンで統一されている。GPTの2つはもっとバラバラに見える。GPT 5.5はExpoの開始テンプレートから不要な「explore」ページを持ち込んでいた。ボイラープレートがアプリに残ったままで、なぜ消さないのか分からない。
褒めるべきは褒める。ホーム画面の細部では5.6が一番良い。今日の予算をどれだけ使い、何食食べたかを正確に表示している。Fable 5はできておらず、本物のCal AIもできていない。
アプリ1の指標
| Fable 5 | GPT-5.6 Sol | GPT-5.5 | |
|---|---|---|---|
| cost | $276.95 | $170.16 | $157.23 |
| active time | 3h 45m | 5h 17m | 5h 20m |
| cost per hour | $74/h | $32/h | $29/h |
| messages | 1,061 | 1,724 | 1,512 |
| lines of code | 3.7k | 4.3k | 4.7k |
| code health (0-100) | 88 | 79 | 79 |
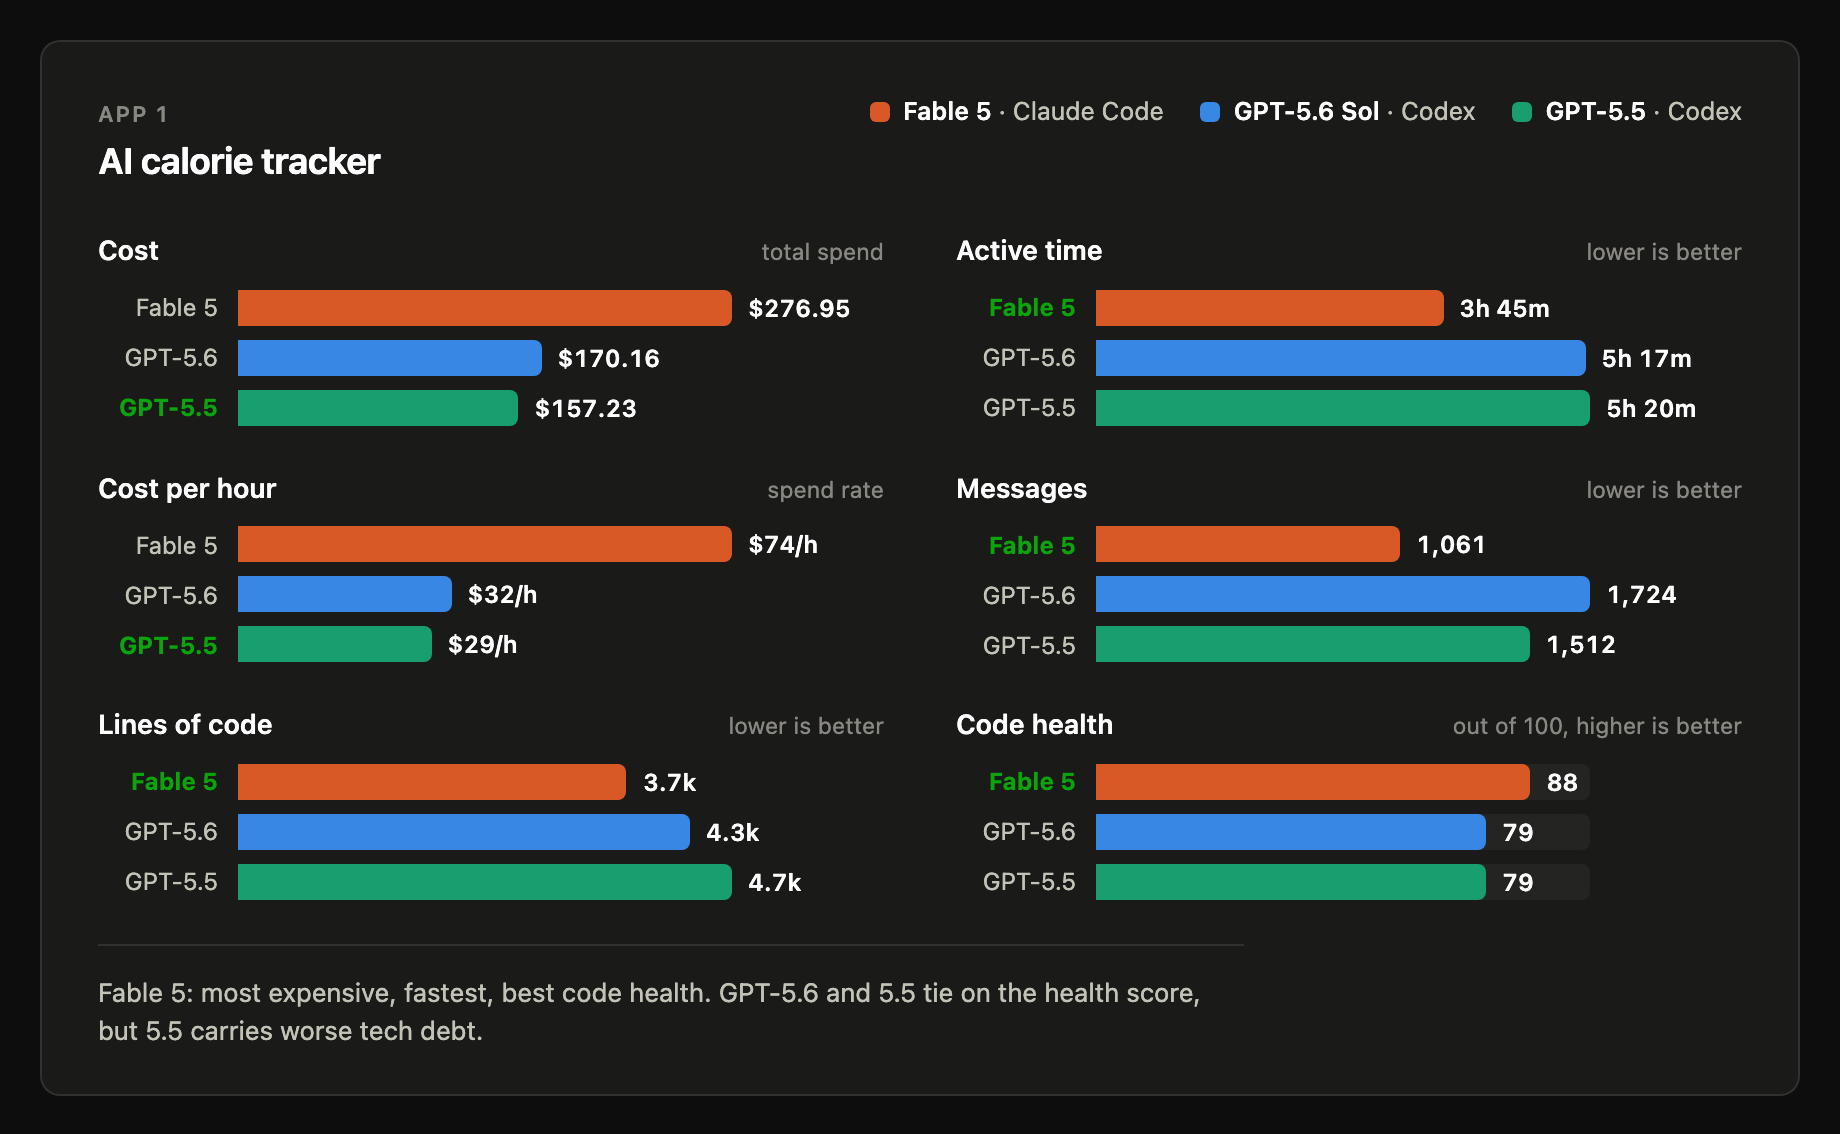
Fable 5が最も高く、最も速い。1時間74ドルで、GPTの2つは32ドルと29ドル。このアプリではコード行数はほぼ同じだが、勝利はFable 5に。
コード品質は面白い。これもFable 5の勝ち。5.5と5.6は健康スコアで並んだが、技術的負債は5.5の方が重い——3つのアプリすべてで繰り返し見られるパターンだ。これらの監査にはコード品質スコアリングskillを使い、全コードとcodebase skillはこのリポジトリにある。
バックエンドが何か気になるなら:Expo API routeが1本。80行のバックエンドだ。Expoアプリは時にこれだけで済む。OpenAI Agents SDKを使い、POSTリクエストを1つ受け取って画像をスキャンする。まだ試したことがなければ、Expo API routesのドキュメントはこちら。
アプリ2:ChatGPTクローン
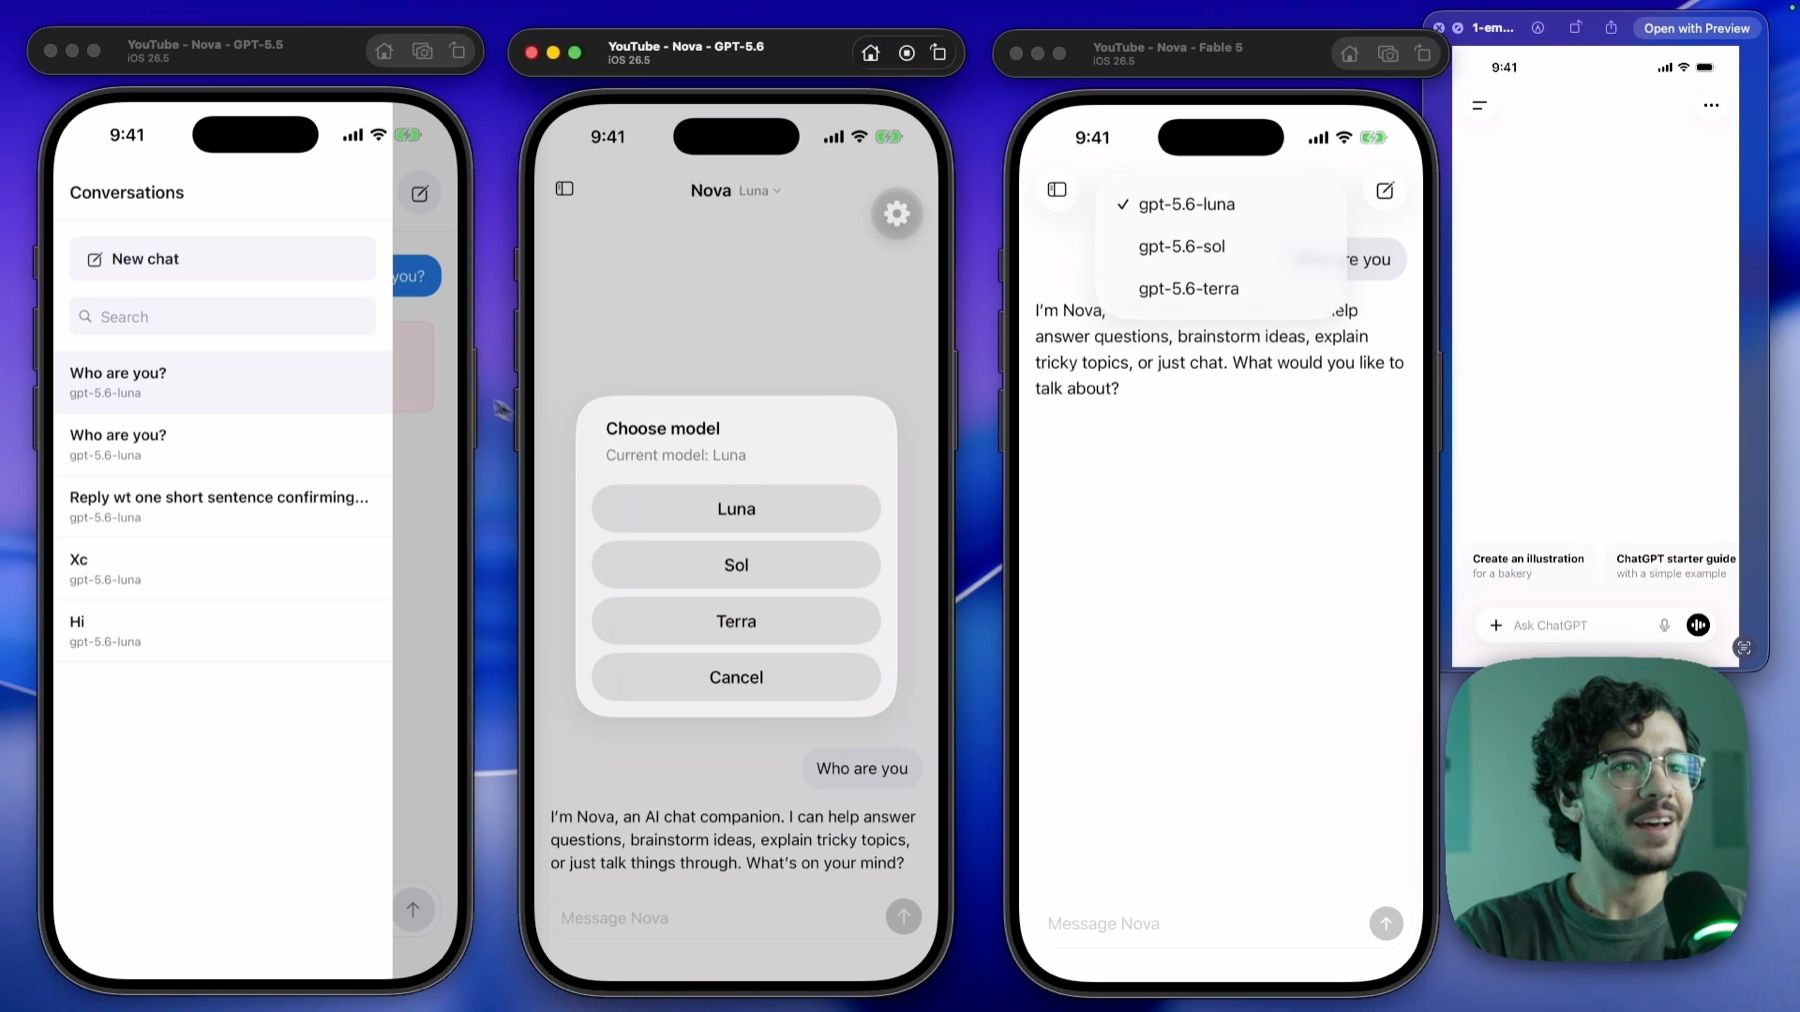
2つ目のテスト:ChatGPTのクローン。バックエンドの考え方は同じ(Expo API route + OpenAI Agents SDK)で、今回はChatGPTアプリ自体をデザインの参照にした。デザインはなかなか良いと思う。
最初の問題:AIは本当に動くのか?
5.5は動かず、返信が一切なかった。他の2つは動き、ストリーミング出力も正常。
UIでも明らかで、Fable 5の方が出来が良い。上部にネイティブボタン、サイドバーもネイティブで、他の2モデルはどちらも使っていない。
アプリ2の指標
| Fable 5 | GPT-5.6 Sol | GPT-5.5 | |
|---|---|---|---|
| cost | $160.82 | $125.50 | $128.29 |
| active time | 2h 0m | 3h 24m | 4h 26m |
| messages | 396 | 1,175 | 1,311 |
| lines of code | 2.0k | 3.5k | 3.6k |
| code health (0-100) | 85 | 78 | 77 |
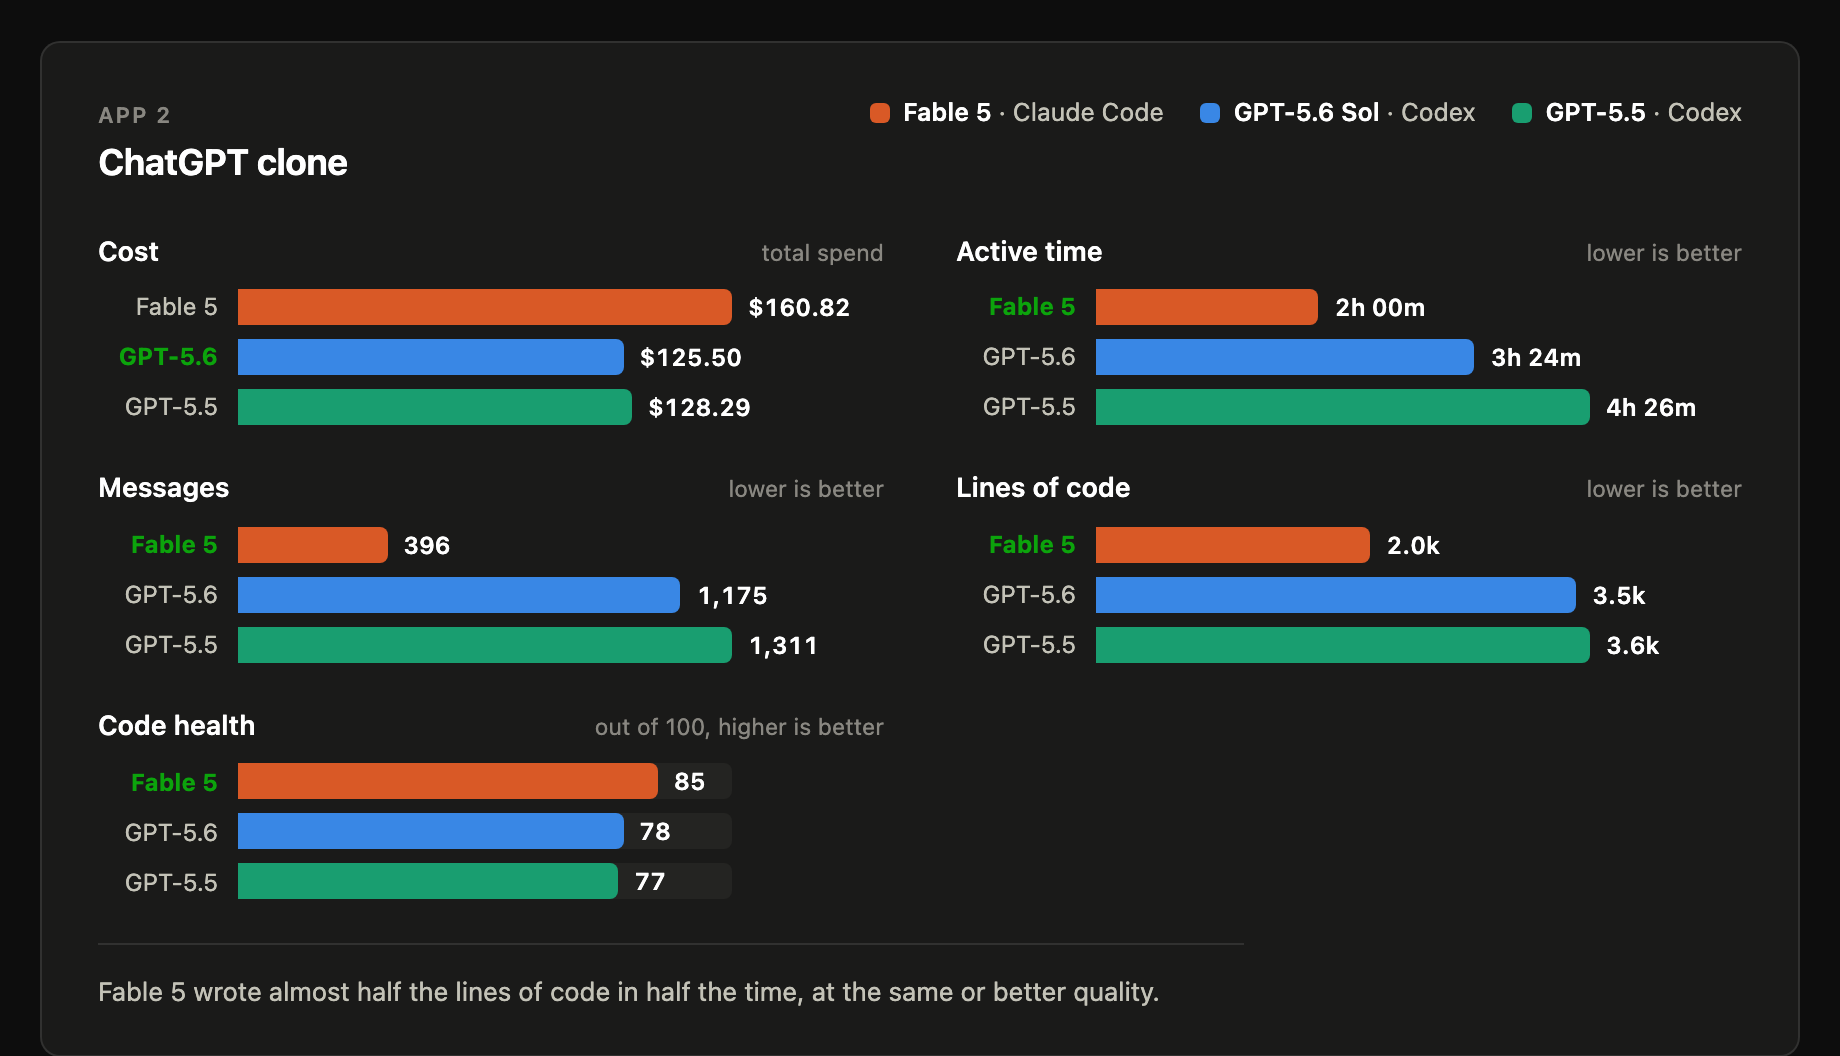
同じ話の、もっと極端な版。Fable 5 が最速で、半分の時間でほぼ半分の行数しか書いていないのに、品質は同等かそれ以上。面白い。アプリ3ではさらに面白くなる。
ちなみに、完成済みで実戦投入できるチャットアプリが欲しいなら、Evan Bacon のチャットテンプレートをそのまま見ればいい。
アプリ3:SwiftUI アプリを丸ごと Expo に書き直す
これが一番緊張した。Twilightは SwiftUI で書かれた睡眠トラッキングアプリだ。モデルがコードベース全体を SwiftUI から Expo + React Native へ、Live Activities も含めて一発で書き直せるかを見たかった。
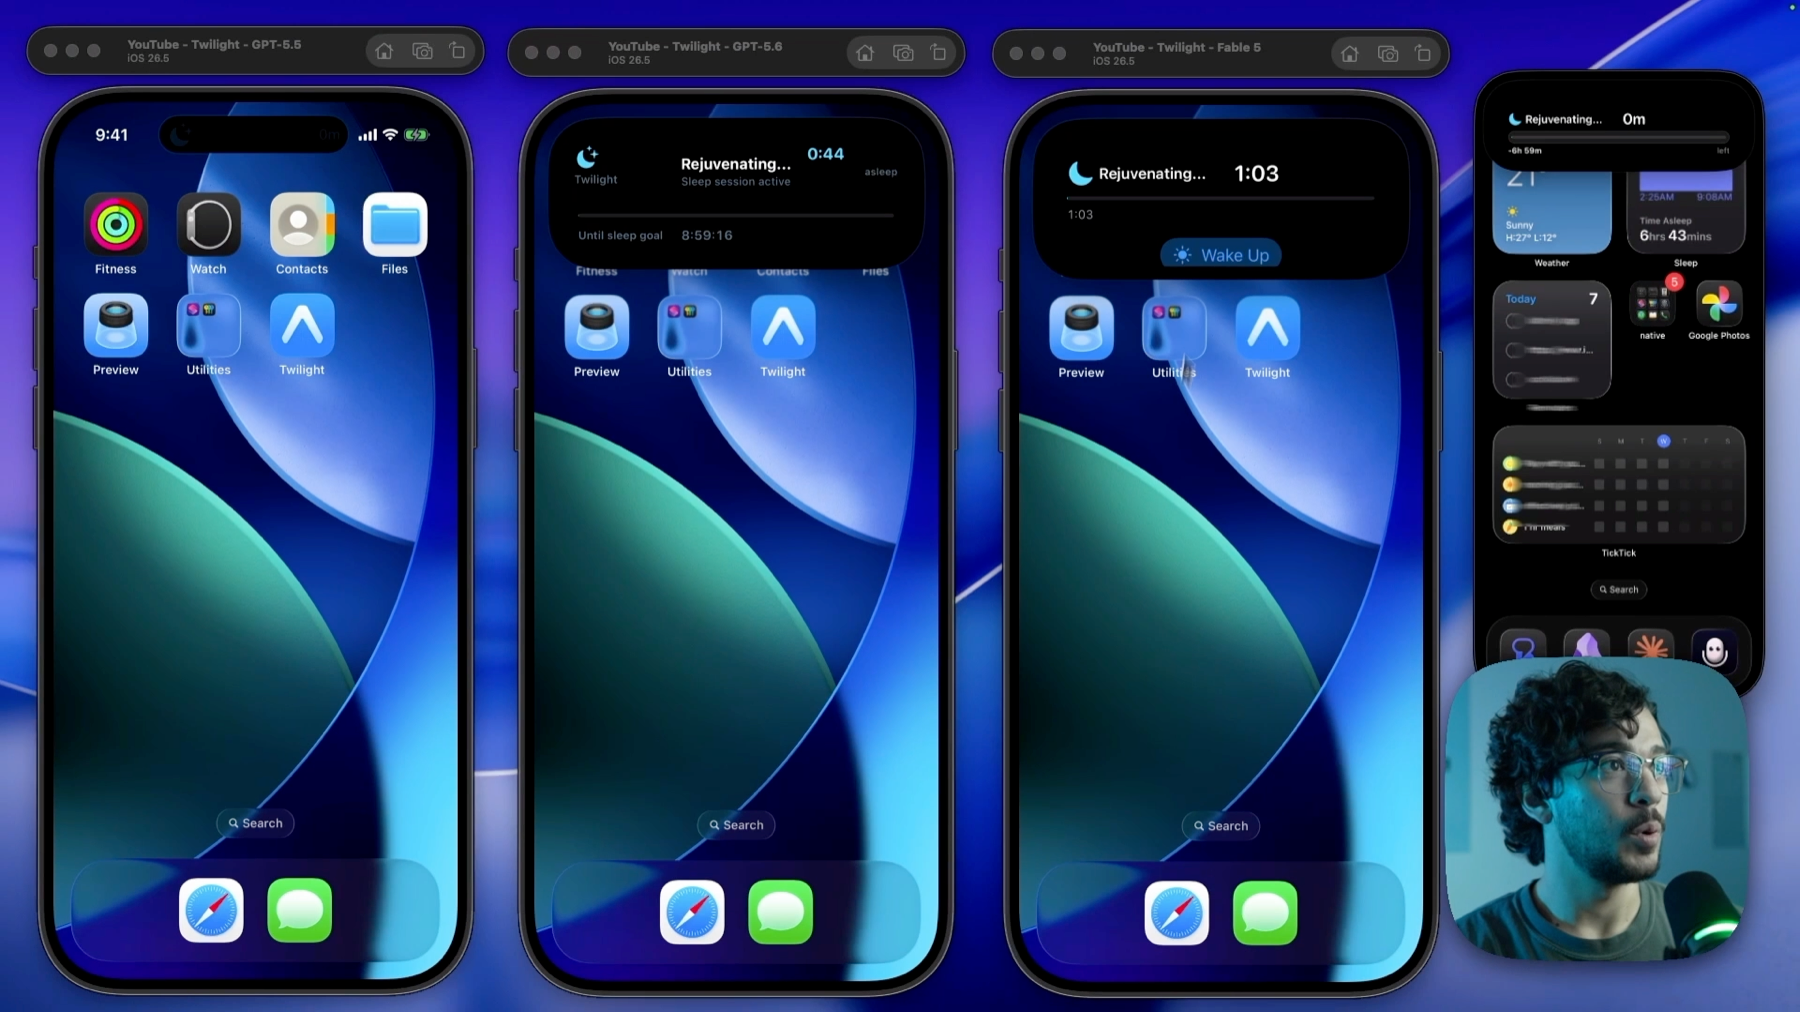
Live Activity について:Fable 5 は完全に正しく、あるべき姿そのもの。5.6 は余計なスペースを取っている——理想的には不要だが——それでも正しくできている。5.5 はなぜか暗い。正直、この項目はどれもよくできていて、それぞれに個性がある。
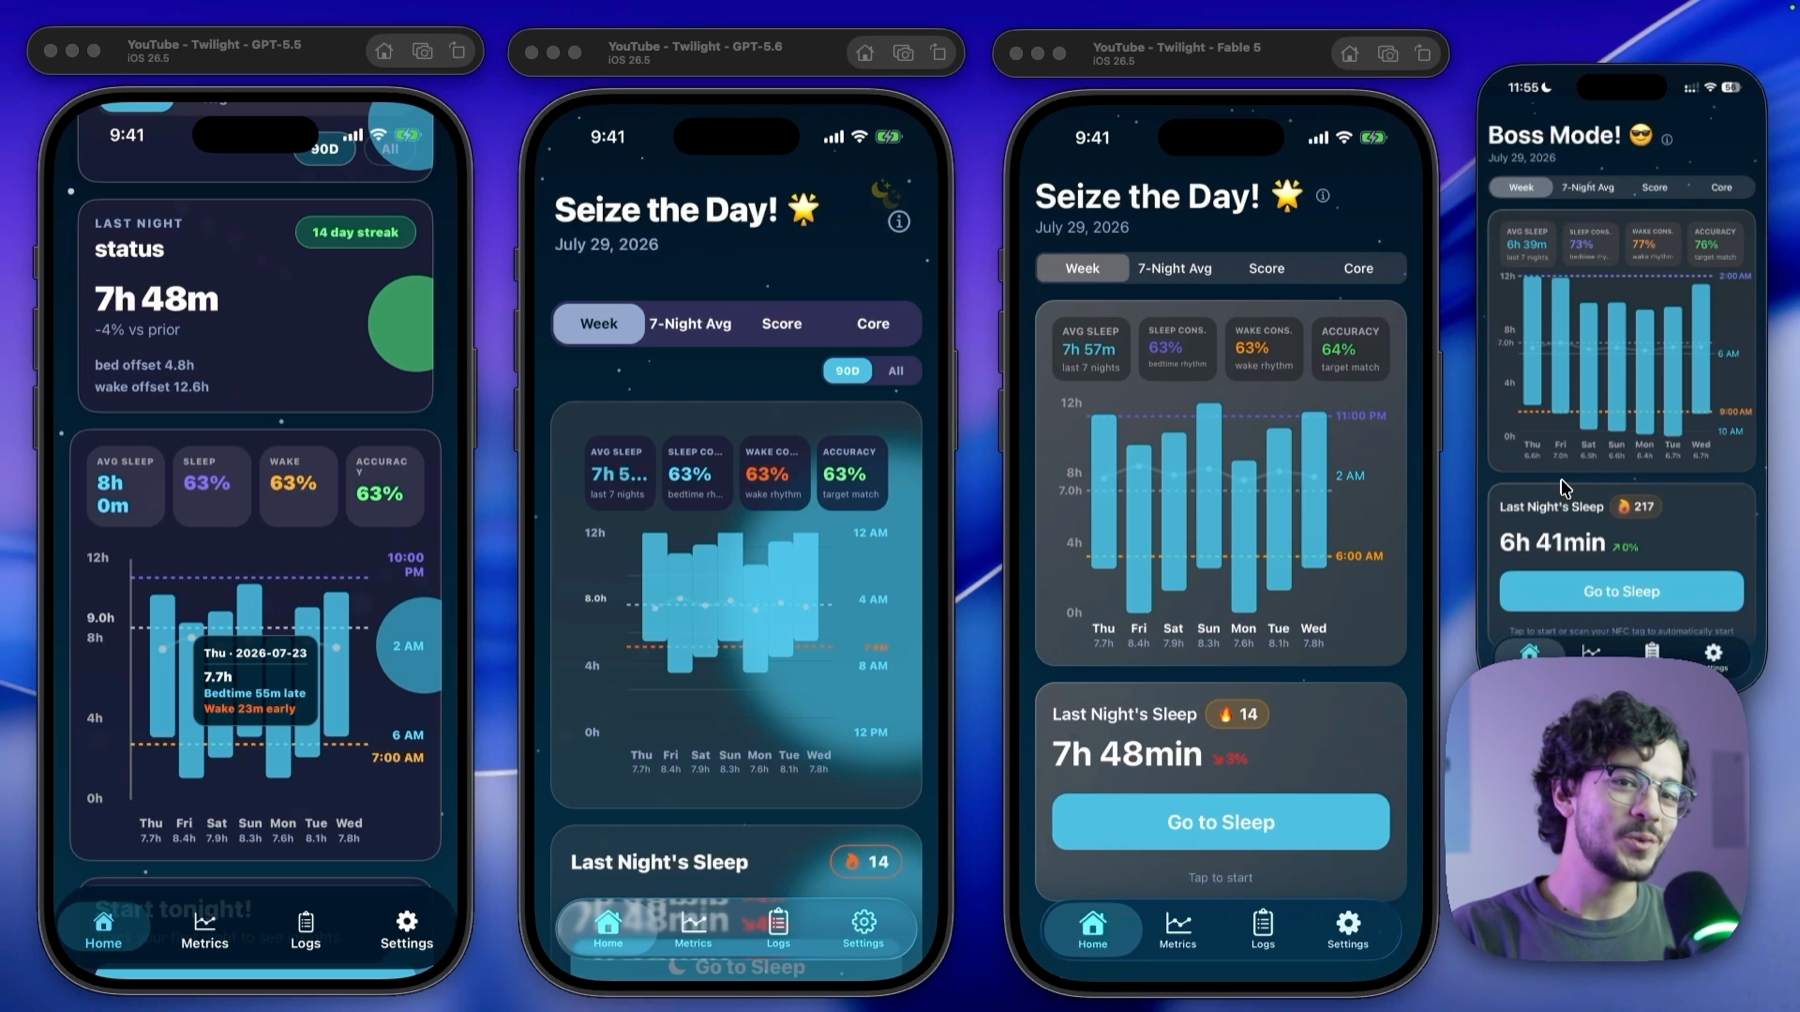
そしてアプリ本体、ここで本当に驚いた。
粗い近似が出てくると思っていた。ところが出てきたのは同じアプリに見えるものだ。移動平均の曲線、睡眠スコア、睡眠負債と睡眠残高、設定のアメジストテーマまで——SwiftUI のオリジナルとほぼ一致している。同じグラフ、同じ配色、何もかも同じ。
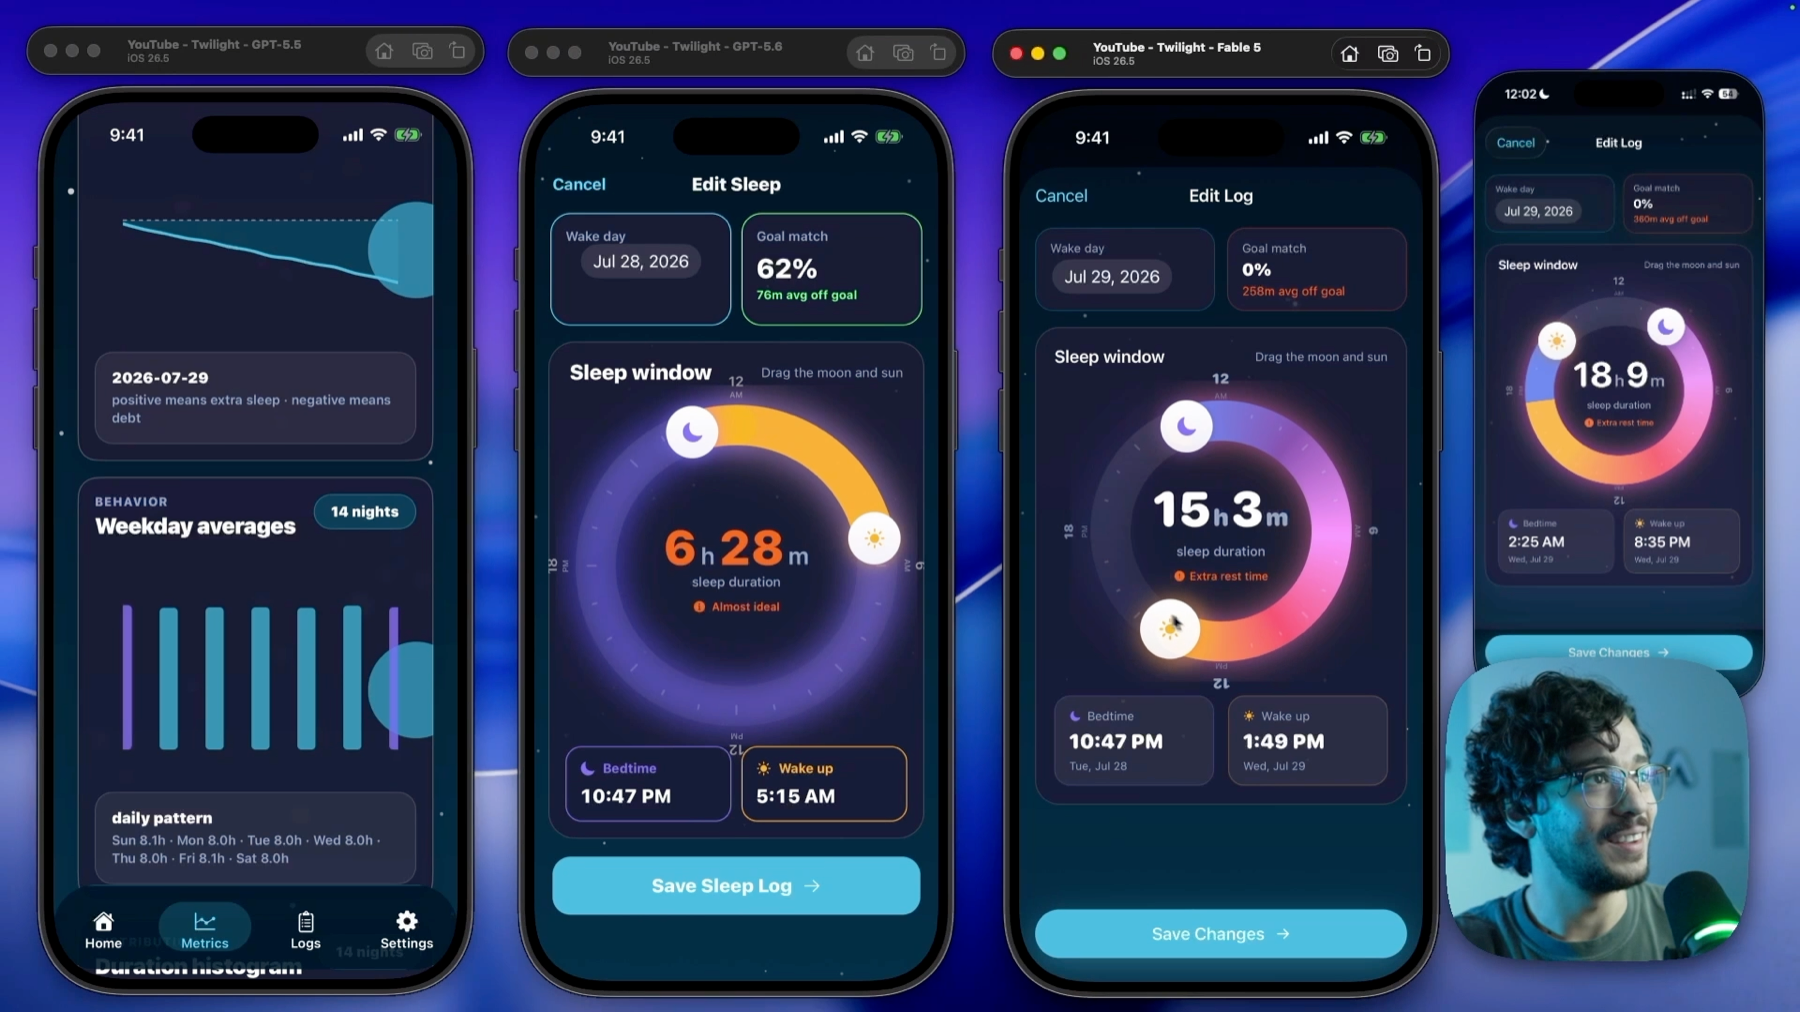
記録ページは本物のネイティブ slider、本物の bottom sheet を使っている。Expo は SwiftUI と同じネイティブ層に接続している。つまり、ネイティブの手触りを失うのが怖くて書き直しに踏み切れずにいるなら、それが失われない証拠がこれだ。
最後に、Swift のオリジナルにバグが一つあったのを Fable 5 が Expo 版で直していた。実は SwiftUI アプリを Expo に変換する動画を撮るつもりだったのだが、もう話すことがない——一発で全部やってのけたから。
アプリ3の指標
ここからはまったく別の話になる。
| Fable 5 | GPT-5.6 Sol | GPT-5.5 | |
|---|---|---|---|
| cost | $558.83 | $254.50 | $160.65 |
| active time | 3h 25m | 13h 34m | 5h 48m |
| cost per hour | $163/h | $19/h | $28/h |
| messages | 773 | 2,439 | 1,539 |
| lines of code | 10.7k | 15.3k | 14.0k |
| code health (0-100) | 88 | 86 | 76 |
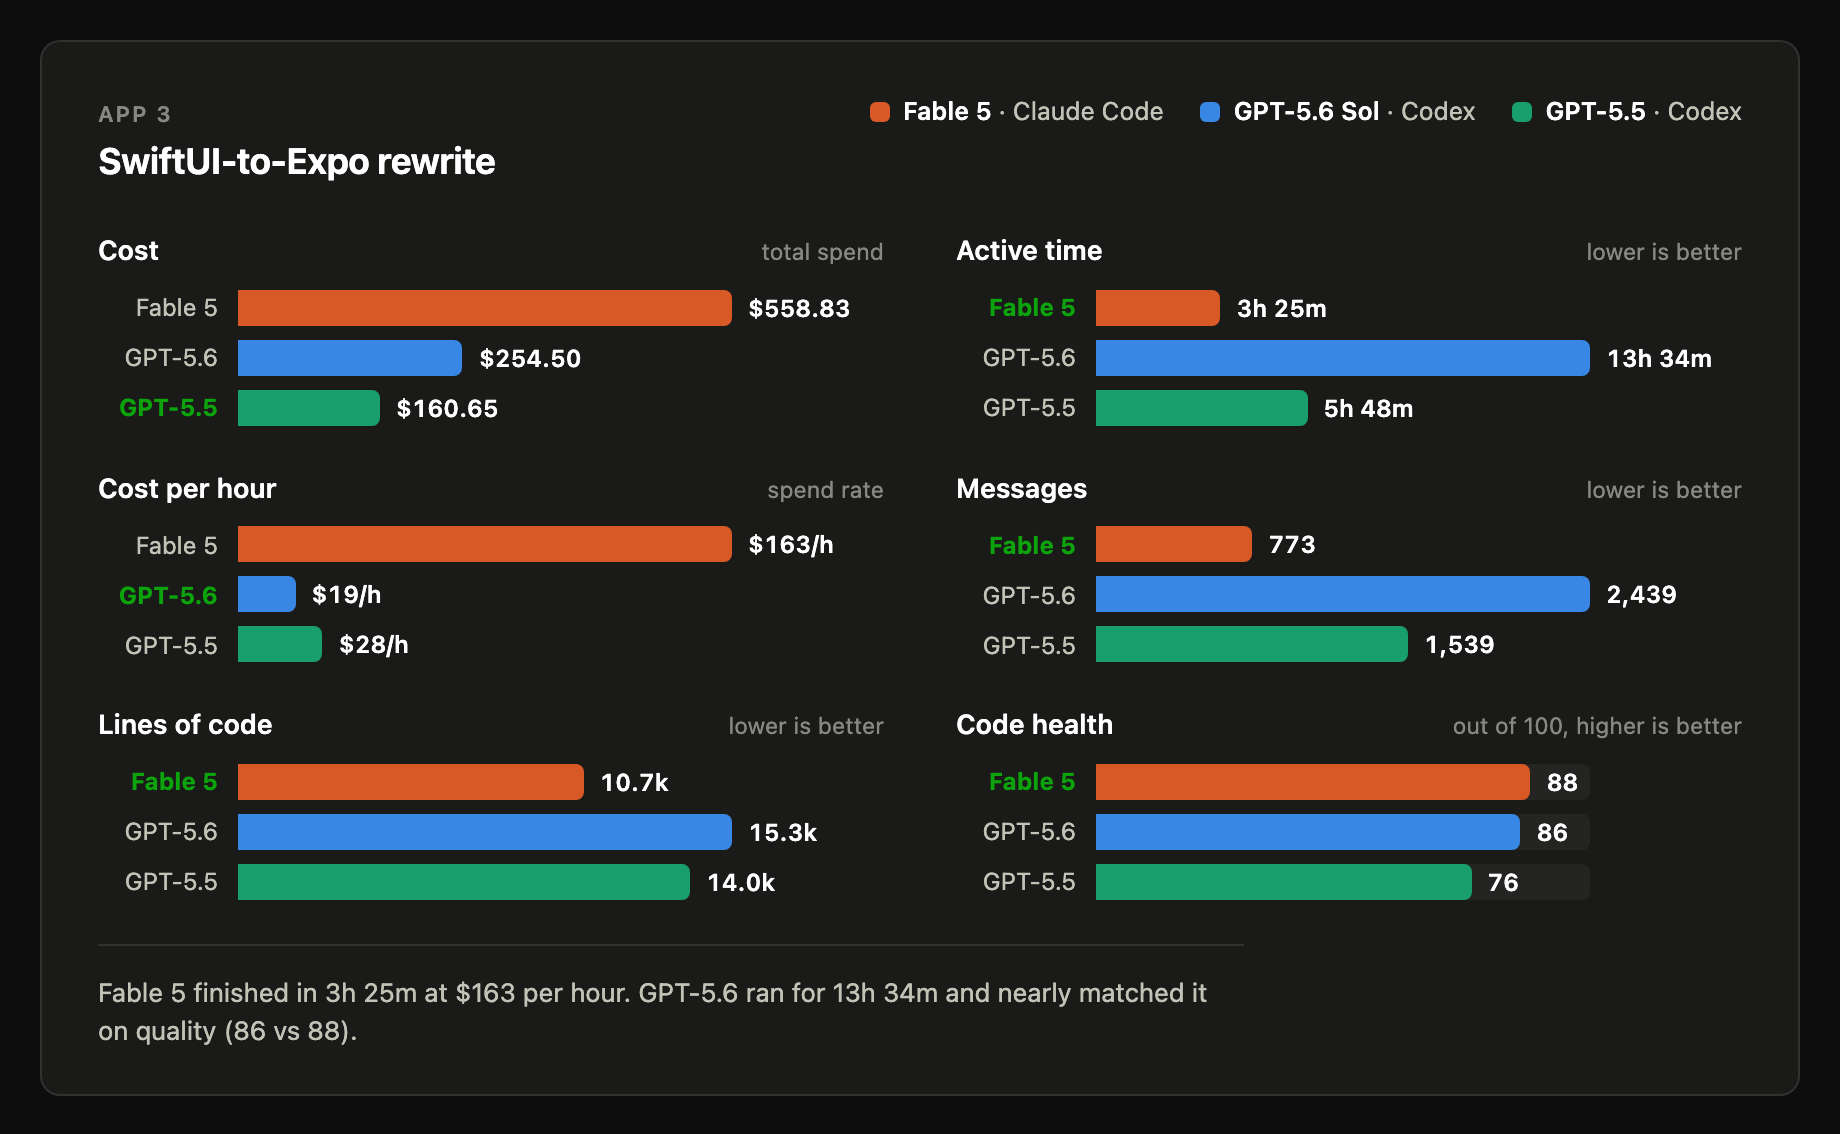
Fable 5 は3時間半で終えたが、時間単価は163ドル——このアプリ1本だけで550ドルを超える。
一方 5.6 は13時間半かかった。理由ははっきりしないが、何かのループにはまり、繰り返し検証していたのだと思う。おそらく Live Activity だ。解決するまで止まらない。これは覚えておいてほしい、後の結論で効いてくる。
品質ではまた Fable 5 が勝ったが、今回は 5.6 が非常に肉薄している(88 対 86)——価格差を考えれば、これが全场で最も極端な数字だ。そして 5.5 が納品したのは目に見えて劣る品だった。既成のネイティブ liquid glass を使わず、偽の tab bar を自作している。しかも技術的負債は3つの中で最も重い。
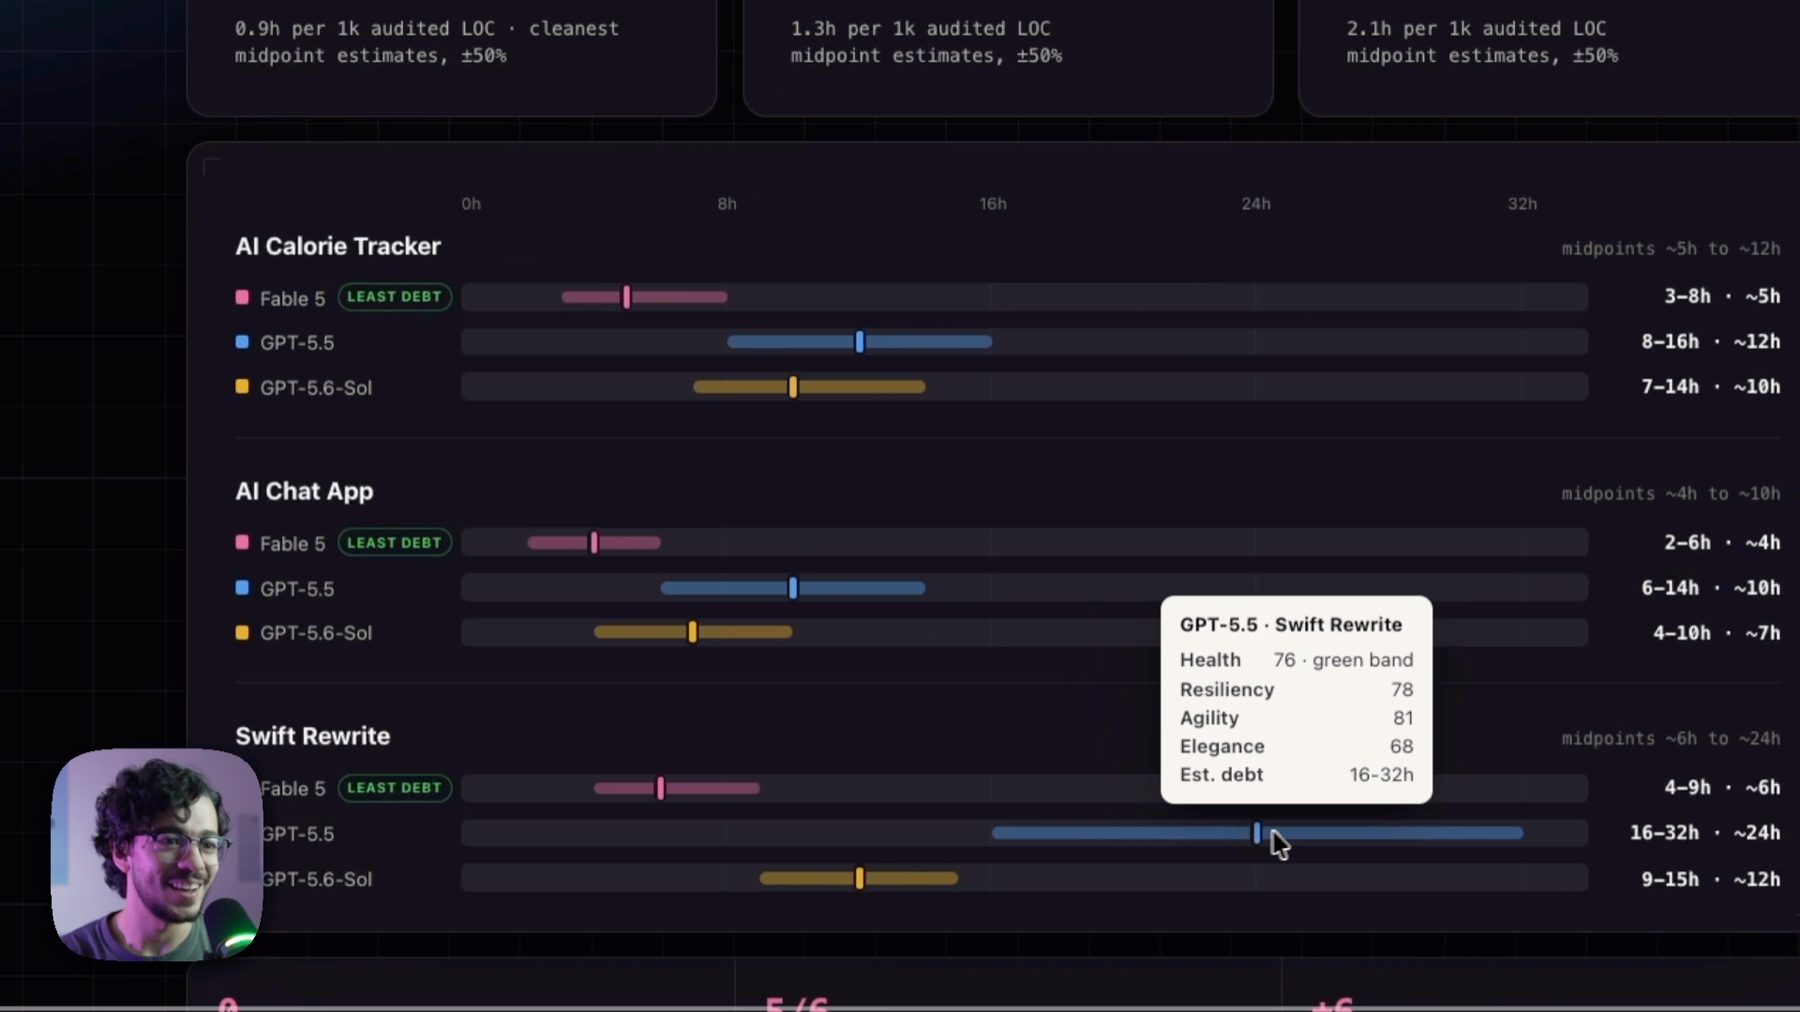
20億トークンは結局どこに消えたのか
かなりの部分は Argent と各種 MCP server だ。Argent はモデルがシミュレータ上で作業を検証するためのツールで、機能を実装するたびに毎回検証する。スクリーンショット1枚、クリック1回、そのメタデータすべてがコンテキストウィンドウに入り、それがアプリごと17タスク、モデルごと、修正の各ラウンドごとに積み重なる。
だからこそ検証とテストは必ず subagent でやる必要がある。トークンは subagent 自身のコンテキストで燃やし、メインのコンテキストウィンドウを汚さない。
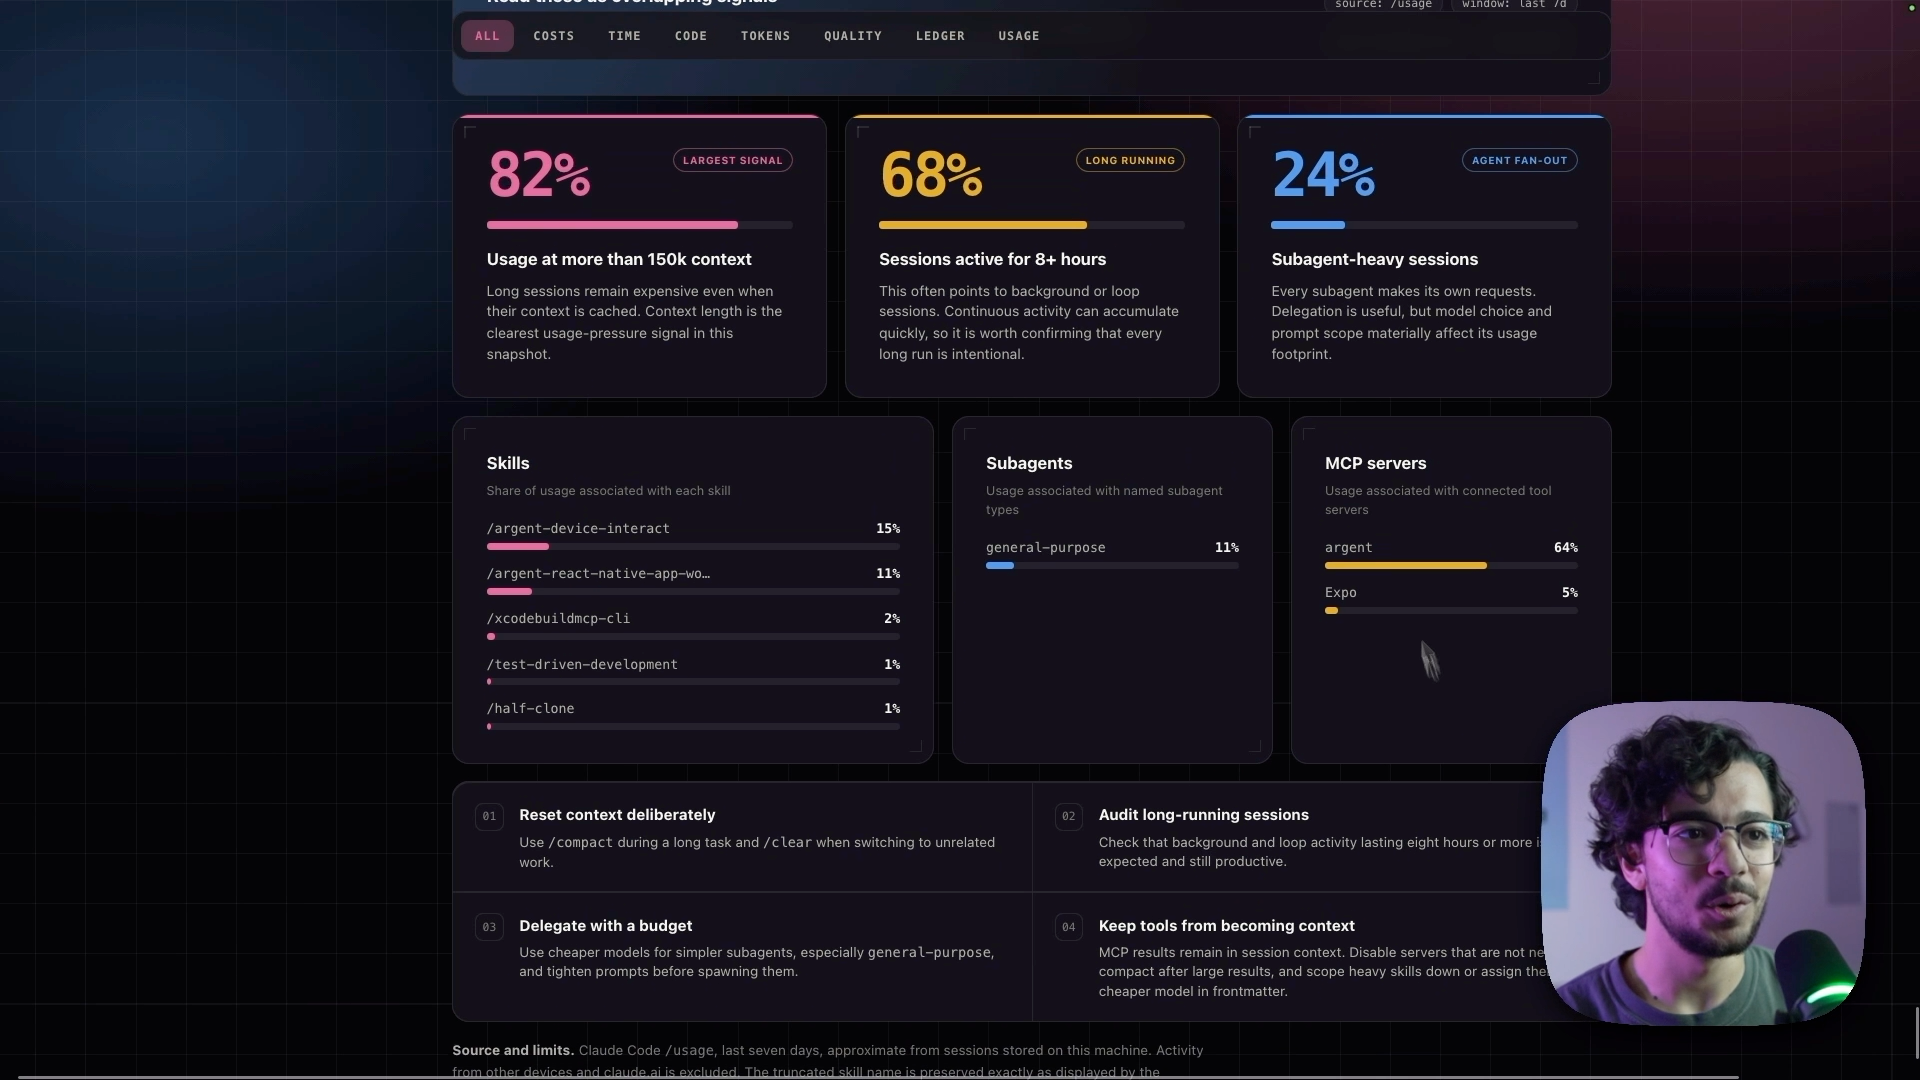
この記事の全指標を操作できる完全版はこちら:ダッシュボード。
結論:どの作業にどのモデルを使うべきか
そう、ほぼすべての場面で Fable 5 が最良だ。だが話はそれだけではない。
GPT-5.6 は働き者だ。 問題を与えれば、13時間半ぶっ続けで走ることも含め、持てる力のすべてを使って解決する。解決するまで止まらない。定義の明確な問題や自動化タスクを任せるには絶好のツールになる。
Fable 5 はベテランの同僚のようだ。 とにかく賢く見える。そして賢いからこそ、書くコードは少なく、使う時間も短く、品質は高い。上のどの表を見てもそうだ。メッセージ最少、コード行数最少、最速、コード品質スコア最高——三戦全勝。
だから私はこう使い分ける:
- 起業家で、アプリを作り、アイデアを検証し、一緒に考える相手が欲しい:Fable 5。
- ビルダーで、computer use を含むあらゆるものを自動化している:5.6 はこの領域で非常に強い。
- 素早い技術タスク、「スクリプトを書いて」「この簡単な機能を作って」:5.6。
- もっと大きなもの、たとえば PR 1本まるごと:Fable 5。主な理由はコード品質がはるかに良いことで、それはもう見てきたとおりだ。
私は両方を使い分けている。用途が違う。(ちなみに、検証の部分は実は Argent の代わりに computer use でもよかった。検証ツールの比較は、今後やるといい実験かもしれない。)
次のステップ
賛成?反対?次回の比較に Kimi も入れるべき?動画のコメントで教えてほしい。
「SwiftUI アプリを Expo に変換する」チュートリアルを録るのを楽しみにしていたが、どうやら不要らしい。適切なツールさえあれば、AI は一発でやってのける。
ツールそのもの(MCP server、skill、これを成立させている設定)については、このブログか YouTube 動画で、AI を使ったモバイルアプリの作り方を解説している。
以下、今回の実験で役に立ったリンクを全部貼っておく:
- コード、prompt、codebase skill のすべて:github.com/rami-maalouf/fable-5-vs-gpt-5-6
- すべての指標とグラフ:ダッシュボード
- 仕様駆動開発の skill:SKILL.md
- コード品質監査の skill:code-quality-scoring
- Expo API routes のドキュメント:docs.expo.dev
- OpenAI Agents SDK(JS):openai-agents-js
- Argent:argent.swmansion.com
- Twilight、あの睡眠トラッキングアプリ:App Store