如何为生产环境 RAG 系统构建回归门禁
内部政策机器人演示时答得滴水不漏,上线后却依据已被取代的旧政策给出自信答案,而且没有任何信号能告诉你退化始于何时;这篇文章讲的是怎么为它建一道回归门禁。
中文
复制
一个团队基于公司内部政策文档搭了个检索增强的聊天机器人。演示时,有人问“我们有多少天育儿假?”,机器人答对了,还引用了正确的 PDF。有人问报销额度——又对了。十个问题,十个好答案,掌声响起,上线。三个月后,一名员工问自己的承包商身份是否符合健康补贴条件,机器人给出一个自信的“符合”,依据的是去年已被取代的政策,员工据此提交了申请。团队里没人说得清这条流水线是从什么时候开始产出这种答案的,因为从来没有任何东西在衡量它是否如此。
这就是大多数生产环境 RAG 系统的真实状态。流水线并非格外不准——任何检索系统都会有漏掉的时候。缺的是那套能够察觉问题的机制。演示被当成了评估,而演示恰恰是 RAG 系统几乎不可能不通过的一种测试:问题由搭建索引的人挑选,措辞与文档中的措辞一致,问的内容是所有人都知道里面有的。
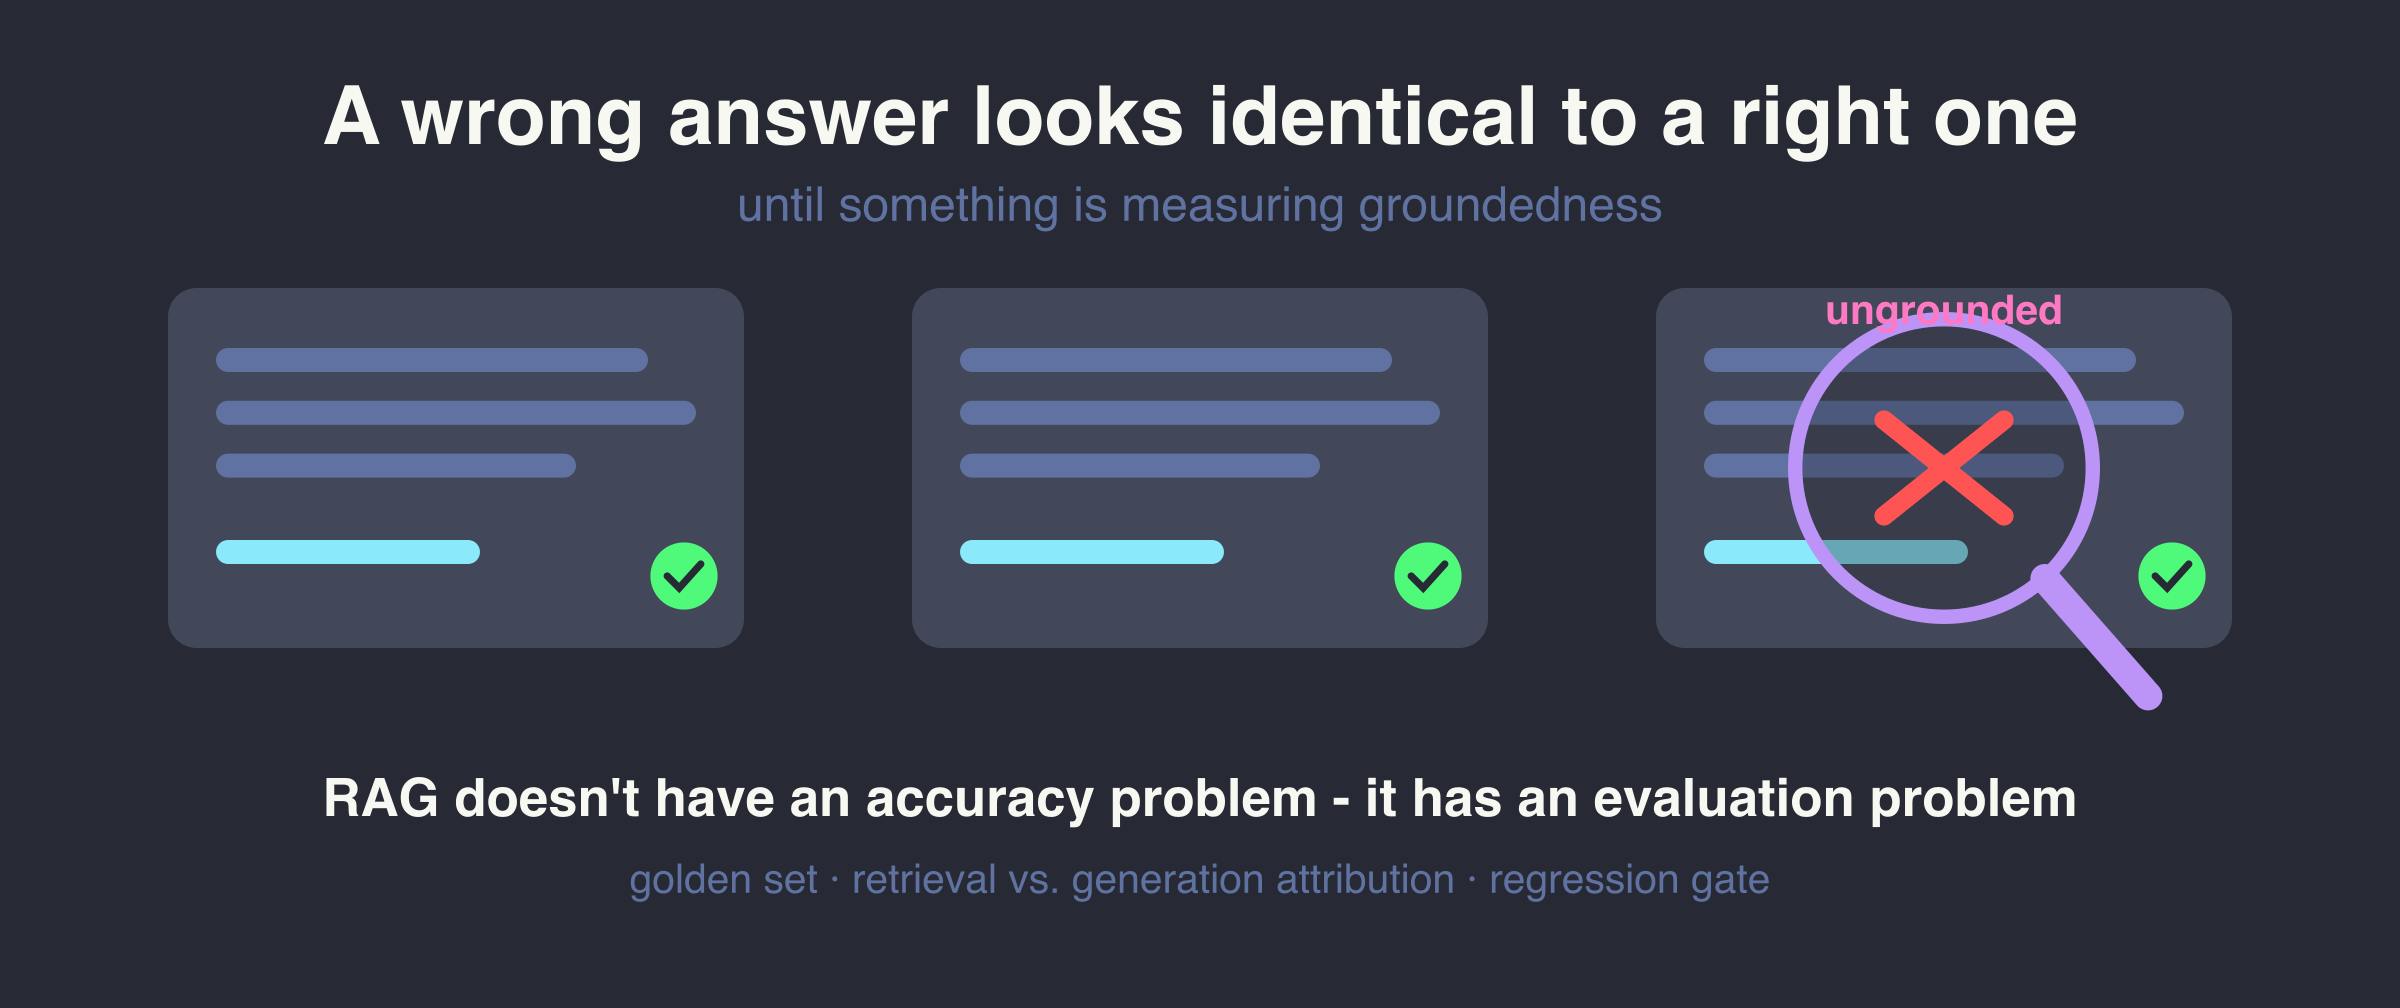
错误答案和正确答案看起来一模一样
传统软件出错时会大声报错。API 调用失败会抛异常;部署出问题会返回 500;测试用例失败会变红。RAG 的退化不会做任何这些事。换掉 embedding 模型,改掉 chunk 大小,文档更新后重新索引——系统照样返回流畅、格式规范、引用自信的答案。它们是否有据可依,在你拿到的所有信号里都看不出来:没有异常,没有延迟飙升,没有 schema 违规。
这不是 RAG 工程里的边缘情况,而是相关工程文献中反复出现的发现。一份 CAIN 2024 的经验报告覆盖了三个 RAG 案例研究(研究、教育和生物医学领域),归纳出七个反复出现的故障点——内容缺失、排名靠前的文档被漏掉、答案被检索到但在整合中丢失、答案在上下文中但未被提取、格式错误、具体程度不对、答案不完整——它的两条核心结论毫不含糊:“RAG 系统的验证只有在运行期间才可行,而 RAG 系统的鲁棒性是演化出来的,不是一开始就设计进去的。”
再读一遍第一句。你无法在发布前完全验证这一类系统。这意味着评估工具不是上线之后再补的可选项——它就是运行期间的验证,只不过被系统化了:用真实用户实际问过的问题来构建,并在系统和语料变化时持续运行。它是你唯一能得知这东西到底行不行的机制。
「RAG 能消除幻觉」是营销话术,而且有数据可以证明
团队之所以跳过评估,是因为一个根深蒂固的假设:检索为模型提供了依据,所以幻觉问题已经解决了。最有力的反例来自一个真金白银押注这件事的领域。法律检索厂商在推销自家 RAG 产品时,声称能「消除」或「避免」幻觉,甚至保证引用「不含幻觉」https://reglab.stanford.edu/publications/hallucination-free-assessing-the-reliability-of-leading-ai-legal-research-tools/?ref=hackernoon.com。斯坦福 RegLab 对这些工具做了首次预注册的实证评估,结果 LexisNexis 和 Thomson Reuters 的旗舰产品「各自的幻觉率在 17% 到 33% 之间」。
这些是专业级系统,由资源雄厚的团队在精心整理、权威的语料上构建——是 RAG 的最佳案例。相比裸模型,检索确实减少了幻觉,但仍有六分之一到三分之一的回答包含编造内容。「我们加了检索」和「我们测量了检索在自家查询上实际交付了什么」之间的差距,正是厂商营销所掉进去的那个差距。他们都能掉进去,你的内部聊天机器人当然也能。
「它准不准?」是一个问题穿着两件风衣
假设你接受了这个前提,然后问:好吧,我的流水线到底有多准?这个问题定义不清,而正是这种定义不清让「凭演示感觉」的评估方式一直存在——从来就没有一个公认的「正确」标准可供对照。
一个 RAG 回答可能在两个相互独立的地方失败,而它们需要不同的修复方式:
- 检索失败。 交给模型的 chunk 里没有答案——没被索引、没排进 top-k,或者在上下文组装时被截掉了。再怎么写 prompt 也修不好;你需要改 chunking、embedding 或排序。
- 生成失败。 答案就在检索到的上下文里,模型却忽略了它、与之矛盾,或者添油加醋。再加强 re-ranking 也修不好;你需要改 prompt 契约、换模型,或者加上输出校验。
一个笼统的“准确率”数字会把这些问题揉成一团,让你在盲目中优化。RAGAS 评估框架把这种拆解正式确立为几个可分别度量的量:上下文相关性 评估检索环节(正确的证据是否出现,又没有淹没在无关材料里?),忠实度 和 答案相关性 评估生成环节(答案中的每个论断是否都有证据支撑,是否回应了问题?)。Ragas 库后来又把检索一侧进一步拆成上下文精确率和上下文召回率。各项指标的具体实现都有已知的粗糙之处——但真正重要的是这种拆解,因为它把“机器人答错了”变成一份能定位到具体组件的 bug 报告。
一个真实的评估框架长什么样
这些都不需要研究团队。最小可用的评估框架是三样东西加一个习惯——这同样不是巧合,它正是我在 SophiArch 的《用 LLM 构建 AI 应用》课程里教的 eval 模块的形态,因为一旦 demo 不再有说服力,团队真正会去抓的就是这三样东西。
1. 黄金集:把你的领域对“正确”的定义写下来。 收集 50–100 个真实问题——来自支持工单、试用用户,以及那位知道知识埋在哪儿的技术专家。为每个问题记录预期答案 以及 它必须出自哪份文档:
{
 "id": "policy_031",
 "question": "Does the health stipend apply to contractors?",
 "expected_answer": "No - eligibility requires full-time employment status.",
 "must_cite": ["benefits-eligibility-2026.pdf"],
 "trap": "superseded 2024 policy still in corpus says yes"
}
价值就在 trap 这个字段里。简单问题会抬高你的分数;黄金集真正发挥作用的地方是已被取代的文档、答案横跨两个 chunk 的问题、语料 无法 回答的问题(正确行为是“我不知道”——CAIN 分类法里的第一个失效点就是编造而非拒答的系统),以及检索到的文本与表面措辞所暗示的意思相反的否定类问题。
2. 保留检索/生成之分的评分。 把“必须引用的文档是否出现在检索结果中?”和“答案是否忠实于检索到的内容?”分开打分。生成一侧在大规模下多半要用 LLM 评委——这可行,但并非没有毛病:MT-Bench 关于 LLM-as-a-judge 的研究发现,强评委与人类评分者的一致率超过 80%,同时也记录了系统性的冗长偏好(更长的答案得分更高,与质量无关)以及自我增强偏好的迹象(评委可能偏爱自己模型的输出)。用评委,但在把它当作回归信号之前,先拿人工标注抽查一下。
3. 回归门禁。 每次变更都跑一遍评估框架——新的 embedding 模型、新的分块策略、重建索引、改 prompt、升模型版本——分数下降就拦住这次变更,就像测试套件失败会拦住合并一样。正是这一步把评估从一次性报告变成工程控制手段。没有门禁,你的黄金集就是你在 notebook 里跑过一次的 benchmark;有了它,“我们是不是刚变差了?”在用户告诉你之前就有答案。
demo 回答的是你挑的问题。黄金集回答的是用户真正会问的问题——包括那些专门设计来让你的 pipeline 撒谎的问题。先把第二样东西建起来,再去信任第一样。
来源: HackerNoon← 返回首页