从 Playwright 路由到浏览器协议:请求拦截如何工作
Playwright 的 page.route() 如何在不同浏览器中拦截请求,以及如何仅用 Chromium DevTools Protocol 实现同样的拦截。
中文
复制
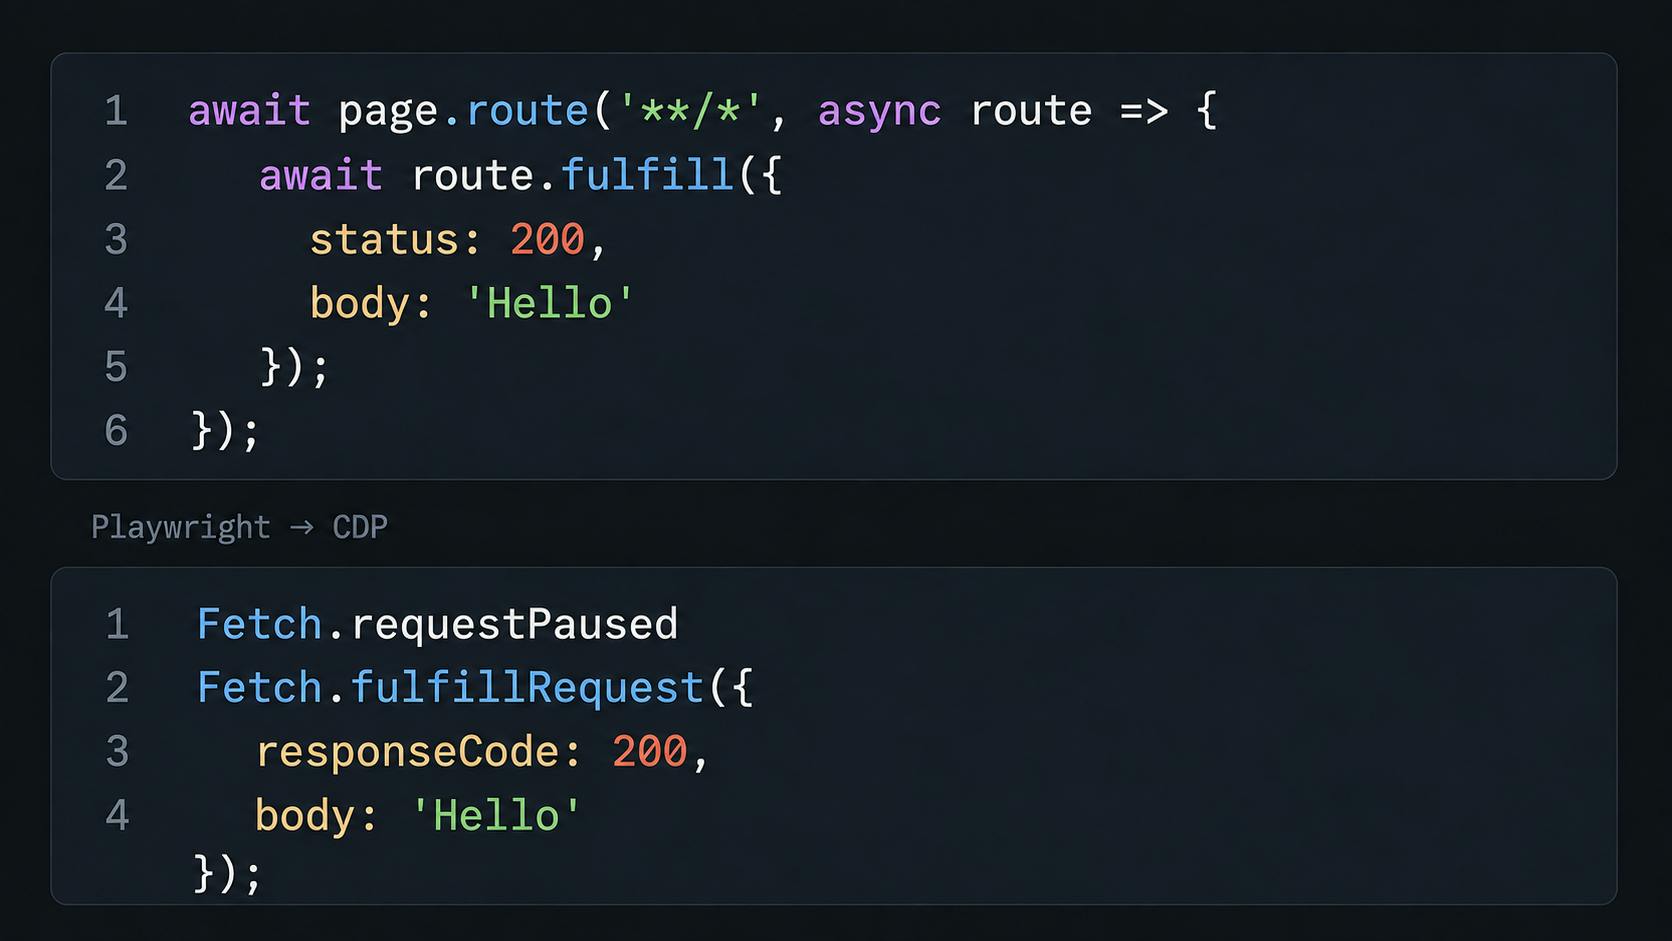
本文沿着 Playwright 的请求拦截一路向下,追到浏览器协议层。我们先看 Playwright 如何用 page.route() 拦截请求,以及它在不同浏览器里的实现方式;再看如何只用 Chromium 的 DevTools Protocol 实现请求拦截;最后看几个例子,说明了解浏览器通信机制在实践中能帮上什么忙。
我们的目标不是用底层 API 取代框架,而是搞清楚浏览器究竟暴露了哪些能力,以及什么时候直接操作底层协议是有用的。
本文所有信息和示例截至 2026 年 9 月。浏览器自动化协议变化很快,部分细节日后可能改变。
可运行的示例都在示例仓库里。
Playwright 的 page.route() 让我们可以拦截浏览器发出的请求,并决定如何处理它:放行、中止,或者自己提供一个响应。page.route() 的一个用途,是加载一个没有 DNS 或 hosts 记录的域名。
假设我们的应用跑在 http://localhost:3000,但我们希望浏览器通过 http://app.invalid 这个 URL 加载它。如果在 Playwright 测试里不做任何前置设置就调用 page.goto('http://app.invalid'),页面根本加载不出来。
不过用 page.route() 就能让这个域名在测试里正常加载。它可以拦截浏览器对 http://app.invalid 的请求,从 localhost 取回我们想在这个 URL 上加载的页面,再用这个响应去满足原始请求:
await page.route('http://app.invalid/**', async route => {
 const localUrl = route.request().url()
 .replace(
 'http://app.invalid',
 'http://localhost:3000'
 );
 const response = await route.fetch({
 url: localUrl,
 });
 await route.fulfill({
 response,
 });
});
现在测试里调用 page.goto('http://app.invalid'); 就能真正加载 http://app.invalid 的内容,而查看页面 origin 时,返回的仍是我们导航到的那个原始 URL:
await page.evaluate(() => location.origin);
// http://app.invalid
接下来看看 Playwright 用来拦截和修改请求的底层机制。
page.route() 在不同浏览器中的工作方式
Chromium
在 Chromium 中,Playwright 通过 Chrome DevTools Protocol(即 CDP)实现请求拦截。
CDP 可用于调试、检查和浏览器自动化。它按域(domain)组织,例如 Page、Runtime、Network、Performance 和 Fetch。既然聊的是请求拦截,本文最关心的就是 Fetch 域。
在看 Playwright 如何使用 CDP 的 Fetch 域之前,先理解 CDP 通信的整体机制会很有帮助。
客户端——Playwright、Chrome DevTools,或者我们自己写的脚本——可以连上 Chromium 并向它发送 CDP 命令,Chromium 用同一套协议回应。
例如,客户端可以通过 CDP 向 Chromium 发送一条 Fetch.enable 命令来启用请求拦截:
{
 "id": 1,
 "method": "Fetch.enable",
 "params": {
 "patterns": [{
 "urlPattern": "http://app.invalid/*",
 "requestStage": "Request"
 }]
 }
}
Chromium 返回的消息带有相同的 id。对于 Fetch.enable,一个成功响应可能就这么简单:
{
 "id": 1,
 "result": {}
}
当导航到 http://app.invalid/(我们启用了拦截的域名)时,Chromium 会暂停该请求并发出一个 Fetch.requestPaused 事件。
事件负载大致如下:
{
 "method": "Fetch.requestPaused",
 "params": {
 "requestId": "...",
 "request": {
 "url": "http://app.invalid/",
 "method": "GET",
 "headers": {}
 },
 "resourceType": "Document"
 }
}
Chromium 会一直暂停该请求,直到客户端告诉它如何处理:继续、失败,还是返回一个特定的响应。
Playwright 在 Chromium 中对 page.route() 的实现基于 CDP。
Playwright 通过 Fetch.enable 启用请求拦截:
Fetch.enable({
 handleAuthRequests: true,
 patterns: [{
 urlPattern: '*',
 requestStage: 'Request'
 }]
});
它还会监听 Chromium 在请求被拦截时发出的 Fetch.requestPaused 事件:
eventsHelper.addEventListener(
 session,
 'Fetch.requestPaused',
 this._onRequestPaused.bind(this, sessionInfo)
);
随后,Playwright 自行将路由与处理器进行匹配——Playwright 增加了额外能力,比如支持 glob 模式、正则表达式、URLPattern 对象和谓词。它还支持为一个路由配置多个处理器以及回退。
查看这个示例的可运行版本。
Firefox 和 WebKit
到目前为止,我们看的都是 Chromium 特有的实现。CDP 只存在于 Chromium 中,那么 Firefox 或 WebKit 里的浏览器通信是如何实现的? 就 Playwright 而言,它为 Firefox 和 WebKit 提供了自己打补丁的构建版本。这些构建让 Playwright 能在各浏览器上提供一致的自动化功能。这也是为什么 Playwright 需要自己的 Firefox 构建而不是标准的 Firefox 发行版,需要自己的 WebKit 版本而不是 Safari。 Playwright API 在所有浏览器中保持一致,底层机制则各不相同。
不用框架直接连接 Chromium
我们已经看到 Playwright 如何用 CDP 与 Chromium 通信。我们也可以不用任何框架,直接与 Chromium 通信。 首先需要连接到浏览器,这要几个步骤:
- 以启用远程调试的方式启动 Chromium。
- 请求可用的调试目标,并选择一个代表页面的目标。
- 连接到该目标的 web socket。 代码大致如下:
// Start Chromium with remote debugging enabled.
const chrome = spawn(process.env.CHROME_PATH, [
 '--headless=new',
 '--remote-debugging-port=9222',
 `--user-data-dir=${profileDir}`, // separate browser profile directory
 'about:blank'
]);

// Request /json/list to see the available debugging targets, and select a target representing a page:
const response = await fetch(
 'http://127.0.0.1:9222/json/list'
);
const targets = await response.json();
const target = targets.find(
 target => target.type === 'page'
);

// The page target includes a webSocketDebuggerUrl.
// This is the URL of the socket we can use to send CDP commands to Chromium. Let's connect to it:
const ws = new WebSocket(
 target.webSocketDebuggerUrl
);

await new Promise(resolve =>
 ws.addEventListener('open', resolve, { once: true })
);
现在我们可以向 Chromium 发送命令了。比如,启用请求拦截:
ws.send(JSON.stringify({
 id: 1,
 method: 'Fetch.enable',
 params: {
 patterns: [{
 urlPattern: 'http://app.invalid/*',
 requestStage: 'Request'
 }]
 }
}));
一旦有请求命中匹配的 URL,Chromium 就会触发 Fetch.requestPaused 事件。我们可以监听它,决定如何处理被拦截的请求:
ws.addEventListener('message', async event => {
 const message = JSON.parse(event.data);

 if (message.method !== 'Fetch.requestPaused')
 return;

 const { requestId } = message.params;

 ws.send(JSON.stringify({
 id: 2,
 method: 'Fetch.fulfillRequest',
 params: {
 requestId,
 responseCode: 200,
 body: Buffer.from('Hello').toString('base64')
 }
 }));
});
完整可运行的示例见仓库。 即便这么小的例子也需要大量样板代码,不过 Puppeteer 这类库可以替我们处理与浏览器的通信。同样的例子会变成这样:
const browser = await puppeteer.launch();
const page = await browser.newPage();

await page.setRequestInterception(true);

page.on('request', async request => {
 if (!request.url().startsWith('http://app.invalid')) {
 await request.continue();
 return;
 }

 await request.respond({
 status: 200,
 body: 'Hello'
 });
});
用了 Puppeteer,我们不必自己打开 WebSocket、跟踪消息 id 或查找 target,代码也短得多。完整的 Puppeteer 示例见此处。
WebDriver BiDi:浏览器自动化的标准化
到目前为止我们看到,浏览器自动化工具与浏览器通信的方式因浏览器而异。这让自动化变得更麻烦:同一个工具可能要为 Chromium、Firefox 和 WebKit 分别实现一套。WebDriver BiDi 就是为了在不同引擎之间提供一套通用的浏览器自动化协议。
它目前以 W3C 工作草案的形式发布,仍在积极开发中,但 Chrome 和 Firefox 已经实现了 BiDi,一些自动化框架也在使用它。例如 Puppeteer 为 Chrome 和 Firefox 都支持 BiDi,并在 Firefox 上默认使用它;WebdriverIO 则将它与其他协议一起用于浏览器自动化。
BiDi 支持许多浏览器自动化功能,包括导航和请求拦截。
这意味着我们可以用 BiDi 实现前面的例子:拦截请求,从 localhost 获取响应,再把该响应交给浏览器。
和 CDP 一样,BiDi 也通过 WebSocket 与浏览器交换命令和事件,但接口本身不同。例如,网络拦截要用 network.addIntercept——相当于 CDP 的 Fetch.enable:
{
 "id": 1,
 "method": "network.addIntercept",
 "params": {
 "phases": ["beforeRequestSent"],
 "urlPatterns": [{
 "type": "pattern",
 "protocol": "http",
 "hostname": "app.invalid"
 }]
 }
}
还需要订阅事件:
{
 "id": 2,
 "method": "session.subscribe",
 "params": {
 "events": ["network.beforeRequestSent"]
 }
}
当浏览器检测到匹配的请求时,会发出 network.beforeRequestSent,我们用 network.provideResponse 来回应,它相当于 Fetch.fulfillRequest:
{
 "id": 3,
 "method": "network.provideResponse",
 "params": {
 "request": "...",
 "statusCode": 200,
 "body": {
 "type": "string",
 "value": "Hello"
 }
 }
}
不过,BiDi 仍未覆盖 CDP 的全部能力,例如 CPU 限流,以及 tracing 和 profiling 相关的 API。
另一项缺失的功能是 CDP 暴露的 DOM.getContentQuads。它返回 quad——即元素内容框的四个角点。即使元素经过变换,quad 也能准确描述其位置。Playwright 在计算点击位置时就会用到 quad。Playwright 团队已将缺少对应的 BiDi API 列为影响交互功能完整支持 BiDi 的问题之一。
为什么了解协议层有用
大多数时候,高层 API 已经够用。只有当框架没有暴露我们所需的浏览器能力,或者我们想构建一个更精简的浏览器工具时,协议层才有用武之地。
用 CDP 扩展 Playwright
Playwright 通过 CDPSession 直接暴露 Chromium 的协议,因此我们可以照常使用 Playwright,只在需要的地方下沉到 CDP。
例如,CDP 可以通过 Emulation.setCPUThrottlingRate 支持 CPU 限流,而 Playwright 没有对应的专用 API:
const cdp = await page.context().newCDPSession(page);
await cdp.send(
 'Emulation.setCPUThrottlingRate',
 { rate: 4 }
);
await page.goto('https://example.com');
测试仍然用 Playwright 编写,CDP 只是补上缺失的浏览器能力。仓库里有一份可运行的示例。
为 agent 构建更小的浏览器工具
为 agent 构建工具时,协议访问同样有用。
现成的工具返回的内容可能超出任务所需,而每个多余字段一旦进入模型上下文都要消耗 token。例如 Chrome DevTools MCP 暴露了 list_network_requests,可以按资源类型过滤请求,但无法按 URL 或状态过滤。如果 agent 只想知道 /api/checkout 是否失败,我们仍然得取回完整列表,模型就会白白烧掉额外的 token。
一个更精简的工具可以暴露:
getFailedRequests({
 urlPattern: '/api/checkout'
})
并且只返回:
[
 {
 "url": "https://example.com/api/checkout",
 "method": "POST",
 "status": 500
 }
]
过滤可以在数据发给模型之前,基于 CDP 网络事件完成,这样列表能短得多,消耗的 token 也更少。 这能省多少?示例仓库做了测量:在某个测试页面上,一个精简的 CDP 工具回答同一问题所用的 token 大约只有 chrome-devtools-mcp 最佳过滤调用的 1/9。
结论
我们从 Playwright 的路由拦截入手,了解了如何通过不同协议实现浏览器拦截。 在此过程中,我们弄清了 Chromium、Firefox 和 WebKit 在浏览器自动化上的差异,Playwright 为什么需要打过补丁的浏览器构建,以及为什么需要像 BiDi 这样的跨浏览器协议。 这些知识不只对请求拦截有用:它还能帮我们理解自动化框架底层是怎么运作的,以及什么时候直接访问协议会派上用场。
来源: HackerNoon← 返回首页