Playwrightのルートからブラウザプロトコルまで:リクエストインターセプトの仕組み
Playwright の page.route() が異なるブラウザでリクエストをインターセプトする方法と、Chromium DevTools Protocol だけで同じインターセプトを実現する方法。
日本語
コピー
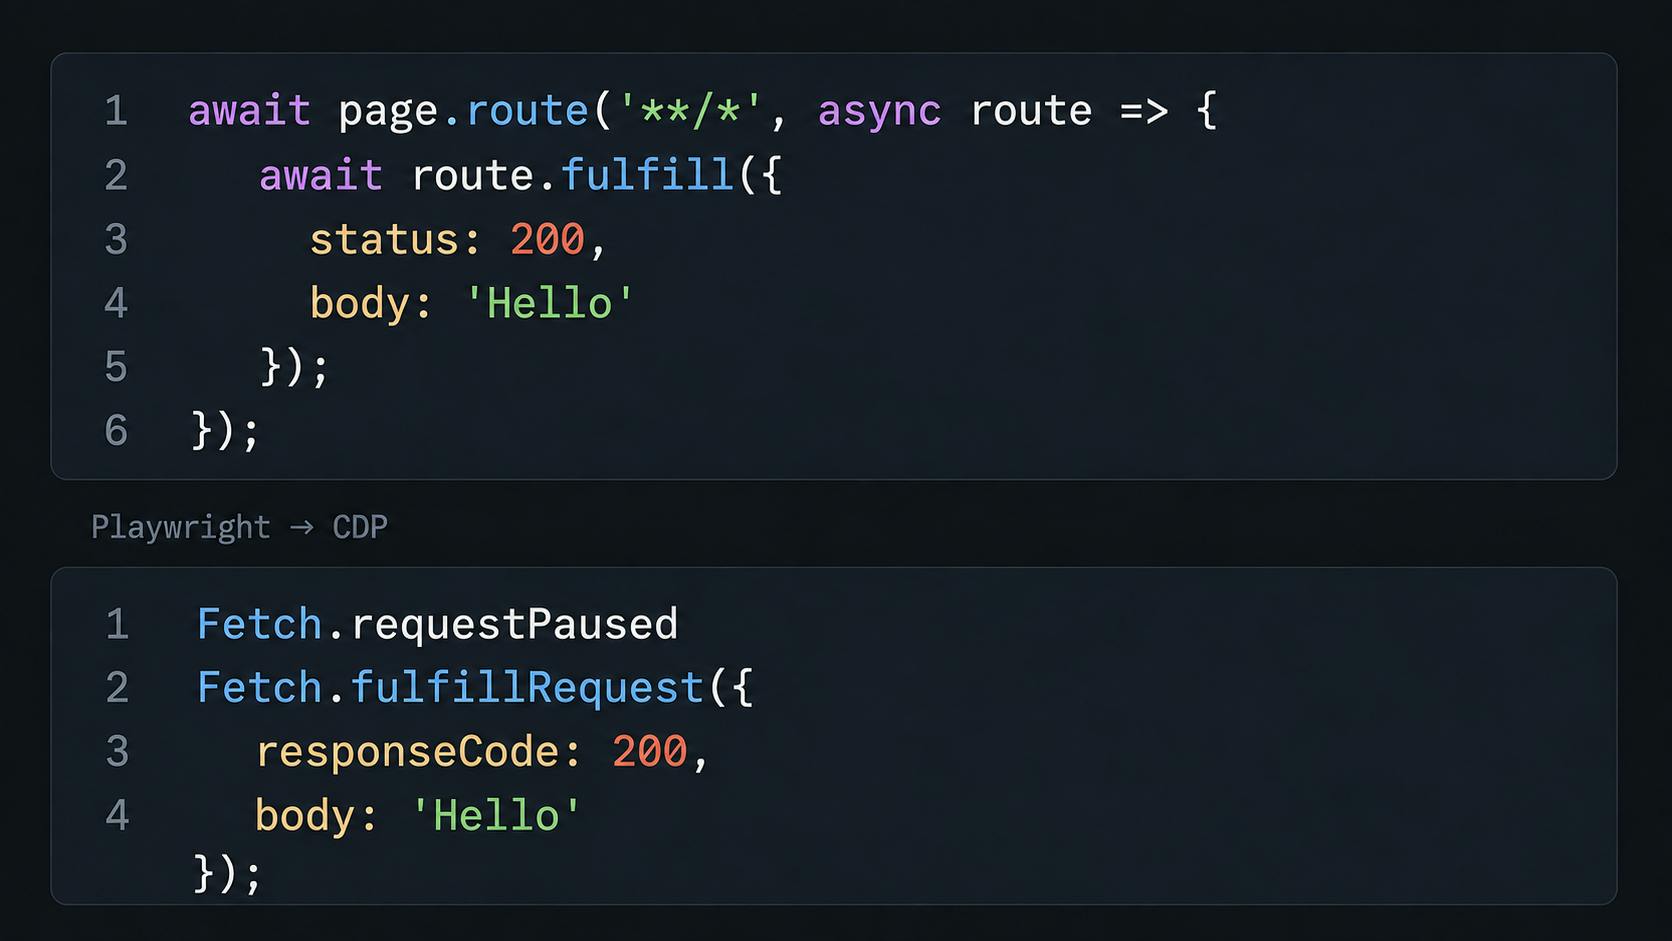
本記事は Playwright のリクエストインターセプトを入口に、ブラウザのプロトコル層まで潜っていく。まず Playwright が page.route() でリクエストをどう傍受し、それを各ブラウザでどう実装しているかを見る。次に Chromium の DevTools Protocol だけでリクエストインターセプトを実装する方法を確認し、最後にいくつかの例を通して、ブラウザの通信の仕組みを知っていると実際に何の役に立つのかを示す。
狙いは低レベル API でフレームワークを置き換えることではない。ブラウザがどんな機能を公開しているのか、そしてどんなときにプロトコルを直接触るのが有効なのかをはっきりさせることだ。
本記事の情報とサンプルは 2026 年 9 月時点のもの。ブラウザ自動化のプロトコルは変化が速く、細部は後で変わる可能性がある。
動かせるサンプルはサンプルリポジトリにある。
Playwright の page.route() を使うと、ブラウザが送るリクエストを傍受し、どう処理するかを決められる。通す、中断する、あるいは自分でレスポンスを返す。page.route() の用途のひとつは、DNS にも hosts にも登録がないドメインを読み込ませることだ。
アプリが http://localhost:3000 で動いていて、ブラウザには http://app.invalid という URL で読み込ませたいとする。Playwright のテストで何も前準備をせずに page.goto('http://app.invalid') を呼ぶと、ページはまったく読み込まれない。
そこで page.route() を使えば、テスト内でこのドメインを普通に読み込めるようになる。ブラウザからの http://app.invalid へのリクエストを傍受し、この URL で読み込みたいページを localhost から取得し、そのレスポンスで元のリクエストを満たすわけだ。
await page.route('http://app.invalid/**', async route => {
 const localUrl = route.request().url()
 .replace(
 'http://app.invalid',
 'http://localhost:3000'
 );
 const response = await route.fetch({
 url: localUrl,
 });
 await route.fulfill({
 response,
 });
});
これでテスト内で page.goto('http://app.invalid'); を呼べば http://app.invalid の中身が実際に読み込まれ、ページの origin を確認してもナビゲート先の元の URL が返る。
await page.evaluate(() => location.origin);
// http://app.invalid
次は Playwright がリクエストの傍受と書き換えに使っている下位の仕組みを見ていく。
page.route() はブラウザごとにどう動くか
Chromium
Chromium では、Playwright は Chrome DevTools Protocol(CDP)でリクエストインターセプトを実装している。
CDP はデバッグ、検査、ブラウザ自動化に使える。ドメイン単位で整理されていて、たとえば Page、Runtime、Network、Performance、Fetch がある。リクエストインターセプトの話なので、本記事で最も重要なのは Fetch ドメインだ。
Playwright が CDP の Fetch ドメインをどう使っているかを見る前に、CDP の通信の仕組み全体を押さえておくと理解しやすい。
クライアント——Playwright、Chrome DevTools、あるいは自作のスクリプト——は Chromium に接続して CDP コマンドを送り、Chromium は同じプロトコルで応答する。
たとえばクライアントは CDP 経由で Fetch.enable コマンドを送り、リクエストインターセプトを有効にできる。
{
 "id": 1,
 "method": "Fetch.enable",
 "params": {
 "patterns": [{
 "urlPattern": "http://app.invalid/*",
 "requestStage": "Request"
 }]
 }
}
Chromium が返すメッセージには同じ id が付く。Fetch.enable なら、成功時のレスポンスはこれだけだ。
{
 "id": 1,
 "result": {}
}
http://app.invalid/(インターセプトを有効にしたドメイン)へナビゲートすると、Chromium はそのリクエストを一時停止し、Fetch.requestPaused イベントを発行する。
イベントのペイロードはおおよそこうなる。
{
 "method": "Fetch.requestPaused",
 "params": {
 "requestId": "...",
 "request": {
 "url": "http://app.invalid/",
 "method": "GET",
 "headers": {}
 },
 "resourceType": "Document"
 }
}
Chromium はクライアントが処理方法を指示するまでリクエストを止めたままにする。続行するか、失敗させるか、特定のレスポンスを返すかだ。
Playwright の Chromium における page.route() の実装は CDP に乗っている。
Playwright は Fetch.enable でリクエストインターセプトを有効にする。
Fetch.enable({
 handleAuthRequests: true,
 patterns: [{
 urlPattern: '*',
 requestStage: 'Request'
 }]
});
さらに、リクエストが傍受されたときに Chromium が発行する Fetch.requestPaused イベントを購読する。
eventsHelper.addEventListener(
 session,
 'Fetch.requestPaused',
 this._onRequestPaused.bind(this, sessionInfo)
);
その後 Playwright は自分でルートとハンドラを突き合わせる。glob パターン、正規表現、URLPattern オブジェクト、述語といった追加機能は Playwright が足したものだ。ひとつのルートに複数のハンドラを設定したり、フォールバックを用意したりもできる。
このサンプルの動く版はこちら。
Firefox と WebKit
ここまでは Chromium 固有の実装を見てきた。CDP は Chromium にしか存在しない。では Firefox や WebKit ではブラウザとの通信をどう実装しているのか。 Playwright の場合、Firefox と WebKit 向けに独自パッチを当てたビルドを用意している。これらのビルドによって、Playwright は各ブラウザで一貫した自動化機能を提供できる。Playwright が標準の Firefox 配布版ではなく自前の Firefox ビルドを、Safari ではなく自前の WebKit を必要とする理由でもある。 Playwright API はどのブラウザでも同じだが、下位の仕組みはそれぞれ異なる。
フレームワークなしで Chromium に直接接続する
Playwright が CDP で Chromium と通信する様子はすでに見た。フレームワークを一切使わずに Chromium と直接通信することもできる。 まずブラウザに接続する必要があり、手順はいくつかある。
- リモートデバッグを有効にして Chromium を起動する。
- 利用可能なデバッグターゲットを問い合わせ、ページを表すターゲットをひとつ選ぶ。
- そのターゲットの web socket に接続する。 コードはおおよそこうなる。
// Start Chromium with remote debugging enabled.
const chrome = spawn(process.env.CHROME_PATH, [
 '--headless=new',
 '--remote-debugging-port=9222',
 `--user-data-dir=${profileDir}`, // separate browser profile directory
 'about:blank'
]);

// Request /json/list to see the available debugging targets, and select a target representing a page:
const response = await fetch(
 'http://127.0.0.1:9222/json/list'
);
const targets = await response.json();
const target = targets.find(
 target => target.type === 'page'
);

// The page target includes a webSocketDebuggerUrl.
// This is the URL of the socket we can use to send CDP commands to Chromium. Let's connect to it:
const ws = new WebSocket(
 target.webSocketDebuggerUrl
);

await new Promise(resolve =>
 ws.addEventListener('open', resolve, { once: true })
);
これで Chromium にコマンドを送れるようになった。たとえばリクエスト傍受を有効にするにはこうする:
ws.send(JSON.stringify({
 id: 1,
 method: 'Fetch.enable',
 params: {
 patterns: [{
 urlPattern: 'http://app.invalid/*',
 requestStage: 'Request'
 }]
 }
}));
マッチする URL のリクエストが発生すると、Chromium は Fetch.requestPaused イベントを発火する。これを監視して、傍受したリクエストをどう扱うか決めればいい:
ws.addEventListener('message', async event => {
 const message = JSON.parse(event.data);

 if (message.method !== 'Fetch.requestPaused')
 return;

 const { requestId } = message.params;

 ws.send(JSON.stringify({
 id: 2,
 method: 'Fetch.fulfillRequest',
 params: {
 requestId,
 responseCode: 200,
 body: Buffer.from('Hello').toString('base64')
 }
 }));
});
動作する完全なサンプルはリポジトリにある。 これだけ小さな例でも大量のボイラープレートが要る。ただ、Puppeteer のようなライブラリがブラウザとの通信を肩代わりしてくれる。同じ例はこうなる:
const browser = await puppeteer.launch();
const page = await browser.newPage();

await page.setRequestInterception(true);

page.on('request', async request => {
 if (!request.url().startsWith('http://app.invalid')) {
 await request.continue();
 return;
 }

 await request.respond({
 status: 200,
 body: 'Hello'
 });
});
Puppeteer を使えば、自分で WebSocket を開いたり、メッセージ id を追跡したり、target を探したりする必要はない。コードもずっと短い。Puppeteer の完全なサンプルはこちら。
WebDriver BiDi:ブラウザ自動化の標準化
ここまで見てきたとおり、ブラウザ自動化ツールがブラウザと通信する方法はブラウザごとに異なる。そのせいで自動化は面倒になる。同じツールでも、Chromium、Firefox、WebKit それぞれに別々の実装が必要になりうる。WebDriver BiDi は、異なるエンジン間で共通のブラウザ自動化プロトコルを提供するために作られた。
現在は W3C 作業草案として公開されており、活発に開発が続いているが、Chrome と Firefox はすでに BiDi を実装しており、いくつかの自動化フレームワークも採用している。たとえば Puppeteer は Chrome と Firefox の両方で BiDi をサポートし、Firefox ではデフォルトで使っている。WebdriverIO は他のプロトコルと併用する形でブラウザ自動化に利用している。
BiDi はナビゲーションやリクエスト傍受など、ブラウザ自動化の多くの機能をサポートする。
つまり BiDi でも先ほどの例を実装できる。リクエストを傍受し、localhost からレスポンスを取得し、そのレスポンスをブラウザに渡すのだ。
CDP と同様、BiDi も WebSocket 経由でブラウザとコマンドやイベントをやり取りするが、インターフェース自体は異なる。たとえばネットワーク傍受には network.addIntercept を使う。CDP の Fetch.enable に相当する:
{
 "id": 1,
 "method": "network.addIntercept",
 "params": {
 "phases": ["beforeRequestSent"],
 "urlPatterns": [{
 "type": "pattern",
 "protocol": "http",
 "hostname": "app.invalid"
 }]
 }
}
イベントの購読も必要だ:
{
 "id": 2,
 "method": "session.subscribe",
 "params": {
 "events": ["network.beforeRequestSent"]
 }
}
ブラウザがマッチするリクエストを検出すると network.beforeRequestSent を発行する。これには network.provideResponse で応答する。Fetch.fulfillRequest に相当する:
{
 "id": 3,
 "method": "network.provideResponse",
 "params": {
 "request": "...",
 "statusCode": 200,
 "body": {
 "type": "string",
 "value": "Hello"
 }
 }
}
ただし BiDi はまだ CDP の機能をすべてカバーしているわけではない。たとえば CPU スロットリングや、tracing、profiling 関連の API が欠けている。
もう一つ欠けているのが、CDP が公開している DOM.getContentQuads だ。これは quad、つまり要素のコンテンツボックスの四隅の点を返す。要素が変形していても、quad なら位置を正確に表せる。Playwright はクリック位置の計算に quad を使っている。Playwright チームは、対応する BiDi API の不在をインタラクション機能の BiDi 完全サポートを妨げる問題の一つとして挙げている。
プロトコル層を知る意味
ほとんどの場合、高レベル API で十分だ。プロトコル層が役に立つのは、フレームワークが必要なブラウザ機能を公開していないとき、あるいはより軽量なブラウザツールを自作したいときだけである。
CDP で Playwright を拡張する
Playwright は CDPSession を通じて Chromium のプロトコルを直接公開している。だから普段どおり Playwright を使い、必要な箇所だけ CDP に降りればいい。
たとえば CDP は Emulation.setCPUThrottlingRate 経由で CPU スロットリングをサポートしているが、Playwright に対応する専用 API はない:
const cdp = await page.context().newCDPSession(page);
await cdp.send(
 'Emulation.setCPUThrottlingRate',
 { rate: 4 }
);
await page.goto('https://example.com');
テストは引き続き Playwright で書き、CDP は足りないブラウザ機能を補うだけだ。リポジトリに動作するサンプルがある。
agent 向けのより小さなブラウザツールを作る
agent 向けのツールを作るときも、プロトコルへの直接アクセスは役に立つ。
既製のツールはタスクに不要なものまで返すことがあり、余分なフィールドはモデルのコンテキストに入るたびにトークンを食う。たとえば Chrome DevTools MCP は list_network_requests を公開しており、リソース種別でリクエストを絞り込めるが、URL やステータスでは絞り込めない。agent が知りたいのが /api/checkout が失敗したかどうかだけでも、完全なリストを取得することになり、モデルは余分なトークンを無駄に消費する。
より軽量なツールなら、次のものを公開し:
getFailedRequests({
 urlPattern: '/api/checkout'
})
返すのはこれだけにできる:
[
 {
 "url": "https://example.com/api/checkout",
 "method": "POST",
 "status": 500
 }
]
フィルタリングはデータをモデルに渡す前に CDP ネットワークイベントをもとに行えるので、リストはずっと短くなり、消費するトークンも減る。 どれだけ節約できるのか。サンプルリポジトリで計測したところ、あるテストページで同じ質問に答えるのに、軽量な CDP ツールが使ったトークンは chrome-devtools-mcp の最適なフィルタ呼び出しのおよそ 1/9 だった。
結論
Playwright のルート傍受から始めて、さまざまなプロトコルでブラウザ傍受を実装する方法を見てきた。 その過程で、Chromium、Firefox、WebKit のブラウザ自動化における違い、Playwright がパッチを当てたブラウザビルドを必要とする理由、そして BiDi のようなクロスブラウザプロトコルが必要な理由が明らかになった。 この知識はリクエスト傍受だけにとどまらない。自動化フレームワークが内部でどう動いているのか、どんなときにプロトコルへ直接アクセスすると役立つのかを理解するのにも使える。