x86 エミュレーションの厄災
ARM の弱い順序付けメモリモデル上で x86-TSO をエミュレートするのは、エミュレータに長くある落とし穴だ。全ストア順序付けを自前で補って初めて正しくなるが、代償は大量のメモリバリアで、性能と正確性の両立が難しい。記事は問題の根源と、手法ごとのトレードオフを整理する。
日本語
コピー
x86 エミュレーションの苦悩
本サイト最初の特集記事へようこそ。今回取り上げるのは、x86 エミュレーションに長くつきまとう問題で、私たちがエミュレートするあらゆるアプリに影響します。突き詰めれば、すべては一つの遠大な概念に行き着きます。それは x86 の全ストア順序付けメモリモデル(x86-TSO)のエミュレーションです。
ARM が定義する弱順序付けメモリモデルの上でこのメモリモデルをエミュレートするとなると、問題は一つの側面にとどまりません。細部が山ほど絡んできます。本記事では、私たちが遭遇しうる問題を一つずつ洗い出し、それをどう解決しているか(解決できていない場合もあります)を見ていきます。お菓子と温かい飲み物を用意してください。長い記事になります。
- x86-TSO とは一体何なのか
- ARMv8.0-a という素朴な出発点
- メモリへのアクセスは一番簡単な部分ではないのか
- 待って、これらのアトミック命令とは何だ
- split-lock が必須とはどういうことだ
- おい、非キャッシュメモリも動かないといけないのか
- より明るい未来に向けて
x86-TSO とは一体何なのか
x86 メモリモデルの問題をどう回避するかを掘り下げる前に、それが一体何なのかをはっきりさせておく必要があります。メモリモデルとは、システム内の各メモリアクセスが互いにどう影響し合うかを定めたルールの集合です。このルールが、シングルスレッド環境とマルチスレッド環境の両方でロードとストアがどう相互作用するかを決めます。ハードウェアに実装されたメモリモデルはいくつかあり、それぞれ形が違いますが、今日関心があるのは二つだけです。ARM の緩い(弱い)一貫性モデルと、x86 のこの全ストア順序付け一貫性モデルです。この二つはほぼスペクトルの両端に位置します。ARM は最も緩く、大量のハードウェア最適化を許します。x86 は最も厳しく、非常に強い一貫性を強制し、最適化の余地をほとんど残しません。メモリモデルを論じる際に注意すべき点が一つあります。一貫性とアトミック性の違いです。両者は関連していますが同一ではなく、あらゆる場面で等号で結べるものでもありません。
メモリモデルの違いがどう現れるかを説明するには、x86 のやり方から入るのが一番です。TSO は動作が極めて厳格で、プログラマは次のように仮定できます。あるメモリストアが起きたとき、システム内の他のすべてのプロセッサがそれを一貫して見ることができる、と。これはまた、あるメモリロードが起きたとき、それより前のすべてのストアが「論理的には」すでに完了している、少なくとも可視になっていることを意味します。これはプログラマの期待に沿います。メモリに書き込めば、書き込んだその瞬間に可視になる。そう考えるのが最も直感的だからです。ストアが実際にロードの可視性の順序を決定する。このモデルの名前はそこから来ています。動作にはもう少し細かな点がありますが、理解するのに必須ではありません。
ARM の弱いメモリモデルは、動作がそこまで直感的ではありません。デフォルトでは、ARM が使う通常のメモリロードとストアは、システム内でプロセッサ間の一貫性を厳密には保証しません。そのおかげで CPU はほとんどの場面でより効率的に動けます。ストア命令が実行されても、そのメモリ(cacheline)はシステム内の他のプロセッサに即座には可視になりません。これにより貴重な電力を節約し効率を上げられます。ハードウェアレベルでは、他のコアの cacheline を無効化したり、別のプロセッサのキャッシュを覗かせたりするのはコストが高いからです。これに関連して、あるプロセッサが別のプロセッサの書き込んだデータをメモリからロードしている場合、そのロードが更新後のメモリを見られる保証すらありません。これではマルチスレッドアプリで深刻な問題が起きそうに聞こえますよね。旧バージョンの ARM(ARMv7 以前)はメモリバリア命令で順序を保証していましたが、これには無視できない性能オーバーヘッドが伴いました。
この一貫性の制約を回避するため、ARM は load-acquire と store-release というメモリ命令も導入しました。C++ の言葉で言えば、それぞれ std::atomic の memory_order_acquire と memory_order_release に対応します。ARM の用語では、これらの命令は 厳密に言えば アトミック操作ではありませんが、プログラマはしばしば両者を混同します。FEX もずっと atomic-load と atomic-store という言葉で同じ意味を表してきました! この区別は たいてい どうでもいいことですが、こうした話題を論じるなら少し細かく見たほうがいいかもしれません。
これらの命令の主な用途は、この種の命令の間にメモリ順序を強制することです。ARM はこれを「Release Consistency sequentially consistent(RCsc)」モデルと呼びます。このモデルがどう動くかの細部に立ち入る必要はありませんが、要点はこうです。load-acquire 命令は順序どおりに観測されなければならず、並べ替えは許されません。store-release 命令も同様で、「barrier-ordered-before」セマンティクスを満たします。これにより、旧 ARM アーキテクチャのあの高コストなメモリバリア命令が不要になりました。
ARMv8.0-a という素朴な出発点
x86-TSO メモリモデルをエミュレートするとき、ARMv8.0-a が出発点の前提になります。私たちは x86 のメモリロードをすべて ARM の load-acquire 命令に、x86 のメモリストアをすべて store-release 命令に変換しました。これで FEX は x86 と実質的に同じメモリセマンティクスを得られます。ただし実際には必要以上に厳格です。その挙動にちょうど合う中間の選択肢がなかったからです。言うまでもなく、これらの命令で TSO をエミュレートするコストは極めて高く、それを示すマイクロベンチマークがあります。ARM CPU は、比較的珍しいはずの acquire/release 命令が突然実行の大半を占めるようになることなど想定して設計されていません。
まずは単純なものから始めましょう。ハードウェアにかなり優しいマイクロベンチマークです。厄介なエッジケースはなく、よくある状況でメモリにアクセスするだけです。これで、最良の場合がどうなるかを表すベースラインの数値が得られます。
このグラフを分解すると、いくつか面白い話が見えてくる。各マシンの Load と Store の列は、ハードウェアが目指すべきベースライン性能の数値を表している。これは各システムのメモリ帯域を飽和させるものではなく、どの操作にも同じ量の仕事をさせるものだ。acquire-load の結果に目を向けると、テストした 5 つの CPU のうち 3 つが acquire-load の使用によってかなり大きな性能低下を起こしていることがわかる。さらに、AmpereOne CPU の release-store 命令は他の結果に比べて驚くほど低く、M1 の Acquire/LRCPC ロード命令もベースラインを明らかに下回っている。
AmpereOne での結果は、このレガシーな経路がどれほど酷くなり得るかを特によく示している。これらの命令はそもそもこういう使われ方をするために設計されたものではない。x86 のエミュレーションでは、すべての load に acquire-release セマンティクスを使うことで、実質的に ARM CPU に非常に厳しい制約を課すことになる。load 命令同士をまったく並べ替えられなくなるのだ。毎秒数百万のそうした命令が飛び交う状況で、性能が良くなるはずもない。だが ARMv8.0-a では使える命令がこれしかなく、これを使うしかない。Cortex-X4 と Cortex-X925 はこれらの命令を非常に高い性能で実行し、Oryon-3 は明らかにその優先度をかなり低くしている。
次はどこへ向かうのか?
LRCPC-load 命令をよく見てみよう。これは ARMv8.3 以降で必須になっている。この拡張は ARM ISA に新しい load 命令群を追加し、ARM の従来の RCsc モデルの上に新しいメモリモデルを導入した。この新しい「Release Consistency processor consistent(RCpc)」メモリモデルこそ、まさに我々が求めていたものだ。この拡張は x86 エミュレーションの要求を中心に設計されており、実装したハードウェアでは大量に使われると見込まれる。グラフからわかる通り、ほぼすべてのプラットフォームで LRCPC-load の性能は通常の load と遜色ない。
新しい ARM で必須となったこの拡張があれば、メモリ性能の問題はほぼ解決したと言える。少なくともこのマイクロベンチマークでは。FEX はこの拡張を検出すると、Acquire-Load 命令を完全に無効化し、LRCPC-Load に切り替える。では Apple M1 のあの結果は何なのか……?
ここは Apple がこの問題をどう解いたかを褒めるべきところだ。Apple Silicon プロセッサでは、彼らは x86-TSO メモリモデルのサポートを直接組み込んだ。この CPU 機能を有効にすると、通常の ARM load/store 命令の挙動が変わり、x86 の要求に合致するようになる。彼らがこの道を選んだのは、ARM エコシステムへ全面的に移行した後も自社ハードウェアには高性能な解決策が必要だと理解していたからだ。だから彼らのハードウェアでは、LRCPC-load 命令は実質的に acquire-load 命令の別名にすぎない。彼らの x86 エミュレータはこれらの命令を使わないからだ。x86 メモリモデルを実装している以上、通常の load/store 命令をそのまま使えばよく、それが我々のマイクロベンチ結果では判別不能な性能オーバーヘッドとして現れている。公平に言えば、このスレッド単位の TSO モード切り替えには確かにいくらかの性能影響がある。ただここでは見えないだけだ。FEX が Asahi Linux からこの CPU 機能を検出すると、我々もそれを有効化し、この性能向上をただで手に入れる。潜在的な懸念は、x86 エミュレーションのコードと ARM のコードを行き来するとき、ARM のコードがすべてのアクセスを TSO にすることで不要なオーバーヘッドを払うことだ。この懸念はもっともだが、エミュレーション下で実行される ARM ネイティブコードの量はほぼ 0% だ。開発者として気にするのは、1% のメモリアクセスが 10% 遅くなることではなく、99% のアクセスが「理想」性能の 15% になることだ(AmpereOne の結果が示す通り)。
念のため言っておくと、我々は TSO モードがこのプラットフォームで高性能な x86 エミュレーションを実現する最良の道だと考える。すべてのメモリアクセス命令の挙動が期待通りになることを保証してくれるからだ。公式の FEAT_LRCPC 拡張には実は 3 つのバージョンがあり、それぞれが実装にパッチを当てるようなもので、それ自体が問題の大きさを物語っている。
- FEAT_LRCPC —— GPR に基本的な TSO load 命令を追加
- FEAT_LRCPC2 —— TSO load 命令に小さなオフセットの即値を追加
- FEAT_LRCPC3 —— 基本的なベクタおよびスタックベースの TSO load & store 命令を追加
これら 3 つの拡張があってもなお、TSO のハードウェアスイッチがあるかのようにはエレガントにエミュレートできないエッジケースが残っている。我々は今後もさらに拡張バージョンが現れ、後述するいくつかのレガシーな問題を修正しようとすると予想している。
メモリへのアクセスが一番簡単な部分だと思ってた?
前節では ARM ハードウェアにかなり気を遣い、下層ハードウェアのアラインメント要求に従って性能ベースラインを得た。だが x86 をエミュレートすると、いきなり目に飛び込んでくる厄介な問題がある。あなたの大好きな x86 アプリはアラインメントなど気にしていない! メモリに好き勝手にアクセスし、cacheline 境界をまたぎ、未アラインメントのアトミック操作を実行する。アラインメント絡みの問題で思いつくものは、これらのゲームが全部やっている。この問題はあまりに深刻なので、我々は split-locks と名付けた。その影響は大きく、Linux カーネルでさえこうした操作を捕捉し、発生時にゲームを遅くする! 多くのプレイヤーがこの性能低下を避けようとカーネルオプションをいじる羽目になっている!
まだ完全な split-locks の話に入るつもりはない。まずはアラインメントを気にしない環境での load-store 命令から始めよう。x86 はプログラマに対していくつかの保証を与えている。load-store を一度実行し、それが同一 cacheline 内に収まっていれば、その load-store はアトミックであり、かつ先に述べた一貫性モデルにも従う。ただし、ハードウェア開発者に少しばかり配慮して、その load-store が cacheline を またいで しまった場合、データはもはやアトミックではなくなり、他のスレッドは tearing を目にすることになる——実際に起きる。だからプログラマは注意しなければならない。普通の load-store は split-lock ではないのだ。
これらの基本アクセスを load-acquire/store-release でエミュレートする場合、問題になるのは ARMv8.0 が要求する自然アラインメントだ。つまり、アクセスするデータのサイズが何であれ、アドレス内のメモリのオフセットはそのサイズと一致していなければならない。8 バイトアクセスならオフセット 0、8、16、24 などに落ちなければならない。ネイティブの ARM アプリケーションならこれで問題ないが、自然アラインメントの要件が満たされなかったらどうなるか? ARM では、その命令がアラインメントエラーを引き起こす。ハードウェアがアラインメント要件を満たしているか検証し、満たしていなければ CPU が例外を発生させる。通常はクラッシュにつながるが、FEX は特別な処理を行う。
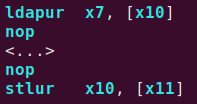
FEX の JIT 機構では、x86 の load-store をエミュレートするために使われるメモリ load-store 命令を追跡している。ある load-store がアラインメントエラーを引き起こす可能性があると分かると、コード中にパッチポイントが現れる。load-store 命令の場合、それは命令の前か後ろに置かれた NOP として現れる。これらのパッチポイントの一つでアラインメントエラーが起きると、FEX は例外を捕捉し、コードを load-acquire/store-release 命令から基本的な等価の load-store にパッチし、その命令をデータメモリバリアで包む。そして実行を続ける!
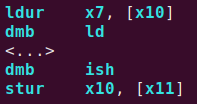
パッチ前とパッチ後
先ほど長々と述べた、ARMv8.0-a がこうした洒落た load-acquire、store-release 命令をどう追加したかという話はどうなったのか? アラインメントの挙動が一致しなくなった時点で、我々は即座に古典的なメモリバリア命令へと後退する。先ほどのグラフはこの厄介なケースを示していなかったので、新しいデータをいくつか導入しよう。
ああ、整理すべきデータが本当に多い。ハードウェアが TSO をエミュレートする際に「最適」な経路からどれだけ離れているかを再確認できるのは良いことだが、ここで関心があるのはそこではない。興味深いのは、このマイクロベンチマークが、通常の load/store においてアラインメントありと未アラインメントの間にどれほどの差があるかを示していないことだ。だから両者の平均を取っただけにした。ARM の列から x86 CPU と通常の load-store のデータを取り除く。これらは FEX の一般的な経路ではないからだ。こうすることで、未アラインメントメモリアクセスがエミュレーション下でどれほどの損害を与えるかを、より的を絞って見ることができる。
だいぶまともなデータ図になったので、左から右へ順に見ていき、何が起きているのかを説明しよう。
AmpereOne
これはなかなか面白い。アラインメントありと未アラインメントのロード命令はほぼ同等の性能で、差はノイズの範囲内だ。つまり、未アラインメントロードがデータメモリバリアのペナルティを食らうにもかかわらず、CPU は耐えている。他のプラットフォームと比べて性能がかなり低いことを考えると、このベンチマーク自体が何か別のものでボトルネックになっている可能性もある。
ストアの方は芳しくない。未アラインメントであってもだ。グラフ上ではほとんど見えない! 未アラインメントストアに当たると性能損失は約 8.5% だが、そもそも出発点が低いので気づきにくい。このテストで通常のストア命令が約 28GB/s を出せることとは対照的だ。
ここから得られる唯一の結論は、Ampere は何らかのサーバー級ワークロード向けに最適化されており、コンシューマー向けハードウェアの挙動とはあまり一致しないということだ。興味深いデータ点ではあるが、我々のユーザーは普通こうしたハードウェアでゲームを動かしたりはしない。
Cortex-X4
これは非常によく使われる CPU コアで、Qualcomm Snapdragon 8 Gen 3 に搭載されている。グラフがデータで溢れかえるのを避けるため、この SoC のコアは一つだけ測定した。多くの携帯ゲーミング機がこれを使っているので、興味深いテスト対象だ。このリストで唯一のスマートフォン SoC であることを考えると、その性能は実に意外なほど良い。全体として、このコアはおおむね我々の予想に沿っており、グラフ上の傾向も図中の次世代 Cortex と一致している。
この CPU の主な状況はこうだ。アラインメントされたロードとストアはまずまず健闘し、それぞれ約 11.5GB/s と 6.7GB/s を出せる。面白いのは未アラインメントの load/store を扱う際の性能低下だ。DMB 命令にぶつかると、このベンチマークではロードとストアがほぼ同等のペナルティを受け、どちらも 50% 前後になる。
これは、CPU がかなりの数の LRCPC-release loadstore を in-flight に保てることを意味するようだ。だから DMB 命令は遭遇したときの影響が大きいが、壊滅的な性能損失には至らない。ただ、アラインメントの問題による 50% の性能低下は良い結果とは言えない。
Cortex-X925
続いて X4 に続き、DGX Spark とその X925 コアを見ていきます。これは単に新しい ARM CPU コアというだけでなく、搭載するシステムのメモリ帯域もはるかに広いものです。プラットフォームの帯域は 273GB/s で、以前は 76.8GB/s でした。つまり X4 とほぼ同等の結果であっても、グラフ全体が少し底上げされるだけです。興味深いのは、非アライメントアクセスのペナルティも X4 とほぼ同じである点です。ただし store はやや早く回復しているようで、これは高速なメモリが効いているのかもしれません。ここに意外な点はなく、世代をまたいでも性能特性は一貫しています。
Oryon-3
Qualcomm が発表したばかりの CPU コア設計です。Linux 対応はまだ進行中ですが、すでに力強さを見せています。最も興味深い結果はアライメントされた LRCPC-load 命令で、性能は通常の load と同等になっています。つまり行儀の良いアプリケーションなら、通常はフル性能が期待できるということです。release-store 命令もかなり健闘しており、帯域は通常の store の 68% にとどまるものの、決して悪い数字ではありません。
この CPU も非アライメントの LRCPC-release loadstore のペナルティは避けられません。load 側は Cortex-X925 とほぼ同じ約 70% の性能低下で、Snapdragon X2 Elite の帯域が潤沢なことが効いているのでしょう。しかし store 側はむしろ悪化し、性能は約 43% です。それでも、こうした非アライメントアクセスのペナルティを抱えながら、このプラットフォームは実際には Cortex 系のアライメントアクセスよりも高速です。
このプラットフォームには妙な点が一つあります。「Fully coherent 96KB 6-way L1 cache with 64B coherency granules」を謳っているのです。我々の理解では、これは非アライメントアクセスの性能影響がもっと小さくなるはずだということを意味します。興味深い……これは覚えておきましょう。
Apple M1
これは重点的に論じなければならないものです。真の転換点であり、あの「Apple の瞬間」です。ARM が実行可能なだけでなく、より高速になり得ることを誰にともなく示しました。このグラフの数字は驚異的で、これは Apple が TSO メモリモデルをハードウェアに直接組み込んだ成果です。この製品は LRCPC-release アクセスを使っておらず、我々は TSO 機能を有効にしただけですが、アライメント版はほぼ非アライメント版に追いついています。store での性能低下は 5% 程度でしょうか? グラフ上の他のどのデバイスと比べても、実質ゼロと言ってよいでしょう。根本的な理由は、非アライメントアクセスに対して DMB 命令をコードに埋め戻す必要がなくなり、ハードウェアが直接処理するからです。
我々にとって、これこそが ARM 上で真剣に x86 エミュレーションに取り組む意味であり、Apple がユーザーのネイティブ・エミュレーション両方のソフトウェア体験を気にかけている証拠でもあります。彼らは問題を見つけ、それを直接「解決」して消してしまったのです。 とはいえ、TSO モードを有効にすると性能は確かに落ちます。前のグラフと比べて store 性能は通常の 76% にとどまり、load 性能はほぼ横ばいです。すべてがはるかに高速な状況では、この程度のコストははるかに受け入れやすくなります。
非アライメント LRCPC/release アクセスのまとめ
本節の締めくくりとして、これらすべてのベンダーが実際にサポートしている性能改善について触れます。ARM が策定した拡張で FEAT_LSE2 と呼ばれ、テストしたすべてのプラットフォームが実装しています。先に述べたように、acquire/LRCPC/release メモリアクセスは自然アライメントが必要で、そうでなければ CPU のアライメント例外が発生します。ARM はこの問題をきちんと考え、この拡張を実装しました。これが x86 エミュレーション(そしておそらく他のワークロード)の助けになります。この拡張は acquire/LRCPC/release load/store 命令のアライメント要件を緩和するだけでなく、read-modify-write アトミック操作のアライメント要件も緩和します!
話は良さそうですが、問題があります。つまりこれが x86 エミュレーションに与えるのは限界的な性能向上にとどまるということです。この拡張はアライメント要件を緩和し、16 バイト粒度内での非アライメントメモリアクセスを許可するにすぎません。この 16 バイト粒度をまたぐアクセスは依然としてアライメント例外を引き起こします。x86 アプリケーションはメモリアクセスのアライメントなど気にしないので、キャッシュライン全体をまたぐ非アライメントアクセスが発生します。x86 では、read-modify-write アトミック操作だけがキャッシュラインをまたがないように試みるのです!
というわけで、試みには感謝しますが、見た目は良くても実際にはほとんど役に立ちません。ここまで来たので、これらの RMW アトミック操作も見てみましょうか?
おや、このアトミック命令は何だ?
ほとんどの現代の命令セットと同様、x86 はアトミックメモリ操作をサポートしています。これらの命令はメモリ内のデータに対して ALU 演算をアトミックに実行し、中間状態を外部から見えるようにしません。x86 の言葉では、これはアトミックかつ一貫したメモリに対する操作であり、ARM ではアトミック性のみを保証するか、あるいはアトミック性と一貫性の両方を保証するかを選べます。先に簡単に触れましたが、データに対するアトミック操作とそのデータの一貫性の間には実は違いがあります。何が違うのでしょうか?
x86 メモリモデルに関するこれまでの議論では、load と store が他のプロセッサから見えることに関わる一貫性の問題を扱ってきました。完全に無視してきたのは、これらのメモリアクセスのアトミック性要件です。x86 の世界では、load や store は通常、非アライメントであってもアトミックに完了します。つまり 8 バイトを store し、別のスレッドが競合状態でこの 8 バイトを load した場合、store 前と store 後のデータが混ざったものを突然見ることは決してありません。ARM では、これらのアトミック性保証は明らかに弱く、非アライメント store 命令を実行した場合、ISA 仕様は読み取ったデータの撕裂について何も保証しません。幸いなことに、自然アライメントされた load-store 命令については、ARM には 「single-copy atomicity」 と呼ばれる仕様があり、これらのアクセスで撕裂が起きないことを保証しています。さらに良い知らせもあります。先に触れた FEAT_LSE2 拡張ですが、これが single-copy atomicity の保証を 16 バイト粒度内のあらゆる非アライメントアクセスにまで拡張するのです! 悪い知らせは、x86 の single-copy atomicity 保証がキャッシュライン全体をカバーするため、この拡張でも根本的に問題は解決せず、発生回数が減るだけだということです。
原子性と一貫性の違いについては、もう十分に語られてきた。では本当のアトミック命令はどこにあり、何ができるのか。ARMv8.1-a 以降、我々の ISA には x86 のアトミック命令とほぼ一対一で対応する命令群が追加された。ここで完全なリストを出し、我々の JIT でどう対応しているかを見ていこう。
| x86 | ARMv8.1-a |
|---|---|
| LOCK DEC | ldaddal |
| LOCK INC | ldaddal |
| LOCK NEG | ??? |
| LOCK NOT | ldeoral |
| LOCK ADC | ldaddal |
| LOCK ADD | ldaddal |
| LOCK AND | ldclral |
| LOCK OR | ldsetal |
| LOCK SBB | ldaddal |
| LOCK SUB | ldaddal |
| LOCK XADD | ldaddal |
| LOCK XOR | ldeoral |
| LOCK BTC | ldclralb |
| LOCK BTR | ldeoralb |
| LOCK BTS | ldsetalb |
| XCHG | swpal |
| LOCK CMPXCHG | casal |
| CMPXCHG8B | caspal |
| CMPXCHG16B | caspal |
見てのとおり、19 個のアトミック RMW 操作がすべて揃っており、ほぼどれも ARM の命令に直接対応させられる。怪しいものは無視していい。実際のワークロードでは使われないし、深掘りしても話がどんどん脇に逸れるだけだ。両アーキテクチャの間にはかなり明快な 1:1 の対応がある。これで一件落着、だろう? x86 エミュレーションの面白さはここにある。命令が揃っているからといって、すんなり繋ぎ込めるわけではない。非アラインドアクセスが通常の load と store の性能を大きく損なうことは既に長々と書いたが、同じ問題が RMW アトミック操作にも当てはまる。
この図で見ているのは単一のアトミック命令で、そのメモリアドレスはある cacheline 内のどこかに位置する。19 個のアトミック操作のデータを全部描いたら、この図は今よりずっと見づらくなる。これらの操作の挙動はおおむね同程度で、全部描いても冗長なうえ、ここで議論したい内容とは関係がない。また、これは本記事で初めて本当に対数スケールを使った図なので、見るときははっきり意識してほしい。最速から最遅までの性能差はおよそ 1000 倍のオーダーになる。
まずは図の中の x86 Zen プロセッサから見ていこう。この結果こそ、我々のシミュレーションが目指すべきものだ。見てのとおり、アクセスが単一の cacheline 内に完全に収まっていれば、命令レイテンシは一律 1.44ns になる。理由は x86 が「アトミック cacheline」、別名「コヒーレント cacheline」を持っているからだ。非アラインドのアトミック操作が cacheline 境界をまたがない限り、コストはほぼ同じで済む。これは何十年も前からサポートされている x86 の極めて強力な機能で、ゲームはそれと気づかないままこれに大きく依存するようになっている。x86 の結果で最も目を引くのは最後のもので、64 バイトの粒度をまたぐと約 660ns かかる! 他の結果よりおよそ 458 倍遅く、驚くべきことに、この時点でハードウェアはついに split-lock に頼ることになる。
本記事の準備中に公開された Chips and Cheese の記事を挙げておきたい。split-lock がなぜこれほど劇的に遅いのかを深く掘り下げており、その仕組みが分からないなら一読の価値がある。特に、x86 の split-lock は cacheline をまたいでも x86-TSO の原子性と一貫性の保証を維持し続ける。データが 決して 分断されることはない。これは少し常軌を逸していて、後ほどさらに説明する。
次にARMプロセッサを見ていきます。まずは自然アラインメントのレイテンシデータからです。ご覧のとおり、どのプラットフォームもそれなりの性能は出していますが、最新のコアでもx86には遠く及びません。最速のARMプラットフォームでもレイテンシはx86の約3倍で、これはゲームのパフォーマンスに直接影響します。ただし通常は直接のボトルネックにはならないため、影響を正確に測るのは困難です。次のデータポイントに移ります。ほとんどのARMプラットフォームでは、16バイト粒度をまたぐ場合と64バイト粒度をまたぐ場合の結果は、実質的に統合できます。ARMの仕様が非アラインのアトミック操作をどう定義しているかにより、この2つの結果はほぼ等価であり、FEXはこれをx86のsplit-lock問題と同じものとして扱います。
このsplit-lockの問題については最初から触れてきましたが、FEXは具体的にどうエミュレートしているのか、そしてなぜそんなに遅いのか。「Apple M1はx86-TSOをハードウェアレベルでサポートしていたはずだが、それでもなぜ遅いのか」。先ほど触れたことを思い出してください。FEAT_LSE2は16バイト粒度内の非アラインメモリアクセスをサポートする機能を導入しました。これらのsplit-lock操作も結局は同じアラインメント問題に行き当たりますが、はるかに遅くなります。FEXはこれらの命令を単純なDMB操作に置き換えることができないため、実行されるたびにalignment-faultが発生します。つまり、split-lock操作は毎回、カーネル → ユーザースペースのシグナルハンドラ → カーネル → 元のコードというサイクルをたどることになります。カーネルモードとユーザーモードの往復はどのプラットフォームでも遅く、それが毎秒何千回も発生すればオーバーヘッドは急速に積み上がります。ARMでのこれらの機能のエミュレーションが異常に遅い理由はここにあります。
とはいえ、今日のARMプラットフォームの1つはこの問題を部分的に解決しています。Oryon-3 CPUコアは「coherent cachelines」として売り込まれている機能を導入しており、その結果はここのマイクロベンチマークで確認できます。x86と同様、アトミックメモリアクセスが64バイトのキャッシュライン内に収まっていれば、性能は自然アラインメント版と一致します。これは大きな進歩であり、このCPUがキャッシュラインをまたごうとするまでは、機能サポートにおいてx86と同等であることを意味します。この機能を実装したQualcommには拍手を送るべきでしょう。x86エミュレーションにおけるsplit-lockの主要なパフォーマンス問題と正確性の問題を解決しています。とはいえ、ハードウェアは依然として64バイトのsplit-lockをサポートしていないため、その場合はFEXのエミュレーションパスにフォールバックすることになります。
Apple の結果に移ろう。x86-TSO のメモリアクセスに対するハードウェアサポートを追加したにもかかわらず、Oryon の場合と同様、キャッシュラインをまたぐ非アラインドアトミック操作はなぜか完全には実装されなかった。このエッジケースを予見して実装していてもおかしくないと思うかもしれないが、それはただの推測にすぎない。ともあれ、TSO のハードウェアスイッチを有効にしても、16 バイト粒度での性能は他のプラットフォームと変わらない。
グラフのもう一つの小さな異常にも気づいたかもしれない。このベンチマークでは Cortex-X4 の結果にアスタリスクが付いており、その非アラインドアトミック操作の性能は、はるかに新しい CPU よりも荒唐無稽なほど速い。どういうわけかレイテンシは約 209ns しかなく、X925 のレイテンシは 1060ns——5 倍の性能向上だ! そんなことがあり得るのか? 実はこれは、我々がテストしたプラットフォームに載っているちょっと面白い「秘密のレシピ」、もちろん Valve Steam Frame のおかげだ。Valve は自社の既存ゲームライブラリの性能を気にかけていたので、とある FEX 開発者がさっと書いたカーネルパッチを配信した。これにより Linux カーネル自体が非アラインドアトミック操作を処理できるようになり、FEX やユーザー空間とやり取りする必要がなくなったため、速度が大幅に向上した。他のプラットフォームもこのパッチをカーネルに取り込みたいなら、そのまま採用することを勧める。FEX が自動的に使い始める。
カーネルの介入と言えば、FEX における split-lock エミュレーションは、ハードウェアの制約により実は完全には正確でないことについて話さなければならない。x86 のこの必須機能を正しく実装するには、16 バイトまたは 64 バイトの split-lock に遭遇するたびに、カーネルが実装するしかない。現在 FEX は「ベストエフォート」で処理しており、場合によってはデータが実際に引き裂かれる。x86 の split-lock は決して引き裂かれないと以前述べたのを覚えているだろうか? 「コヒーレントキャッシュライン」を持つ Oryon-3 でさえ、この問題は今も解決できていない。
split-lock は必須だと、どういう意味だ?
今日の ARM ハードウェアで高性能に split-lock エミュレーションを実装するのは、実は非常に難しい。最も素朴な方法はグローバルミューテックスを使い、split-lock が発生するたびにミューテックスを取得してから操作を実行するというものだ。つまり、関与するすべての split-lock 操作がこのロックを通り抜けることになる。これ自体は正しい。問題は、アラインされたアトミック操作は split-lock ではないため、関与しないことだ。split-lock エミュレーションコードは 2 回の 64 ビット compare-exchange 操作として実装しなければならず、それぞれの半分が粒度境界をまたぐため、関与しないアトミック操作があっても引き裂きが起こり得る。簡単な例:あるスレッドがキャッシュラインの中央にあるアトミック変数をひたすら変更し、別のスレッドがその半分の整数をだけ変更する。一見すると作為的な例に思えるが、まさにその通りに動作するロックフリー連結リストの実装が実在する! アラインされたスレッドがどちらの半分を変更するかによって、split-lock コードの 1 回目か 2 回目の CAS が失敗する。1 回目の CAS が失敗すれば安全で、コードはリトライできる。2 回目の CAS が失敗すれば、データはすでに引き裂かれており、データが壊れないこと、クラッシュしないことを祈る以外にできることはない。これは完全に顧客アプリケーションが使うアルゴリズム次第であり、我々には制御できない。
もう一つの完全に実行不可能な案は、カーネルがメモリを共有するすべてのプロセスとスレッドを追跡し、あるスレッドが split-lock をエミュレートする必要があるとき、そのプロセスとメモリを共有する すべての プロセスをカーネルが一時停止し、この split-lock を単独で完了させてから、世界全体を再開させるというものだ。この案の性能への影響は到底受け入れられない。アプリやゲームは毎秒数千回、それ以上の場合もある split-lock を実行する可能性があり、世界全体を止めることによる性能損失は耐え難く、x86 ネイティブよりもはるかに悪い。
split-lock エミュレーションで正確性を保証するなら、FEX には何らかの形のハードウェアサポートが必要だ。だからといって、今すべてのアトミック操作が x86 のように split-lock をサポートすべきだというわけではない——それも同じく実行不可能だ。幸いなことに、ARM にはまさに我々がやりたいことを実現する拡張がある。ARM には Transactional Memory Extension という拡張があり、これが我々の問題を解決できる。この拡張を使えば、コードはトランザクション領域内でいくつかの操作を実行し、その作業をアトミックにコミットできる。コミットが失敗すれば、そのままリトライすればいい。この拡張の欠点は何か? ARM はすでに公式に非推奨にしており、実際にリリースした者も誰もいない。おそらくこれが最良の結果だ。この拡張の x86 版は問題が続出し、多くのプラットフォームで無効化される原因になったからだ。
そこで、split-lock を正しくエミュレートするには別の仕掛けが要る。FEX の要件と ARM ベンダーの要件の両方を満たせる案として考えたのが、128 ビットの CASP 命令の 2 つの半分を、原子粒度の境界にちょうどまたがせる——下位 64 ビットと上位 64 ビットをそれぞれ境界の両側に置く——というものだ。この形のときだけ、命令はアラインメントエラーを起こさずに CAS を試みる。うまくいく理由は、x86 の非アラインメント原子操作が最大 64 ビットまでなので、操作の 2 つの半分は常にこの 1 命令で丸ごと覆えるからだ。
だが「ハードウェアが split-lock を直接サポートするより何が良いのか」と思うかもしれない。もっともな疑問なので、この操作が実際にどう動くかを慎重に説明しよう。x86 では原子操作は常に成功しなければならず、引き裂かれてはならない。我々のエミュレーションでは、この ARM の CASP 命令を安全に失敗させて、あとで再試行できる。これは CAS の利点のひとつで、操作はどんな理由でも失敗してよく、失敗したらもう一度やればいい。この命令はそのときメモリから読んだデータも同時に返すので、プログラムは最新のメモリ状態を手に入れられる。この違いは大きい。つまり FEX は CAS 操作が必ず成功するまで無限に再試行できる! これは ARM の LL/SC アーキテクチャのおかげで、この方式が成り立つ根本的な理由だ。厄介なのは、ハードウェアがいつかは前方進行を保証する必要がある点だが、それは別の理由ですでにサポートされているので問題ない。CAS 命令で新たに増える失敗ケースは、2 本の cacheline のどちらかが操作の完了前に別のコアに持っていかれた場合だけだ。前方進行の保証に何千サイクルかかるとしても、x86 の挙動とほぼ一致する。
ARM で x86 の split-lock をエミュレートするにはこれが最良の方向だと考えているが、我々はハードウェアアーキテクトではないので、文句を言って誰かが直してくれるのを待つしかない。split-lock の話はここまでにして、次は別の面白い問題を見ていこう。
待って、uncached メモリも動かないと?
この話題に入る前に「uncached」という言葉を整理しておきたい。見る角度によって意味がいくつかあるからだ。本記事では Vulkan の用語を使う。主に関心があるのがゲームだからだ。Vulkan には VK_MEMORY_HOST_CACHED_BIT があり、これはホスト CPU がそのメモリをキャッシュすることを示す。ここで問題にするのはこのフラグが付かない場合、つまり我々が「uncached」と呼んでいるものだ。これがメモリサブシステムにとって何を意味するかは、思っているよりややこしい。特にメモリが GPU 上にあり、PCIe を経由することもある場合、メモリが「uncached」である状態は通常(ただし常にではない!)VKMEMORY_HOST_COHERENT_ フラグを伴う。つまりこのメモリはキャッシュ不可なので、CPU と GPU の間で常に一貫したメモリビューが得られる。
CPU 側から見ると、これは通常メモリのマッピングが最大 3 通りあり得ることを意味する。「cached」メモリを確保すると、そのメモリタイプは通常 Write-back になり、普通のメモリマップト型も同じだ。「uncached」マッピングは Write-Combine か「Strong Uncacheable」になり得る。「Strong Uncacheable」の 実装はユーザー空間アプリからはまず見えないので、今日は無視してよい。すると実際に使えるのは WB (cached)と WC(uncached)の 2 種類だけになる。ゲームは通常、staging buffer に cached メモリを使い、GPU に直接データを渡すときには uncached を使う。
多くのゲームエンジンはこれをコードに織り込んでいて、uncached buffer タイプを提供しないと動かないエンジンもある。背景には UMA システム(APU など)と PCIe GPU の挙動の違いがある。UMA システムは通常、cached かつ coherent で GPU からも見えるメモリ割り当てを提供できる。PCIe GPU はそれを保証できない ので、ゲーム開発者は staging buffer でデータを非同期に GPU へコピーするか、「uncached」メモリを使って PCIe 経由で慎重にデータを GPU へ運ぶかのどちらかを選ぶ。PC ゲームでは PCIe が一般的すぎるため、UMA 専用の コードパスを書かず、一律 uncached 方式にするエンジンもある。
uncached が我々にとって何を意味するかの前置きはこのくらいにして、次は UMA の Snapdragon システム数台で cached メモリがどれだけ速いかを測ったベンチマークを見よう。通常性能のベースラインが得られる。
Steam Frame と Snapdragon X2 Elite のスコアはどちらもかなり良い。予想どおり Oryon-3 プラットフォームは メモリ帯域が広いのでグラフ上でも上まで伸びるが、どちらも毎秒数十 GB に達している。この図は「普通の」write-back メモリがどの程度の水準になるかを示す良いベースラインだ。次は uncached の結果を見て、どれだけ性能が落ちるか確かめよう。
妙なことになっている。この図でもまた対数スケールを使うしかなかった。まずは明らかになった良い知らせから。
未キャッシュのメモリバッファが write-combine 方式なので、ARM プラットフォームでも通常のストア操作がキャッシュのベンチマーク結果に匹敵することがわかる。write-combine メモリは write combine buffers を使い、このバッファが cacheline 分のデータを ごく 短時間だけ保持することで、write-combine が 1 回のバーストで cacheline 単位の書き込みを可能にしているからだ。面白いのは、Zen 4 の WCB はキャッシュの速度に追いつけないように見える点だが、PCIe バス経由と考えるとおそらく大した問題ではない。
ここからが本当にまずい結果だ。説明しやすい方から始めよう。すべてのテストプラットフォームで、write-combine メモリからの読み込み帯域が壊滅的だった。Zen を性能の基準にすると、ARM では通常のロード命令の方がむしろ勝っているが、LRCPC ロードはさらに悪い。何が起きているのか。これは write-combine メモリの仕組みの癖で、キャッシュされないため、ロード命令はセマンティクスを保つために毎回システムメモリまで取りに行かねばならない。そこに LRCPC ロードが加わるとさらに悪化する。だが最悪なのはストア性能で、Zen のストア性能と比べるとほぼ致命的だ。帯域差はなんと 816 倍。Hollow Knight: Silksong や Subnautica 2 のようなゲームは、この性能の崖のせいで 1FPS 未満で動いている。
前述のとおり、PCIe GPU を使う場合、ゲームは GPU にデータを渡すために未キャッシュメモリを使う必要がある。PCIe 外付け GPU を載せたプラットフォームで x86 ゲームをエミュレートすると、勝ち目のない状況に陥り、極端に遅くなる運命にある。ARM が x86 メモリモデルのエミュレーションを改善するために FEAT_LRCPC1/2/3 系の拡張を追加したのを覚えているだろうか。これが未対応のエッジケースにぶつかったときに起きることだ。これらの拡張はすべて、x86-TSO メモリモデルのセマンティクスでメモリロードを処理する新しい命令を追加したが、x86-TSO セマンティクスで write-combine メモリにストアする問題を解決したものは一つもない。ARMv8.0-a 以降、ストア命令はバッキングメモリの種類にかかわらず通常の store-release 命令を使う。FEX がこれを解決する唯一の方法は、問題が起きたときに TSO エミュレーションを選択的に無効化することだけで、だから PCIe GPU を載せた x86 エミュレーションプラットフォームの体験は永遠に UMA に劣る。少なくとも、これを解決する別の FEAT_LRCPC4 か同種の拡張が出るまでは。
UMA システムを使っている人たちは喜んでいい。性能を引き上げるために使っている一連のゲーム向けワークアラウンドは、彼らにもそのまま効く。あるプラットフォームが CPU と GPU のキャッシュコヒーレントな組み合わせをサポートするとわかっていれば、グラフィックスドライバに 常に キャッシュ済みバッファを使わせることができ、この問題を完全に回避できる。NVIDIA は自社の Tegra プラットフォームで既にそうしているし、Snapdragon は少なくとも Adreno 600 クラスの GPU 以来ずっと対応している。多くの Mali プラットフォームも同様だ。FEX の実行中、プラットフォームが対応していれば未キャッシュメモリに絶対に触れないようにする Adreno Turnip パッチがある。面白いことに、Asahi のユーザーはハードウェアに TSO ビットが備わっているため現実にはこの問題に遭遇しないが、そのプラットフォームで PCIe グラフィックスカードを使うとなると全く別の話になる。もう一つ面白い癖として、ARM プラットフォームの Radeon は write-combine メモリをすべて隠して write-back に変えてしまう。これについてはまた今度。
より明るい未来へ
このマラソン記事を読み終えた今、x86-TSO メモリモデルのエミュレーションがもたらす課題のいくつかについて、より深く理解してもらえたはずだ。ARMv8.0 を最低スペックとして出発し、その後のハードウェアの進歩は驚くべきものだった。すべてのエッジケースがアーキテクチャレベルで解決されたわけではないが、エコシステム全体に最悪のケースを改善しようという意志は確かにある。各社がそれぞれ問題の一部を解決し、互換性を前進させている。おそらく 10 年後、今を振り返って当時の問題に笑いながら、ARM ハードウェアには決して移植されない良質な x86 ゲームを楽しんでいることだろう。どこで遊ぶことになっても、PC ゲームエコシステムの遺産は受け継がれていく。
2026 年 9 月 17 日執筆