x86 模拟的祸害
在 ARM 的弱定序内存模型上模拟 x86-TSO,是模拟器里长期存在的坑。模拟器要自己补回全存储定序才算正确,代价是大量内存屏障,性能与正确性难以两全,文章梳理了问题根源与几种做法的取舍。
中文
复制
x86 模拟之痛
欢迎阅读本站第一篇专题文章。我们要讨论的是 x86 模拟中一个长期存在的问题,它影响我们模拟的每一个应用。归根结底,这一切都源于一个影响深远的概念:模拟 x86 全存储定序内存模型(x86-TSO)。
在 ARM 定义的弱定序内存模型上模拟这套内存模型,问题不止一个方面,牵扯到许多细节。本文会逐一梳理我们能遇到的所有问题,以及我们解决它们的方式(有些情况下则解决不了)。备好零食和热饮,这篇文章会很长。
- x86-TSO 到底是什么?
- ARMv8.0-a 的朴素起点
- 访问内存不是最简单的一环吗?
- 等等,这些原子指令是什么?
- 什么叫 split-lock 是强制的?
- 慢着,非缓存内存也得能用?
- 展望更光明的未来
x86-TSO 到底是什么?
在深入讨论我们如何绕过 x86 内存模型的问题之前,先得说清楚它究竟是什么。内存模型是一套规则,规定系统中各次内存访问之间如何相互影响。这些规则决定了单线程和多线程环境下加载与存储如何交互。硬件中实现的内存模型有好几种,各有各的形态,但今天我们关心的只有两个:ARM 的宽松(弱)一致性模型,以及 x86 这一版的全存储定序一致性模型。这两个模型基本处在光谱的两端:ARM 最宽松,允许大量硬件优化;x86 最严格,强制一套非常强的一致性,几乎不留优化空间。讨论内存模型时有一点要小心,就是一致性与原子性之间的区别。二者相关,但并不等同,也不能在所有情况下都画等号。
要解释内存模型的差异如何体现,最好的切入点是从 x86 的做法讲起。TSO 在运作方式上极为严格,程序员可以假定:一次内存存储发生时,系统中所有其他处理器都能一致地看到它。这还意味着,当一次内存加载发生时,它之前的所有存储“在逻辑上”都已完成,至少已经可见。这符合程序员的预期——你写入内存,它在写入的那一刻就变得可见,因为这样思考最符合直觉。存储实际上决定了加载可见性的顺序,这个模型的名字也由此而来。具体运作上还有些细微之处,但并非理解它的必要条件。
ARM 的弱内存模型在运作方式上就没那么直观了。默认情况下,ARM 使用的普通内存加载和存储在你的系统中并不严格保证跨处理器一致,这让 CPU 在大多数时候能更高效地运行。当一条存储指令执行时,那块内存(cacheline)不会立即对系统中的其他处理器可见。这样做节省了宝贵的功耗、提升了效率,因为在硬件层面,让其他核心的 cacheline 失效,或者允许它们窥探另一个处理器的缓存,代价都很高。与此相关的是,如果一个处理器正在从内存加载另一个处理器写入的数据,这次加载甚至不保证能看到更新后的内存。听起来这会在多线程应用里造成严重问题,对吧?旧版本的 ARM(ARMv7 及更早)使用内存屏障指令来保证顺序,而这带来了显著的性能开销。
为了绕开这一一致性限制,ARM 还引入了 load-acquire 和 store-release 内存指令。用 C++ 的说法,它们分别对应 std::atomic 的 memory_order_acquire 和 memory_order_release 定义。按 ARM 的术语,这些指令 严格来说 也不算原子操作,但程序员往往把两者混为一谈。FEX 就一直用 atomic-load 和 atomic-store 这两个词来表达同样的意思!这一区分 通常 无关紧要,但在讨论这些话题时,较真一点可能更好。
这些指令的主要用途是在这一类指令之间强制内存顺序。ARM 将其称为“Release Consistency sequentially consistent(RCsc)”模型。不必深入这个模型如何运作的细节,基本要点是:load-acquire 指令必须按顺序被观察到,不得重排,store-release 指令同样如此,同时满足“barrier-ordered-before”语义。这就省去了旧版 ARM 架构中那条代价高昂的内存屏障指令。
ARMv8.0-a 的卑微起点
在模拟 x86-TSO 内存模型时,ARMv8.0-a 就是我们起步的前提。我们把所有 x86 内存加载变成 ARM 的 load-acquire 指令,把 x86 内存存储变成 store-release 指令。这样 FEX 就获得了与 x86 实质上相同的内存语义,尽管我们实际上比必要的更严格。原因是我们没有恰好匹配其行为的中间选项。可想而知,用这些指令模拟 TSO 的代价极其高昂,我们有微基准测试可以证明这一点。ARM CPU 在设计时并没有考虑让这些相对少见的 acquire/release 指令突然变成执行的绝大多数指令。
先从简单的开始,用一个对硬件相当友好的微基准测试。没有棘手的边界情况,只是访问常见情形下的内存。这给了我们一些基线数字,代表最佳情况应该是什么样。
我们来拆解这张图,它讲出了几个有意思的故事。每台机器的 Load 和 Store 列代表我们的硬件应当努力达到的基线性能数字。这些并不是要压满每个系统的内存带宽,而是对每种操作做相同量的工作。把注意力转向 acquire-load 的结果,可以看到在测试的五颗 CPU 中,有三颗的性能因使用 acquire-load 而受到相当大的拖累!此外还能看到,AmpereOne CPU 的 release-store 指令相比其他结果低得惊人,而 M1 的 Acquire/LRCPC 加载指令也明显低于基线。
AmpereOne 上的结果尤其能说明这条遗留路径能糟糕到什么程度。这些指令从来就不是为这种用法设计的。在 x86 模拟中,对每一次 load 都使用 acquire-release 语义,实际上给 ARM CPU 加上了非常严格的限制:load 指令之间完全不能再重排序。所以当每秒有数百万条这样的指令在途时,性能本来就不该指望有多好。但在 ARMv8.0-a 下我们只有这些指令可用,也只能用它们。Cortex-X4 和 Cortex-X925 跑这些指令的性能非常出色,而 Oryon-3 显然把它们的优先级排得很低。
接下来往哪走?
仔细看看 LRCPC-load 指令,从 ARMv8.3 起它就是必需的。这个扩展给 ARM ISA 加了一批新的 load 指令,并在 ARM 此前的 RCsc 模型之上引入了新的内存模型。这个新的 “Release Consistency processor consistent(RCpc)” 内存模型正是我们一直想要的。该扩展就是围绕 x86 模拟的需求设计的,在实现了它的硬件上预计会被大量使用。从图中可以看到,几乎所有平台上 LRCPC-load 的性能都与普通 load 相当。
有了这个被新版 ARM 强制要求的新扩展,内存性能问题基本算是解决了。至少在这个微基准测试里是这样。FEX 一旦检测到这个扩展,就会完全停用 Acquire-Load 指令,改用 LRCPC-Load。那 Apple M1 那个结果又是怎么回事……?
这里就得称赞 Apple 解决这个问题的思路了。在 Apple Silicon 处理器上,他们直接加入了对 x86-TSO 内存模型的支持。开启这个 CPU 特性后,他们普通的 ARM load/store 指令会改变行为,以匹配 x86 的要求。他们选择这条路,是因为清楚在全面转向 ARM 生态后,自家硬件需要一个高性能的解决方案。所以在他们的硬件上,LRCPC-load 指令实际上只是 acquire-load 指令的别名,因为他们的 x86 模拟器根本不用这些指令。既然实现了 x86 内存模型,他们直接用普通 load/store 指令就行,这在我们的微基准结果里表现为无法分辨的性能开销。平心而论,这种线程级 TSO 模式切换确实会带来一些性能影响,只是在这里看不出来。当 FEX 从 Asahi Linux 检测到这个 CPU 特性时,我们也会启用它,白拿这份性能提升。一个潜在的顾虑是,在 x86 模拟代码和 ARM 代码之间跳转时,ARM 代码会因为所有访问都变成 TSO 而付出不必要的开销。这个顾虑合理,但在模拟下执行的 ARM 原生代码量趋近于 0%。作为开发者,你不在乎 1% 的内存访问变慢 10%,你在乎的是 99% 的访问变成“理想”性能的 15%(正如 AmpereOne 的结果所示)。
需要说明的是,我们认为 TSO 模式是确保在该平台上实现高性能 x86 模拟的最佳路径,因为它能保证每一条内存访问指令的行为都符合我们的预期。官方 FEAT_LRCPC 扩展实际上有三个版本,每一次都是在给实现打补丁,这本身就说明了问题。
- FEAT_LRCPC —— 为 GPR 增加基本的 TSO load 指令
- FEAT_LRCPC2 —— 为 TSO load 指令增加小偏移立即数
- FEAT_LRCPC3 —— 增加基本的向量和基于栈的 TSO load & store 指令
即便有了这三个扩展,仍存在一些边缘情况,无法像拥有 TSO 硬件开关那样被优雅地模拟。我们预计随着时间推移还会出现更多扩展版本,试图修复我们将在后文讨论的一些遗留问题。
我以为访问内存是最简单的部分?
上一节里我们对 ARM 硬件相当客气,顺着底层硬件的对齐要求来,以便得到一个性能基线。但模拟 x86 时,我们一上来就迎面撞上一个刺眼的问题。你最爱的 x86 应用根本不在乎对齐!它们想怎么访问内存就怎么访问,跨越 cacheline 边界,执行未对齐的原子操作。你能想到的对齐问题,这些游戏全都在做。这个问题严重到我们专门给它起了个名字,叫 split-locks。它的影响之大,连 Linux 内核都会捕获这类操作并在发生时拖慢游戏!导致许多玩家去折腾内核选项来规避这种性能下降!
不过我们还不打算讨论完整的 split-locks,先从不在乎对齐的环境下的 load-store 指令说起。x86 对程序员做出了某些保证:如果你执行一次 load-store,且它位于同一个 cacheline 内,那么这次 load-store 既是原子的,也仍然符合前面描述的一致性模型。然而,为了对硬件开发者稍微友好一点,如果这次 load-store 确实 跨越了 cacheline,数据就不再是原子的,其他线程可以而且确实会看到撕裂。所以程序员必须小心,因为普通的 load-store 并不是 split-lock。
用 load-acquire/store-release 来模拟这些基本访问,问题在于 ARMv8.0 要求所谓的自然对齐。 也就是说,无论访问的数据是多大,内存在地址中的偏移都必须与大小匹配。8 字节访问就必须落在偏移 0、 8、16、24 等位置上。这对原生 ARM 应用来说没问题,但如果不满足自然对齐要求会怎样?在 ARM 上,这意味着 该指令会触发对齐错误。 硬件会校验对齐要求是否满足,不满足则 CPU 触发异常。这通常会导致崩溃,但 FEX 做了特殊处理。
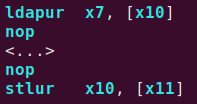
在 FEX 的 JIT 机制中,我们会跟踪那些用于模拟 x86 load-store 的内存 load-store 指令。当我们知道某条 load-store 可能引发对齐错误时,代码中就会出现所谓的patchpoint。对于 load-store 指令,它表现为该指令之前或之后的一条 NOP。当这些 patchpoint 之一发生对齐错误时,FEX 会捕获该异常,把代码从 load-acquire/store-release 指令修补为基本的等价 load-store,并用一条数据内存屏障 把该指令包起来。然后继续执行!
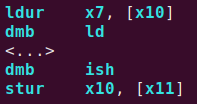
修补前与修补后
前面那一大段关于 ARMv8.0-a 如何新增这些花哨的 load-acquire、store-release 指令的讨论呢?一旦对齐行为不匹配,我们 立刻退回到经典的内存屏障指令。之前的图表没有展示这种糟糕情况,所以我们 引入一些新数据。
哦,要梳理的数据可真不少。虽然再次看到硬件在模拟 TSO 时距离“最优”路径有多远是件好事,但这并不是我们这里关心的。 有意思的是,这个微基准并没有显示出对齐与未对齐在普通 load/store 上有多少差异,所以我们只是 取了两者的平均值。 我们会从 ARM 列中移除 x86 CPU 和普通 load-store 数据,因为这些不是 FEX 的常见路径。这样我们就能更 有针对性地看到未对齐内存访问在模拟下造成的伤害有多严重。
现在数据图合理多了,我们从左到右逐个看一遍,说说到底发生了什么。
AmpereOne
这个挺有意思,对齐和不对齐的加载指令表现大致相当,差异在噪声范围内。也就是说,尽管不对齐加载会吃到数据内存屏障的惩罚,CPU 还是扛住了。考虑到它的性能相比其他平台低了不少,也有可能这个基准测试本身就被别的东西卡住了瓶颈。
存储这边就不太乐观了,即使不对齐也一样。图上几乎都看不见它!碰到不对齐存储时性能损失大约 8.5%,但因为起点本来就低,很难注意到。这和普通存储指令在这个测试里能跑到约 28GB/s 形成了鲜明对比。
这里唯一能得出的结论是,Ampere 是在为某种服务器级负载做优化,并不太符合消费级硬件的行为。这是个有意思的数据点,但我们的用户一般不会在这类硬件上跑游戏。
Cortex-X4
这是一颗非常流行的 CPU 核心,搭载在 Qualcomm Snapdragon 8 Gen 3 里。我们只测了这颗 SoC 中的这一个核心,免得图表被数据淹没。大量掌机都用它,所以是个有意思的测试对象。考虑到它是这份名单里唯一的手机 SoC,它的表现其实出乎意料地好。总体来看,这颗核心大致符合我们的预期,图表上的趋势也和图中下一代 Cortex 一致。
这颗 CPU 的主要情况是:对齐加载和存储都还算给力,分别能跑到约 11.5GB/s 和 6.7GB/s。有意思的是它在处理不对齐 load/store 时的性能下滑——撞上 DMB 指令后,在这个基准测试里加载和存储受到的惩罚大致相当,都在 50% 左右。
这似乎意味着 CPU 能让相当数量的 LRCPC-release loadstore 保持在飞行中,因此 DMB 指令在遇到时影响更大,但还不至于造成灾难性的性能损失。只是说,因对齐问题导致的 50% 性能下降算不上什么好结果。
Cortex-X925
接着 X4,我们来看看 DGX Spark 及其 X925 核心。这不仅是一颗更新的 ARM CPU 核心,它所在的系统内存带宽也高得多。平台为 273GB/s,此前是 76.8GB/s。这意味着即便结果与 X4 相当接近,图表也只是整体抬高了一点。有意思的是,非对齐访问的性能损失也大致与 X4 相同。不过 store 似乎恢复得稍快一些,可能是更快的内存帮了忙。这里没有什么意外,几代之间性能表现始终一致。
Oryon-3
这是 Qualcomm 刚刚出炉的 CPU 核心设计。Linux 支持仍在推进中,但已经展现出强劲的实力。最有趣的结果其实来自对齐的 LRCPC-load 指令,它们的性能已经与普通 load 持平!这意味着对于行为良好的应用,通常可以期待满血性能。release-store 指令同样相当能打,只是带宽仅为普通 store 的 68%。这表现一点也不差。
这颗 CPU 同样逃不过非对齐 LRCPC-release loadstore 的惩罚。load 一侧大致与 Cortex-X925 约 70% 的性能损失相当,可能是因为 Snapdragon X2 Elite 的带宽也很充裕。但 store 一侧反而更差一些,性能约为 43%。即便有这些非对齐访问带来的性能损失,这个平台实际上仍快于 Cortex 系列的对齐访问。
这个平台有一点很奇怪:它宣传拥有“Fully coherent 96KB 6-way L1 cache with 64B coherency granules”。按我们的理解,这意味着非对齐访问的性能影响应该小得多。有意思……先记住这一点。
Apple M1
这是我们必须重点讨论的一个。它是真正的转折点,是那个“Apple 时刻”。它向所有人证明,ARM 不仅可行,而且可以更快。这张图上的数字非常惊人,而这是 Apple 把 TSO 内存模型直接做进硬件的成果。这一款没有使用 LRCPC-release 访问,我们只是启用了它们的 TSO 特性,对齐版本基本追平了非对齐版本。store 上大概有 5% 的性能损失?和图上其他任何设备相比,这实际上等于没有。根本原因在于,非对齐访问不再需要把 DMB 指令回填进代码,硬件直接处理了。
对我们来说,这就是在 ARM 上认真做 x86 模拟的意义所在,也确实说明 Apple 在乎用户运行原生和模拟软件时的体验。他们看到了问题,然后直接把它“解决”了,让它消失。 话虽如此,TSO 模式开启时,性能确实会下降。和上一张图相比,store 性能只有常规水平的 76%,load 性能基本持平;当一切都快得多的时候,这点代价就让人好受多了。
非对齐 LRCPC/release 访问小结
本节收尾,我们要谈一个所有这些厂商都实际支持的性能改进。这是 ARM 搞出来的一个扩展,叫 FEAT_LSE2,所有测试平台都实现了它。我们之前说过,acquire/LRCPC/release 内存访问需要自然对齐,否则会触发 CPU 的对齐异常。ARM 确实考虑到了这个问题,实现了这个扩展,它对 x86 模拟(可能还有其他工作负载)有帮助。这个扩展不仅放宽了 acquire/LRCPC/release load/store 指令的对齐要求,还放宽了 read-modify-write 原子操作的对齐要求!
这话听着不错,但问题来了:这意味着它只能给 x86 模拟带来边际性能提升。这个扩展只是放宽了对齐要求,允许在 16 字节粒度内进行非对齐内存访问。任何跨越该 16 字节粒度的访问仍然会触发对齐异常。x86 应用根本不在乎内存访问是否对齐,所以我们会遇到跨越整个缓存行的非对齐访问。在 x86 上,只有 read-modify-write 原子操作才会尝试避免跨越缓存行!
所以感谢这次尝试,看着挺不错,但实际没什么用。既然已经聊到这儿了,那就来看看这些 RMW 原子操作吧?
糟糕,这些原子指令是什么?
和大多数现代指令集一样,x86 支持原子内存操作。这类指令对内存中的数据原子地执行 ALU 运算,不允许任何中间状态对外可见。用 x86 的话说,这是对既原子又一贯的内存进行操作,而 ARM 允许你选择只保证原子性,或者同时保证原子性和一贯性。我们之前简单提过,对数据原子地操作和该数据的一贯性之间其实是有区别的。这有什么区别?
在前面关于 x86 内存模型的讨论中,我们一直在谈 load 和 store 对其他处理器可见所涉及的一贯性问题。我们完全忽略的是这些内存访问的原子性要求。在 x86 的世界里,load 或 store 通常是原子完成的,即使是非对齐的。这意味着如果你存储 8 字节数据,而另一个线程在竞态条件下加载这 8 字节,它绝不会突然看到存储前和存储后数据的混合。在 ARM 上,这些原子性保证明显更弱,也就是说如果你执行一条非对齐 store 指令,ISA 规范对读到数据撕裂不做任何保证。好在对于自然对齐的 load-store 指令,ARM 有一项叫 “single-copy atomicity” 的规范,保证这些访问不会出现撕裂。还有个好消息;之前提到的 FEAT_LSE2 扩展?它实际上把 single-copy atomicity 保证扩展到了 16 字节粒度内的任何非对齐访问!坏消息是 x86 的 single-copy atomicity 保证覆盖整个缓存行,所以这个扩展依然没有彻底解决问题,只是减少了出现的次数。
关于原子性和一致性的差异,已经说得够多了。真正的原子指令在哪里?它们又能做什么?从 ARMv8.1-a 开始,我们的 ISA 新增了一批指令,其行为基本与 x86 的原子指令一一对应。这里直接给出完整列表,看看它们在我们的 JIT 中是如何逐一对应的。
| x86 | ARMv8.1-a |
|---|---|
| LOCK DEC | ldaddal |
| LOCK INC | ldaddal |
| LOCK NEG | ??? |
| LOCK NOT | ldeoral |
| LOCK ADC | ldaddal |
| LOCK ADD | ldaddal |
| LOCK AND | ldclral |
| LOCK OR | ldsetal |
| LOCK SBB | ldaddal |
| LOCK SUB | ldaddal |
| LOCK XADD | ldaddal |
| LOCK XOR | ldeoral |
| LOCK BTC | ldclralb |
| LOCK BTR | ldeoralb |
| LOCK BTS | ldsetalb |
| XCHG | swpal |
| LOCK CMPXCHG | casal |
| CMPXCHG8B | caspal |
| CMPXCHG16B | caspal |
瞧,19 个原子 RMW 操作全在这儿了,而且基本上都能直接对应到某条 ARM 指令。那个可疑的可以忽略,它在真实负载里用不到,深究下去也只会越扯越远。两个架构之间是相当清晰的 1:1 映射,大功告成,对吧?x86 模拟的有趣之处就在这儿:有了这些指令,不代表就能顺顺当当地接上去。我们前面花了那么多篇幅讲非对齐访问会严重拖累普通 load 和 store 的性能,同样的问题也适用于 RMW 原子操作!
这张图里,我们看的是单条原子指令,其内存地址落在某个 cacheline 内的某个位置。如果把 19 个原子操作的数据全画出来,这张图会比现在更加让人吃不消。这些原子操作的表现大致相当,画全了既冗余,也与这里要讨论的内容无关。另外,这是本文第一张真正使用对数刻度的图,所以看图时务必清楚:从最快到最慢的结果,性能差距大约在 1000 倍这个量级。
先从图里的 x86 Zen 处理器看起。这些结果正是我们的模拟应该追求的样子。可以看到,只要访问完全落在同一条 cacheline 内,指令延迟就一律是 1.44ns。
It’s worth calling out a Chips and Cheese article published while we were preparing this piece. They dig deep into why split-lock is so dramatically slow, and it’s worth a read if you don’t understand how it works. In particular, x86 split-lock still maintains x86-TSO’s atomicity and coherence guarantees—even across cachelines, it never tears data. That’s a bit absurd, and we’ll explain further later.
再看我们的 ARM 处理器,从自然对齐的延迟数据开始。如你所见,我们所有平台的表现都还不错——只要访问自然对齐,延迟就在同一个量级。
我们前面一直在提 split-lock 这个问题,FEX 到底是怎么模拟它们的,又为什么这么慢?我还记得第一次看到这些数字时的意外。
不过今天已经有一颗 ARM 平台部分解决了这个问题。Oryon-3 核心引入了他们宣传为「coherent」的某种机制。
接着看 Apple 的结果。尽管他们为 x86-TSO 内存访问加了硬件支持,但出于某种原因并没有实现——
你可能还注意到图里另一个数据上的小异常。在这项基准测试中,Cortex-X4 的结果上标了个星号,而且它的非对齐原子操作性能比新得多的 CPU 快得离谱。它不知怎么做到延迟只有约 209ns,而 X925 的延迟是 1060ns——性能提升了 5 倍!这怎么可能?其实这是我们测试的平台上搭载的一点有趣的“特殊配方”,当然就是 Valve Steam Frame。因为 Valve 在意自家现有游戏库的性能,他们推送了一个由某位 FEX 开发者随手写出的内核补丁。这让 Linux 内核本身就能处理非对齐原子操作,不必再和 FEX 及用户空间来回折腾,速度因此大幅提升。如果其他平台也想在内核里带上这个补丁,我们建议直接采纳,FEX 会自动开始使用它。
说到内核介入,我们得谈谈 split-lock 模拟在 FEX 下其实并不完全正确,原因在于硬件的限制。要正确实现 x86 的这一强制特性,每当遇到 16 字节或 64 字节的 split-lock,唯一的办法就是由内核来实现。目前 FEX 是以“尽力而为”的方式处理的,某些情况下数据真的会被撕裂。你还记得我们之前说过 x86 上的 split-lock 永远不会撕裂吧?即便是拥有“一致性缓存行”的 Oryon-3,至今也没能解决这个问题。
split-lock 是强制的,你这话什么意思?
用今天的 ARM 硬件以高性能的方式实现 split-lock 模拟,其实非常困难。最朴素的做法是用一个全局互斥锁,每当发生 split-lock 就先获取互斥锁再执行操作。这意味着所有参与的 split-lock 操作都会挤过这把锁。这本身是正确的,问题在于任何对齐的原子操作都不是 split-lock,也就不会参与进来。由于 split-lock 模拟代码必须实现为两次 64 位 compare-exchange 操作,每一半都跨越粒度边界,所以即便有未参与的原子操作,仍然可能出现撕裂。一个简单的例子:一个线程不断修改缓存行中间的某个原子变量,另一个线程则只修改其中一半上的整数。乍一听这像是刻意构造的例子,但确实存在行为完全如此的无锁链表实现!取决于对齐线程修改的是哪一半,split-lock 代码中的第一次或第二次 CAS 会失败。如果第一次 CAS 失败,那是安全的,代码可以重试;如果第二次 CAS 失败,就意味着数据已经撕裂,我们除了祈祷它别损坏数据、别崩溃之外无能为力。这完全取决于客户应用使用的算法,我们控制不了。
另一种完全不可行的方案,是让内核跟踪所有共享内存的进程和线程,然后当某个线程需要模拟 split-lock 时,内核暂停与该进程共享内存的 每一个 进程,单独完成这次 split-lock,再让整个世界重新启动。这个方案的性能影响根本不可接受。应用和游戏每秒可能执行数千次甚至更多 split-lock,暂停整个世界带来的性能损失难以承受,甚至比 x86 原生还要糟糕得多。
如果要在 split-lock 的模拟上保证正确性,FEX 就需要某种形式的硬件支持。这并不是说现在所有原子操作都应该像 x86 那样支持 split-lock——那同样不可行。好消息是,ARM 实际上有一个扩展正好能做我们想做的事。ARM 有一个名为 Transactional Memory Extension 的扩展,可以解决我们的问题。这个扩展允许我们的代码在一个事务区域内执行若干操作,然后以原子方式提交这些工作;如果提交失败,我们直接重试即可。这个扩展的缺点是什么?ARM 已经正式弃用了它,而且从来没有人真正发布过它。这大概是最好的结果,因为该扩展的 x86 版本问题层出不穷,导致它在许多平台上被禁用。
所以我们需要别的东西来正确模拟 split-lock。为了找到一个我们认为既能满足 FEX 需求、也能满足 ARM 厂商需求的方案,我们提出了这样一个想法:让一条 128 位的 CASP 指令能够把 CASP 的两半精确地跨在原子粒度边界上,低半部分 64 位,高半部分 64 位。只有在这种情况下,该指令才不触发对齐错误,并尝试执行 CAS 操作。这之所以可行,是因为 x86 的非对齐原子操作最多只有 64 位,所以操作的两半总能被我们的单条指令完整覆盖。
但你可能会问:“这比硬件直接支持 split-lock 好在哪里?”这个想法不错,我们得小心描述这个操作到底是怎么做的。对 x86 来说,它的原子操作必须始终成功,不能撕裂。而在我们模拟的方案里,可以让这条 ARM CASP 指令安全地失败,然后再重试。这正是 CAS 的好处之一:操作可以因为任何原因失败,失败了就再试一次。这条指令还会同时返回它当时从内存里读到的数据,这样程序拿到的就是最新的内存状态。这个区别很重要,因为这意味着 FEX 可以无限次重试 CAS 操作,直到它必然成功!这是 ARM LL/SC 架构带来的好处,基本上让这套方案能跑起来。麻烦的一点是,硬件确实需要在某个时刻保证向前推进,但它出于其他原因本来就已经支持这一点,所以完全可行!CAS 指令唯一新增的失败情形,纯粹是两条 cacheline 中的某一条在完整操作完成之前被另一个核心拿走了。即便硬件仍然需要最多几千个周期来保证向前推进,这也基本和 x86 的行为一致。
我们认为这是在 ARM 平台上模拟 x86 split-lock 的最佳前进方向,但我们不是硬件架构师,能做的只有抱怨,然后指望有人替我们解决。split-lock 的讨论先到这里,接下来看另一个有意思的问题。
等等,uncached 内存也得能用?
进入这个话题之前,得先说说“uncached”这个词,因为站在不同角度看,它可以有好几种含义。本文使用 Vulkan 的术语,因为我们主要关心游戏。在 Vulkan 里,有 _VK_MEMORY_HOST_CACHEDBIT,表示主机 CPU 会缓存这块内存。我们这里关心的是没有这个标志位的情况,也就是我们所说的“uncached”。至于这对内存子系统意味着什么,就比你想的要复杂一些了。尤其是当内存位于 GPU 上、可能还要经过 PCIe 的时候,内存处于“uncached”状态通常(但并非总是!)还会带上 VK_MEMORY_HOST_COHERENT 标志。也就是说,由于这块内存不可缓存,CPU 和 GPU 之间始终拥有一致的内存视图。
对 CPU 来说,这通常意味着内存最多可以有三种映射方式。申请“cached”内存时,其内存类型通常是 Write-back,普通的内存映射类型也是如此。“uncached”映射 则可以是 Write-Combine 或“Strong Uncacheable”。“Strong Uncacheable” 的实现对用户态应用来说基本不存在,所以今天可以先忽略。这样一来,实际可用的就只有 WB (cached)和 WC(uncached)两种内存类型。游戏通常用 cached 内存做 staging buffer,而直接把数据传给 GPU 时用的则是 uncached。
很多游戏引擎把这一点写进了代码:如果不提供对 uncached buffer 类型的支持,有些引擎就跑不起来。这背后是 UMA 系统(比如 APU)与 PCIe GPU 之间的行为差异。UMA 系统通常能提供既是 cached、又保持一致(coherent)、同时 GPU 可见的内存分配。PCIe GPU 无法保证这一点, 所以游戏开发者要么用 staging buffer 把数据异步拷贝到 GPU,要么用“uncached”内存,小心翼翼地 通过 PCIe 把数据搬到 GPU。由于 PCIe 在 PC 游戏领域太普遍,有些引擎干脆不写 UMA 专用的代码路径, 一律走 uncached 方案。
关于 uncached 对我们的意义,这点铺垫就到这里。接下来看一个基准测试,测的是几台 UMA Snapdragon 系统上 cached 内存有多快。这样我们就能拿到一个常规性能的基线。
Steam Frame 和 Snapdragon X2 Elite 的成绩都相当不错。不出所料,Oryon-3 平台的内存 带宽更大,所以在图表上能冲到更高,但两者的成绩都达到了每秒几十 GB。这张图给出了“正常”的 write-back 内存能达到什么水平的一个好基线。下面来看 uncached 的结果,看看性能差多少。
这里出现了一些奇怪的情况,我们不得不在这张图上再次使用对数坐标。先说说已经显现出来的好消息。 由于未缓存的内存缓冲区采用 write-combine 机制,我们可以看到 ARM 平台上的普通存储操作与缓存基准测试结果相当。这是因为 write-combine 内存使用了所谓的 write combine buffers,这些缓冲区会 非常 短暂地保留一个 cacheline 的数据,以便 write-combine 能够一次突发写入一个 cacheline 的内存。有趣的是,Zen 4 的 WCB 似乎跟不上缓存的速度,但考虑到这预计是通过 PCIe 总线进行的,可能问题不大。
现在来看看真正糟糕的结果。先从比较容易解释的说起:在所有测试平台上,从 write-combine 内存读取的带宽都惨不忍睹。如果以 Zen 作为性能基线,那么 ARM 上的普通加载指令反而胜出,但 LRCPC 加载更差。这是怎么回事?这是 write-combine 内存运作方式的一个怪癖——由于它不被缓存,我们的加载指令每次访问都必须前往系统内存以维持语义。再加上 LRCPC 加载,问题就更加严重了。但最糟糕的是存储性能,与 Zen 的存储性能相比,这基本上是个致命问题。带宽差距高达 816 倍!像 Hollow Knight: Silksong 和 Subnautica 2 这样的游戏因为这一性能悬崖而运行在不到 1FPS。
正如我们上面所说,当涉及 PCIe GPU 时,游戏需要使用未缓存内存来向 GPU 传递数据。在配备独立 PCIe GPU 的平台上模拟 x86 游戏时,我们处于一个无法取胜的境地,注定会运行得极其缓慢。还记得 ARM 之前添加了 FEAT_LRCPC1/2/3 系列扩展来改进 x86 内存模型模拟吗?这就是遇到不支持的边缘情况时会发生的事情。所有这些扩展都添加了新指令,以 x86-TSO 内存模型语义处理内存加载,但没有一个能解决以 x86-TSO 语义存储到 write-combine 内存的问题。从 ARMv8.0-a 开始,我们的存储指令无论后备内存类型如何都使用普通的 store-release 指令。FEX 解决这个问题的唯一方法是当问题出现时有选择地禁用 TSO 模拟,因此配备 PCIe GPU 的 x86 模拟平台体验永远不如 UMA。至少在我们获得另一个 FEAT_LRCPC4 或类似的扩展来解决这个问题之前是这样。
对于使用 UMA 系统的用户来说,欢呼吧:我们用来提升性能的一套游戏变通方案同样适用于你们。既然我们知道某个平台支持 CPU 与 GPU 的缓存一致性组合,就可以让显卡驱动 始终 使用带缓存的缓冲区,从而彻底避开这个问题。NVIDIA 在自家 Tegra 平台上已经这么做了,Snapdragon 至少从 Adreno 600 级别的 GPU 起就一直支持,还有许多 Mali 平台也是如此。我们有一个 Adreno Turnip 补丁,确保在 FEX 运行时,只要平台支持,我们就绝不会碰到非缓存内存。有意思的是,Asahi 用户因为硬件自带 TSO 位,在现实中根本不会遇到这个问题,但要在那个平台上用上 PCIe 显卡就完全是另一回事了。还有个有趣的怪癖:ARM 平台上的 Radeon 显卡会把所有 write-combine 内存藏起来,改成 write-back,这个我们下次再聊。
展望更光明的未来
读完这篇马拉松式的文章,希望你对模拟 x86-TSO 内存模型带来的一些挑战有了更好的理解。我们从 ARMv8.0 作为最低规格起步,而这些年硬件带来的巨大进步简直令人惊叹。虽然并非所有边缘情况都在架构层面得到解决,但整个生态似乎确实有心去改善最糟糕的那些情况。各家厂商分别解决了问题的一部分,推动兼容性向前迈进。也许再过十年,当我们回望现在,会一边为当时遇到的问题发笑,一边享受着那些永远不会移植到 ARM 硬件上的优质 x86 游戏。无论我们最终在哪里玩游戏,PC 游戏生态的传承都会延续下去。
写于 2026 年 9 月 17 日