同じリンカで2つのベンチマークが正反対の結論:Wild作者が項目ごとに分解して自分で確認
Moldが最近リンカベンチマークを更新し、初めてWildを対象に含めた。このベンチマークではWildはMoldよりかなり遅く、8月4日の前回リリース時にWildが最新で公表したベンチマーク結果とは逆である。
日本語
コピー
David Lattimore - 2026-09-18
Mold がリンカーのベンチマークを更新し、今回初めて Wild がその対象に加わった。このベンチマークでは Wild が Mold よりかなり遅いという結果が出ている。8 月 4 日の前回リリース時に Wild が公開したベンチマークとは逆の結果だ。本記事では、なぜこの 2 つのベンチマークでこれほど差が出るのかを突き止めようと思う。
Mold のベンチマークは 2 台のマシンで実行されている。
- 64 コア(128 スレッド)の Threadripper、Ubuntu 24.04
- Apple M1 Ultra(高性能コア 16 個)、Asahi Linux
Wild の最近のベンチマークは 1 台のマシンで実行した。
- 16 コア(32 スレッド)の Ryzen 9955hx、Ubuntu 26.04
ベンチマーク設定の大きな違いのひとつは出力ファイルに関するものだ。こちらのベンチマークでは、出力ファイルは前回リンカーを実行したときのものが残ったままになっている。Mold のベンチマークは、リンカーを呼び出すたびに出力ファイルを削除する。これはリンカーの性能に大きく影響し、その度合いはファイルシステムにも強く依存する。Wild のベンチマークはこれまで tmpfs 上で実行してきた。ベンチマークのノイズを減らし、SSD の消耗も避けるためだ。今思えばこれはおそらく間違いだった。ほとんどのユーザーは tmpfs 上でビルドしたりしない。Mold のベンチマークは ext4 を使っており、こちらのほうが妥当だ。今後は両方の方式を使うかもしれない。
もうひとつの違いは、Mold のベンチマークが --no-fork を渡している点だ。これはデフォルトの動作を上書きする。デフォルトでは起動時に fork して終了コストを下げる。Wild のベンチマークは計測時にはこの設定をデフォルトのままにし、メモリ消費量を測るときだけ --no-fork を渡している。
以下では、16 コアの Apple M1 上で Mold のベンチマークに近い結果を再現してみる。Mold のベンチマークと同様、両リンカーとも 2026-08-28 時点の release ビルドを使う。結果をできるだけ近づけるため、出力ファイルは ext4 上に置き、実行のたびに削除し、--no-fork を渡す。
まず、これから実行するベンチマークに対応する部分を Mold の結果から抜き出す。
| プログラム | Wild(秒) | Mold(秒) | Wild/Mold |
|---|---|---|---|
| blender-debug | 1.81 | 1.56 | 1.2x |
| godot-debug | 0.81 | 0.62 | 1.3x |
| blender-release | 0.20 | 0.25 | 0.8x |
| clang-release | 0.15 | 0.14 | 1.0x |
こちらで計測した結果は次のとおり。
| ベンチマーク | Wild(秒) | Mold(秒) | Wild/Mold |
|---|---|---|---|
| blender-debug | 2.23 | 1.79 | 1.2x |
| godot-debug | 1.11 | 0.89 | 1.2x |
| blender-release | 0.30 | 0.33 | 0.9x |
| clang-release | 0.21 | 0.20 | 1.0x |
両方の Wild/Mold 比を 1 つの表にまとめる。
| プログラム | Mold のベンチマーク | 今回のベンチマーク |
|---|---|---|
| blender-debug | 1.2x | 1.2x |
| godot-debug | 1.3x | 1.2x |
| blender-release | 0.8x | 0.9x |
| clang-release | 1.0x | 1.0x |
CPU アーキテクチャが違い、キャッシュサイズもメモリも条件が異なることを考えれば、かなり近い結果と言える。
おおよそ似た結果が再現できたので、さらに掘り下げてみよう。なぜこのベンチマークは、Wild が 1 か月足らず前に公開した結果とこれほど違うのか。
clang-release に絞って見ていく。Wild が公開したベンチマークにもこの項目があるからだ。Mold のベンチマークが使う設定(ext4+delete+no-fork)から、Wild がこれまで使ってきた設定(tmpfs+no-delete+fork)まで、いくつかの構成を試した。
| ベンチマーク | Wild(秒) | Mold(秒) | Wild/Mold |
|---|---|---|---|
| clang-release.ext4-delete-no-fork | 0.21 | 0.20 | 1.0x |
| clang-release.ext4-no-delete-no-fork | 0.14 | 0.20 | 0.7x |
| clang-release.tmpfs-delete-no-fork | 0.16 | 0.20 | 0.8x |
| clang-release.tmpfs-no-delete-no-fork | 0.14 | 0.19 | 0.7x |
| clang-release.tmpfs-no-delete-fork | 0.11 | 0.19 | 0.6x |
本文の残りの部分はすべて tmpfs+no-delete+fork 構成で測定している。
Wild(少なくともここで試したバージョン)が最も良い結果を出すのは、fork が許可され、出力ファイルが既に存在して tmpfs 上にある場合、つまり Mold のベンチマークが使った構成とは正反対の条件だ。ただしこれは主に、Wild が OS 向けの最適化を欠いているためである。その最適化こそが、非 tmpfs のファイルシステム上で新規ファイルを作成して書き込む処理を高速にしている。Mold の作者は論文 mold: A Massively Parallel Linker でこの手法を説明しており、具体的には fallocate でファイルに領域を事前確保し、そのファイルを大ページでマップする。どちらも Wild には実装済みで、次のリリースに含まれる。
とはいえ、8 月 4 日公開の Wild のベンチマークと、8 月 28 日公開の Mold のベンチマークの間には、依然としてかなり明確な性能差がある。原因を突き止めるため、Mold と Wild が過去 1 年あまりに公開したすべてのバージョンをベンチマークした。ここでも対象は clang-release である。Wild 0.6.0 は引数ファイルと通常のコマンドライン引数の併用に対応していないため、自前でビルドした clang release を使った。また、空の sframe に遭遇したときの失敗を避けるため、mold には --discard-section=.sframe を渡した。この問題は修正済みだが、修正を含まない mold のバージョンでベンチマークを回したかった。したがってこれは、上の clang-release と似ているが別の、独立したベンチマーク群と見なすべきである。
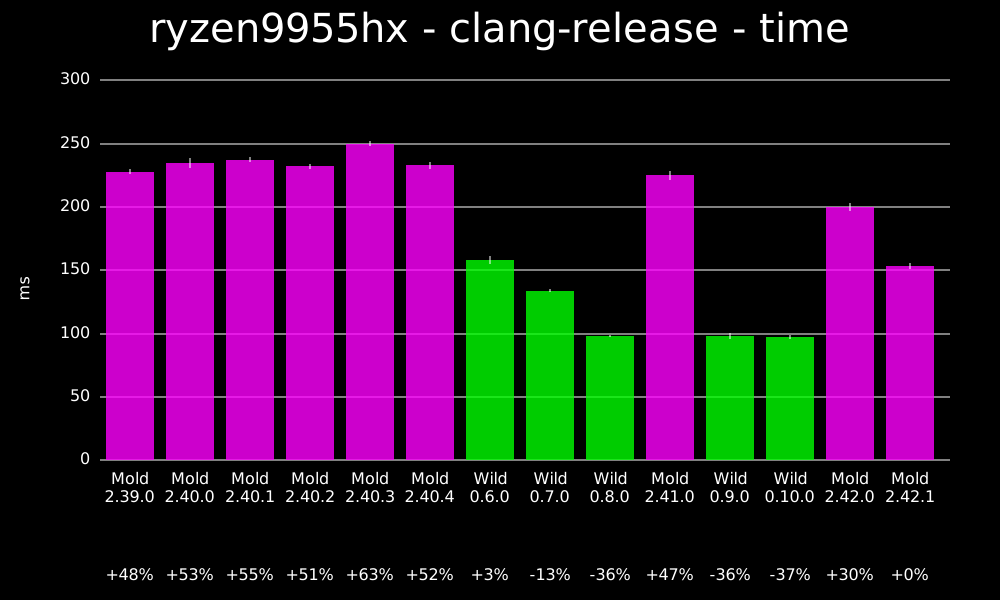
これを見ると、Mold が最近大きく高速化していることがわかる。Wild の 8 月 4 日のベンチマークは Mold 2.42.0 と 2.42.1 のリリース前に行われたもので、主要な性能向上はまさにこの 2 つのバージョンで起きている。
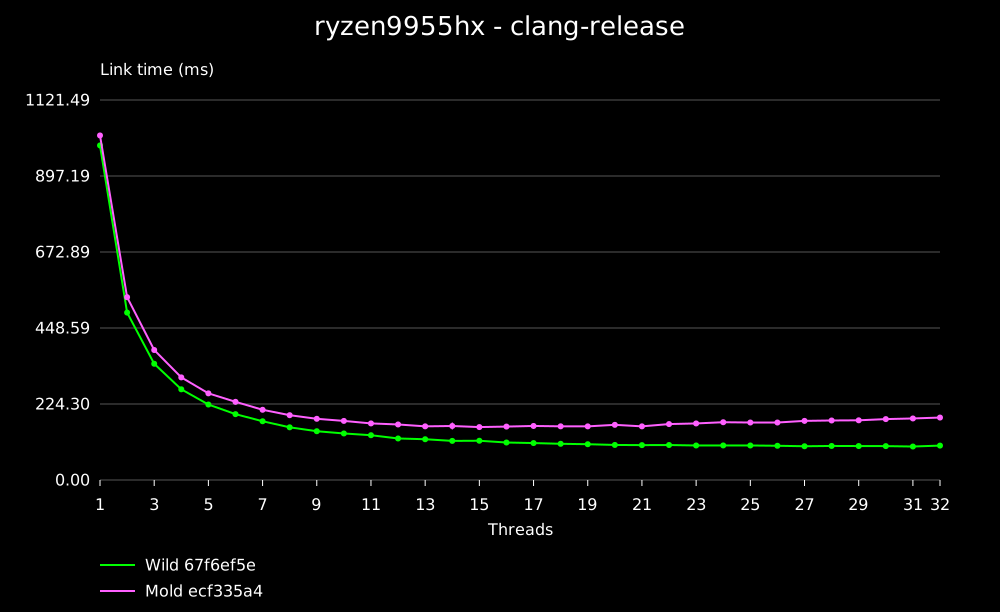
本記事の冒頭では、Mold が M1 Mac で得たベンチマークに近い結果をおおむね再現できた。しかし Threadripper 上の結果は再現できなかった。私の手元に那样的硬件はない。この 16 コアの Ryzen 9955hx に 92GiB のメモリという構成は、低スペックなマシンではないが、64 コア・384GiB メモリの Threadripper ではない。上で述べた差異に加えて、ここでの差が特に大きいのは、Wild が 128 スレッドで動作するのに対し Mold は 32 スレッドしか使わないためではないかと推測している。私の 16 コア(32 スレッド)のマシンでは、Wild は 24 スレッドから 32 スレッドに増やしてもまだ速くなり続けていた(幅度は小さいが、下の図を参照)。そのためスレッド数の上限は設けていない。ただ、これはあくまで推測にすぎない。Threadripper を持っていて、さまざまなスレッド数で Wild をベンチマークしてみようという人がいれば、ぜひ知らせてほしい。