同一个链接器,两份基准测出相反结论:Wild 作者逐项拆给自己看
Mold 最近更新了他们的链接器基准测试,并首次将 Wild 纳入其中。这些基准测试显示,Wild 比 Mold 慢了不少,这与我们 8 月 4 日上次发布时 Wild 最新公布的基准测试结果相反。
中文
复制
David Lattimore - 2026-09-18
Mold 最近更新了他们的链接器基准测试,并首次将 Wild 纳入其中。这些基准测试显示,Wild 比 Mold 慢了不少,这与我们 8 月 4 日上次发布时 Wild 最新公布的基准测试结果相反。本文试图弄清为什么两次基准测试的结果会有如此大的差异。
Mold 的基准测试在两台机器上运行:
- 一台 64 核(128 线程)的 Threadripper,运行 Ubuntu 24.04
- 一台 Apple M1 Ultra(16 个性能核),运行 Asahi Linux
Wild 最近的基准测试在一台机器上运行:
- 一台 16 核(32 线程)的 Ryzen 9955hx,运行 Ubuntu 26.04
基准测试配置的一个重大差异与输出文件有关。我们的基准测试运行时,输出文件是上一次链接器运行后留下的。Mold 的基准测试则会在每次调用链接器之间删除输出文件。这对链接器的性能影响很大,具体影响还高度依赖文件系统。Wild 的基准测试历来在 tmpfs 上运行,这样做是为了减少基准测试中的噪声,也避免损耗 SSD。现在回头看,这很可能是个错误,因为大多数用户不太可能在 tmpfs 上构建。Mold 的基准测试使用 ext4,这是更合理的选择。今后我可能会两种方式都用。
另一个差异是,Mold 的基准测试传入了 --no-fork,覆盖了默认行为——默认会在启动时 fork,以降低关闭成本。Wild 的基准测试在计时时保持该设置为默认值,只在测量内存消耗时才传入 --no-fork。
下面我们尝试在 16 核 Apple M1 上复现与 Mold 基准测试相近的结果。与 Mold 的基准测试一样,我们用的是两个链接器截至 2026-08-28 的 release 构建。为了让结果尽可能接近,我们把输出文件放在 ext4 上,每次运行之间删除该文件,并传入 --no-fork。
首先是我们即将运行的那几项基准测试在 Mold 结果中的对应部分:
| 程序 | Wild(秒) | Mold(秒) | Wild/Mold |
|---|---|---|---|
| blender-debug | 1.81 | 1.56 | 1.2x |
| godot-debug | 0.81 | 0.62 | 1.3x |
| blender-release | 0.20 | 0.25 | 0.8x |
| clang-release | 0.15 | 0.14 | 1.0x |
以下是我们测得的结果:
| 基准测试 | Wild(秒) | Mold(秒) | Wild/Mold |
|---|---|---|---|
| blender-debug | 2.23 | 1.79 | 1.2x |
| godot-debug | 1.11 | 0.89 | 1.2x |
| blender-release | 0.30 | 0.33 | 0.9x |
| clang-release | 0.21 | 0.20 | 1.0x |
把两组 Wild/Mold 比值放进同一张表:
| 程序 | Mold 基准测试 | 本次基准测试 |
|---|---|---|
| blender-debug | 1.2x | 1.2x |
| godot-debug | 1.3x | 1.2x |
| blender-release | 0.8x | 0.9x |
| clang-release | 1.0x | 1.0x |
考虑到我们运行在不同的 CPU 架构上,缓存大小、内存等条件都不一样,这样的结果已经算是相当接近了。
既然我们复现出了大致相似的结果,就可以再往下挖一挖:为什么基准测试的结果与 Wild 不到一个月前公布的相差这么大。
我们把重点放在 clang-release 上,因为 Wild 公布的基准测试集里就有这一项。我们尝试了几种不同的配置,从 Mold 基准测试所用的配置(ext4+delete+no-fork)开始,到 Wild 历来使用的配置(tmpfs+no-delete+fork)为止。
| 基准测试 | Wild(秒) | Mold(秒) | Wild/Mold |
|---|---|---|---|
| clang-release.ext4-delete-no-fork | 0.21 | 0.20 | 1.0x |
| clang-release.ext4-no-delete-no-fork | 0.14 | 0.20 | 0.7x |
| clang-release.tmpfs-delete-no-fork | 0.16 | 0.20 | 0.8x |
| clang-release.tmpfs-no-delete-no-fork | 0.14 | 0.19 | 0.7x |
| clang-release.tmpfs-no-delete-fork | 0.11 | 0.19 | 0.6x |
本文余下部分都采用 tmpfs+no-delete+fork 配置。
Wild(至少是这里测试的版本)在允许 fork、且输出文件已存在并位于 tmpfs 上时表现最好,也就是说,与 Mold 基准测试所用的配置恰好相反。但这主要是因为 Wild 缺少那些针对操作系统的优化——正是这些优化让在非 tmpfs 文件系统上创建并写入新文件变得很快。Mold 的作者在论文 mold: A Massively Parallel Linker 中描述了这些做法,具体是用 fallocate 为文件预分配空间,并用大页映射该文件。这两处改动已经在 Wild 上完成,将包含在下一个版本中。
不过,Wild 在 8 月 4 日发布的基准测试与 Mold 在 8 月 28 日发布的基准测试之间,仍存在相当明显的性能差距。为了弄清其中的原因,我对 Mold 和 Wild 过去一年多里发布的每个版本都做了基准测试。这次同样以 clang-release 为测试对象。由于 Wild 0.6.0 不支持将参数文件与普通命令行参数混用,我使用了自行构建的 clang release 版本。另外,为了绕开遇到空 sframe 时的失败,我给 mold 传了 --discard-section=.sframe。这个问题已经修复,但我想用尚未包含该修复的 mold 版本跑一遍基准测试。因此,这实际上应视为与上面的 clang-release 类似但独立的另一组基准测试。
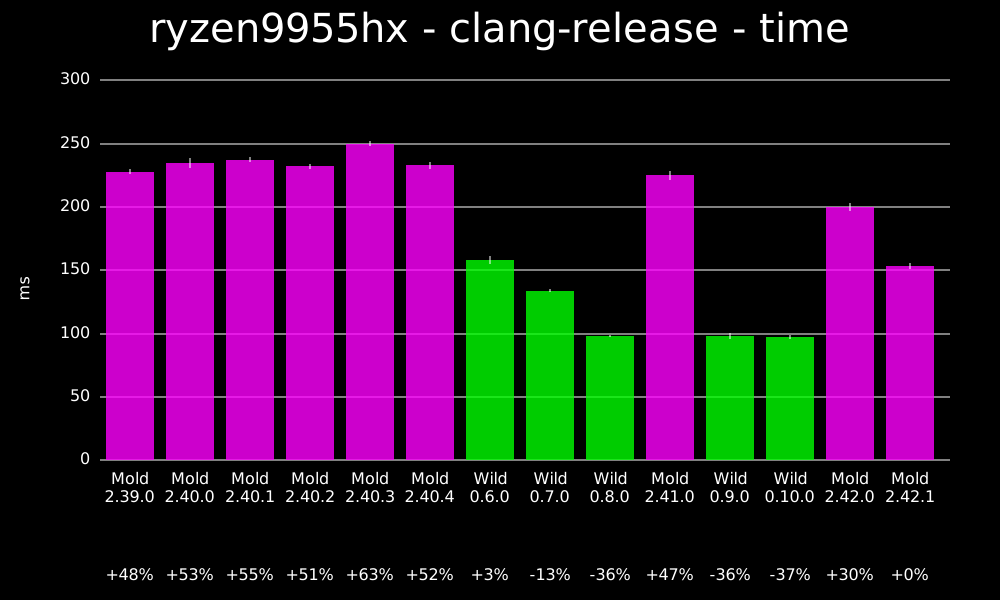
由此可以看出,Mold 最近提速明显。Wild 8 月 4 日的基准测试是在 Mold 2.42.0 和 2.42.1 发布之前做的,而主要的性能提升正出现在这两个版本中。
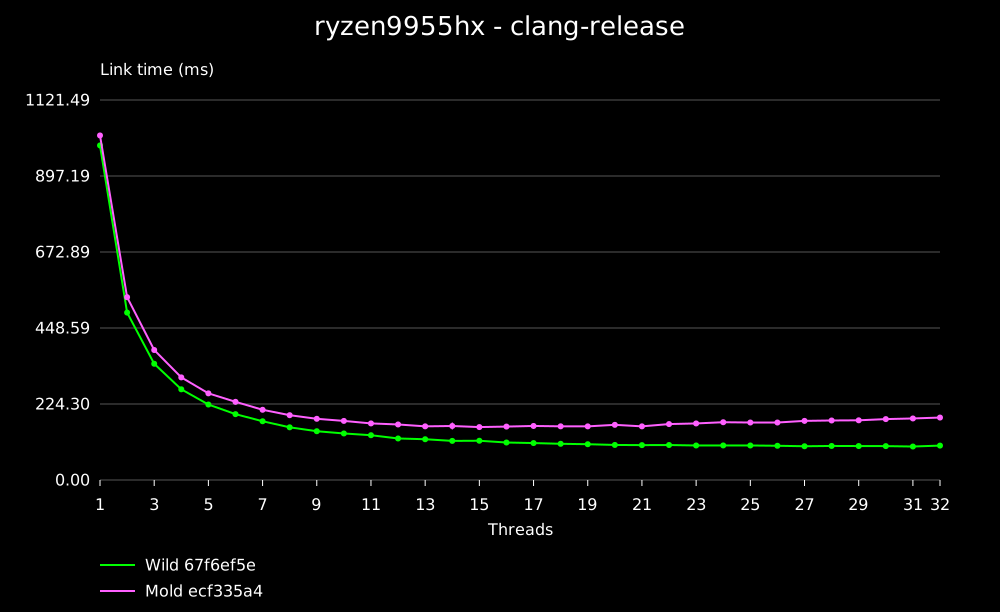
本文开头,我们基本复现了与 Mold 在 M1 Mac 上得到的基准测试相近的结果。但 Threadripper 上的结果我们没能复现——我没有那样的硬件。我这台 16 核 Ryzen 9955hx 配 92GiB 内存,算不上低端机器,但毕竟不是 64 核、384GiB 内存的 Threadripper。我猜测,除了上面讨论过的差异之外,这里差距格外大,可能是因为 Wild 以 128 线程运行,而 Mold 只用 32 线程。在我这台 16 核(32 线程)机器上,Wild 从 24 线程增加到 32 线程时仍在变快(尽管幅度很小,见下图)。因此我没有设置任何线程数上限。但这终究只是猜测。如果有人有 Threadripper,愿意用不同线程数对 Wild 做基准测试,欢迎告诉我。