あなたの Pod はドレインされていない:実測して確かめた
drainwatch が25回の実測でKubernetesのグレースフルシャットダウンを分解、即座に終了するPodは45ミリ秒以内にRSTでTCPを切断されるが、Serviceは死んだプロセスを221ミリ秒間外部に通知し続ける。
日本語
コピー
Kubernetes のグレースフルシャットダウンに関するガイドは、どれも同じ話をしている。Pod が SIGTERM を受け取る。エンドポイントがローテーションから外れる。トラフィックが届かなくなる。ハンドラが処理中の作業を終えてから終了する。筋は通っている。本当にそうなのかを知りたかった。もっともらしいかどうかではなく、実測とタイムスタンプがあるかどうかだ。
そこで drainwatch を作った。Pod に対して TCP と UDP の長接続を張り、さまざまな方法でその Pod を終了させ、各接続が実際に何によって、いつ終わったのかを記録する小さな Go ツールだ。証拠は Kubernetes の watch イベントとパケットそのものから取る。
試行は 25 回。5 種類の終了シナリオをそれぞれ 5 回繰り返し、バイナリは固定、シナリオごとに新しい kind クラスタを用意した。Kubernetes v1.34.0、kube-proxy は iptables モード。以下の結論はすべて、リポジトリにコミットされた report.json まで遡れる。
発見 1:SIGTERM を受け取って何をするかが TCP の運命を決める
同じクラスタ。同じトリガー、つまり Pod の削除。同じ 30 秒の猶予期間。唯一の変数は、アプリが SIGTERM を受け取った後に何をするか。
| SIGTERM の挙動 | TCP の結果(5 回の繰り返しすべてで一致) | 最後の TCP 接続が終わった時刻 | コンテナの終了コード |
|---|---|---|---|
| 即座に終了 | 10/10 が RST で切断 | 45 ms(30–98) | 0 |
| ドレインしてから終了 | 10/10 がクリーンにクローズ | 25.04 s(25.03–25.11) | 0 |
| SIGTERM を無視 | 10/10 が転送の途中で切断 | 30.06 s(30.05–30.06) | 137 |
数値は 5 回の繰り返しの中央値、括弧内は範囲。
即座に終了するアプリは、自分が保持しているすべての接続を 45 ミリ秒で殺す。ドレインするアプリは 10 本すべての接続を 25 秒のウィンドウの終わりまで生かし、それからクリーンに閉じる。SIGTERM を無視するアプリは、kubelet が動き出すまで接続を保持し続ける。SIGKILL は 30 秒の猶予の境界から 62 ミリ秒後に届く。5 回の繰り返しすべてで終了コードは 137。決して終了しないアプリは、自分の接続がいつ死ぬかを決められない。決めるのは kubelet だ。
ここまでのところ、ドキュメントと矛盾はしていない。次の 2 つの発見が、ドキュメントが語っていない部分だ。
発見 2:あなたの Service は、外に対して死んだ Pod を告知している
「即座に終了」のシナリオで、2 つのイベントの間隔を測った。最後の TCP 接続が切断された時刻と、エンドポイントが EndpointSlice から削除された時刻だ。
| 指標(n=5) | 中央値 | 最悪のケース |
|---|---|---|
| 最後の TCP 接続が死んだ時刻 | 45 ms | 98 ms |
| エンドポイントが削除された時刻 | 293 ms | 591 ms |
| Service が死んだプロセスを告知しているウィンドウ | 221 ms | 521 ms |
中央値で 221 ミリ秒、最悪のケースでは 0.5 秒を超える。EndpointSlice にはエンドポイントが載ったままで、そのプロセスはとっくに自分が保持していたすべての接続をリセットしている。この告知に従ってルーティングされたリクエストは、どこにも着地できない。
これはまさに、コネクションドレインの推奨がカバーしようとしていたレースだ。今、それに数字がついた。2 つのタイムスタンプは同じクロックから取っているので、このウィンドウは正確だ。ウィンドウは繰り返しごとに個別に計算し、その中央値を取っている。したがって上の表の 2 つの中央値の差にはならない。
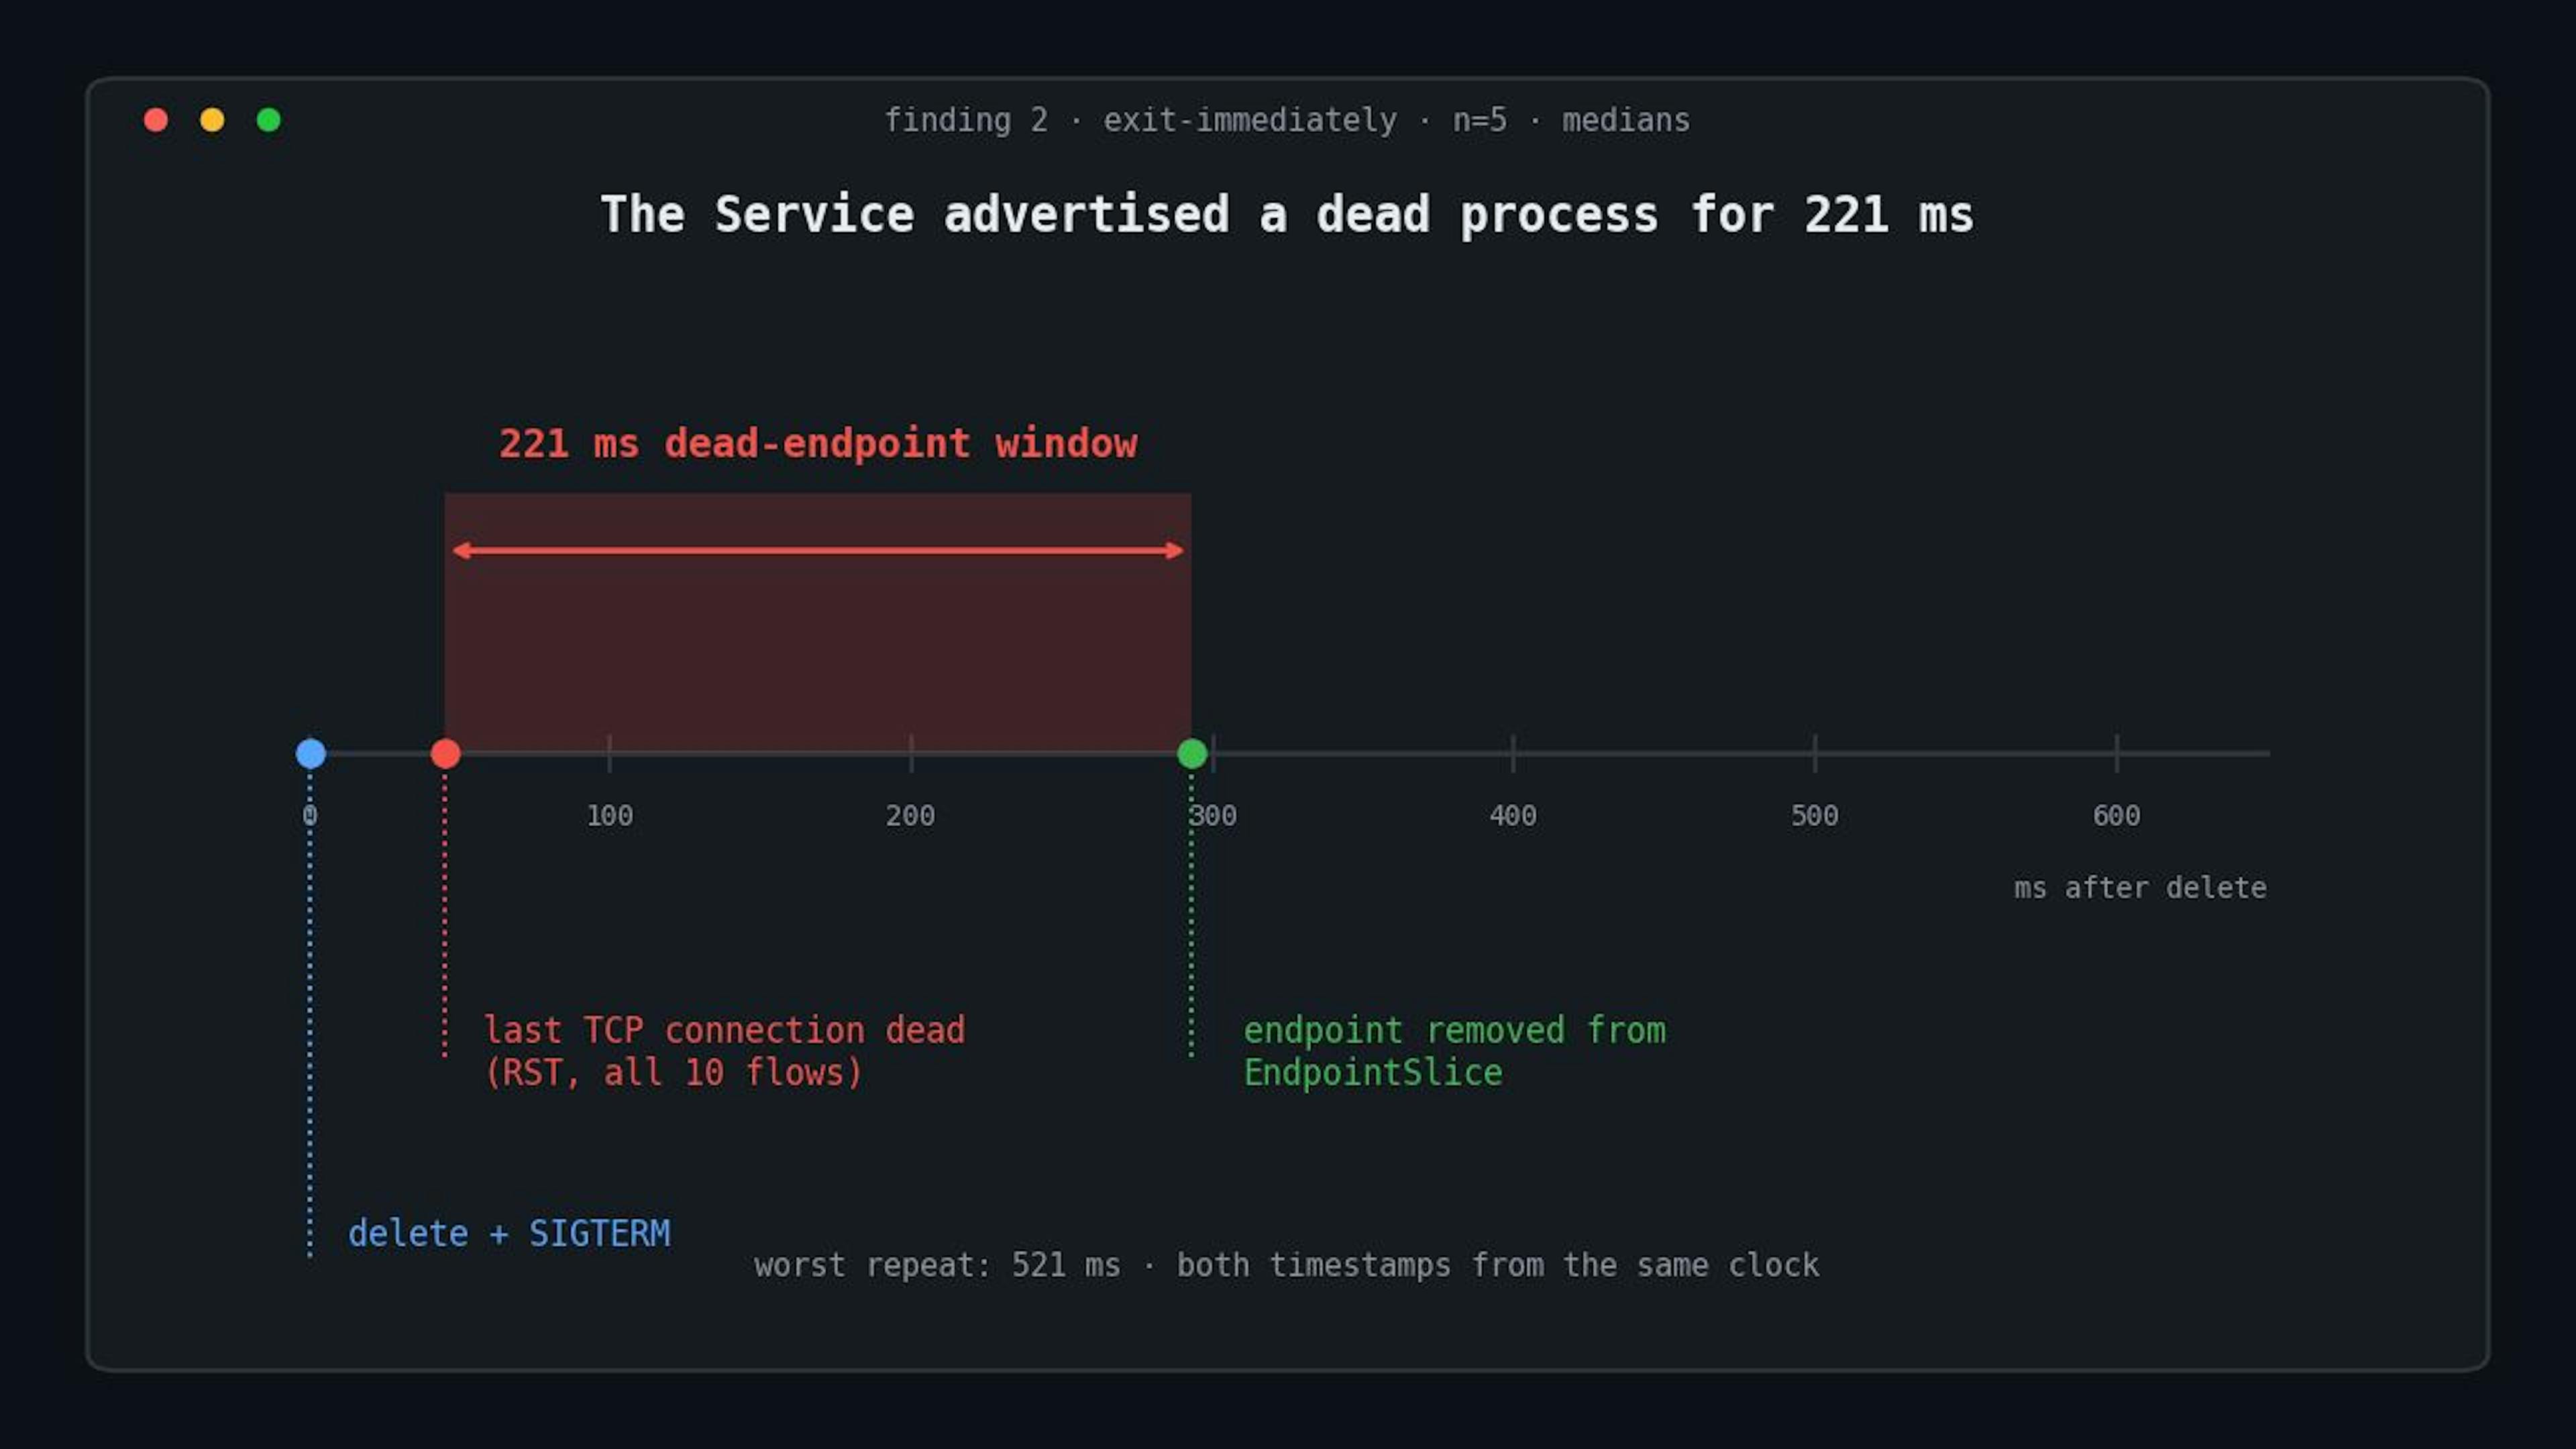
「即座に終了」シナリオにおける死んだエンドポイントのウィンドウ
同じデータからもう 1 つ言えることがある。一般には、エンドポイントの削除は SIGTERM より前に起こり、使える余裕が残ると想定されている。このクラスタでは、2 つのイベントは同時に起こっており、差は測定精度の範囲内だった。毎回の試行で、どのシナリオでもそうだった。
発見 3:UDP にドレインという概念はない
この発見には驚いた。自分はリアルタイムメディアのシステムを作っているのだが。
ドレインのシナリオは教科書どおりのグレースフルシャットダウンを実行している。新規接続の受け付けを止め、確立済みの接続は提供し続け、終わったら終了する。TCP はその 25 秒を手に入れた。UDP ストリームは同じ Pod 上に、同じ Service を経由して保たれていた。それなのに、delete の 2.4 秒後に消えた。死んだのではない。別の Pod が応答するようになったのだ。
Deployment が管理する Pod を削除すると、ReplicaSet が代替を作る。UDP はコネクションレスだ。代替の準備が整うと、kube-proxy はデータグラムをそちらへ流す。元の Pod はまだ動いていて、まだ健全で、まだ TCP を提供しており、ドレインのウィンドウは中央値でまだ 22.9 秒残っている。アプリは完璧なドレインを実行したが、UDP に関しては何も得られなかった。
トラフィックが移ったことがわかるのは、プローブが各応答に自分の Pod 名を付けているからだ。この仕組みの原理は後で説明する。
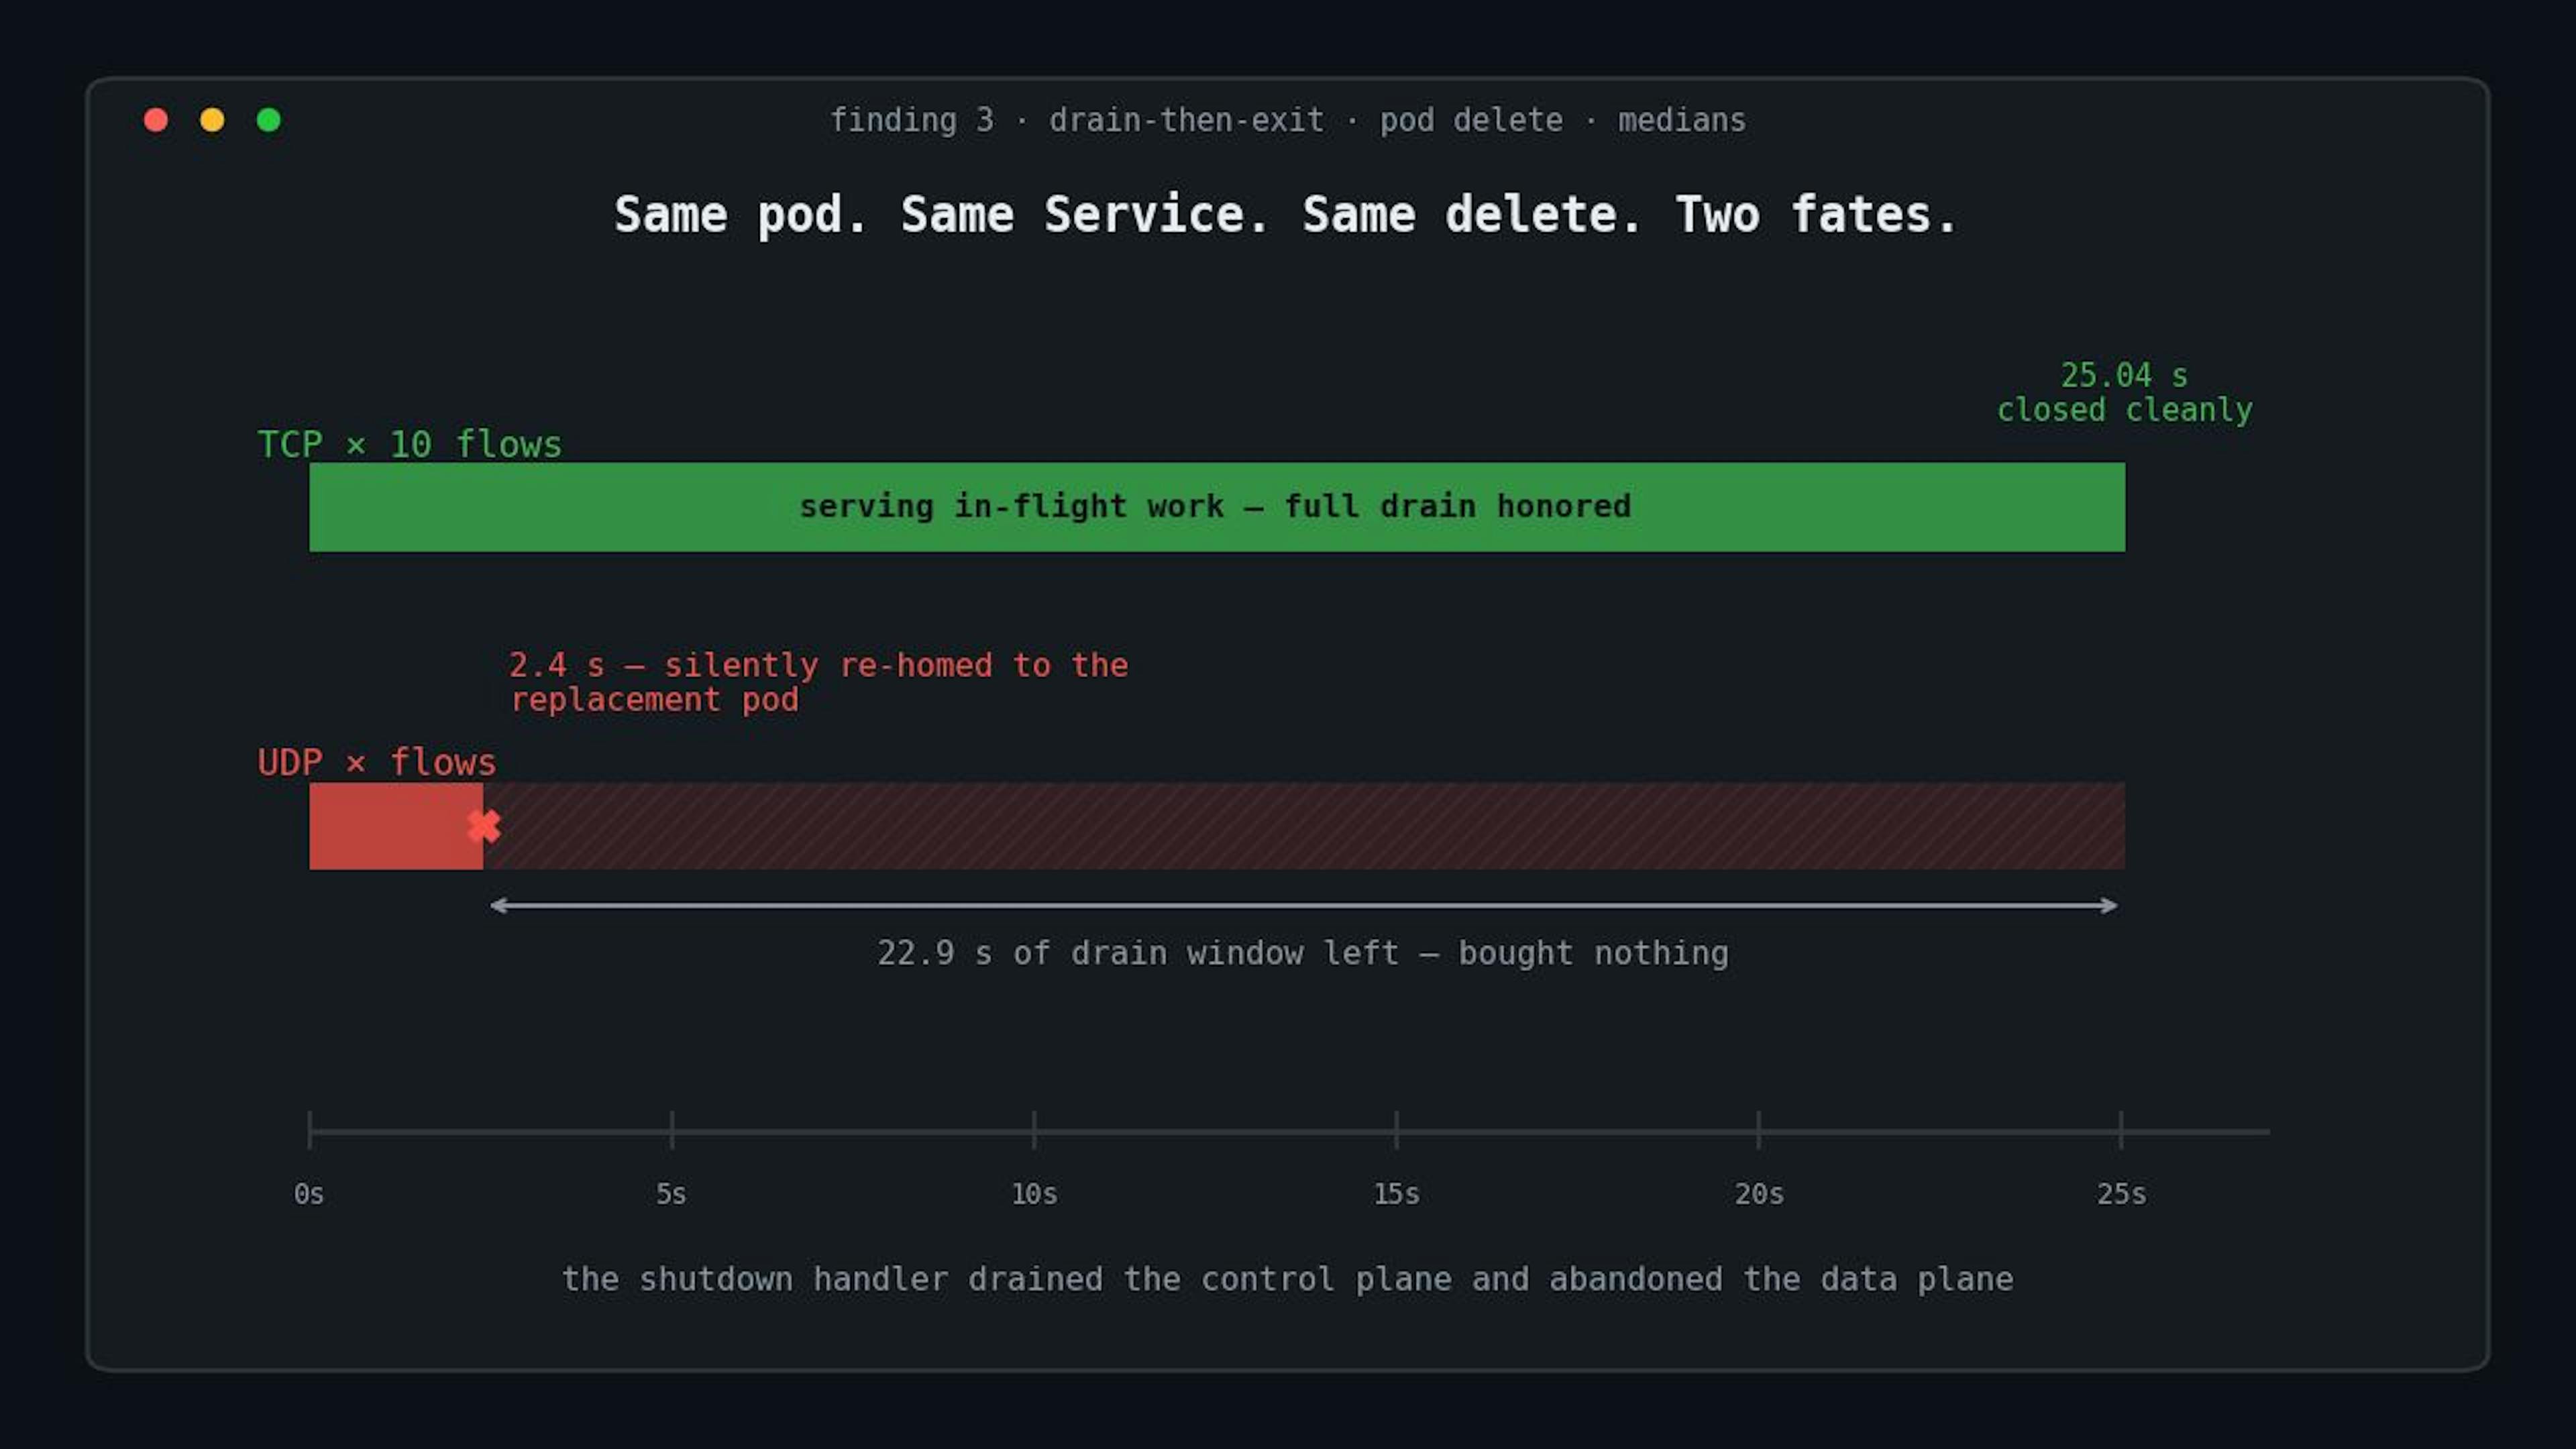
Pod を 1 つ削除すると、2 つの結末が待っている。TCP フローは 25 秒のドレインウィンドウを最後まで走り切って、きれいに閉じる。UDP フローは 2.4 秒の時点で、こっそり代替 Pod に付け替えられる——元の Pod はまだ健全で、まだドレイン中で、ウィンドウの残り時間の中央値は 22.9 秒ある。
原因を切り分けるため、対照群を 1 つ追加した。Pod を削除するのではなく、Deployment をゼロにスケールダウンする。これなら代替 Pod が存在しないので、付け替えは起こりようがない。実際、起こらなかった。UDP フローはすべて ICMP port unreachable で終わり、その時刻の中央値はコンテナ終了の 177 ミリ秒後だった。kube-proxy が、endpoint を持たない Service 宛てのトラフィックを拒否しているのだ。eviction の挙動は削除と同じで、こちらも付け替えが起きる。両者の中央値の差は 3 ミリ秒だった。
つまり Pod 終了中の UDP フローに待っている結末は 2 つだけだ。元の Pod がまだドレイン中なのに、こっそり別のバックエンドへ移されるか、あっさり拒否されるか。どちらが起きるかは代替 Pod の有無で決まり、shutdown handler とは関係ない。WebRTC のメディア、ゲームサーバー、DNS、あるいは UDP そのものが製品であるようなサービスを動かしているなら、あなたの graceful shutdown はコントロールプレーンをドレインし、データプレーンを捨てている。
メカニズムについて補足しておく。付け替えという挙動は、タイムスタンプから私が推測したものだ。drainwatch はフローの結末とクラスタイベントを記録するだけで、kube-proxy のルールや conntrack は調べていない。
最も重要な発見を、あやうく埋もれさせるところだったバグ。
最初のクラスタ実行で、drainwatch は付け替えられた UDP フローを「観測ウィンドウ内で生存」と報告した。クライアントは ack を受け取り続けていて、それが別の Pod から来ていることなど知る由もない。報告書は、これらのフローには何も起きていないと述べていた。事実は正反対だった。
だから今のプローブは、ハートビートと ack のたびに身元を名乗る。新しいインスタンスが応答したフローは切断済みと判定され、記録には新旧両方の Pod 名が残る。これが、残りの数字を私が信頼している理由でもある。テストフレームワークは、検証できない前提条件にぶつかればその時点で中止し、欠けた実行結果を平均することを拒む。自ら引き起こした結果については、すべて明記する。exit-immediately シナリオは SO_LINGER=0 を通じて強制的に RST を送り、その動作を記録に残す。カーネルのバッファリングに結果を決めさせたりはしない。自分の誤りを捕まえられない測定器は、測定器とは言えない。
注意事項
これは実験環境であって、本番環境ではない。ノードは同一マシン上のコンテナなので、絶対的なレイテンシはそのまま持ち出せない。結論は結果の構造にある。何がどのフローを終わらせたのか、そしてその順序だ。kube-proxy は iptables モードで動いており、IPVS や eBPF のデータプレーンでは挙動が違うかもしれない。クラスタイベントのタイムスタンプは watch が受信した時刻なので、上限値でしかない。ワークロードは設計上レプリカ 1 つなので、どの結果も単一の Pod に帰属できる。
自分で走らせてみる。
git clone https://github.com/jaynirmal15/drainwatch
cd drainwatch && make demo # kind cluster up, one trial, report on stdout
scripts/repeat5-matrix.sh # the full 25-trial matrix, ~30 minutes
各試行は完全な JSON レポートを書き出す。環境、タイムライン、フローごとの結果、そしてクロックに関する注記。この記事の元になった生のレポートはリポジトリにコミットしてある。
v0.2 が狙うのは、この版では答えられない 2 つの問いだ。組み込みプローブではなく自分のワークロードを接続すること、そしてクラウドロードバランサの登録解除のタイミングを測ること——そこでは、発見 2 のデッドエンドポイントのウィンドウはもっと大きくなるはずだ。
シャットダウン処理は儀式ではない。TCP にとっては 3 桁分の価値がある。UDP にとっては無価値だ——それはまた別の問題で、今では測定済みの問題である。
Jay Nirmal はシニアソフトウェアエンジニアで、リアルタイム通信インフラに携わっている。drainwatch は MIT ライセンス。issue も歓迎するし、他のデータプレーンからの反証結果も歓迎する。