你的 Pod 根本没有在排空:我实测过了
drainwatch 用 25 次实测拆开 Kubernetes 的优雅关闭,立即退出的 Pod 在 45 毫秒内被 RST 切断 TCP,Service 却还能对外通告已经死掉的进程 221 毫秒。
中文
复制
关于 Kubernetes 优雅关闭的指南讲的都是同一个故事。Pod 收到 SIGTERM。端点被移出轮转。流量停止到达。处理程序完成在途工作后退出。这个故事很合理。我想知道它是不是真的。不是看起来合理,而是有实测、有时间戳。
于是我做了 drainwatch。这是一个小型 Go 工具,它对一个 pod 保持长连接 TCP 和 UDP 连接,用不同方式终止该 pod,并记录每条连接实际是被什么、在什么时候结束的。证据来自 Kubernetes watch 事件以及数据包本身。
我跑了 25 次试验。五种终止场景,每种重复五次,一个固定不变的二进制文件,每个场景一个全新的 kind 集群。Kubernetes v1.34.0,kube-proxy 使用 iptables 模式。下面每一条结论都能追溯到仓库中提交的 report.json。
发现 1:收到 SIGTERM 后怎么做,决定 TCP 的命运
同一个集群。同样的触发方式:删除 pod。同样 30 秒的宽限期。唯一的变量是应用收到 SIGTERM 后做什么。
| SIGTERM 行为 | TCP 结果(五次重复全部一致) | 最后一条 TCP 连接结束于 | 容器退出码 |
|---|---|---|---|
| 立即退出 | 10/10 被 RST 切断 | 45 ms(30–98) | 0 |
| 排空后退出 | 10/10 干净关闭 | 25.04 s(25.03–25.11) | 0 |
| 忽略 SIGTERM | 10/10 在传输中途被切断 | 30.06 s(30.05–30.06) | 137 |
数值为五次重复的中位数,括号内为范围。
立即退出的应用会在 45 毫秒内杀掉它持有的所有连接。排空的应用让全部十条连接存活到 25 秒窗口结束,然后干净地关闭它们。忽略 SIGTERM 的应用则一直保持连接,直到 kubelet 介入。SIGKILL 在 30 秒宽限边界之后 62 毫秒内到达。五次重复的退出码都是 137。一个永不退出的应用无法决定自己的连接何时死掉。决定权在 kubelet 手里。
这些都不与文档矛盾。接下来两条发现讲的才是文档没说的部分。
发现 2:你的 Service 对外通告的是已经死掉的 pod
在「立即退出」场景里,我测了两个事件之间的间隔:最后一条 TCP 连接被切断的时刻,以及 endpoint 从 EndpointSlice 中被移除的时刻。
| 指标(n=5) | 中位数 | 最差一次 |
|---|---|---|
| 最后一条 TCP 连接死亡于 | 45 ms | 98 ms |
| Endpoint 被移除于 | 293 ms | 591 ms |
| Service 对外通告一个已死进程的窗口 | 221 ms | 521 ms |
中位数 221 毫秒,最差的一次超过半秒,EndpointSlice 里始终挂着一个 endpoint,而它的进程早已把它持有的每一条连接都重置了。任何按这份通告路由过去的请求都无处可落。
这正是连接排空(connection draining)那套建议想要覆盖的竞态。现在它有数字了。两个时间戳取自同一个时钟,所以这个窗口是精确的。窗口在每一次重复中单独计算,再取各次重复的中位数,因此它并不等于上表中两个中位数之差。
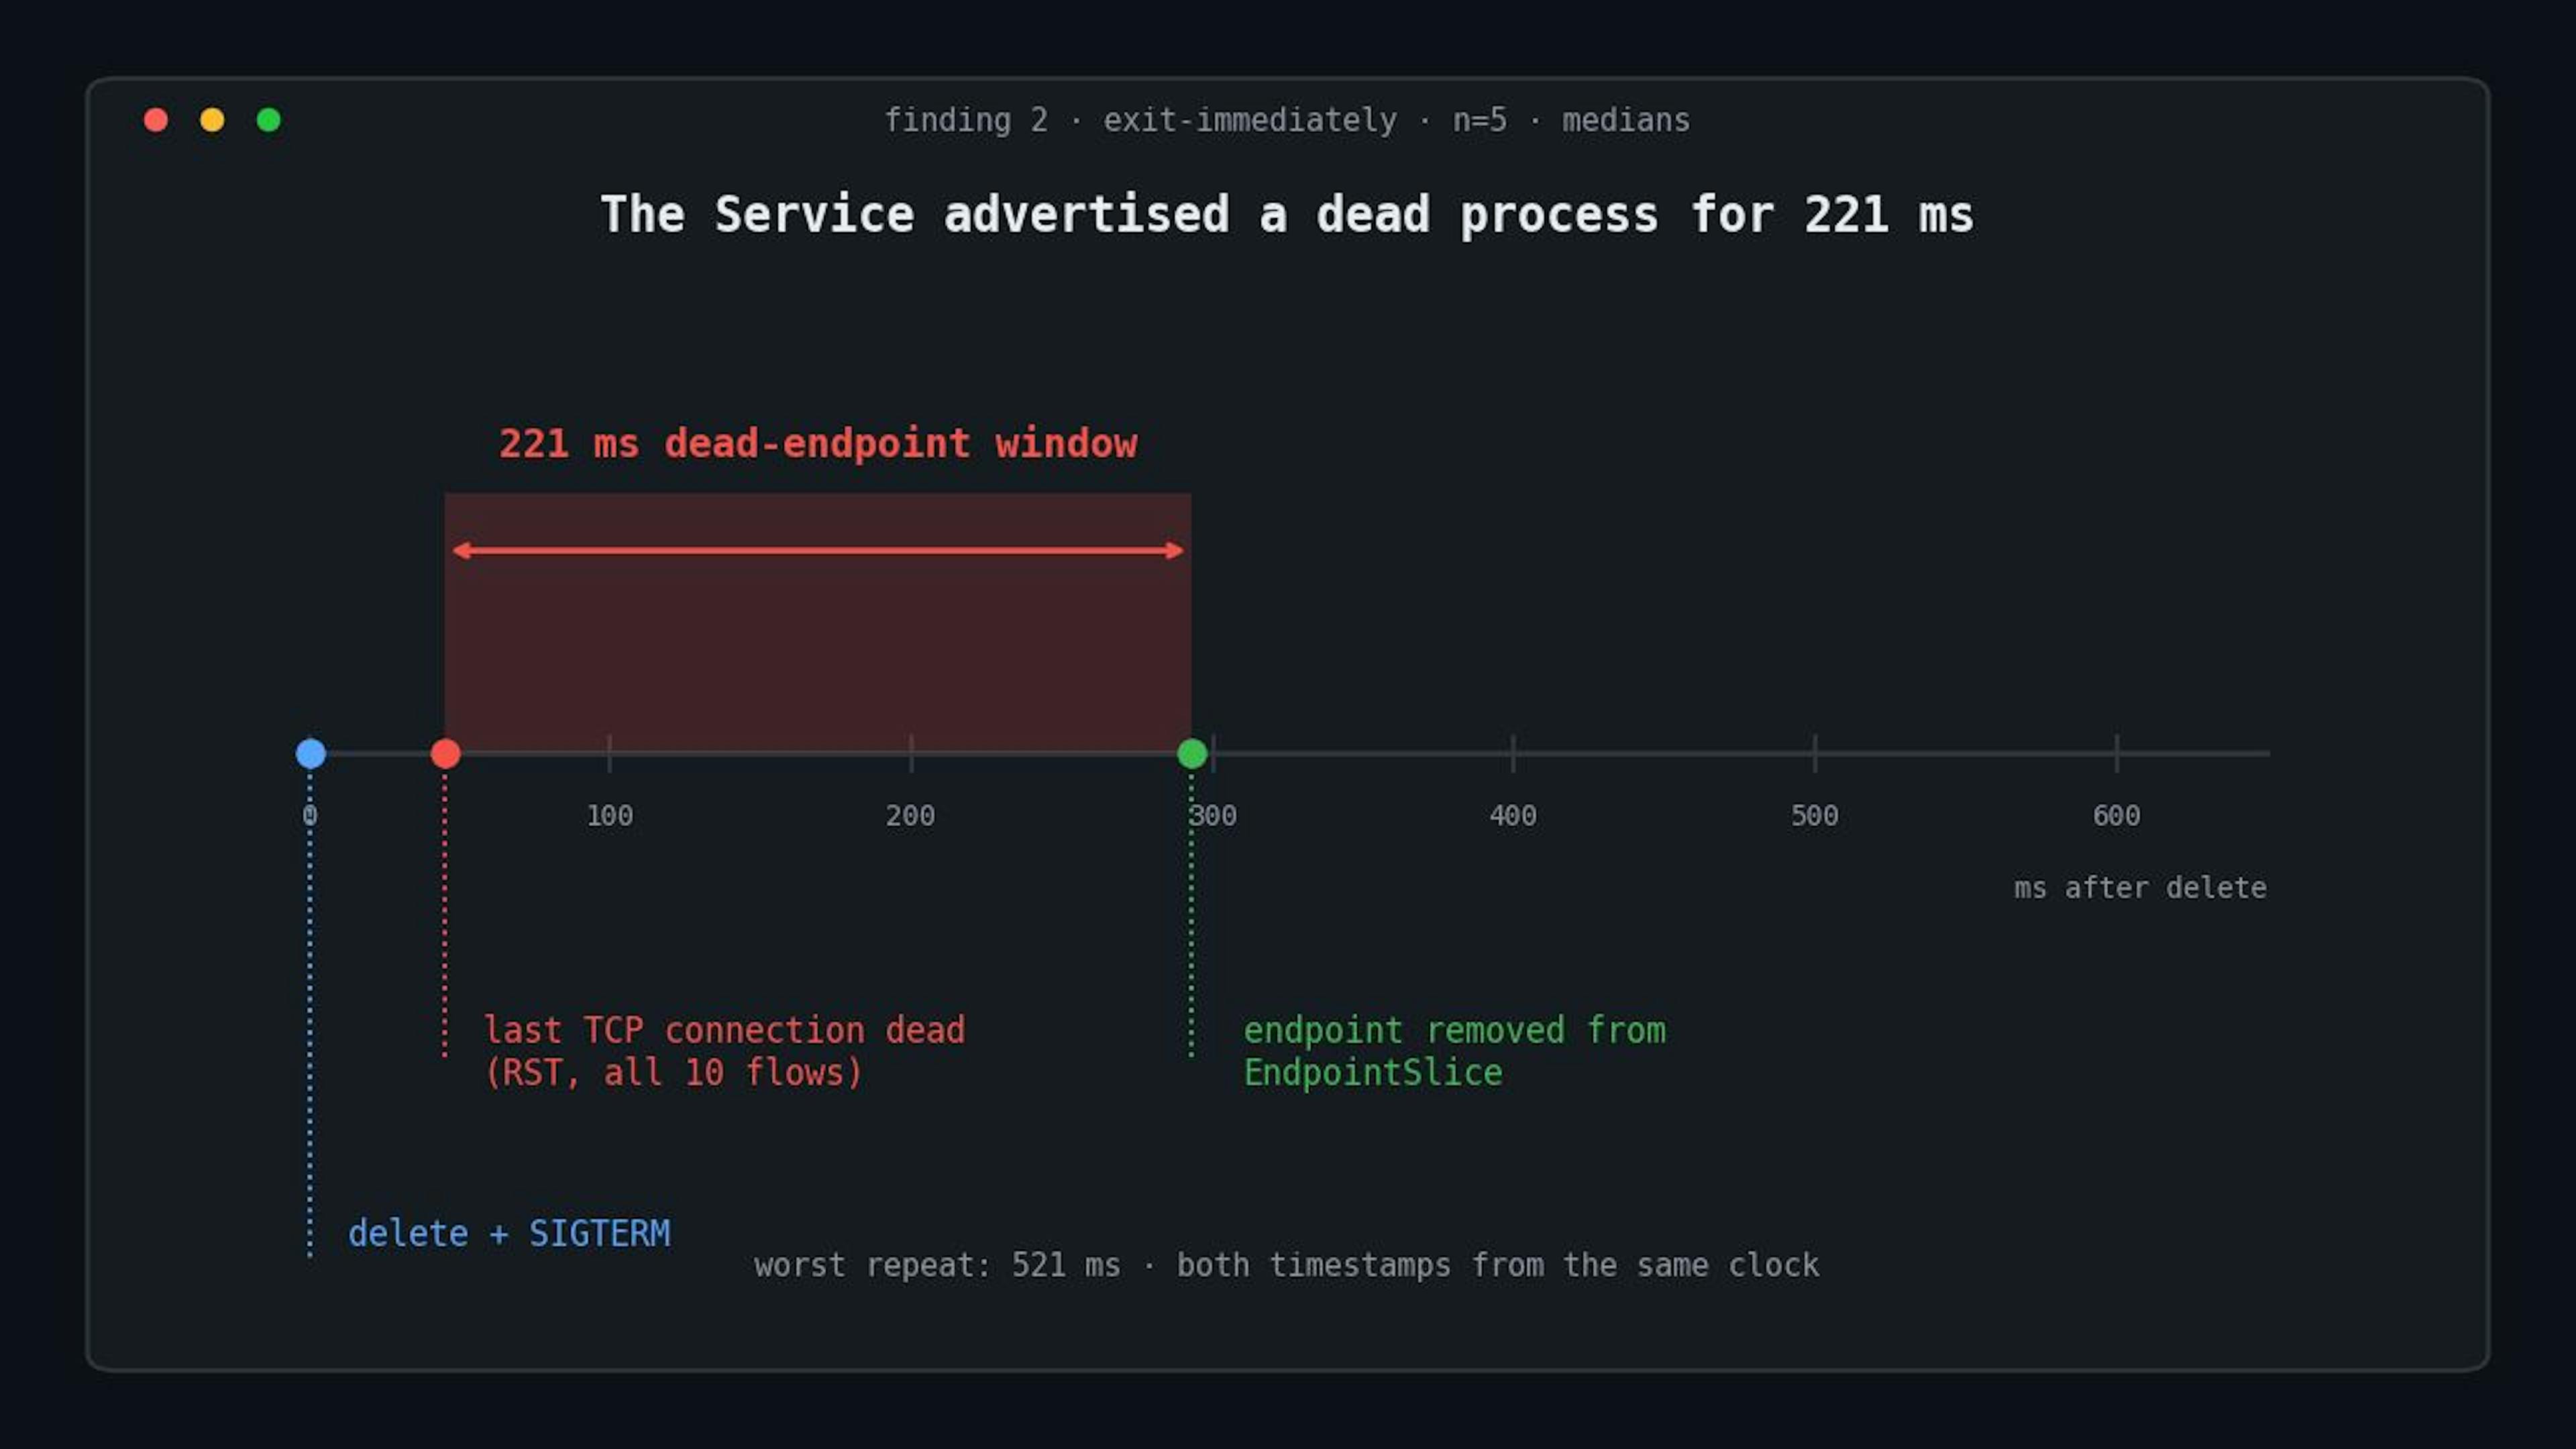
「立即退出」场景中的死 endpoint 窗口
同一份数据还有一个结果。通常的假设是 endpoint 移除会发生在 SIGTERM 之前,并留出一段可用的余量。在这个集群上,两个事件同时发生,差距在测量精度之内。每一次试验、每一个场景都是如此。
发现 3:UDP 没有排空可言
这个发现让我意外,而我自己就是做实时媒体系统的。
排空场景跑的是教科书式的优雅关闭:停止接受新连接,继续服务已建立的连接,做完就退出。TCP 拿到了它的 25 秒。UDP 流则被保持在同一个 pod、经由同一个 Service 上——然后在 delete 之后 2.4 秒就没了。不是死掉,而是由另一个 pod 来应答了。
删除一个由 Deployment 管理的 pod 会让 ReplicaSet 创建替代者。UDP 是无连接的。替代者一就绪,kube-proxy 就把数据报导了过去。原来的 pod 还在运行,还健康,还在服务 TCP,排空窗口里中位数还剩 22.9 秒。应用执行了一次完美的排空,而对 UDP 来说,这什么也没换来。
我知道流量发生了迁移,因为探针会在每个回复上标记自己的 pod 名称。这个机制的原理,下面再说。
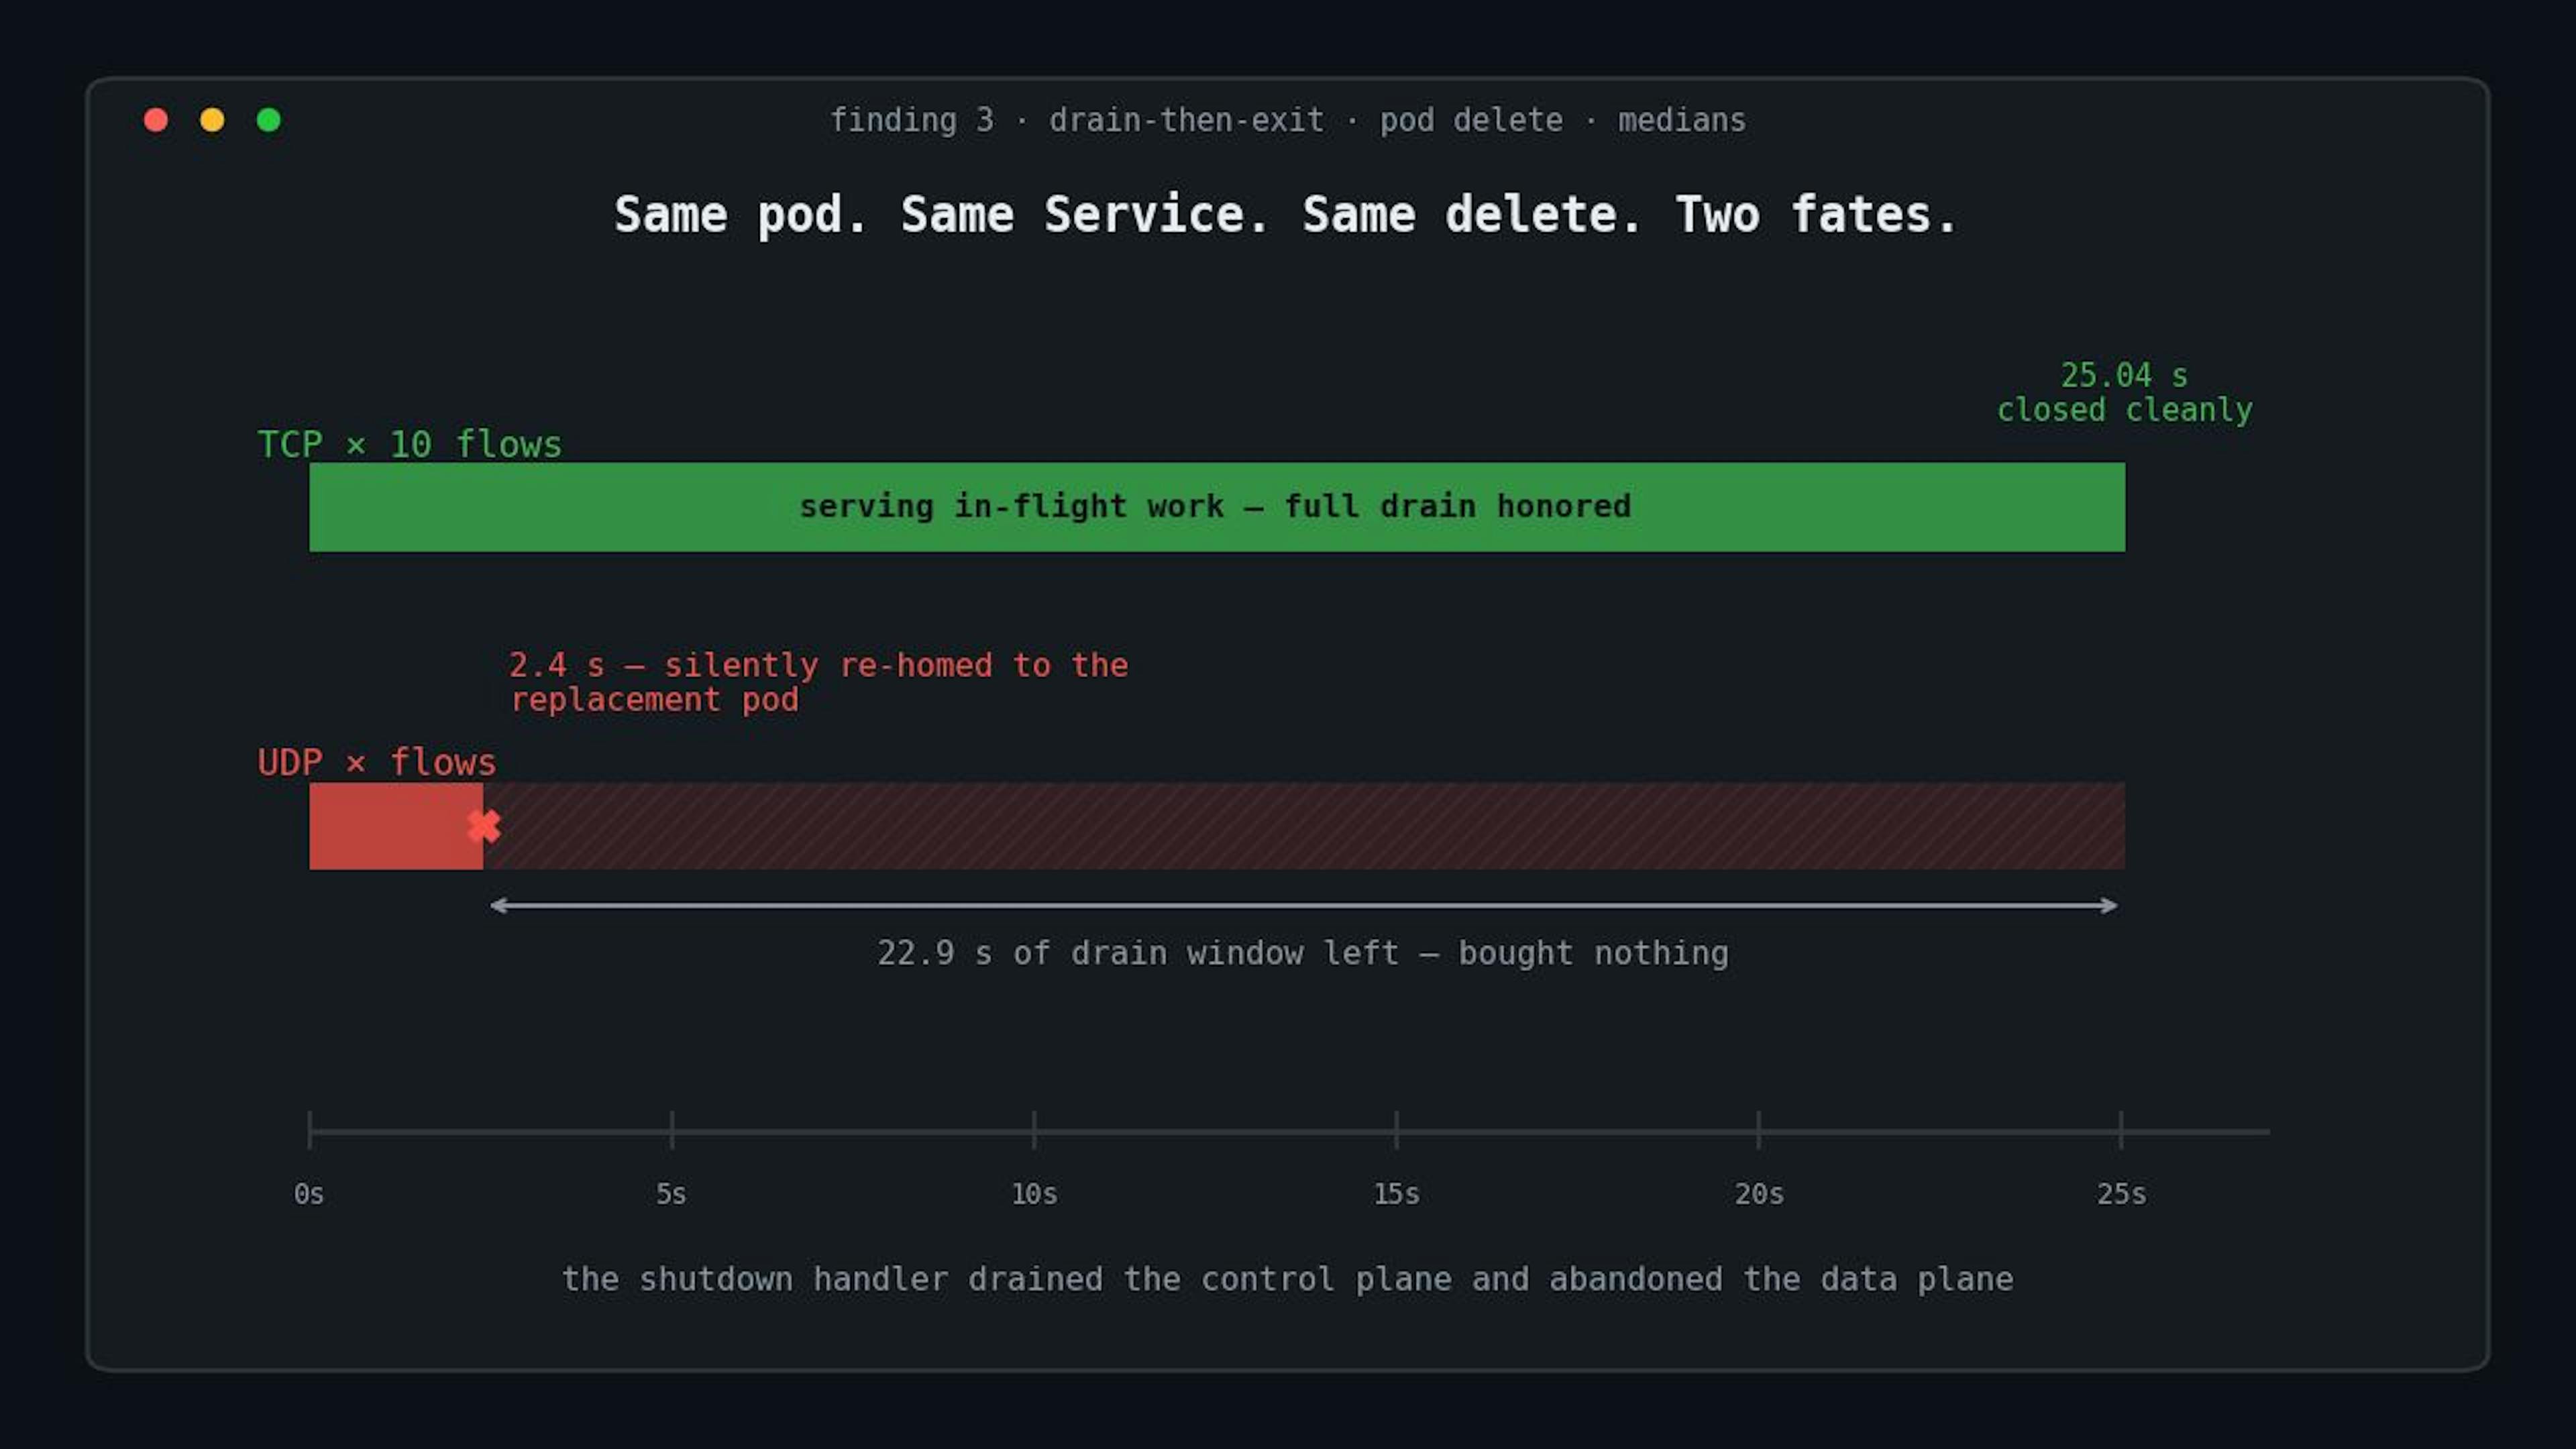
删除一个 pod,两种命运。TCP 流走完完整的 25 秒排水窗口,干净关闭。UDP 流在 2.4 秒时被悄悄改接到替换 pod 上——而原 pod 仍然健康,仍在排水,窗口剩余时间中位数为 22.9 秒。
为了隔离原因,我加了一组对照:把 Deployment 缩容到零,而不是删除 pod。这样不存在替换 pod,改接就不可能发生。结果确实没有发生。所有 UDP 流都以 ICMP port unreachable 告终,时间中位数为容器退出后 177 毫秒。这是 kube-proxy 在拒绝发往一个没有 endpoint 的 Service 的流量。驱逐(eviction)的行为和删除一样,同样会改接,两者中位数相差 3 毫秒。
所以 pod 终止期间的 UDP 流只有两种命运:在原 pod 仍在排水时被悄悄迁移到另一个后端,或者直接被拒绝。触发哪一种,取决于是否存在替换 pod,与 shutdown handler 无关。如果你跑的是 WebRTC 媒体、游戏服务器、DNS,或者任何以 UDP 为产品的服务,你的优雅关闭排空的是控制面,抛弃的是数据面。
关于机制补充一句:改接这个行为是我从时间戳推断出来的。drainwatch 记录流的命运和集群事件,不检查 kube-proxy 规则或 conntrack。
差点埋掉最重要发现的 bug。
第一次集群运行时,drainwatch 把改接的 UDP 流报告为“在观察窗口内存活”。客户端一直在收到 ack,无从得知它们来自另一个 pod。报告说这些流什么都没发生。事实恰恰相反。
这就是探针现在每次心跳和 ack 都要表明身份的原因。由新实例响应的流会被判定为已切断,记录里同时保留新旧 pod 名称。这也是我信任其余这些数字的原因。测试框架遇到任何无法验证的前置条件都会中止,拒绝在残缺的运行结果上取平均。凡是它主动造成的结果,它都会写明:exit-immediately 场景通过 SO_LINGER=0 强制发出 RST,并记录下这一动作,而不是让内核缓冲决定结果。一个抓不住自身错误的测量工具,算不上测量工具。
注意事项
这是实验环境,不是生产环境。节点是同一台机器上的容器,所以绝对延迟不可迁移。结论在于结果的结构:什么终结了哪些流,以及顺序如何。kube-proxy 运行在 iptables 模式下,IPVS 或 eBPF 数据平面可能表现不同。集群事件时间戳是 watch 收到的时间,因此只是上界。工作负载按设计只有一个副本,所以每个结果都能归因到单个 pod。
自己跑一遍。
git clone https://github.com/jaynirmal15/drainwatch
cd drainwatch && make demo # kind cluster up, one trial, report on stdout
scripts/repeat5-matrix.sh # the full 25-trial matrix, ~30 minutes
每次试验都会写出完整的 JSON 报告:环境、时间线、每条流的结果,以及时钟说明。本文背后的原始报告已提交到仓库中。
v0.2 针对的是这一版回答不了的两个问题:接入你自己的负载而不是内置探针,以及测量云负载均衡器的注销时序——在那里,发现 2 中的死端点窗口应该会更大。
关闭处理不是走过场。对 TCP 来说,它值三个数量级。对 UDP 来说,它一文不值——这是另一个问题,现在是一个已被测量的问题。
Jay Nirmal 是一名高级软件工程师,从事实时通信基础设施方面的工作。drainwatch 采用 MIT 许可证。欢迎提交 issue,也欢迎来自其他数据平面的相反结果。
来源: HackerNoon← 返回首页