DatabricksとRedisによるリアルタイムパーソナライゼーションの実現
Spark の Real-Time Mode が連続計算を担い、Redis がミリ秒単位の読み取りを担う。この役割分担により、パーソナライズ推薦と不正スコアリングをリクエストパス内に収めている。記事には実行可能なサンプルリポジトリも付属。
日本語
コピー
顧客がECサイトを見ている。ランニングシューズを検索し、商品ページを開き、レビューを確認し、カートに入れる——どの操作も、その瞬間に何を求めているかを示すシグナルだ。ここで表示されるホームページが今朝の汎用プロモーションのままなら、そのタイミングは逃している。レコメンドの価値は急速に薄れる。多くの場合、同じセッションのうちに、あるいは1回のページ読み込みに要する500ミリ秒のうちにさえ。
しかし、数分おきにしか更新されない従来のバッチアーキテクチャでは、リアルタイムの機会を捉えることは不可能だ。リアルタイムパイプラインを設計するデータエンジニアやアーキテクトにとっての課題は、分析とアクションの間のギャップを埋めることにある。スケジュールに従って更新される従来のパイプライン——数分おき、あるいは数秒おきであっても——は、「何が起きたか」に答えるのは得意だ。だが、パーソナライゼーション、不正スコアリング、在庫判断は、顧客がまだページ上にいるうちに「次に何が起きるべきか」に答えなければならない。つまり、イベントが到着した時点で最新の状態を計算し、それをミリ秒単位でアプリケーションに返す必要がある。
同時に成り立たなければならないことが2つある。処理は連続的でなければならず、サービングは即時でなければならない。かつてこれを実現するには、複雑なデュアルエンジン構成を維持する必要があった。通常は、既存のバッチフレームワークの隣に Apache Flink のような専用エンジンを追加で載せる形だ。
RTM と Redis がリアルタイムユースケースに不可欠な理由
Real-Time Mode(RTM)が解決するのは1つ目、連続処理だ。Structured Streaming は Apache Spark™ でイベントストリームを連続処理するためのエンジンで、使い方はテーブルをクエリするのと同じだ。ただし、そのテーブルは決して更新が止まらない。デフォルトの実行モードは高スループットの ETL に非常によく合い、秒から分単位の遅延は許容できるが、数十ミリ秒以内に収める必要があるクローズドループの意思決定には向かない。Real-Time Mode は Structured Streaming の比較的新しい実行モードで、まさにこのギャップを埋めるために存在する。RTM は連続的なデータストリームを取り込み、イベントが届き次第処理することで、サブ秒の性能を実現し、p99 レイテンシは数十から100ミリ秒台で安定する。すでに書いているのと同じ Spark API 上で動作するため、Apache Flink のような独立したエンジンを立てる必要がなく、コードベースの重複やロジックのずれも解消される。
Redis が担うのは後半、即時読み取りだ。RTM が最新のレコメンド結果、不正スコア、セッション状態を計算したあと、アプリケーションはリクエストパス上で極めて高いリクエストレートのもと、1ミリ秒を大きく下回る時間でそれを読み出す必要がある。ここで Redis の出番となる:
-
高スループット下でのサブミリ秒の読み書き
-
Hashes、JSON、Streams、TimeSeries、Sorted Sets といった柔軟なデータモデルにより、アプリケーションが必要とする形でデータを書き込める
-
組み込みの TTL(Time to live)とエビクションにより、データを新鮮に、メモリを効率的に保つ
-
本番の読み取りに向けた高可用性構成:Redis Cloud と Azure Managed Redis は、条件を満たすマルチ AZ デプロイで99.99%、条件を満たす Active-Active デプロイで99.999%のサービスコミットメントを提供する。どの水準が適用されるかは製品、プラン、トポロジーによって異なる
すでに Redis をアプリケーションキャッシュとして使っているチームにとって、このパターンは既存のコンポーネントをリアルタイム読み取り層へと拡張するものであり、アプリケーションチームが運用・統合しなければならない技術を新たに持ち込む必要はない。
役割分担が肝心だ。Real-Time Mode はストリーミングイベントから最新の実行状態を計算し続け、Redis がその状態を低レイテンシの読み取り層として保持する。これによりアプリケーションはミリ秒単位で意思決定し、パーソナライズされた体験を届けられる。計算は計算、読み取りは読み取りで、それぞれが自分の役割を果たす。
iFood はラテンアメリカをリードするフードデリバリープラットフォームで、毎日数百万件の注文を処理している。Databricks Real-Time Mode と Redis を基盤に、その機械学習プラットフォーム上で大規模なリアルタイム意思決定を支えている。
「Real-Time Mode のおかげで、Databricks は私たちのリアルタイム Feature Platform の中核になりました。オンライン読み取りに Redis を組み合わせることで、ストリーミングデータを1秒以内に本番利用可能な特徴量へと継続的に変換しつつ、機械学習ワークロードに必要なスケールと運用のシンプルさを保てています。」
—— Willian Moreira、iFood チーフ機械学習プラットフォームエンジニア

ユースケース:セッション内でリアルタイムに調整されるレコメンド
具体的に考えてみよう。作るのは、ユーザーが閲覧するにつれて更新され続ける商品レコメンドだ。ユーザーが見る次のページが、前回のバッチ処理が終わった時点の状態ではなく、直近の操作を反映するようにする。
入力はクリックストリームだ。商品閲覧、検索、カート追加、注文と、アクションごとに1件のメッセージが流れる。出力は、ユーザーごとに継続的に更新されるレコメンド商品のランキングリストで、サイトがページをレンダリングするたびに読み取る。その間には、ユーザー単位の少量のセッション状態(最近何を見たか)を保持し、それをもとに候補商品をスコアリングする必要がある。
Databricks と Redis の組み合わせ方
アーキテクチャ
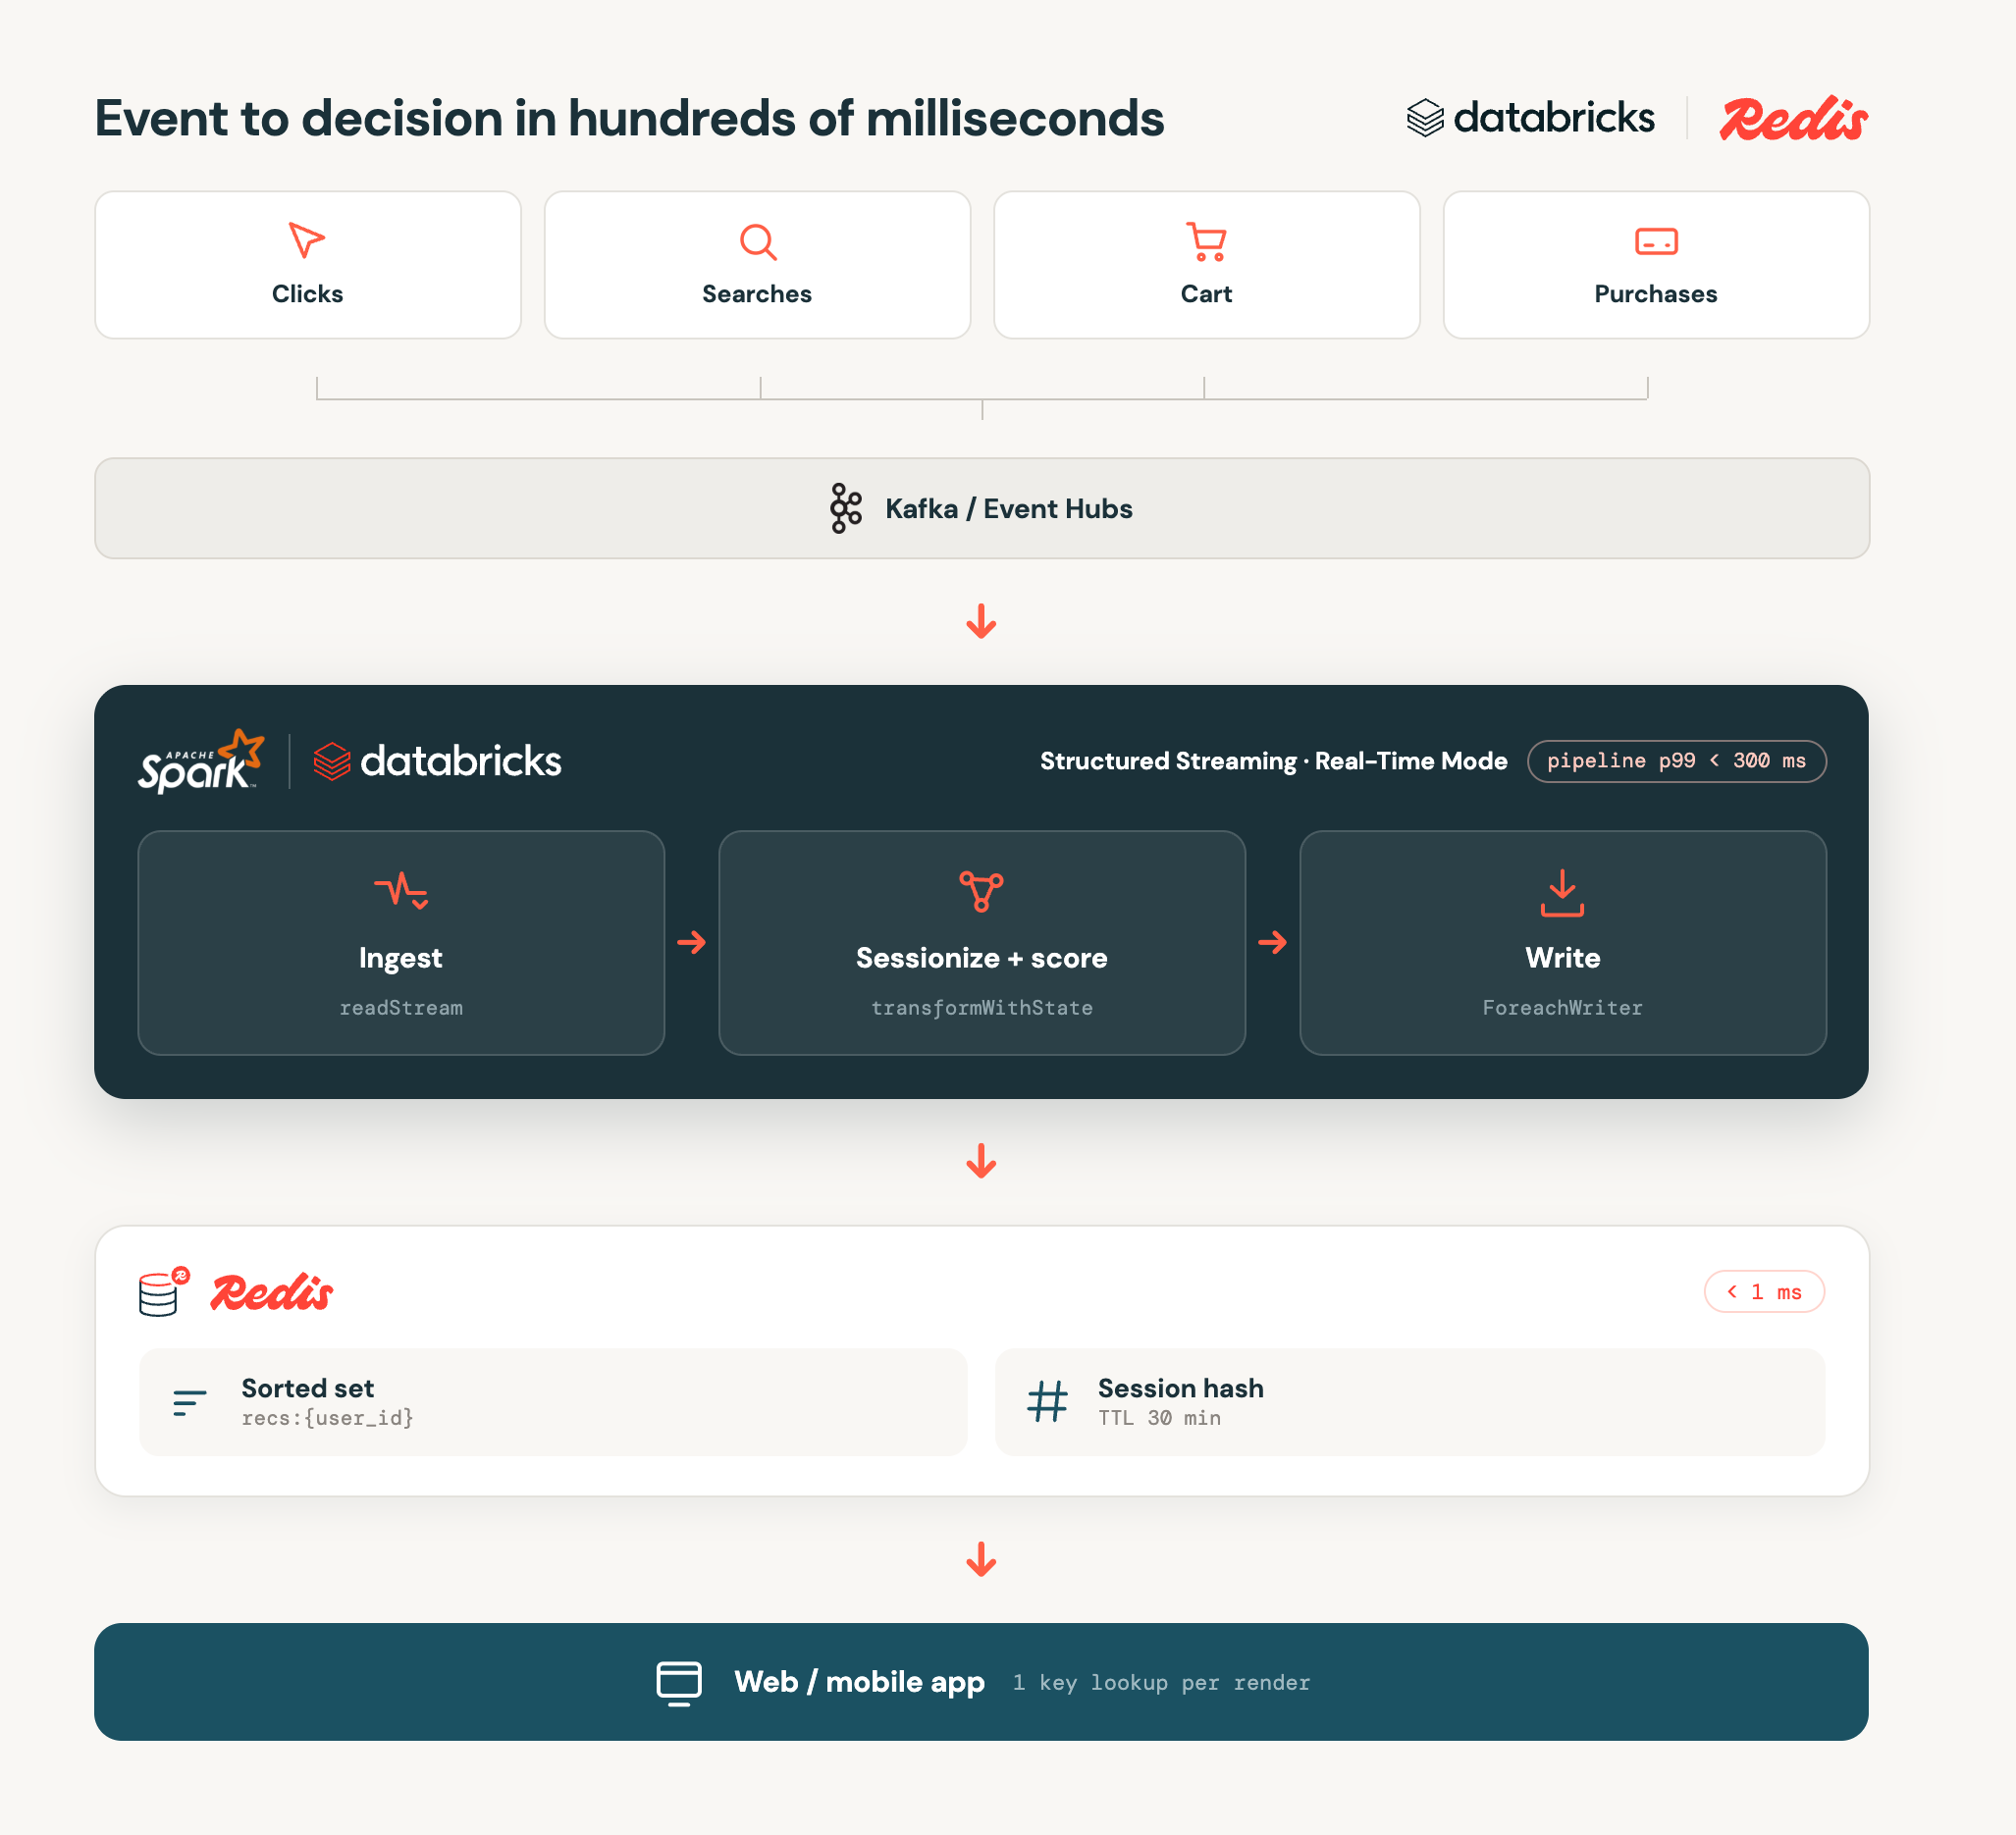
クリックストリームはまず Kafka に入る。RTM パイプラインがそれを読み、ユーザーごとのセッション状態を維持し、その状態で候補商品をスコアリングし、ランキング結果を Redis に書き込む。サイトはページをレンダリングするたびに Redis のキーを1つ読む。
ステップ1:クリックストリームを読む
通常の Structured Streaming だ。ここにはまだ RTM 固有の要素はない。
events = (spark.readStream.format("kafka")
    .option("subscribe", "clickstream")
    .option("kafka.bootstrap.servers", BROKERS)
    .load()
    .select(from_json(col("value").cast("string"), EVENT_SCHEMA).alias("e"))
    .select("e.*"))    # user_id, event_type, product_id, category, ts
ステップ2:セッションを分割してスコアリングする
ユーザーごとに保持する状態は少量だ。そのユーザーが触れた各商品について、時間減衰するスコアを1つ記録する。各イベントは、関与した商品にスコアを加算する。重みは意図に依存し(注文は閲覧より重い)、すべてのスコアは時間とともに減衰するため、直近の関心が古い関心を上回る。リアルタイムパス全体で、キー付きステートフルオペレータは1つだけ、シャッフルも1回だけだ。
EVENT_WEIGHTS = {"view": 1.0, "search": 1.5, "cart": 4.0, "purchase": 8.0}

def decay(score, last_seen_ms, now_ms):          # halves every HALF_LIFE_SECONDS
    return score * 0.5 ** ((now_ms - last_seen_ms) / 1000 / HALF_LIFE_SECONDS)

class ProductAffinity(StatefulProcessor):
    def init(self, handle):
        # the user's whole affinity map, held as one JSON-encoded state value
        self.state = handle.getValueState("affinity", "payload STRING")

    def handleInputRows(self, key, rows, timerValues):     # once per row in RTM
        now = timerValues.getCurrentProcessingTimeInMs()
        v = self.state.get()
        m = json.loads(v[0]) if v else {}                  # 1 state read: whole map
        for r in rows:
            old = m.get(r.product_id)
            score = (decay(old[0], old[1], now) if old else 0.0) + EVENT_WEIGHTS[r.event_type]
            m[r.product_id] = [score, now]
        ranked = sorted(((p, decay(s, ts, now)) for p, (s, ts) in m.items()),
                        key=lambda kv: kv[1], reverse=True)
        ranked = [(p, s) for p, s in ranked if s >= SCORE_FLOOR][:MAX_TRACKED]
        self.state.update((json.dumps({p: [s, now] for p, s in ranked}),))   # 1 state write
        yield emit(key[0], ranked[:TOP_N], now)            # per-event: top-10 to Redis

recommendations = (events
    .groupBy("user_id")
    .transformWithState(ProductAffinity(), OUTPUT_SCHEMA,
                        outputMode="update", timeMode="processingTime"))
ここでのスコアリングはあえて単純にしてある。直近の行動に重みを付け、商品を並べ替える。完全なモデルに差し替えても、同じ位置に差し込むだけだ。本番環境では、こうした興味スコアは通常 ML ランキングモデルに渡されるか、モデル自体に置き換えられる。その前段に候補生成を置き、ユーザーがまだ見ていない商品を拾い上げる。以下のベンチマークでは、Kafka インターフェース経由で Azure Event Hubs に接続してこのパイプラインを動かした。付属のリポジトリにはその Kafka パイプラインが含まれている。
ステップ 3: ForeachWriter で Redis に書き込む
ここに、実際に効いてくる統合の詳細がある。Spark から Redis へ書き込む方法は 2 つある。Redis Spark Connector は、クラシックな Structured Streaming で Redis に接続する最も手軽な手段だ。Real-Time Mode の更新に connector はまだ対応していないため、RTM では ForeachWriter 経由で書き込む。これは Spark がカスタム出力先向けに用意した標準 sink だ(foreachBatch ではなく foreach sink。foreachBatch は本質的にマイクロバッチのままだ)。各ユーザーの推薦は、同じ slot を共有する 2 つの key として保存する。並び順を保持する sorted set(商品からスコアへ)と、商品ごとのタイトルと価格を持つ hash だ。どちらにも短い TTL を設定し、期限切れのセッションは自然に消える。書き込み時はユーザーをバッファリングし、パイプラインでまとめてコミットしてラウンドトリップを減らす。
class RedisSink:
    def open(self, partition_id, epoch_id):
        import redis
        self.r = redis.Redis(host=HOST, port=PORT, password=PWD, ssl=True)
        self.buffer = []
        return True

    def _queue(self, pipe, user_id, recs):           # stage one user's full replace
        key = f"recs:{{{user_id}}}"                   # {..} = Redis Cluster hash tag
        meta = f"{key}:meta"
        pipe.delete(key, meta)
        pipe.zadd(key, {r.product_id: r.score for r in recs})
        pipe.hset(meta, mapping={r.product_id: f"{r.title}|{r.price}" for r in recs})
        pipe.expire(key, TTL); pipe.expire(meta, TTL)

    def process(self, row):
        self.buffer.append((row.user_id, list(row.recs)))
        if len(self.buffer) >= FLUSH_EVERY:
            self._flush()

    def _flush(self):
        pipe = self.r.pipeline(transaction=False)
        for user_id, recs in self.buffer:
            self._queue(pipe, user_id, recs)
        pipe.execute()
        self.buffer = []

    def close(self, error):
        if self.buffer:
            self._flush()
        self.r.close()

query = (recommendations.writeStream
    .foreach(RedisSink())
    .trigger(realTime="5 minutes")   # enables RTM (Scala: RealTimeTrigger.apply("5 minutes"))
    .outputMode("update")            # RTM requires update mode
    .start())
本番環境での注意点が 1 つある。デモの pipe.execute() はバッファしたコマンドを送信し、Redis が書き込みを確認するまで待つ。高負荷時にこれを fire-and-forget に置き換えてはいけない。確認のない書き込みは静かに失われ、サービス層から見れば、推薦結果が古くなっているのに誰も気づかないということになる。
ステップ 4: アプリケーションからの読み取り
サイトのレンダリングごとに、pipeline のラウンドトリップは 1 回だけだ。sorted set から並び替え済みの id を取得し、hash から対応するタイトルと価格を取得する。Spark のクエリもテーブルスキャンもなく、あるのはサブミリ秒の Redis だけだ。
key  = f"recs:{{{user_id}}}"
top  = r.zrevrange(key, 0, 9, withscores=True)   # ranked product ids + scores
meta = r.hgetall(f"{key}:meta")                  # product_id -> "title|price"
顧客がクリックすれば、次のページに反映される。Eコマースはあくまで背景にすぎない。本当に示したいのは、計算とサービングがエンドツーエンドで連携して動くことだ。
パフォーマンス
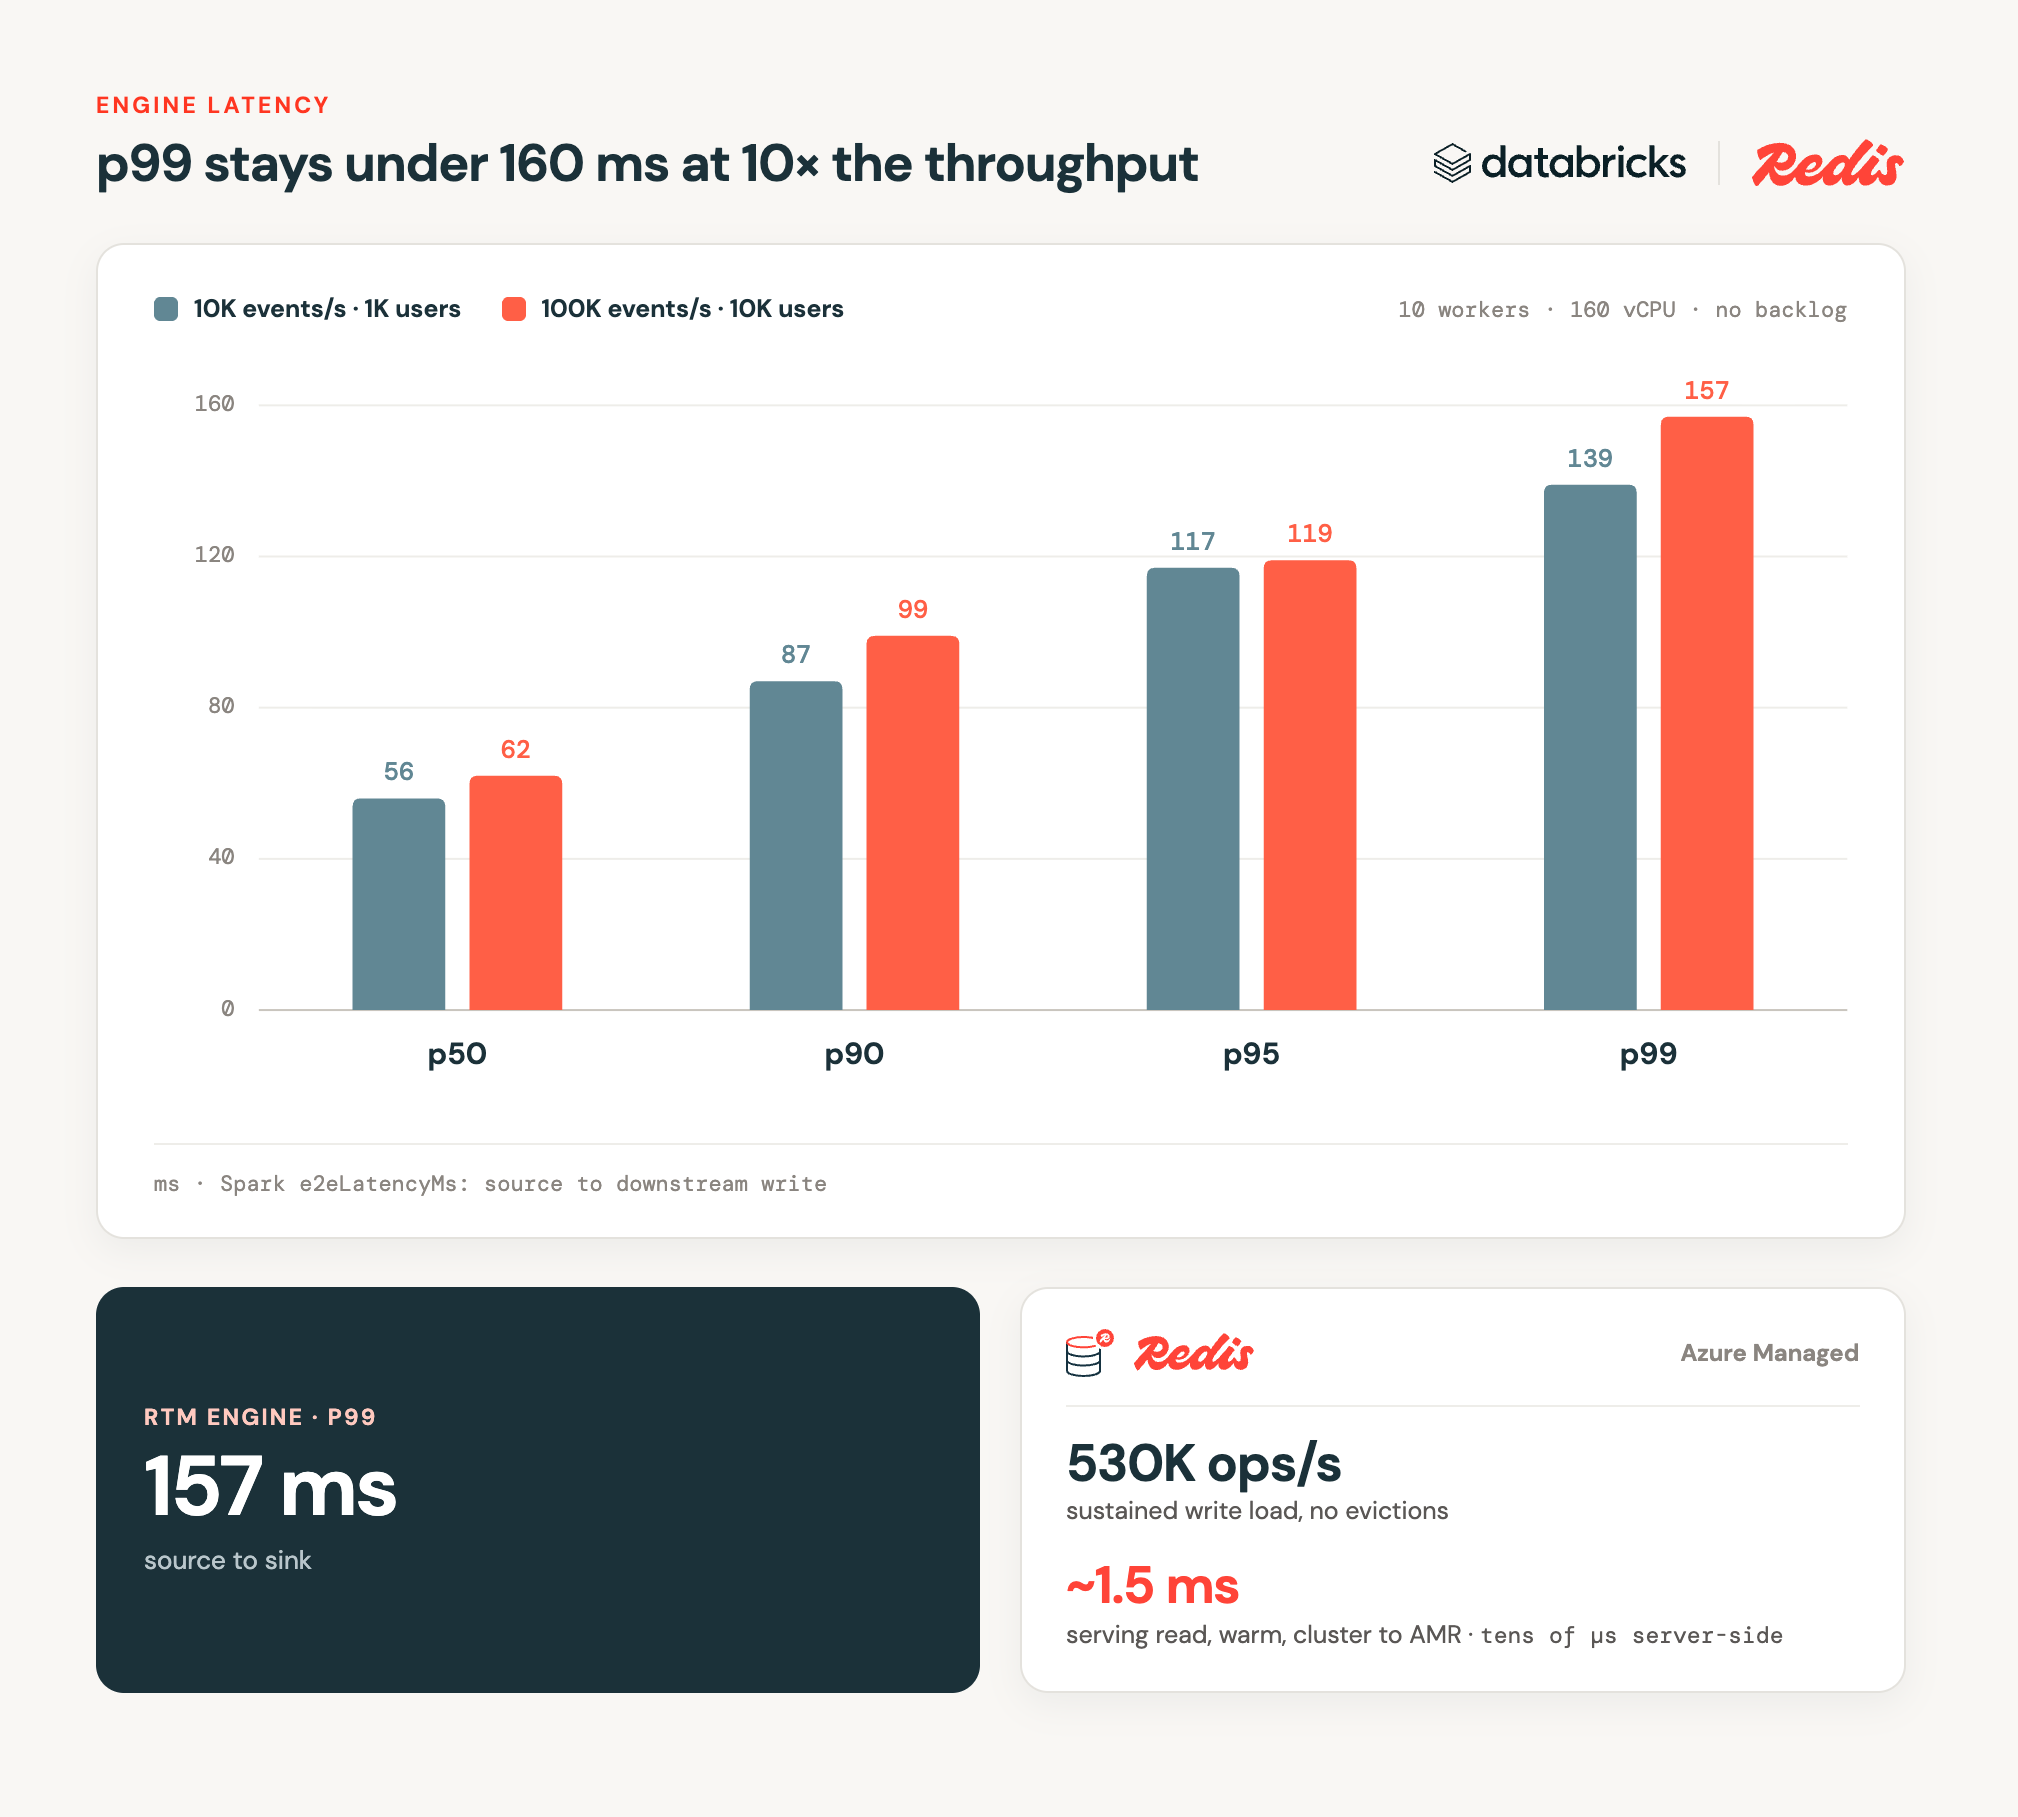
このパイプラインを Azure Managed Redis に対して継続的に動かし、10 worker のクラスタ(160 vCPU)、アクティブユーザー 10,000 人の条件下で、毎秒 100,000 件のクリックストリームイベントを滞留なく安定して処理した。ユーザーごとの状態は常に有界で、Redis は毎秒約 530,000 オペレーションの書き込み負荷を難なくさばき、eviction は発生しなかった。
クリックから推薦が返るまで: p99 は 160 ms 未満
| 指標 | 10k イベント/秒 | 100k イベント/秒 |
|---|---|---|
| p50 | 56 ms | 62 ms |
| p90 | 87 ms | 99 ms |
| p95 | 117 ms | 119 ms |
| p99 | 139 ms | 157 ms |
ユースケースの広がり
同じパターン(RTM が最新状態を計算し、Redis がミリ秒単位でそれを提供する)は、あらゆる業界で見られる。イベントとスコアリングのロジックを差し替えても、形は変わらない。
-
決済の不正検知: RTM が取引データを enrich して不正スコアを計算し、Redis が承認前に最新スコアを決済ゲートウェイへ提供する。
-
マルチエージェント協調: RTM がエージェントのイベント、ツールの結果、ワークフローの更新を継続的に処理して共有状態を導出し、Redis がその状態を即座に利用可能にする。エージェントはそれに基づいて協調し、作業を引き継ぎ、行動の衝突を避ける。
-
リアルタイム ML 特徴量サービング: RTM がローリング特徴量(直近の購買、クリック率、セッションのアクティビティ)を継続的に計算し、Redis が最新の特徴量ベクトルをオンライン推論へ提供する。
-
動的在庫: 注文、返品、倉庫の更新が絶えず在庫を変動させる。Redis が最新の販売可能数量を Web とモバイルへ提供する。
-
車両追跡と ETA: RTM が GPS 更新を処理して ETA を再計算し、Redis が最新の車両状態を配車側と顧客アプリへ提供する。
-
セキュリティ運用: RTM がイベントを相関させてアクティブなインシデントをまとめ、Redis がアナリストと自動応答のために最新の脅威状態を保持する。
-
運用ダッシュボード: RTM が KPI を継続的に更新し、Redis によってダッシュボードはストリーム処理エンジンにクエリを投げずに最新の指標を読める。
どこでも動かせる
このパターンは特定のクラウドベンダーにも、特定の Redis デプロイ形態にも縛られない。だからスタックのある場所にそのまま乗る。Databricks は AWS、Azure、GCP で動き、Redis はその環境に合った形で組み合わせる。
-
Redis Cloud: AWS、GCP、Azure 上のフルマネージド。運用負担をゼロにしたいチーム向け。
-
Redis Software: オンプレミスの自己管理、または自前の仮想マシンや Kubernetes 上へのデプロイ。厳格なデータレジデンシーやエアギャップ環境の要件がある場合向け。
-
Azure Managed Redis: Redis Enterprise を基盤とする Azure のファーストパーティサービス。ネイティブな Azure 課金、MACC の消化、Entra ID 認証、Azure との深い統合を備える。
Databricks がどこで動いていても、Redis はそのリアルタイム層として機能する。
行動を促す
リアルタイムのパーソナライゼーションは、より大きなパターンの一例にすぎない。継続的な計算は RTM で、即時配信は Redis で行う。Databricks 上でレイテンシに敏感な体験を構築しているなら、この組み合わせによって、別途ストリーム処理エンジンを立てることなく、イベントから意思決定までをミリ秒でつなげられる。このウォークスルーの内容はすべて端から端まで動く。クローンして、自分の Kafka と Redis を指定すれば、イベントが届くたびにレコメンドが更新されるのを確認できる。
-
コードを入手:https://github.com/redis-developer/redis-rtm-personalization-demo
-
Redis Spark Connector(GitHub):redis-field-engineering/redis-spark
-
Databricks Real-Time Mode ドキュメント:docs.databricks.com
-
Redis Cloud を無料で試す:redis.io/cloud
-
Azure Managed Redis:azure.microsoft.com/en-us/products/managed-redis
Philip Laussermair は Redis のグローバル Microsoft テクニカルリードで、Azure Managed Redis と AI/ML の統合を担当している。Anant Pingle は Databricks のシニアスペシャリストソリューションエンジニア。本記事で紹介したのは、両チームが顧客現場でともに観察した新たなパターンであり、Redis と Databricks の協力関係が深まっていることを示すものでもある。