使用 Databricks 和 Redis 实现实时个性化
Spark 的 Real-Time Mode 负责连续计算、Redis 负责毫秒级读取,两者分工把个性化推荐和欺诈评分压进请求路径,文章还配了一个能跑通的示例仓库。
中文
复制
顾客正在浏览一个电商网站。搜索跑鞋、打开商品页、查看评论、将商品加入购物车——每一个动作都是关于他此刻想要什么的信号。如果此时落地的主页还在展示今早那批通用促销,这个时机就错过了。推荐的价值衰减得很快,往往就在同一个会话之内,甚至就在单个页面加载所需的 500 毫秒里。
但在每隔几分钟才刷新一次的传统批处理架构上,抓住实时机会是不可能的。对于设计实时管道的数据工程师和架构师来说,挑战在于弥合分析与行动之间的缺口。按计划刷新的传统管道——每隔几分钟甚至每隔几秒——非常擅长回答“发生了什么”。但个性化、欺诈评分和库存决策必须在顾客还停留在页面上时回答“接下来该发生什么”。这意味着事件到达时就要计算最新状态,并在毫秒级内把它送回应用。
有两件事必须同时成立:处理必须是连续的,服务必须是即时的。过去要做到这一点,就得维护一套复杂的双引擎架构,通常是在现有批处理框架旁边再挂一个 Apache Flink 这样的专用引擎。
为什么 RTM 和 Redis 对实时用例至关重要
Real-Time Mode(RTM)解决的是第一件事:连续处理。Structured Streaming 是 Apache Spark™ 用于连续处理事件流的引擎,用法和你查询一张表一样,只不过这张表永远不会停止更新。它的默认执行模式非常适合高吞吐的 ETL,能容忍从秒到分钟的延迟,但不适合必须落在几十毫秒内的闭环决策。Real-Time Mode 是 Structured Streaming 中较新的执行模式,正是为了补上这个缺口。RTM 采用连续数据流,事件一到就处理,从而实现亚秒级性能,p99 延迟稳定在几十到一百多毫秒。它运行在你已经在写的同一套 Spark API 上,无需搭建 Apache Flink 之类的独立引擎,也就消除了代码库重复和逻辑漂移。
Redis 负责后半段:即时读取。RTM 算出最新的推荐结果、欺诈评分或会话状态之后,应用需要在请求路径上以极高的请求速率、在远低于 1 毫秒内把它读出来。这正是 Redis 的用武之地:
-
高吞吐下亚毫秒级读写
-
灵活的数据模型,如 Hashes、JSON、Streams、TimeSeries 和 Sorted Sets,数据可以按应用需要的形态写入
-
内置 TTL(Time to live)和淘汰机制,让数据保持新鲜、内存保持高效
-
面向生产读取的高可用方案:Redis Cloud 和 Azure Managed Redis 对符合条件的多可用区部署提供服务承诺 99.99%,对符合条件的 Active-Active 部署提供 99.999%;具体适用哪一档取决于产品、方案和拓扑
对于已经把 Redis 用作应用缓存的团队,这套模式是把现有组件扩展成实时读取层,而不必再引入一项技术让应用团队去运维和集成。
分工才是关键。Real-Time Mode 持续从流式事件中计算最新的运行状态,Redis 把这些状态落地为低延迟的读取层,应用便能在毫秒级做出决策、交付个性化体验。计算归计算,读取归读取,各司其职。
iFood 是拉丁美洲领先的外卖平台,每天处理数百万订单,它依托 Databricks Real-Time Mode 和 Redis,在其机器学习平台上支撑大规模实时决策。
“Real-Time Mode 让 Databricks 成为我们实时 Feature Platform 的核心部分。配合 Redis 做在线读取,我们可以持续把流式数据在一秒内转化为可用于生产的特征,同时保持机器学习负载所需的规模和运维简洁性。”
—— Willian Moreira,iFood 首席机器学习平台工程师

用例:在会话内实时调整的推荐
具体一点。我们要做的是随用户浏览不断更新的商品推荐,让用户看到的下一页反映他最近一次的操作,而不是上一轮批处理跑完时的状态。
输入是一条点击流:商品浏览、搜索、加购、下单,每个动作一条消息。输出是每个用户一份持续刷新的推荐商品排序列表,网站每次渲染页面时读取。中间需要保留少量按用户维度的会话状态(最近看过什么),再据此为候选商品打分。
Databricks 和 Redis 怎么搭
架构
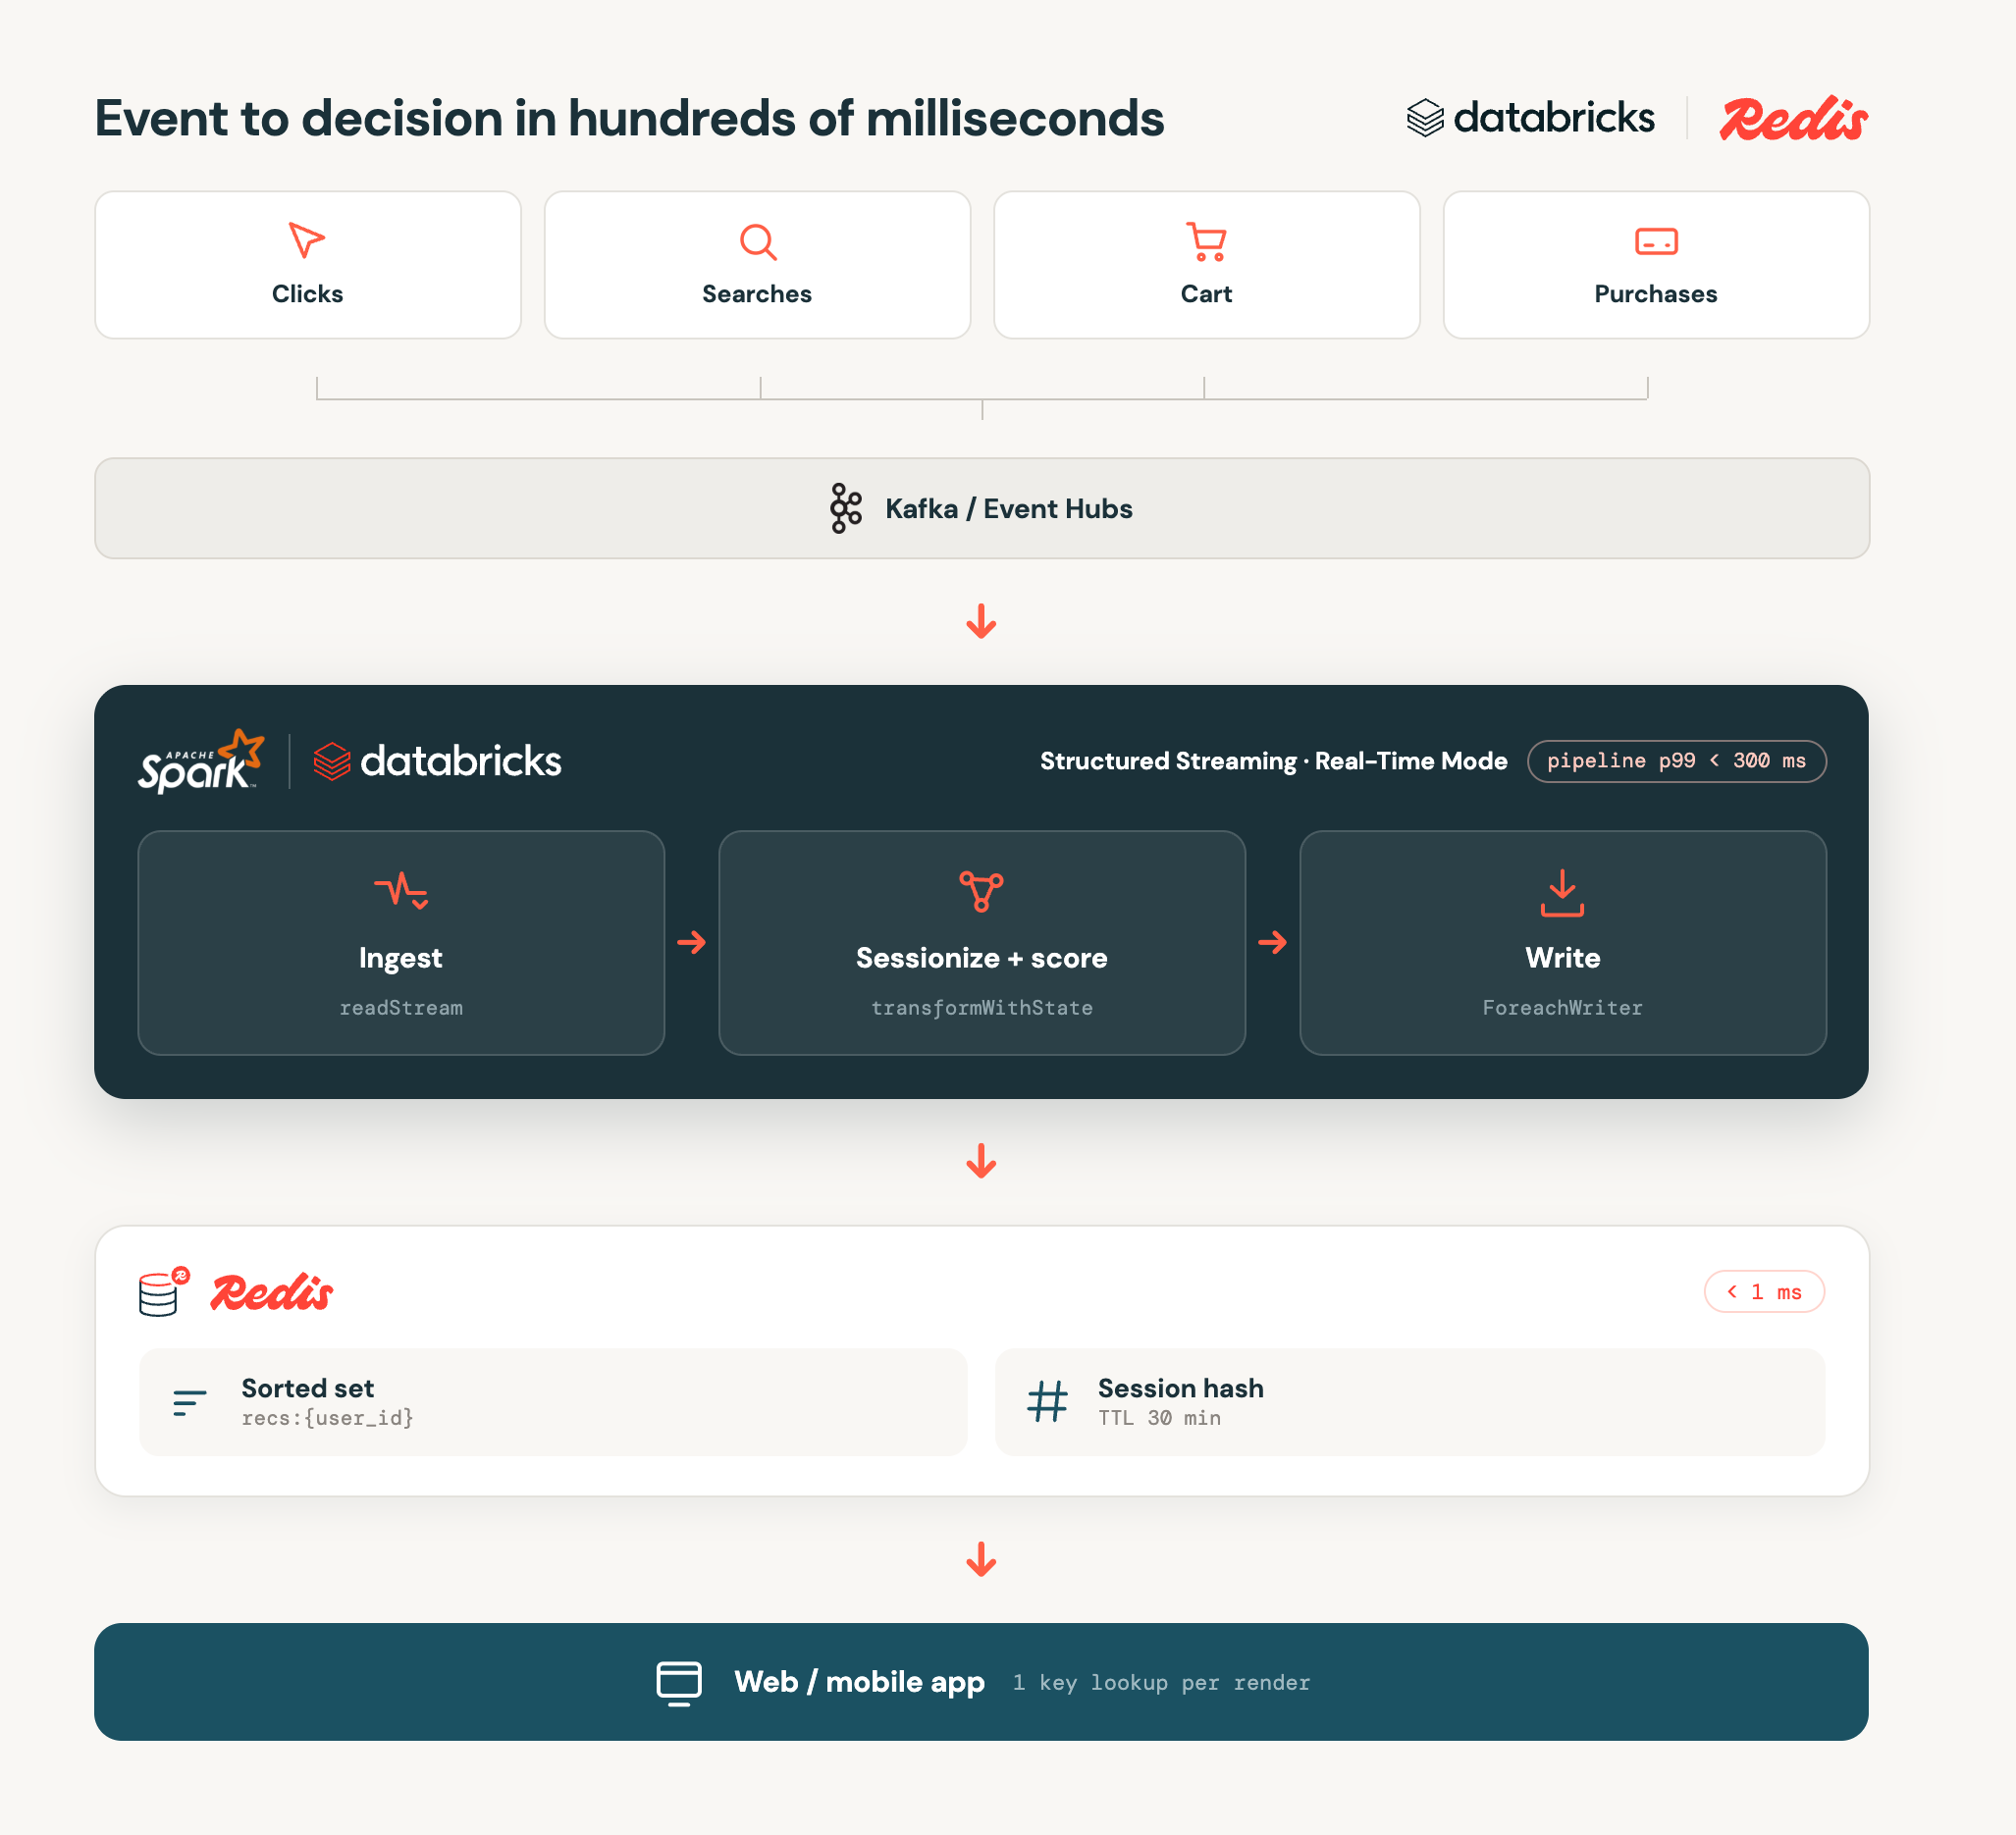
点击流先进 Kafka。RTM 管道读取它,维护每个用户的会话状态,用这个状态给候选商品打分,把排序结果写进 Redis。网站每次渲染页面读一个 Redis key。
第 1 步:读取点击流
普通的 Structured Streaming,这里还没有 RTM 特有的东西。
events = (spark.readStream.format("kafka")
    .option("subscribe", "clickstream")
    .option("kafka.bootstrap.servers", BROKERS)
    .load()
    .select(from_json(col("value").cast("string"), EVENT_SCHEMA).alias("e"))
    .select("e.*"))    # user_id, event_type, product_id, category, ts
第 2 步:切分会话并打分
每个用户只保留少量状态:对他接触过的每个商品记一个按时间衰减的分数。每个事件给它涉及的商品加分,权重取决于意图(下单比浏览权重大),所有分数随时间衰减,让近期的兴趣压过旧的。整个实时路径上只有一个带 key 的有状态算子,一次 shuffle。
EVENT_WEIGHTS = {"view": 1.0, "search": 1.5, "cart": 4.0, "purchase": 8.0}

def decay(score, last_seen_ms, now_ms):          # halves every HALF_LIFE_SECONDS
    return score * 0.5 ** ((now_ms - last_seen_ms) / 1000 / HALF_LIFE_SECONDS)

class ProductAffinity(StatefulProcessor):
    def init(self, handle):
        # the user's whole affinity map, held as one JSON-encoded state value
        self.state = handle.getValueState("affinity", "payload STRING")

    def handleInputRows(self, key, rows, timerValues):     # once per row in RTM
        now = timerValues.getCurrentProcessingTimeInMs()
        v = self.state.get()
        m = json.loads(v[0]) if v else {}                  # 1 state read: whole map
        for r in rows:
            old = m.get(r.product_id)
            score = (decay(old[0], old[1], now) if old else 0.0) + EVENT_WEIGHTS[r.event_type]
            m[r.product_id] = [score, now]
        ranked = sorted(((p, decay(s, ts, now)) for p, (s, ts) in m.items()),
                        key=lambda kv: kv[1], reverse=True)
        ranked = [(p, s) for p, s in ranked if s >= SCORE_FLOOR][:MAX_TRACKED]
        self.state.update((json.dumps({p: [s, now] for p, s in ranked}),))   # 1 state write
        yield emit(key[0], ranked[:TOP_N], now)            # per-event: top-10 to Redis

recommendations = (events
    .groupBy("user_id")
    .transformWithState(ProductAffinity(), OUTPUT_SCHEMA,
                        outputMode="update", timeMode="processingTime"))
这里的打分刻意做得很简单:给近期行为加权,再对商品排序,换成完整模型也是插在同一个位置。在生产环境里,这类兴趣分通常会喂给 ML 排序模型,或者干脆被它取代,前面再加一步候选生成,把用户还没见过的商品捞出来。下面的基准测试中,我们是通过 Kafka 接口对接 Azure Event Hubs 跑这条管道的;配套仓库里包含了那条 Kafka 管道。
第 3 步:用 ForeachWriter 写入 Redis
这里有一个真正要紧的集成细节。从 Spark 写 Redis 有两种方式。Redis Spark Connector 是用经典 Structured Streaming 对接 Redis 最省事的办法。Real-Time Mode 更新,目前 connector 还没覆盖它,所以在 RTM 下要通过 ForeachWriter 写——这是 Spark 面向自定义目标的标准 sink(是 foreach sink,不是 foreachBatch,后者本质上还是微批)。我们把每个用户的推荐存成共享同一个 slot 的两个 key:一个 sorted set(商品到分数)存排序,一个 hash 存每个商品的标题和价格。两者都设短 TTL,过期会话自己就清掉了。写入时先缓冲用户,再以流水线批量提交,减少往返次数。
class RedisSink:
    def open(self, partition_id, epoch_id):
        import redis
        self.r = redis.Redis(host=HOST, port=PORT, password=PWD, ssl=True)
        self.buffer = []
        return True

    def _queue(self, pipe, user_id, recs):           # stage one user's full replace
        key = f"recs:{{{user_id}}}"                   # {..} = Redis Cluster hash tag
        meta = f"{key}:meta"
        pipe.delete(key, meta)
        pipe.zadd(key, {r.product_id: r.score for r in recs})
        pipe.hset(meta, mapping={r.product_id: f"{r.title}|{r.price}" for r in recs})
        pipe.expire(key, TTL); pipe.expire(meta, TTL)

    def process(self, row):
        self.buffer.append((row.user_id, list(row.recs)))
        if len(self.buffer) >= FLUSH_EVERY:
            self._flush()

    def _flush(self):
        pipe = self.r.pipeline(transaction=False)
        for user_id, recs in self.buffer:
            self._queue(pipe, user_id, recs)
        pipe.execute()
        self.buffer = []

    def close(self, error):
        if self.buffer:
            self._flush()
        self.r.close()

query = (recommendations.writeStream
    .foreach(RedisSink())
    .trigger(realTime="5 minutes")   # enables RTM (Scala: RealTimeTrigger.apply("5 minutes"))
    .outputMode("update")            # RTM requires update mode
    .start())
一条生产环境注意事项:demo 里的 pipe.execute() 会发送缓冲的命令,并等待 Redis 确认写入。在高负载下不要把它换成 fire-and-forget;未确认的写入会静默丢失,对服务层来说,这意味着推荐结果过期了却没人发现。
第 4 步:应用读取
网站每次渲染只做一次 pipeline 往返:从 sorted set 取排序后的 id,再从 hash 取对应的标题和价格。没有 Spark 查询,没有表扫描,只有亚毫秒级的 Redis。
key  = f"recs:{{{user_id}}}"
top  = r.zrevrange(key, 0, 9, withscores=True)   # ranked product ids + scores
meta = r.hgetall(f"{key}:meta")                  # product_id -> "title|price"
客户一点击,下一页就会反映出来。电商场景只是背景。我们真正想展示的是计算和服务端到端协同工作。
性能
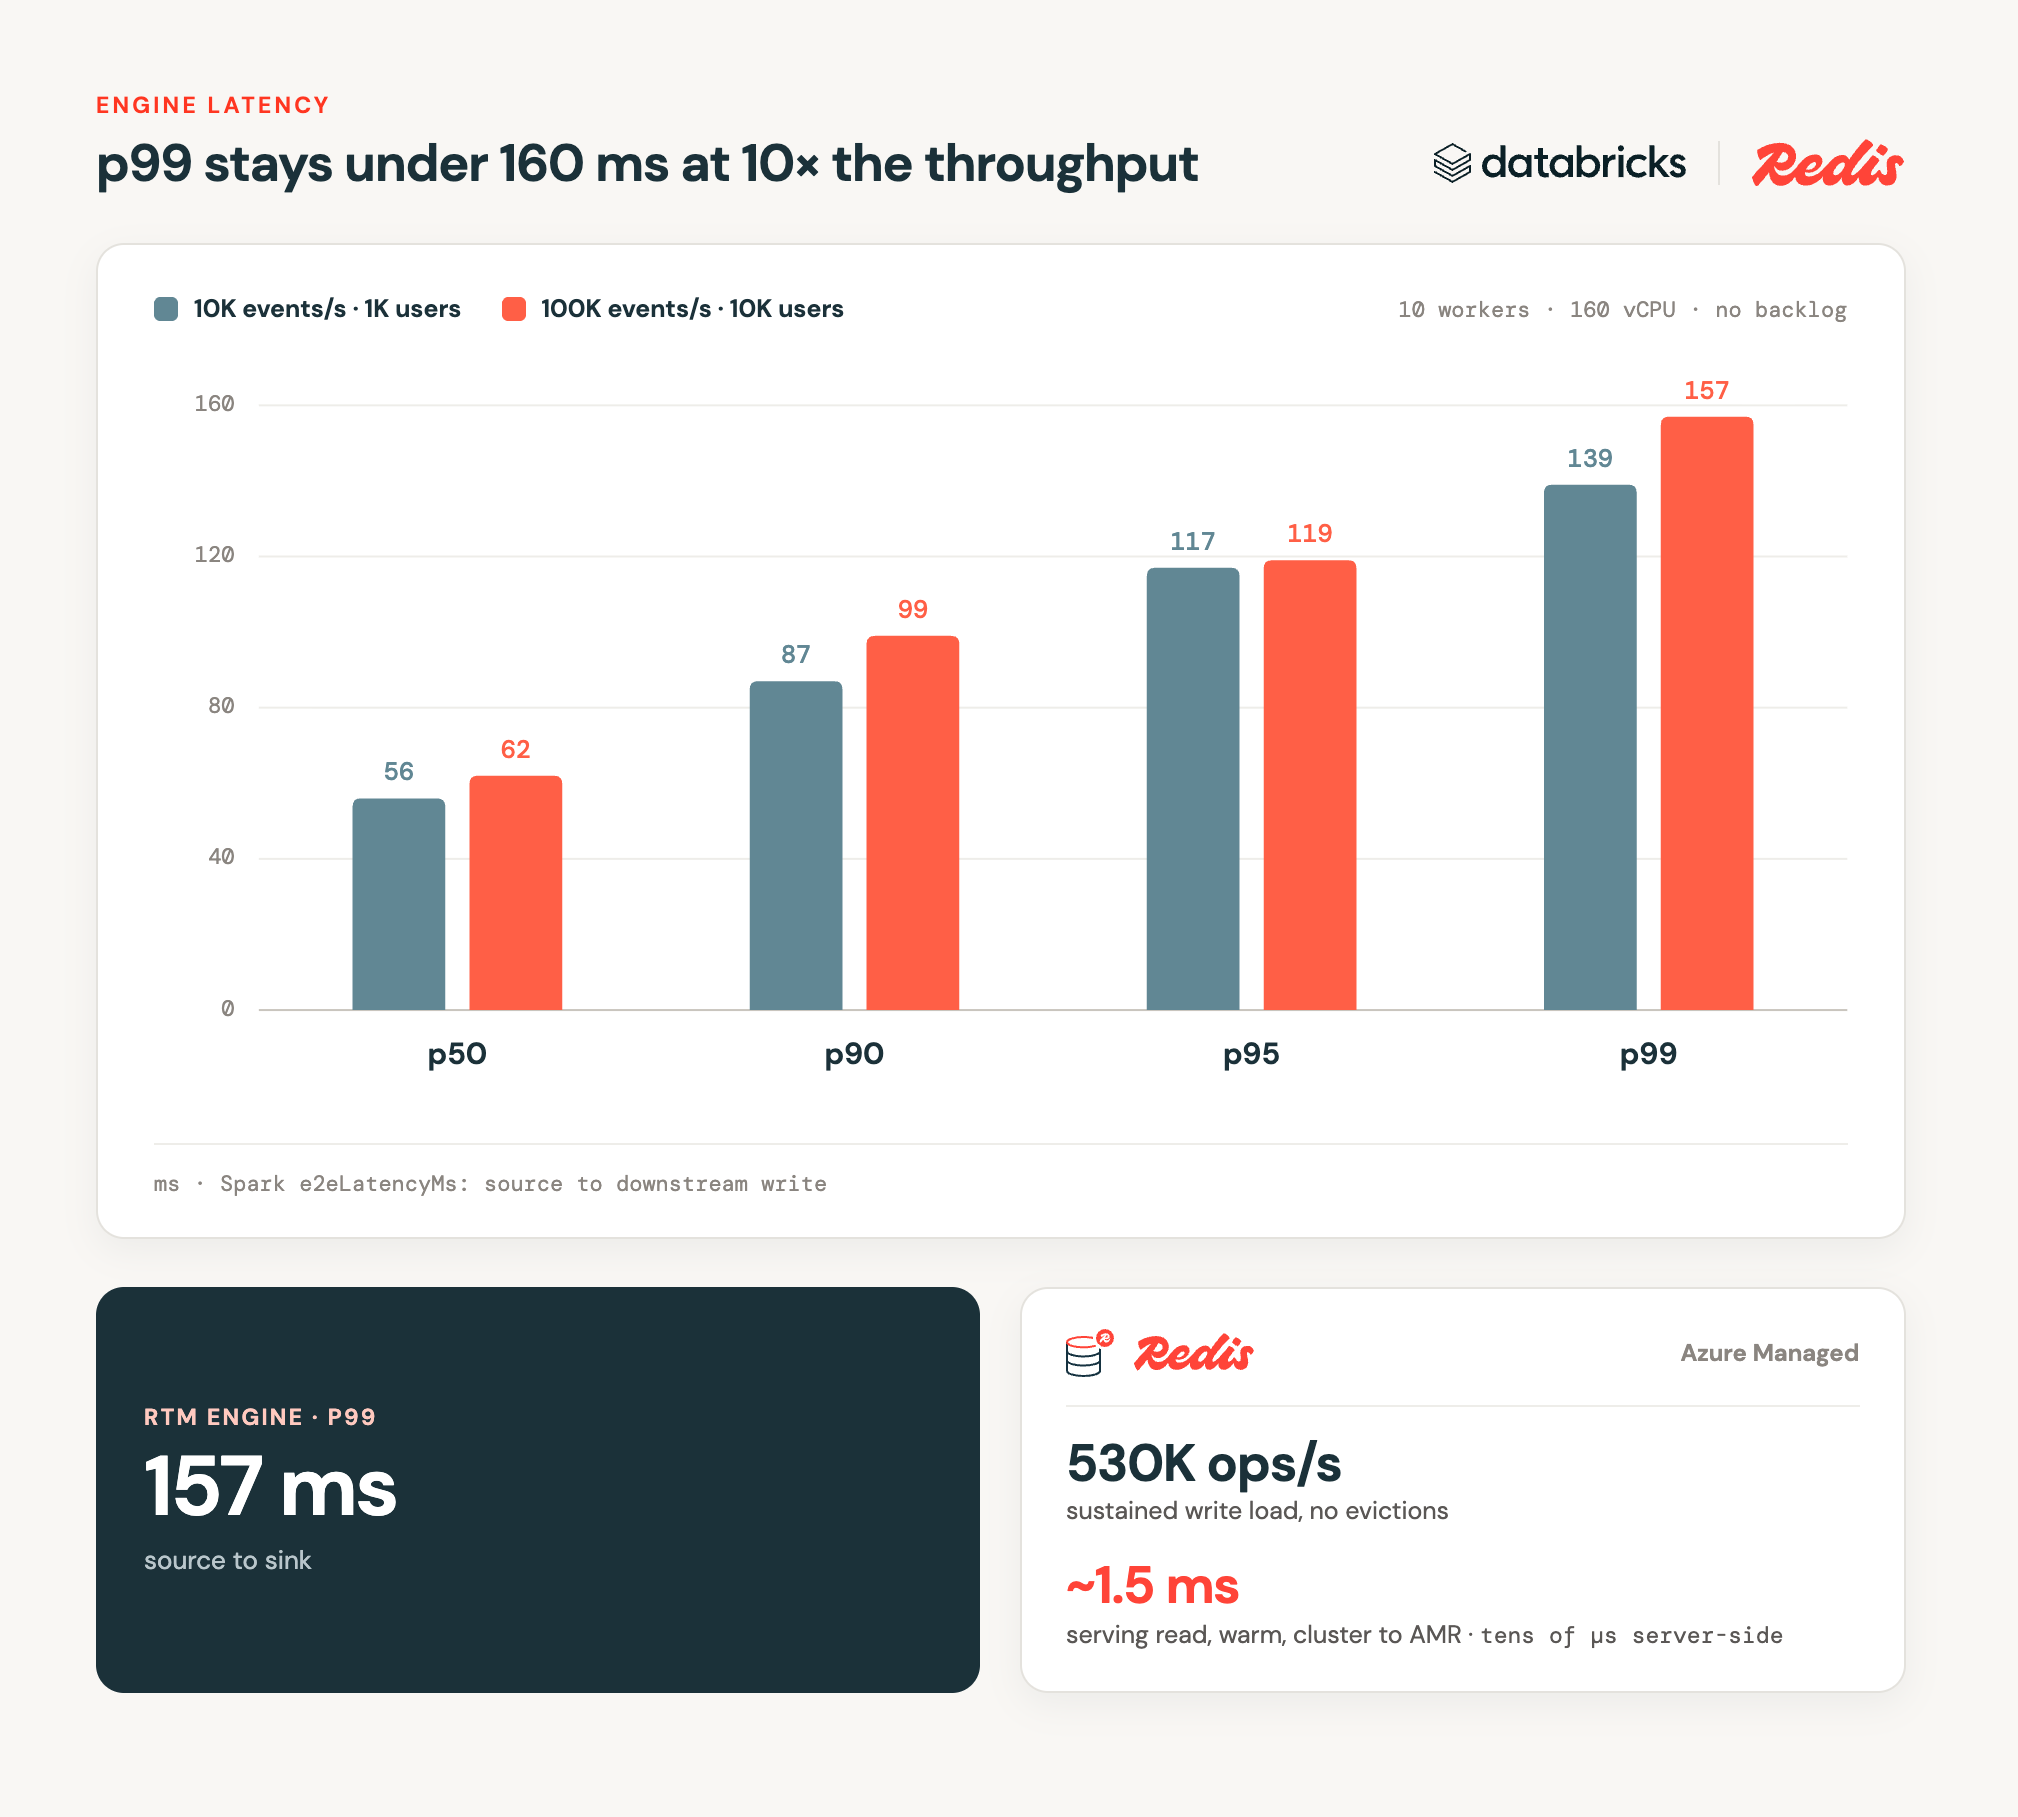
我们持续对 Azure Managed Redis 运行这条 pipeline,在 10 个 worker 的集群(160 vCPU)上、10,000 名活跃用户的情况下,稳定支撑每秒 100,000 个点击流事件,没有积压。单用户状态始终有界,Redis 轻松承受写入负载,大约每秒 530,000 次操作,没有发生 eviction。
从点击到推荐返回:p99 低于 160 ms
| 指标 | 10k 事件/秒 | 100k 事件/秒 |
|---|---|---|
| p50 | 56 ms | 62 ms |
| p90 | 87 ms | 99 ms |
| p95 | 117 ms | 119 ms |
| p99 | 139 ms | 157 ms |
用例的广阔空间
同一个模式(RTM 计算最新状态,Redis 在毫秒级把它提供出去)在各行各业都能见到。换掉事件和打分逻辑,形态不变。
-
支付欺诈检测:RTM 丰富交易数据并计算欺诈分数;Redis 在授权前把最新分数提供给支付网关。
-
多智能体协同:RTM 持续处理智能体事件、工具结果和工作流更新,推导出共享状态;Redis 让这个状态立即可用,智能体据此协同、交接工作,避免动作冲突。
-
实时 ML 特征服务:RTM 持续计算滚动特征(近期消费、点击率、会话活跃度),Redis 把最新特征向量提供给在线推理。
-
动态库存:订单、退货和仓库更新不断改变库存;Redis 将最新可售数量提供给网页端和移动端。
-
车队追踪与 ETA:RTM 处理 GPS 更新并重新计算 ETA;Redis 将最新车辆状态提供给调度端和客户应用。
-
安全运营:RTM 将事件关联为活跃事件;Redis 为分析师和自动响应保存最新威胁状态。
-
运营仪表盘:RTM 持续更新 KPI;Redis 让仪表盘无需查询流处理引擎即可读取最新指标。
随处运行
这套模式不绑定某一家云厂商,也不绑定某一种 Redis 部署方式,因此你的技术栈在哪里,它就能落在哪里。Databricks 可运行在 AWS、Azure 和 GCP 上,Redis 则以适合该环境的形式与之配合:
-
Redis Cloud:在 AWS、GCP 或 Azure 上全托管,适合希望零运维负担的团队。
-
Redis Software:本地自管,或部署在你自己的虚拟机和 Kubernetes 上,适合有严格数据驻留或气隙环境要求的场景。
-
Azure Managed Redis:由 Redis Enterprise 提供支持的 Azure 一方服务,具备原生 Azure 计费、MACC 抵扣、Entra ID 认证以及与 Azure 的深度集成。
无论 Databricks 运行在哪里,Redis 都能充当其实时层。
行动号召
实时个性化只是更广泛模式的一个实例:用 RTM 做持续计算,用 Redis 做即时服务。如果你正在 Databricks 上构建对延迟敏感的体验,这一组合能让你在毫秒内从事件走到决策,而无需另建一套流处理引擎。本演练中的所有内容都能端到端跑通:克隆下来,指向你的 Kafka 和 Redis,然后看着推荐结果随事件到达而更新。
-
获取代码:https://github.com/redis-developer/redis-rtm-personalization-demo
-
Redis Spark Connector(GitHub):redis-field-engineering/redis-spark
-
Databricks Real-Time Mode 文档:docs.databricks.com
-
免费试用 Redis Cloud:redis.io/cloud
-
Azure Managed Redis:azure.microsoft.com/en-us/products/managed-redis
Philip Laussermair 是 Redis 的全球 Microsoft 技术负责人,专注于 Azure Managed Redis 与 AI/ML 集成。Anant Pingle 是 Databricks 的资深专家解决方案工程师。本文所呈现的,是双方团队在客户现场共同观察到的一种新兴模式,也体现了 Redis 与 Databricks 日益深入的合作。
来源: Redis Blog← 返回首页