「Jevより1年早い」という主張は、論文と229問の結果と噛み合わない
Nandakishor Mukkunnothは2025年3月にJevの非自己回帰意思決定モデルを作り、それについて長い記事を書いたと述べている。私は彼が引用した2本の論文を読み、彼の2026年のモデルを229問の細粒度問題で走らせたが、見えたものはこの話とは少し違っていた。
日本語
コピー
Nandakishor Mukkunnoth は、Jev の非自己回帰型意思決定モデルを自分が 2025 年 3 月に作っていた、TypeSafe より 1 年早い、と言って、そのための非常に長い不満の文章を書いた。彼が引用した 2 本の論文を読み、彼の 2026 年のモデルを我々の凍結した 229 問で走らせてみた。
先月、Nandakishor Mukkunnoth が r/LocalLLaMA と DEV に同じ長文を投稿した。タイトルを直訳すると「私は 1 年前に非自己回帰型意思決定モデルを作った。そしてフロンティアラボがそれをブレイクスルーと呼んだ」となる。感情は露骨に書かれている。2025 年 3 月に彼は論文を出し、重みを公開した。それに対し TypeSafe AI が 2026 年 9 月に Jev をリリースしたとき、「テキストを生成せず、確率付きの型付き判断だけを返す」その仕組みはまったく新しい科学的ブレイクスルーとして扱われ、しかもクローズドソースでのリリースで、論文も重みも訓練データもなかった。
この不満の半分には同意する。資金を調達したラボが、すでに誰かがオープンソースで出していたアイデアをブレイクスルーとして再パッケージするのは、確かに気分が悪い。だがもう半分は資料を見る必要がある。「私は同じアーキテクチャを 1 年早く作った」という一文について、Mukkunnoth が引用したものを一つずつ開いて読んだところ、結論はこの一文より複雑だった。
タイムライン自体は明確だ。
- 2025 年 3 月 30 日、Mukkunnoth が arXiv:2503.23303 を投稿。タイトルは SalesRLAgent で、営業会話における成約確率の予測を行う。
- 2025 年 9 月 23 日、2 本目の arXiv:2510.01237。信頼度に応じたルーティングで、確信度に応じてクエリをローカル生成、検索拡張、より大きなモデル、あるいは人間に振り分ける。
- 2026 年 9 月 15 日、TypeSafe AI が Jev をリリース。
- 2026 年、Mukkunnoth 自身が現在のモデルを作った。421M パラメータ、ModernBERT-large エンコーダに決定ヘッドを載せたもので、名前は Laya。
タイムライン上、彼が早いのは確かだ。問題は、何が早かったのかである。
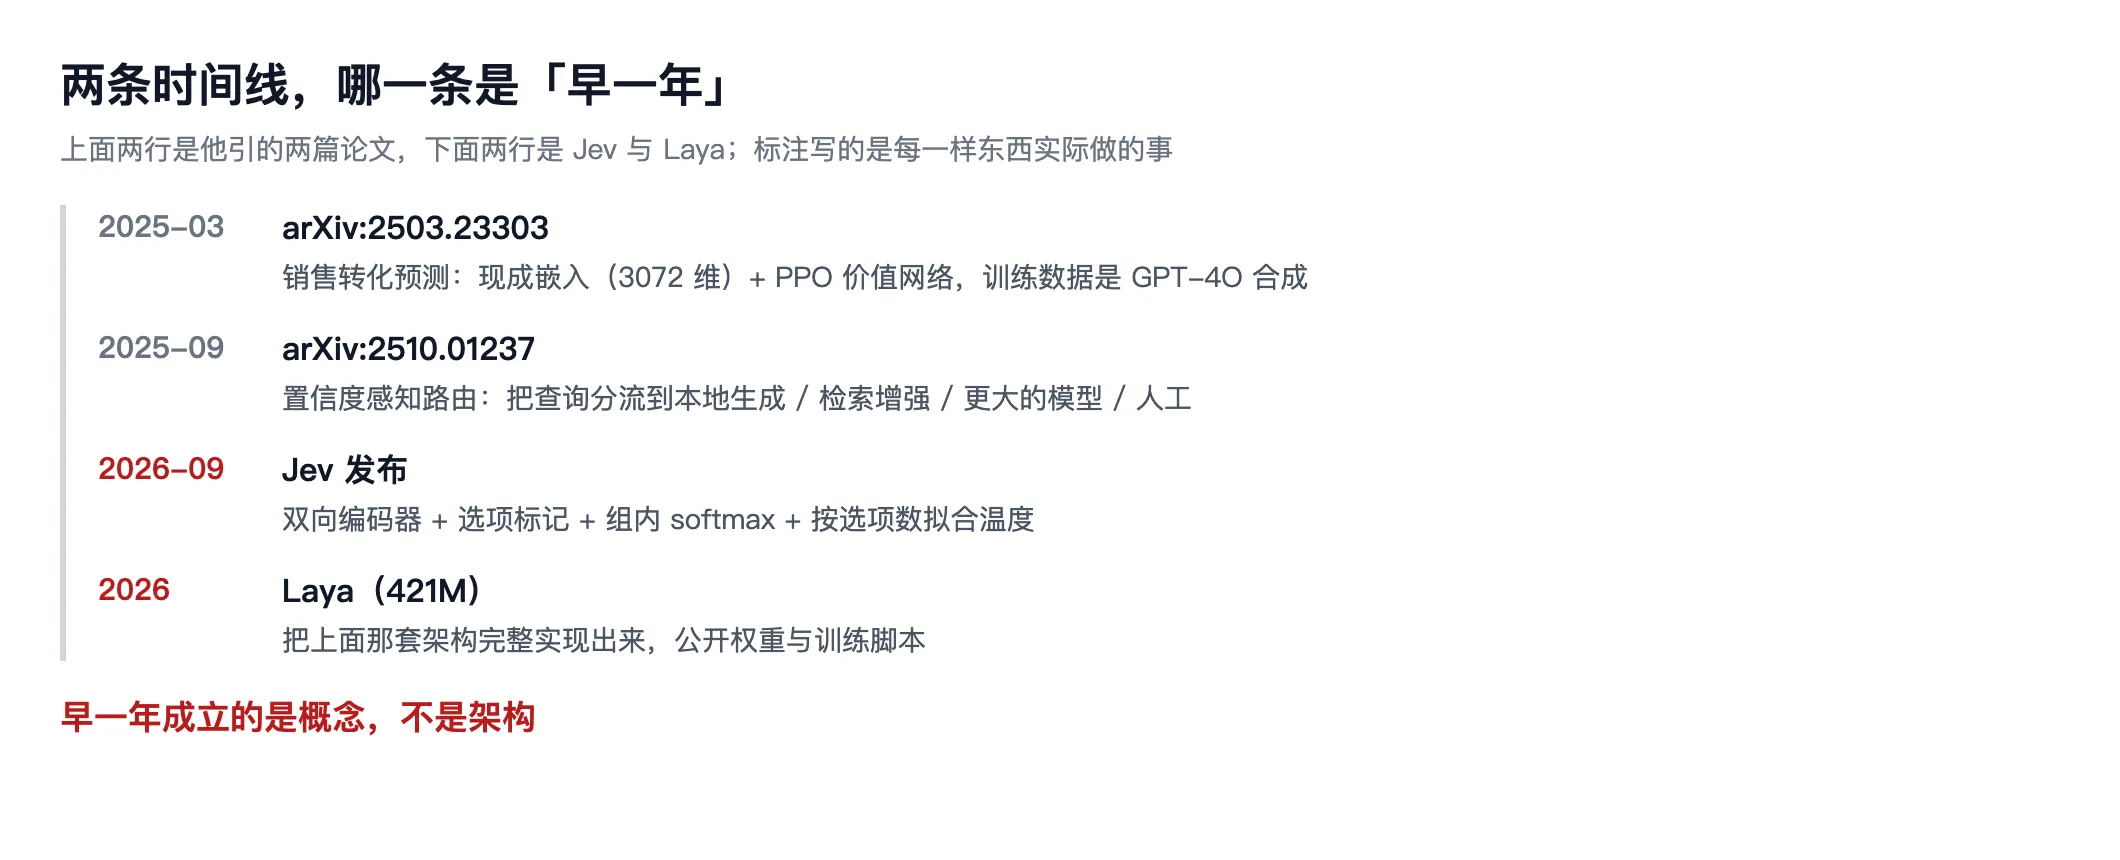
第一篇の要旨は逐句読んだ。変換予測を系列決定問題として扱い、Azure OpenAI の 3072 次元埋め込みを使い、訓練データは GPT-4O の合成だ。これは「既製の埋め込み+強化学習」という垂直な解であり、後に出てくる「双方向エンコーダ、各選択肢の前に [MASK] トークンを置き、選択肢グループ内で softmax を取る」アーキテクチャではない。
Mukkunnoth 自身、あの長文でこれを認めている。2025 年 3 月の箇所を書くとき、同氏は「凍結した系列埋め込みに独立した PPO 価値ネットワークを組み合わせたもの」と述べ、これはエンドツーエンドではなく、実行時に動的な新しい問題を扱うこともできないと書いている。
第二篇はもっと遠い。主題はクエリを 4 本の異なる生成経路にルーティングするもので、schema の意思決定フレームワークではない。Mukkunnoth は長文で、この論文が「schema ベースの意思決定フレームワークの正確な形式を与えている」と述べているが、要旨と構成を読んだ限り、見えるのはルーティングとハルシネーション緩和であって、選択肢トークンとグループ内確率の話ではない。
つまり論文に厳密に沿って見れば、1 年早く成立していたのは概念の層だ。非自己回帰、強化学習で訓練、確率校准を要求する、この 3 点は 2025 年の論文に確かに書かれている。一方、Jev の具体的なアーキテクチャの形——選択肢トークン、グループ内 softmax、選択肢数に応じた温度のフィッティング——が現れたのは 2026 年、Jev の公開後だ。Mukkunnoth 自身も長文で、古い論文の内容から「アーキテクチャ上の制約を一つ残らず潰した」うえで作り直したと述べている。
併せて読む価値があるのは第三者の分析 Decoding Jev だ。Jev はオープンソースではないため、この分析は Jev に関する主張と自分が読めるコードを分けて注記し、Laya の公開コードを参照しながら、意思決定モデルのテンソルフロー、バッチ推論、RLCD の数式を一通り導出している。
そこには私も同意する判断が二つある。第一に、直接分類そのものは新しくない。BERT は 2018 年にはテキストを生成せずラベル確率を直接返していたのだから、非自己回帰の分類それ自体は新規性にならない。第二に、Laya は独立したオープンな意思決定モデルであり、Jev が公開したアーキテクチャではない。この分析はついでに 150 段落の比較テストも記録していて、Jev と Haiku がともに 66%、Sonnet が 71.3% だった。
ここまでで、私は誰もやっていないことを二つやった。一つ目は Laya を我々の凍結した 229 問で走らせることだ。この問題群は細粒度の原文一致チェックで、数字を一桁変え、実体を一つ入れ替え、方向を反転させ、モデルは「この文は原文と一致するか」を判定する。正解は確定している。
結果は 4 つの再現のうち最も低かった。
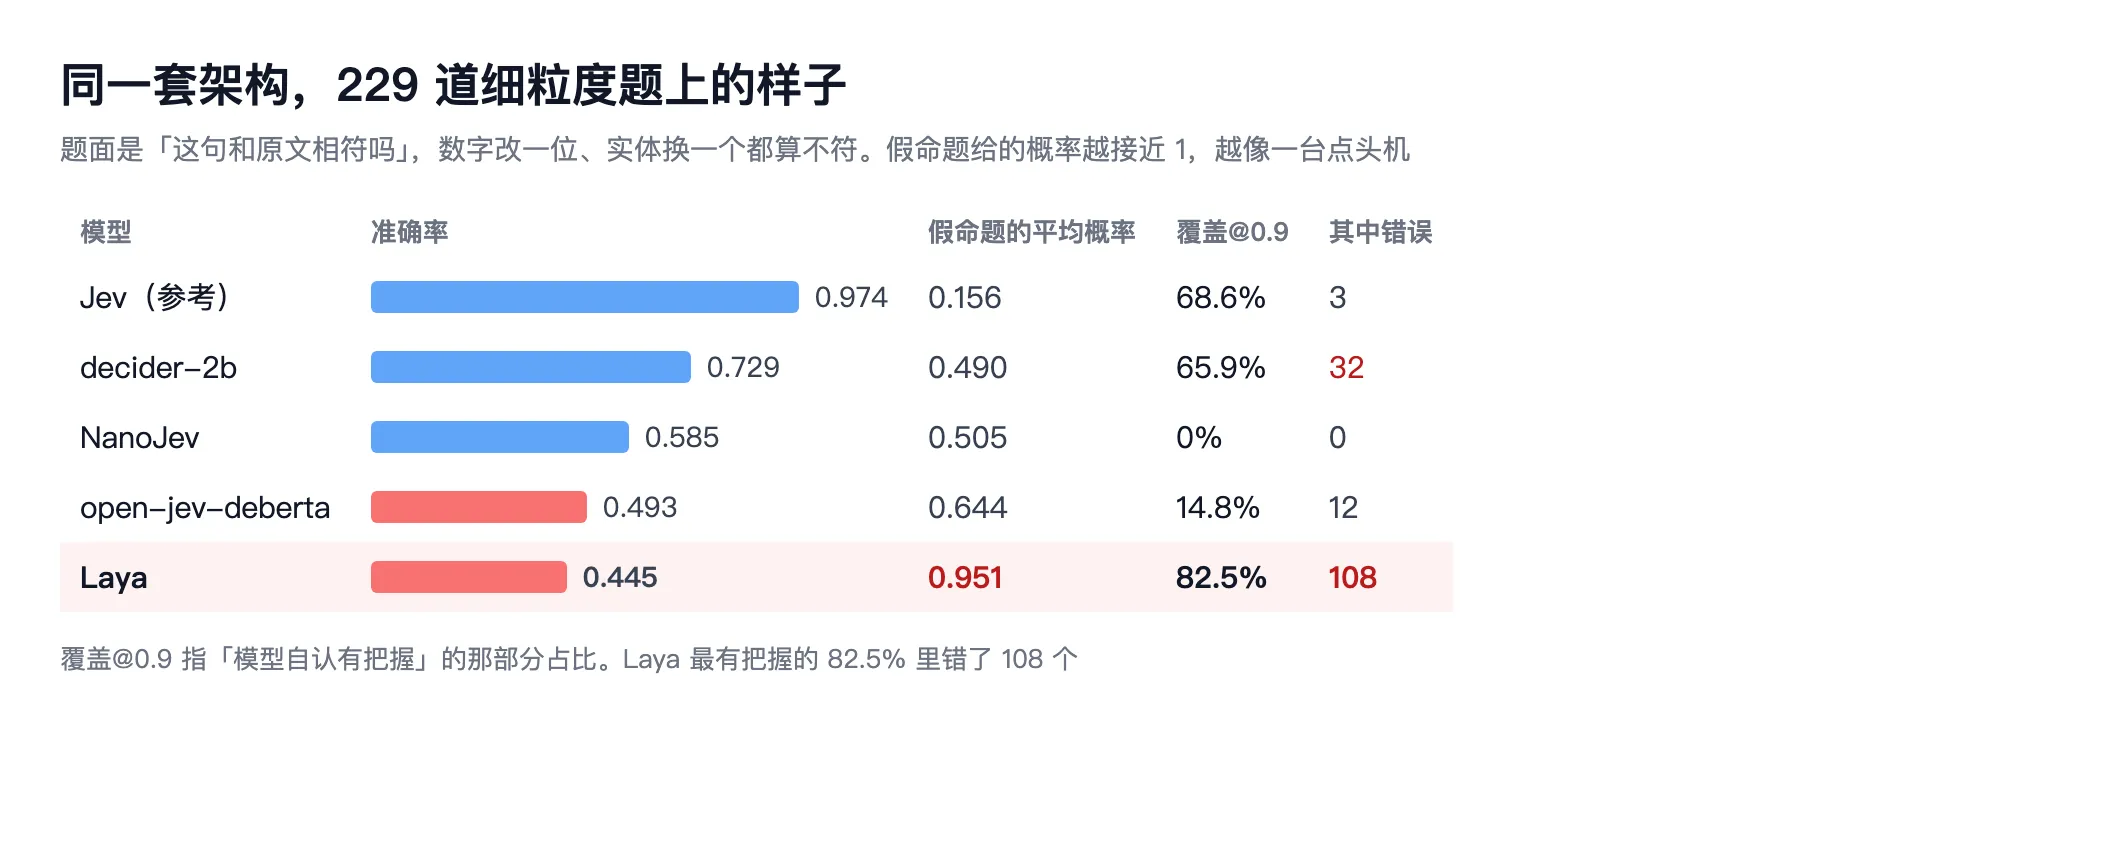
精度より最後の2列のほうが問題を示している。偽の命題に与えた平均確率は0.951、真の命題には0.945。つまり、ほぼ何にでも「はい」と言っている。閾値0.9で最も自信のある82.5%を選び出すと、その中に108個の誤りがあった。キャリブレーション誤差0.503は、私が測定したモデルの中で最悪だ。
Laya自身のモデルカードには別の数字が並んでいる。タスク内マクロ平均精度83.8%、意図とカスタマーサポートのルーティング99.1%、メールトリアージ73.2%、そしてJevとの項目別比較表も添えられている。この2組の数字は矛盾しない。問題がまったく違うからだ。Layaの強みはルーティング、分類、トリアージのような粗い粒度の判断にあり、私が与えたのは1つの数字をじっと見張る必要がある細かい粒度の検査だった。同じアーキテクチャがこの2種類のタスクでこれほど差が出るという事実こそ、1つのことを示している。難しさはアーキテクチャの中にはない。
双方向エンコーダ、選択肢マーキング、グループ内softmax、温度フィッティング、これらはすべて公開された工学だ。Mukkunnoth自身、長文の中で構造全体、テンソルの形状、act/escalateヘッドに使う4つの分布特徴まで書き出している。タスクの選び方が正しいか、データが足りているか、確率が独立したデータでキャリブレーションされているか、この3つが分水嶺だ。
優先権より問題をよく示していると思う細部が1つある。Mukkunnothの2025年の論文では、訓練データはGPT-4Oが合成したものだった。一方、2026年のLayaのモデルカードには「100%人手アノテーションの実データセット、合成的ショートカットはゼロ」と書かれている。合成データから人手アノテーションへ、この一歩は本物の進歩であり、この1年で最も価値のある蓄積でもある。だがそれは「誰が先にこの概念を発表したか」とは別の話だ。
Mukkunnothの不満は半分は妥当だ。クローズドソースの製品がオープンソース化されたアイデアを語る、この点は指摘に値する。しかし「私は1年前に同じアーキテクチャを作った」は論文を見る限り支持できない。早かったのは概念であって、そのアーキテクチャではない。しかも彼自身の現在のモデルも2026年に作り直されたものだ。
読者にとってより問う価値があるのは別の問題だ。このアーキテクチャはあなたのタスクで機能するのか。私が測定した答えはこうだ。同じものが細かい粒度のタスクに置かれると崩れる。崩れる場所はデータとタスクにあり、アーキテクチャにはない。Layaは今オープンで、ローカルで動かせて、訓練スクリプトも公開されている。あなたがやろうとしているのがルーティングとトリアージなら、試す価値はある。ある文が原文と1つの数字だけ違うかどうかを判定したいなら、使うな。
Decoding Jev · arXiv:2503.23303 · arXiv:2510.01237 · Laya モデルカード