他说自己比 Jev 早一年,论文和 229 道题都对不上
Nandakishor Mukkunnoth 说他在 2025 年 3 月就做出了 Jev 那套非自回归决策模型,为此写了一篇很长的 文章。我读了他引的两篇论文,也把他 2026 年的模型拿 229 道细粒度题跑了一遍,看到的和这个故事不太一样。
中文
复制
Nandakishor Mukkunnoth 说,他在 2025 年 3 月就做出了 Jev 那套非自回归决策模型,比 TypeSafe 早一年,为此写了一篇很长的不平之文。我读了他引的两篇论文,也把他 2026 年的那个模型拿我们冻结的 229 道题跑了一遍。
上个月,Nandakishor Mukkunnoth 在 r/LocalLLaMA 和 DEV 上发了同一篇长文,标题直译过来是《我在一年前就做了非自回归决策模型,然后一家前沿实验室把它叫做突破》。他的情绪写得很直白。2025 年 3 月他发了论文、放出了权重,而 TypeSafe AI 在 2026 年 9 月发布 Jev 时,那套「不生成文本、只返回带概率的类型化判断」的东西被当成全新的科学突破,而且是闭源发布,没有论文、没有权重、没有训练数据。
这个抱怨有一半我认同。一个拿了融资的实验室把已经有人开源过的想法重新包装成突破,确实让人不舒服。但另一半需要看材料,「我早一年做了同一套架构」这句话,我把 Mukkunnoth 引的东西逐个打开读了,结论比这句话复杂。
时间线本身很清楚。
- 2025 年 3 月 30 日,Mukkunnoth 提交了 arXiv:2503.23303,标题是 SalesRLAgent,做销售对话里的转化概率预测。
- 2025 年 9 月 23 日,第二篇 arXiv:2510.01237,做的是置信度感知路由,按把握程度把查询分流到本地生成、检索增强、更大的模型或者人工。
- 2026 年 9 月 15 日,TypeSafe AI 发布 Jev。
- 2026 年,Mukkunnoth 自己做出了现在的模型,421M 参数,ModernBERT-large 编码器加一个决策头,名字叫 Laya。
时间线上他确实早。问题在于早的是什么。
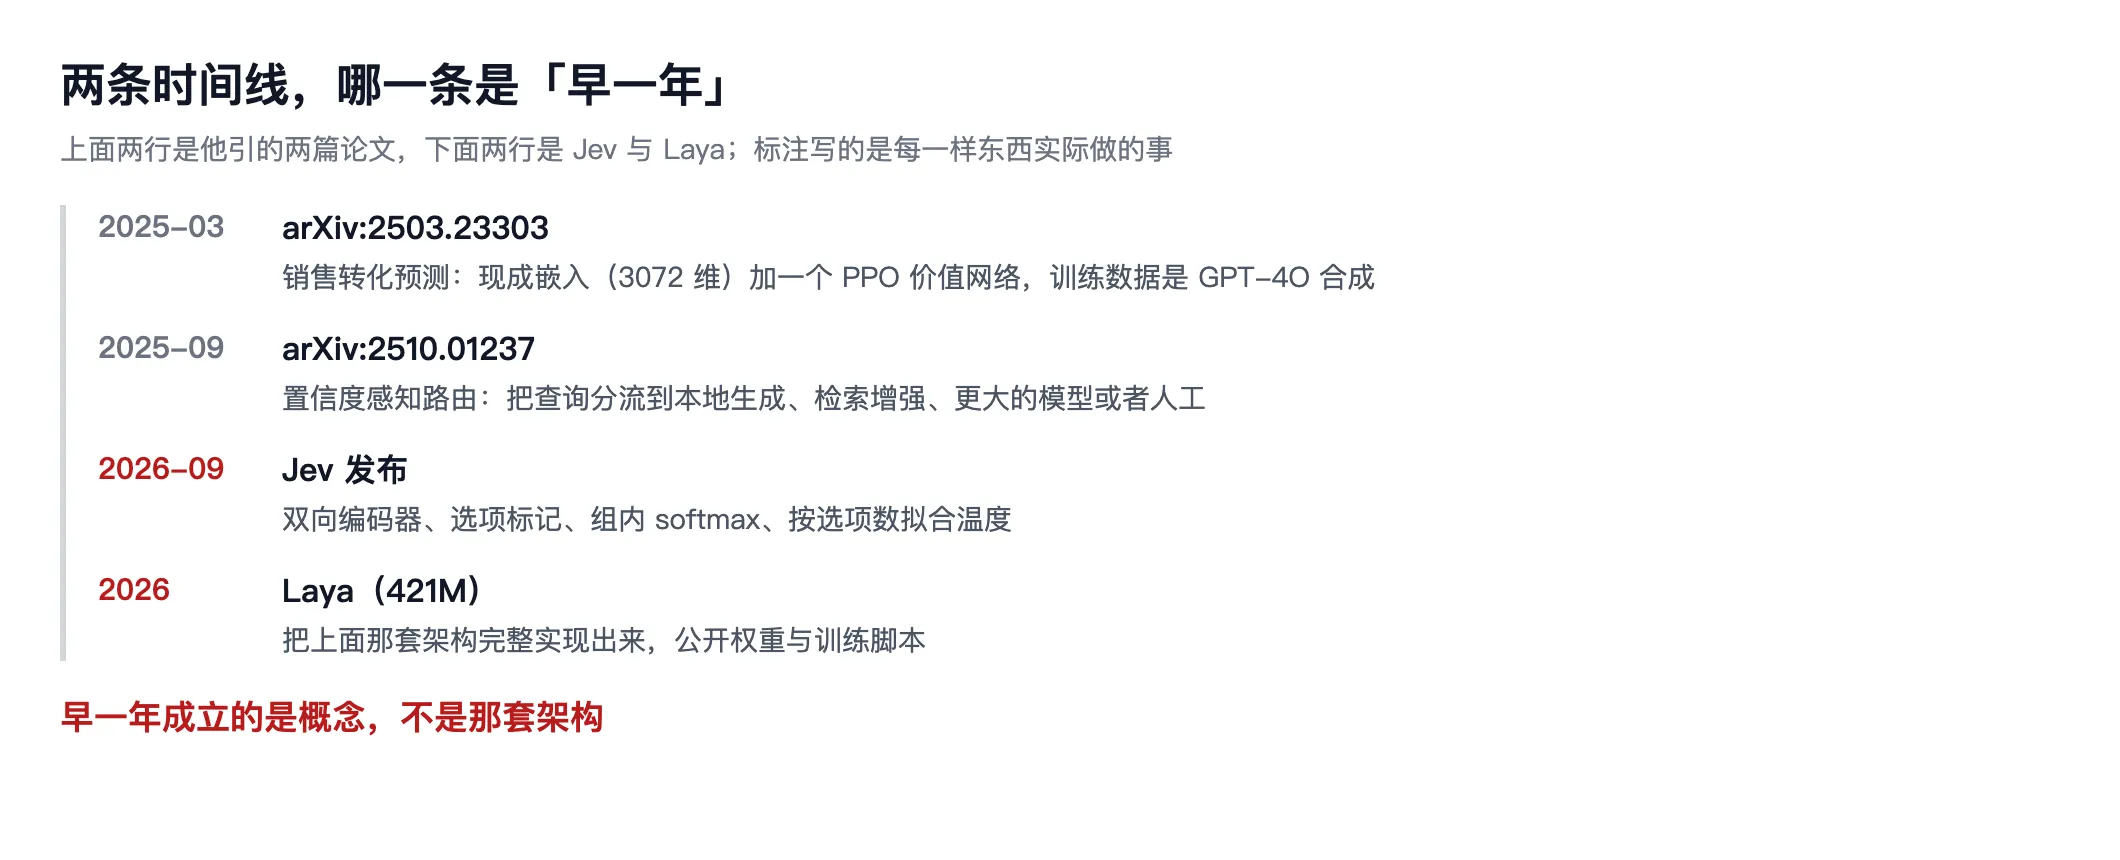
第一篇的摘要我逐句读了。它把转化预测当作序列决策问题,用 Azure OpenAI 的 3072 维嵌入,而且训练数据是 GPT-4O 合成的。这是一条「现成嵌入加强化学习」的垂直方案,不是后来那套「双向编码器,每个选项前面放一个 [MASK] 标记,再在选项组内做 softmax」的架构。
Mukkunnoth 自己在那篇长文里也承认了这件事。他写 2025 年 3 月那一段时,用的是「冻结的序列嵌入加一个独立的 PPO 价值网络」,并说这套东西不是端到端的,也不能在运行时处理动态的新问题。
第二篇更远一点。它的主题是把查询路由到四条不同的生成路径,不是 schema 决策框架。Mukkunnoth 在长文里说这篇「给出了基于 schema 的决策框架的精确形式」,但我读完摘要和结构,看到的是路由和幻觉缓解,不是选项标记和组内概率那一套。
所以严格按论文看,早一年成立的是概念那一层。非自回归、用强化学习训、要求概率校准,这三件事在 2025 年的论文里确实写了。而 Jev 那套具体的架构形状,选项标记、组内 softmax、按选项数拟合温度,是 2026 年才出现的,Jev 发布之后。Mukkunnoth 自己也在长文里说了,是把旧论文里的东西「修掉每一个架构限制」之后重新做的。
值得一并读的是一份第三方分析,Decoding Jev。Jev 没开源,所以它把关于 Jev 的说法和自己读得到的代码分开标注,用 Laya 的公开代码当参照,把决策模型的张量流、批量推理和 RLCD 的数学推了一遍。
它给了两个我认同的判断。第一,直接分类这件事本身不新,BERT 在 2018 年就不生成文本、直接返回标签概率了,所以非自回归分类本身不构成新颖性。第二,Laya 是一个独立的开放决策模型,不是 Jev 公开的架构。它还顺手记了一次 150 条段落的对比测试,Jev 和 Haiku 都是 66%,Sonnet 是 71.3%。
到这里,我做了两件别人没做的事。第一件是把 Laya 拿我们冻结的 229 道题跑一遍。这批题是细粒度的原文一致性检查,数字被改一位、实体被换一个、方向被反转,模型要判断「这句和原文相符吗」,标准答案是确定的。
结果是四个复刻里最低的一个。
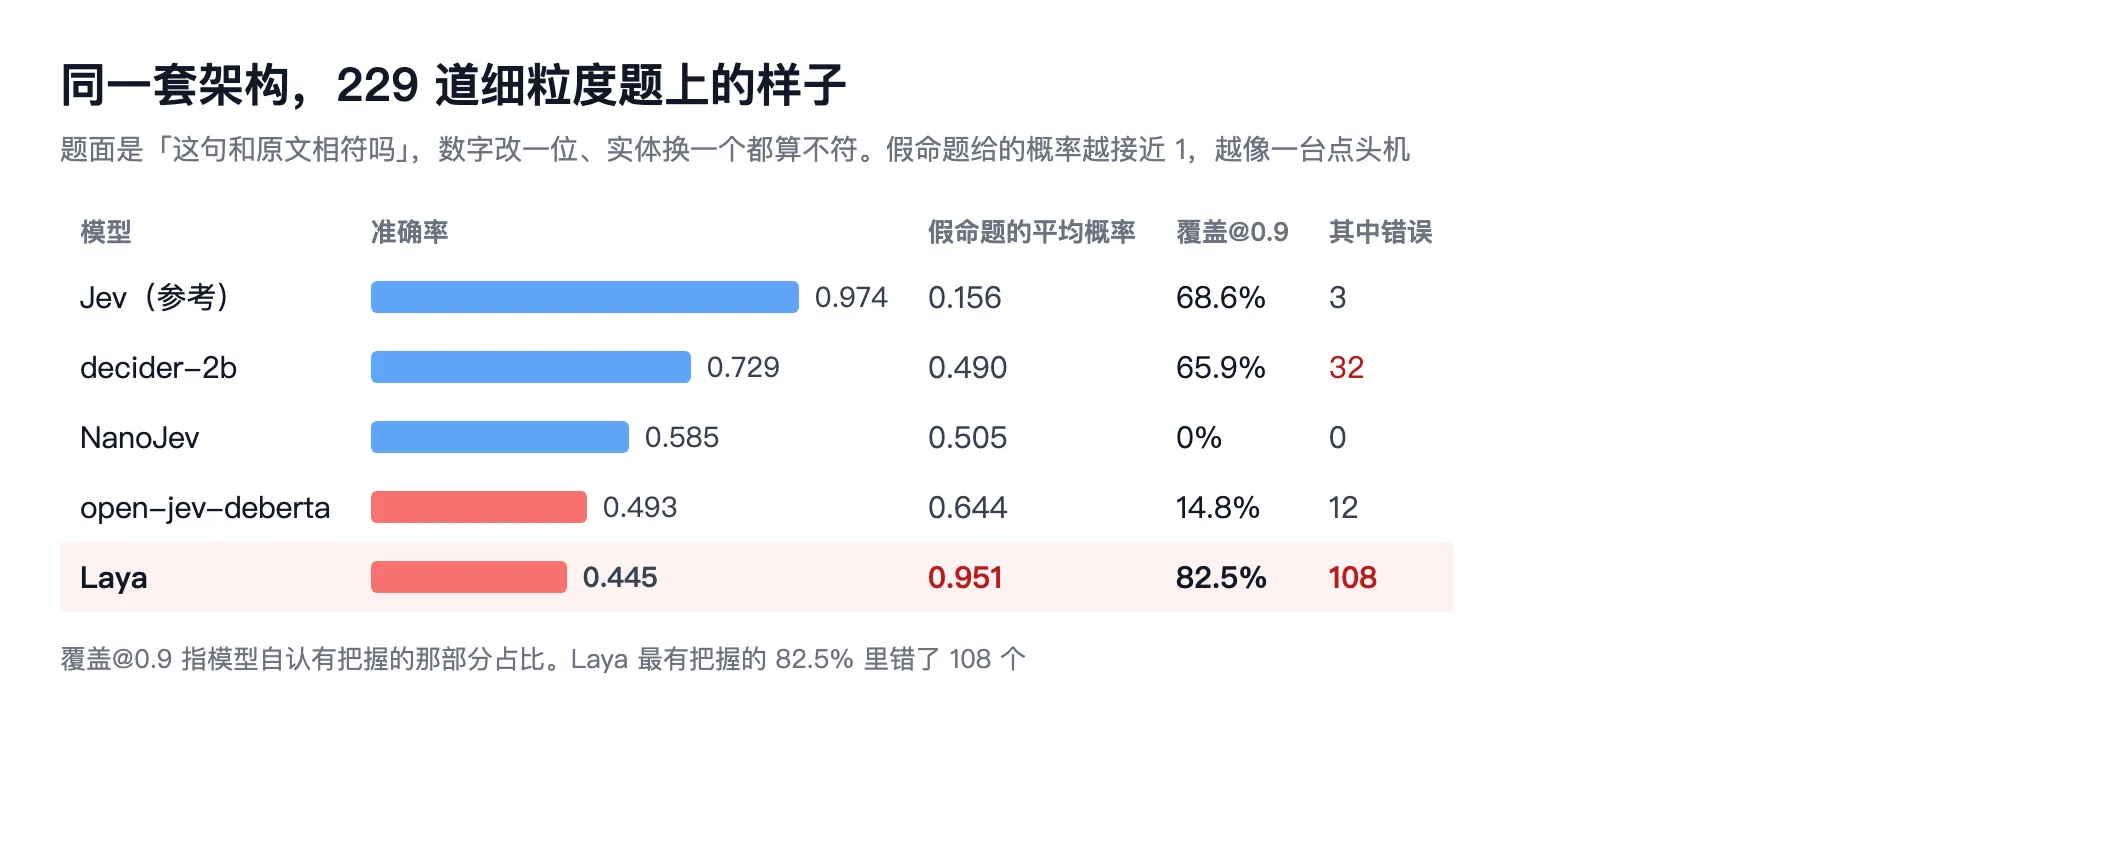
比准确率更说明问题的是最后两列。它给假命题的平均概率是 0.951,给真命题是 0.945,也就是说它几乎对什么都说「是」。所以按 0.9 的阈值挑出它最有把握的那 82.5%,里面错了 108 个。校准误差 0.503,是我量过的模型里最差的一个。
Laya 自己的模型卡上写的是另一组数字,任务内宏平均准确率 83.8%,意图与客服路由 99.1%,邮件分诊 73.2%,还有一张逐项对比 Jev 的表格。这两组数字并不矛盾,因为题目根本不一样。它的强项在路由、分类、分诊这种粗粒度判断上,我给它的是需要盯住一个数字的细粒度检查。同一套架构在两类任务上差出这么多,恰好说明了一件事,难点不在架构里。
双向编码器、选项标记、组内 softmax、温度拟合,这些全是公开的工程,Mukkunnoth 自己在长文里把整个结构、张量形状、连 act/escalate 头用的四个分布特征都写了出来。任务选得对不对、数据够不够、概率有没有在独立数据上校准过,这三件事才是分水岭。
有一处细节我觉得比优先权更能说明问题。Mukkunnoth 2025 年的论文里,训练数据是 GPT-4O 合成的;而 2026 年 Laya 的模型卡上写着「100% 人工标注的真实数据集,零合成捷径」。从合成数据到人工标注,这一步是真实的进步,也正是这一年里最有价值的积累,但它跟「谁先发布了这个概念」是两件事。
Mukkunnoth 的抱怨有一半成立,闭源产品讲一个开源过的想法,这件事值得被指出来。但「我早一年做了同一套架构」按论文看撑不住,早的是概念,不是那套架构,而且他自己现在的模型也是 2026 年重做的。
对读者来说更值得问的是另一个问题,这套架构在你的任务上行不行。我量出来的答案是,同一套东西放到细粒度任务上会塌,塌的地方在数据和任务,不在架构。Laya 现在是开放的、能本地跑的、训练脚本也放出来了,如果你要做的是路由和分诊,它值得试;如果你要判断一句话和原文差了一个数字,别用它。
Decoding Jev · arXiv:2503.23303 · arXiv:2510.01237 · Laya 模型卡