JevとDeepSeekは同じ判断問題群を解いたが、違いはどちらがより賢いかではない
10の実シナリオ、確定的な答えを持つ66問、さらに229の検証問題、3つの比較アーム。精度差はわずか数ポイント、時間差は10倍、そして確率の使い方はまったく異なる。
日本語
コピー
これは「どちらが賢いか」を測る評価ではない。同じ判断タスクを、2つのやり方で解かせた。1つはモデルに文章を書かせる方法(答えと確率を JSON で書かせてパースする)。もう1つは解答用紙だけを提出させる方法(型付きの選択肢、スコア、確率)。実シナリオ10件と、正解が確定している200問超を用意し、同じ入力を両方の経路に流して走らせた。
どう比べたか
比較する腕は3つ。1つ目は Jev で、テキストを生成せず、型付きの答えと確率だけを返す。残り2つは同じチャットモデル DeepSeek の2つのモードで、デフォルトで思考が有効(effort は high)。この「思考あり」と「思考オフ」の両方を測った。
公平性のために、3つのことを意図的にやっている。同じ材料、同じ問題群で、両方のモデルが見るものは完全に同一。1回の呼び出しで1バッチをまとめて問うので、1問ずつ聞いて相手を不利にすることはない。チャットモデル側はJSON モードを有効にして、つまり構造化出力にとって最良の条件を与え、さらに正誤だけでなく確率も出させた。
問題の真値は構成で決まる。10シナリオの各問について、正解は先に書いてから走らせた。後から都合のいい解釈を選んだのではない。
10のシナリオ
材料は自分たちで書いたもので、生活・プログラミング・仕事をカバーしている。結果は下の図のとおり。
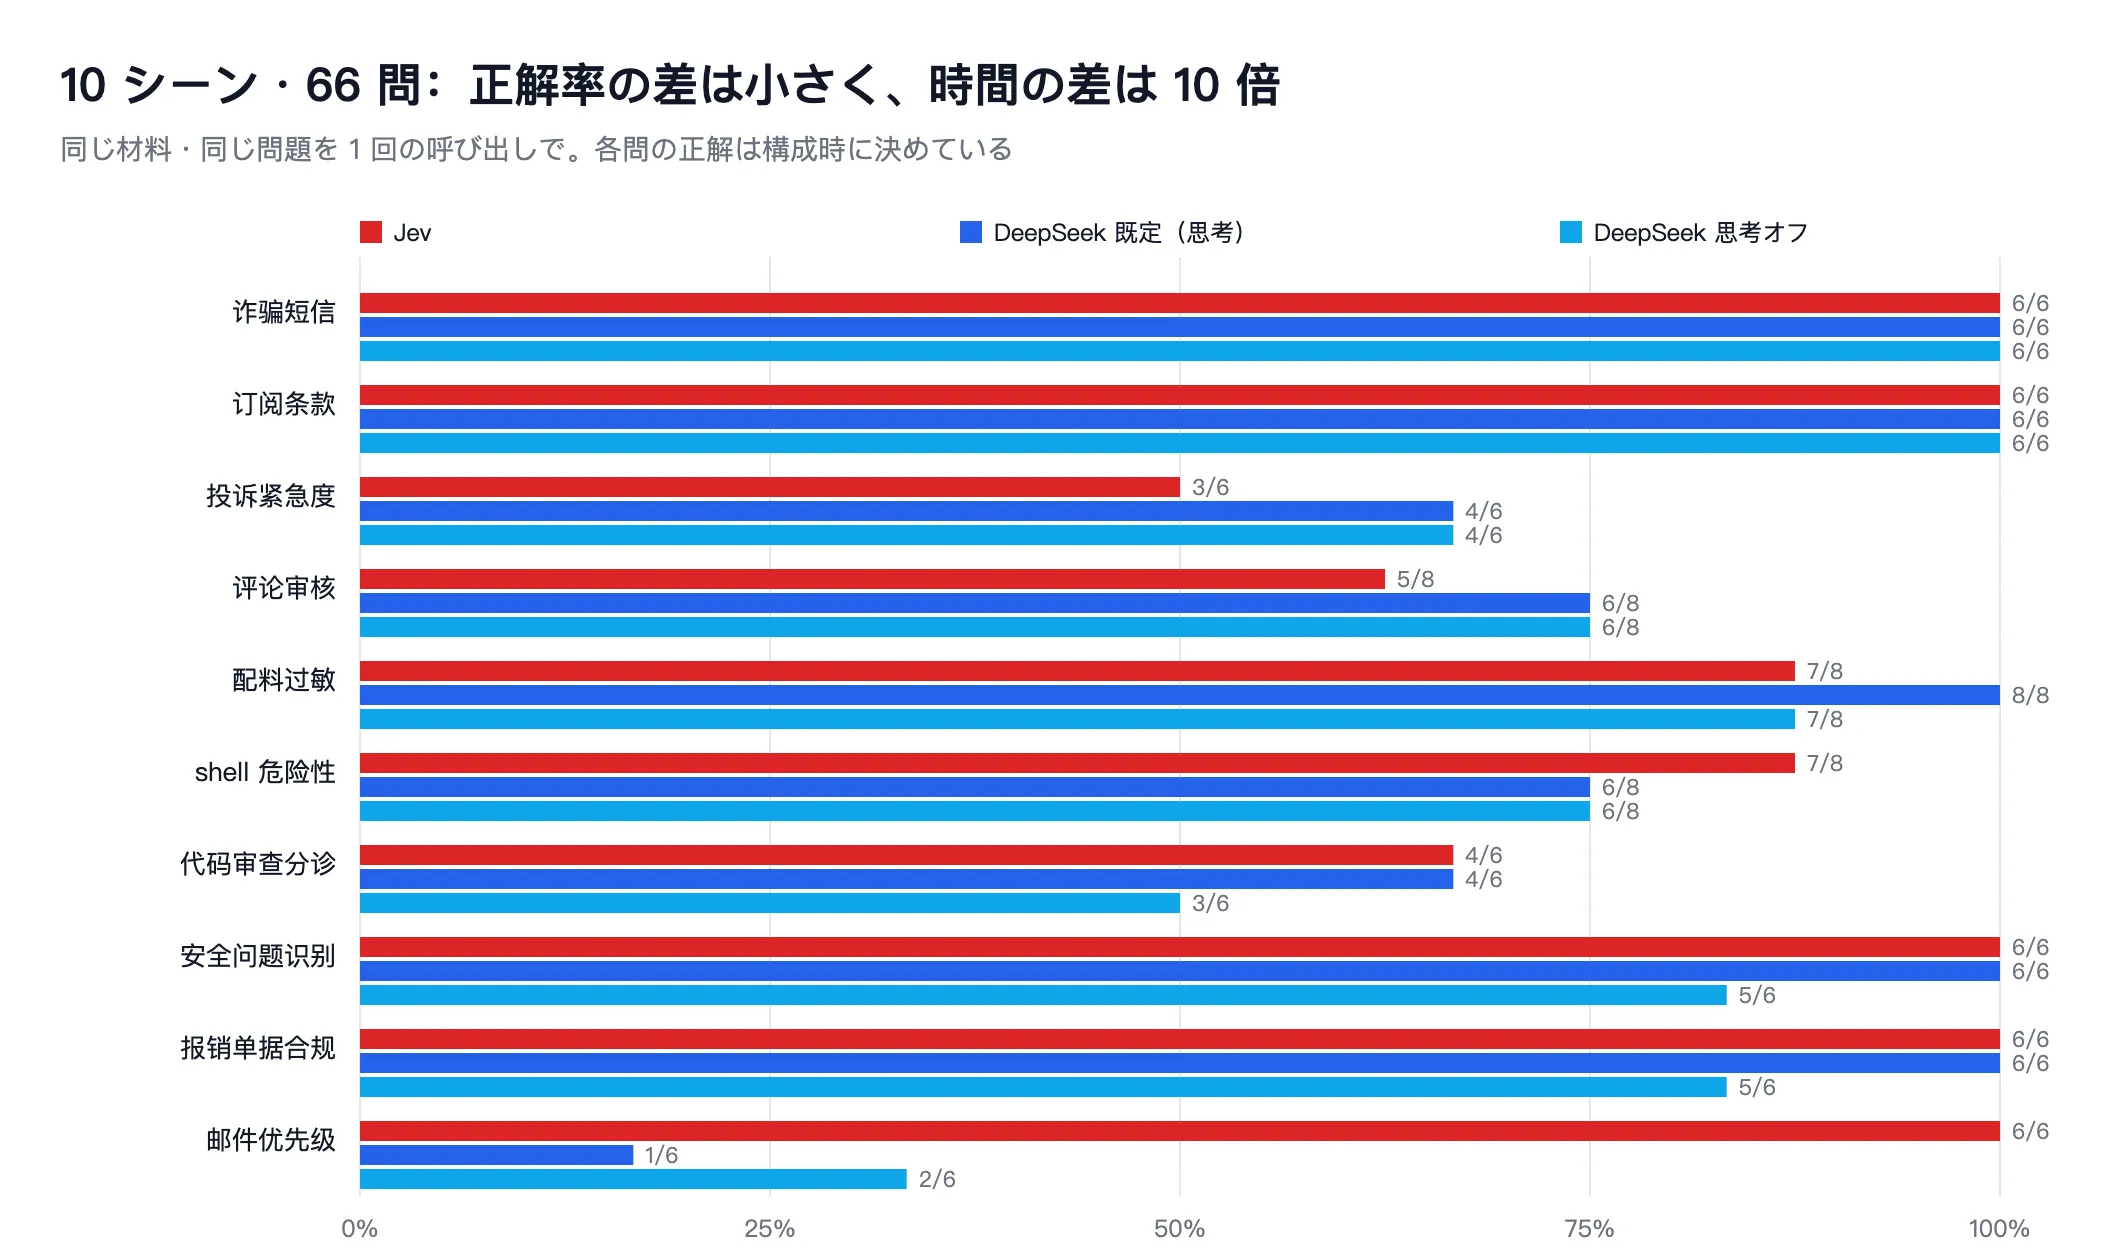
いくつかのシナリオは個別に触れる価値がある。
詐欺 SMS(6 件、うち 3 件はフィッシングリンク、偽の保険金請求、ロマンス詐欺)は 3 アームすべて正解。サブスクリプション規約(数字が本文に埋め込まれていて、14 日か 30 日か、7 日前か 30 日前か)も 3 アームすべて正解だった。この種の「原文と食い違う一項を探す」は 3 者の共通の得意分野だ。
食物アレルギーの回で Jev は 1 問落とし、しかも落とし方が面白い。資料に「沙茶牛肉」という料理があり、材料に沙茶醤と書いてある。これにエビが入っているかを判断するには、沙茶醤にエビの干し身が入っているという常識が要る。Jev は自信 0.06 で誤答し、DeepSeek のデフォルト思考は正解した。世界知識の広さではチャットモデルに分がある。
コメント審査で Jev は 5/8。私が「グレーゾーン、人間が目を通すべき」とラベルした 3 件を、そのまま「削除」と判定した。ただし信頼度の分布が、本人も確信していないことを露呈している。その 3 件の信頼度は 0.88、0.66、0.59 で、明確な違反 3 件は 0.99、0.96、0.84 だった。つまり閾値を 0.9 に置けば、この 3 件は自動的に人手キューに落ちる。 これについては後でも触れるが、今回のテストで最も実用的な発見の一つだ。
苦情の緊急度はどちらのスコアも低く(Jev 3/6、DeepSeek 4/6)、しかも私が最も判定に迷った 1 件に、Jev はその回で最低の信頼度 0.31 を付けた。等級の判断は是非の判断より難しく、これはどちらのモデルも逃れられない。
shell コマンドの危険度は Jev が最も差をつけた回だ。8 件のコマンドを「読み取り専用 / 復元可能 / 不可逆」に判定させて、誤ったのは 1 件だけ。未コミットの変更を破棄する、実際には不可逆な操作を復元可能と判定した。この回はまさに agent の安全ゲートの実用例で、エコシステムにはすでに同じことをやっているプロジェクトがある。
コードレビューのトリアージはどちらのモデルも振るわなかった(4/6)。資料には私が仕込んだ罠があり、たとえば i <= a.length のような範囲外アクセスや、そのままセキュリティ問題になっているコード 2 箇所(SQL の文字列連結、ハードコードされた鍵)が含まれる。Jev はそのセキュリティ問題のコード 2 箇所も「バグあり」と判定した。ただ「このコードにセキュリティ問題はあるか」だけを単独で聞くと 6/6 の全問正解なので、2 つの問いを混ぜて聞いたのが原因らしい。
メールの優先度の回は今回のテストで最も劇的な結果が出た。Jev 6/6、DeepSeek のデフォルト思考は 1/6。理由は尺度の向きをまるごと逆に答えたからで、私が定義した 3 段階は「放置してよい / 今日返信 / 即対応」なのに、「放置してよい」の社内イベント通知を 2 と答え、「即対応」の返金苦情を 0 と答えた。ほぼ完全な鏡像だ。
メールは読めている。問題は尺度の向きがチャットモデル側の経路では構造的に一切保証されないことにある。Jev では 3 段階は順序付きリストで、向きは契約で固定される。チャットモデルでは、プロンプトに一文書いて、あとは覚えていてくれることを祈るしかない。
差異その 1、答えが提出されたかどうか
本当の分かれ目は答えが提出されたかどうかで、何問正解したかはむしろ二の次だ。
私たちは狙って壊す実験を 1 回やった。古典的な経営学の読解問題に 5 問の単一選択、正解は 1-D、2-D、3-C、4-D、5-B。元の問題ではどちらのモデルも 5/5 だった。
そこで私は第 2 段落の「これらの著者は直感についての理解が乏しい」を「これらの著者は、管理者が実際にどう行動したかではなく、主に管理者自身の言葉に依拠している」に差し替え、第 2 問の正解が C だけに反転するようにした。
Jev は 5/5 を返し、第 2 問は D から C に反転、信頼度 0.99。 目の前の改変されたテキストを読んでいる。
DeepSeek は何も返さなかった。 37 秒走り、推論内容は 4 万字、8000 の token 予算をすべて思考に焼き尽くし、最後に content は空だった。推論過程を覗いてみると、実際には正解の C にたどり着いている。答えはある、ただ納品されていない。
これは harness の違いで、モデルの賢さとはあまり関係がない。チャットモデルの出力は 1 本のテキストで、考えがまとまる前に予算を使い切ることも、JSON を壊すことも、空文字列を返すこともある。Jev の契約は「1 回の呼び出しで型付きの答えを 1 つ返す」で、これには中間状態がない。
同じ類のことはもう 1 回あった。メール優先度の回で、DeepSeek の最初の呼び出しは 26 ミリ秒で返り、token もエラー内容もなかった。再実行すると正常だった。これは一過性の障害として扱い、能力差には数えないが、「リクエストは投げたが何も受け取れなかった」事例ではある。
差異その 2、時間とコスト
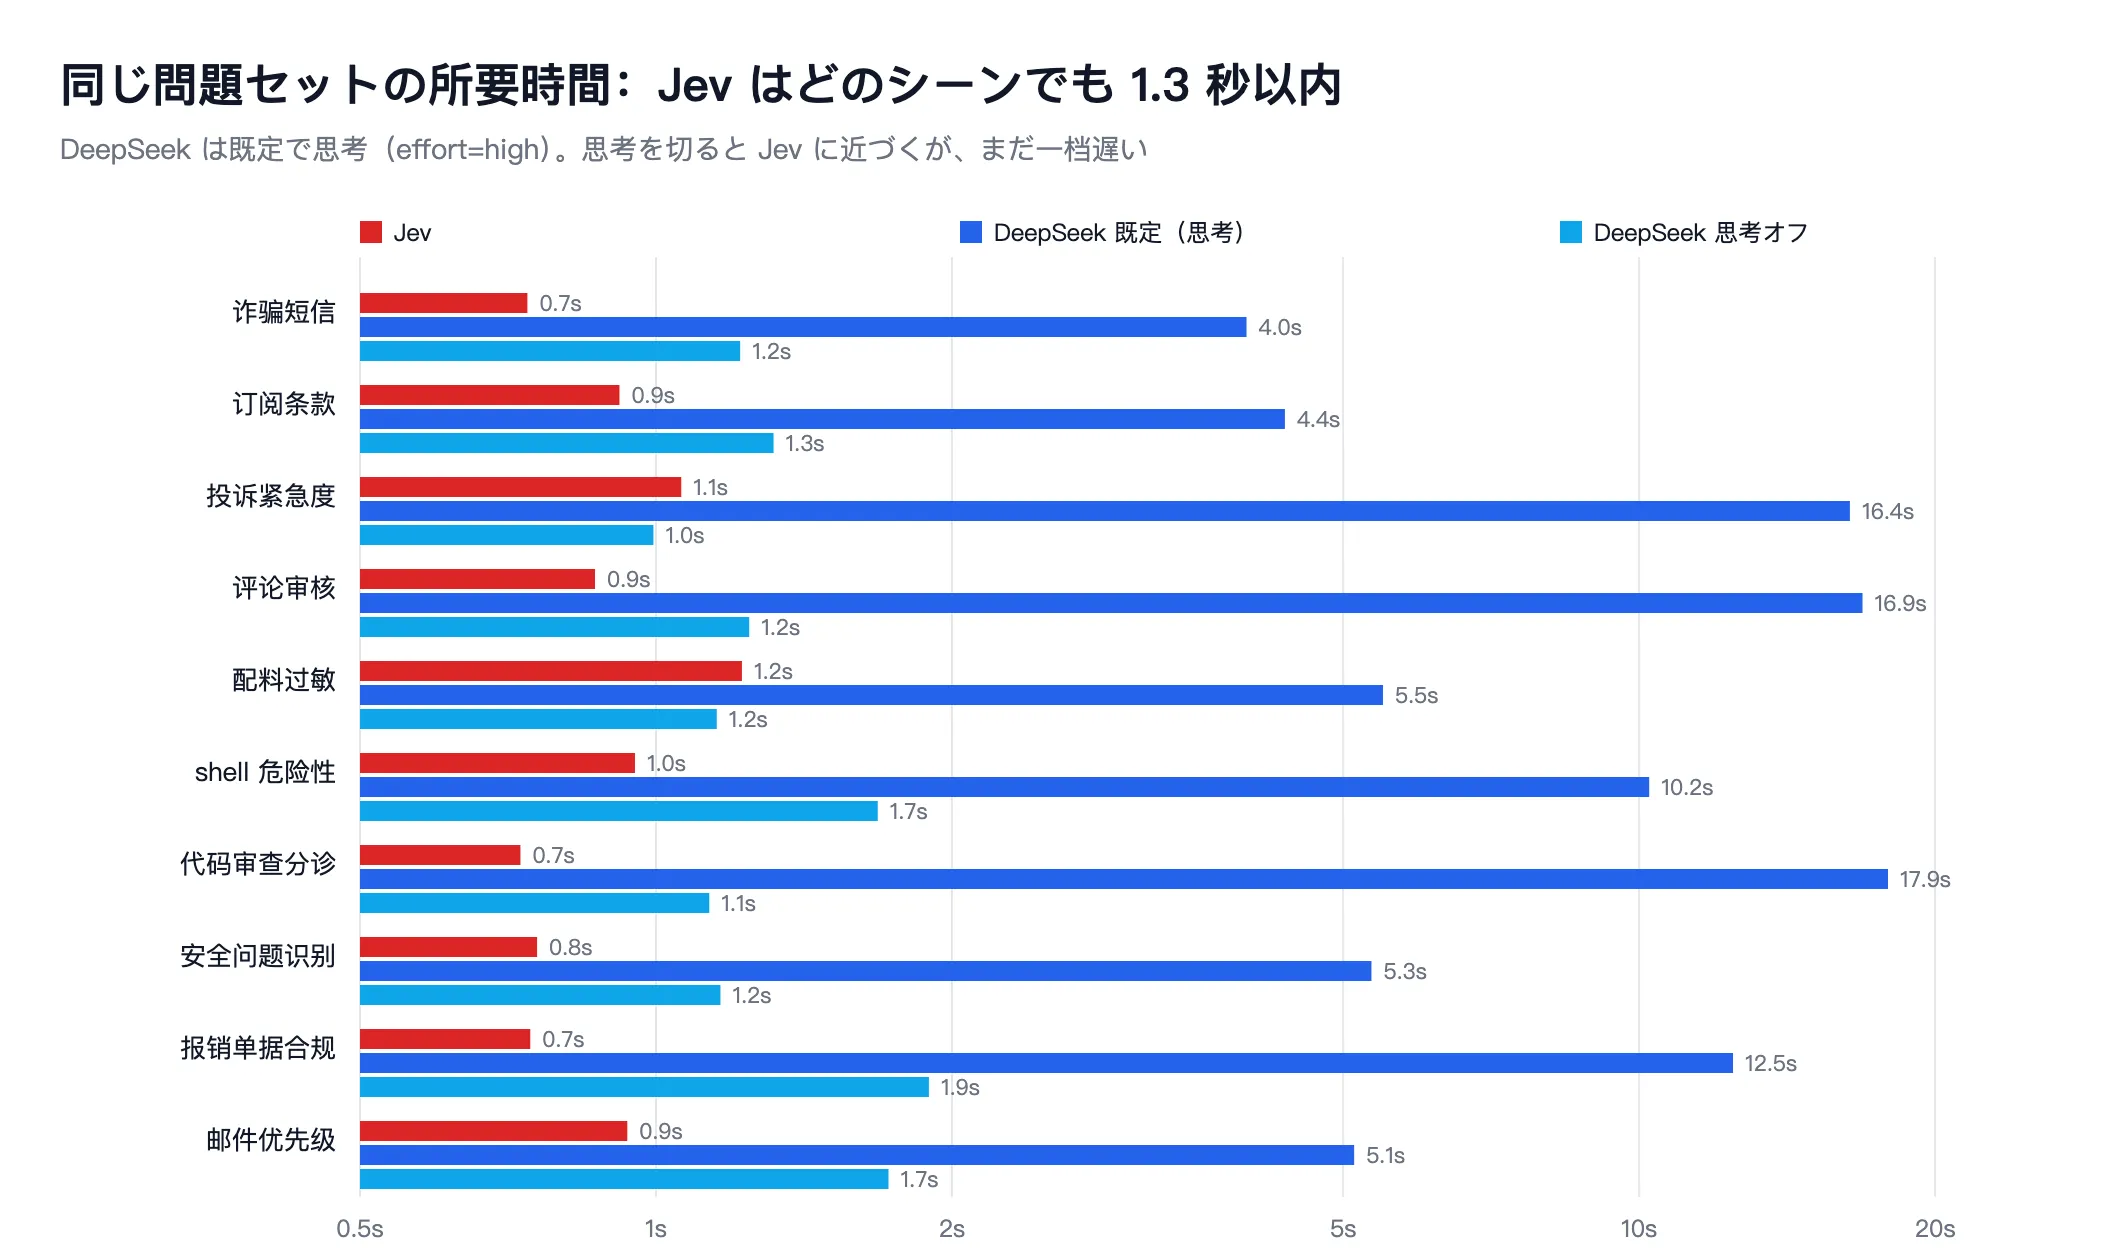
問題数を1から20まで増やし、同じ呼び出しに詰め込むと、曲線の違いがはっきりと現れる。
| 1回の呼び出しに含める問題数 | Jev | DeepSeek デフォルト思考 | DeepSeek 思考オフ |
|---|---|---|---|
| 1問 | 924ms · 出力21トークン | 1052ms · 66(推論48) | 1067ms · 17 |
| 5問 | 718ms · 89 | 3628ms · 688(推論617) | 829ms · 85 |
| 20問 | 685ms · 355 | 6975ms · 1608(推論1327) | 1960ms · 340 |
| 20問のコスト | $0.00007 | $0.00106 | $0.00030 |
Jevの所要時間はほぼ横ばいだ。 問題数が20倍になっても、時間は924ミリ秒から685ミリ秒になるだけ。つまり「問題を足しても応答時間はほとんど変わらない」という主張は、我々の手元では成り立つ。チャットモデルは線形に伸び、しかもデフォルト思考モードでは20問に7秒かかり、コストはJevの15倍になる。
価格は両社の公式サイトのその日の公開価格を用いた。Jevは入力$0.042/100万トークン、出力は課金なし。deepseek-flashは入力$0.15、出力$0.6(キャッシュミス時、オフピーク価格。ピーク時は倍)。チャットモデルはコストの大半が出力で、その出力の一部は推論過程だ。
差異その3、確率は使えるのか
ここが最も直感に反する節であり、先月の実測記事の直接の続きでもある。
先月の229問の検証データセット(正解が確定している真偽判定問題。問題も素材も自作)を3つのアームに食わせた。
| Jev | DeepSeek デフォルト思考 | DeepSeek 思考オフ | |
|---|---|---|---|
| 正答率 | 97.4%(6問誤り) | 100% | 99.6%(1問誤り) |
| ECE(小さいほど良い) | 0.084 | 0.0005 | 0.014 |
| 0.00または1.00を返した問題数 | 0 / 229 | 218 / 229 | 46 / 229 |
| 真命題の平均確率 / 偽命題 | 0.93 / 0.16 | 1.00 / 0.00 | 0.97 / 0.02 |
| 10回呼び出しの総所要時間 | 35秒 | 133秒 | 46秒 |
| 総コスト | $0.0014 | $0.0186 | $0.0048 |
まず最も誤読されやすいマスを見てほしい。正答率はDeepSeekの勝ちで、ECEも良く見える。 この2つの数字はセットで読む必要がある。
DeepSeekは229問のうち218問で、いきなり0.00か1.00を返してくる。両端でしか喋らないモデルは、それが正しければキャリブレーション指標が信じられないほど綺麗に出る。なぜなら「確信度」というものがそもそも発生していないからだ。何かに過学習しているわけではない。ただ、この軸を与えられていないだけだ。
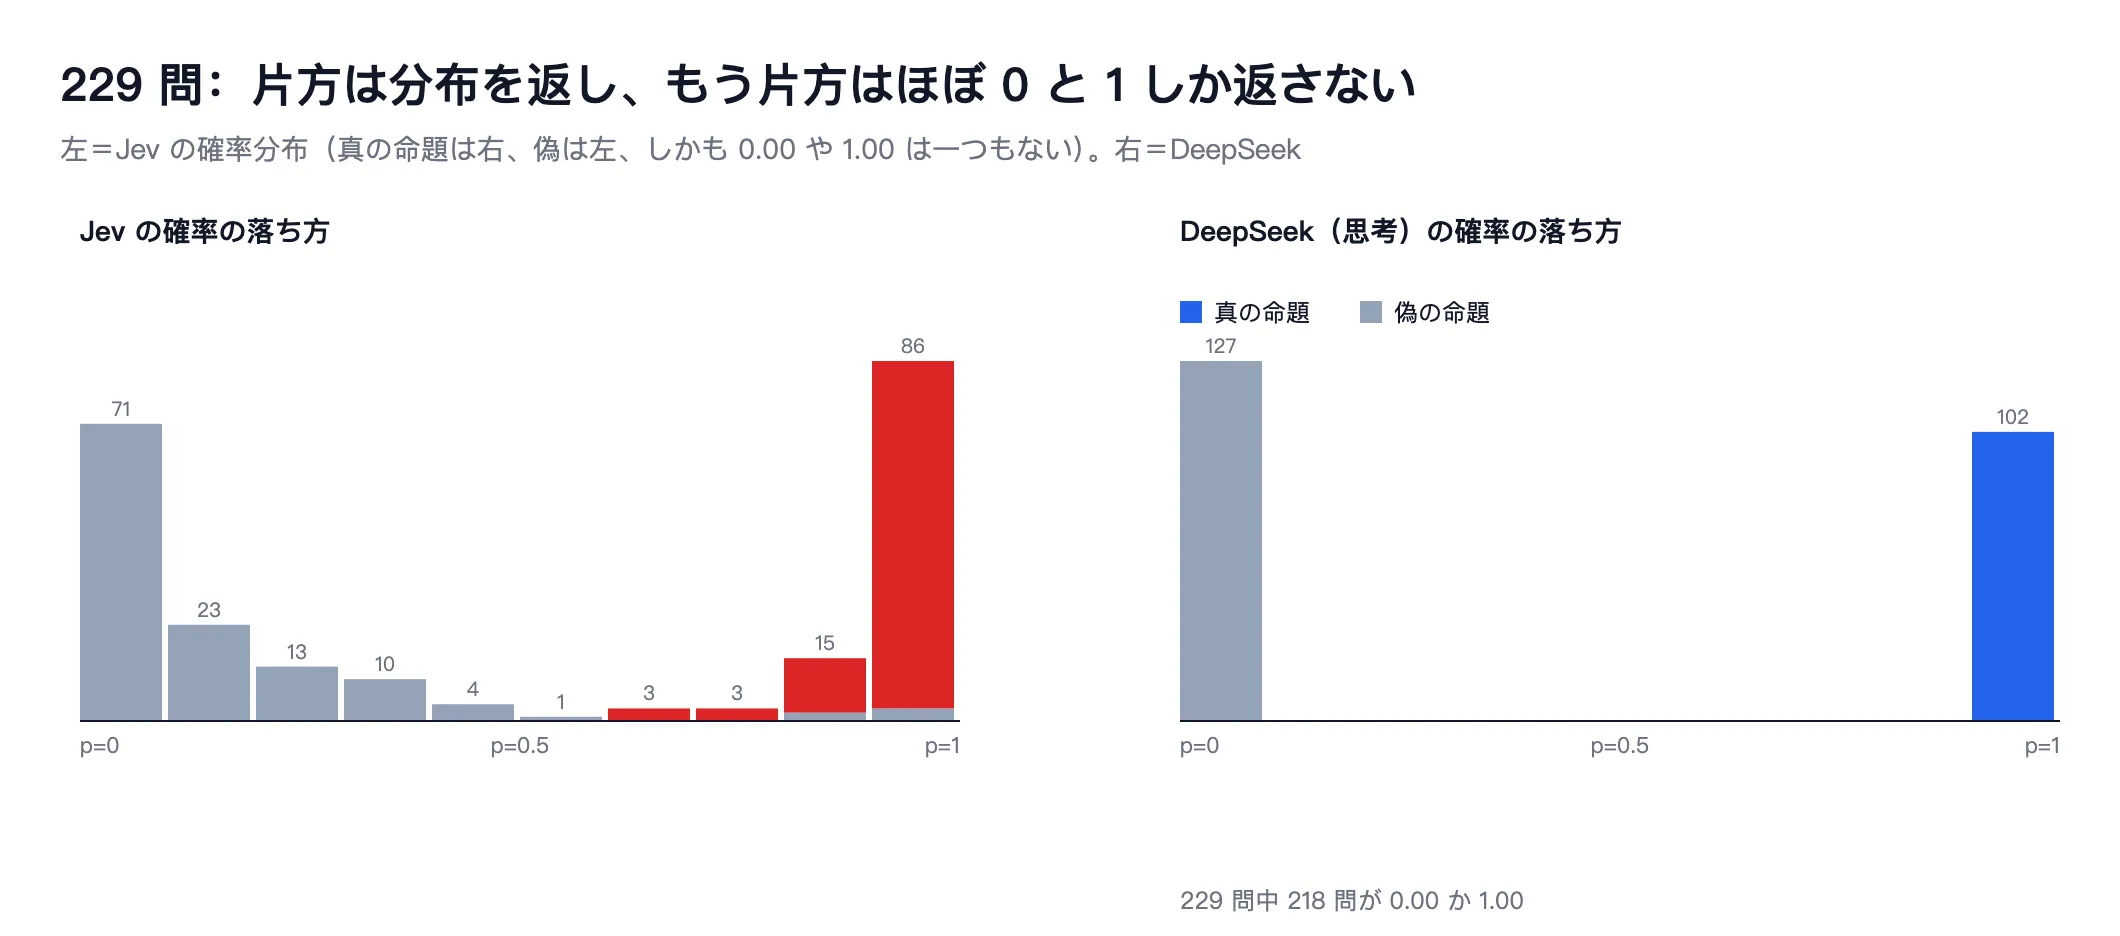
Jev には飽和値がひとつもなく、確率は 0.05 から 0.95 まで広がり、偽の命題の平均確率は 0.16、真の命題は 0.93。代償は ECE の数字がチャットモデルほど良くないこと、利点は本当に回せるつまみを渡してくれることだ。
| しきい値 | 自動処理できる割合 | そのうち誤った問題数 | 人手が必要な量 |
|---|---|---|---|
| 確信度 ≥ 0.9(または ≤0.1) | 69% | 3 | 31% |
| 確信度 ≥ 0.95(または ≤0.05) | 45% | 1 | 55% |
0.9 で止めれば約七割を自動処理して誤りは三題。もう少し堅くして 0.95 まで上げると、自動処理は四割半まで落ちて誤りは一題になる。DeepSeek のこの軸には調整できる場所がない。すべて 100% 自動処理できると言う。どの問題にも満点をつけているからだ。いったん間違えれば、ふるいにかける手段がない。
どう選ぶか
これらの数字を並べると、かなり明快な判断表になる。
Jev を使う場面は、判断が多くて小さく、遅延をミリ秒単位に抑えたいとき、コードにしきい値を置いて「自動か人手か」を決めたいとき、そして予算内で回したいとき。Jev が勝つ典型例は機械的なゲート、たとえば agent が shell コマンドを実行する前に危険かどうかを尋ねるようなケースだ。
チャットモデルを使う場面は、判断に世界常識が要るとき、多段の推論が要るとき、あるいはそもそも数十件しかなくて一度走らせて結果を急がないとき。食材アレルギーの回がその例だ。もっと現実的な使い方もある。チャットモデルに得意なこと(書く、直す、要約する)をやらせて、判断は手放す。
両方を組み合わせる場面では、生成はチャットモデルに、照合は Jev に任せる。一段落書かせたら、原文を渡して「この文に根拠はあるか」をもう一度尋ねる。一回の呼び出しでまとめて数十件を問い合わせられ、各バッチが数十ミリ秒で済むから、全件照合が割に合ってくる。
限界
このテストには、はっきりさせておくべき制約がいくつかある。
チャットモデルは一つ(DeepSeek の flash 版)しか試していない。より強いモデルに替えれば、精度や世界常識の節の結果は変わりうる。問題集は自作で、素材も自分たちで書いた。だからこれらの数字が示すのは二つの道筋の形であって、ランキングではない。呼び出しはすべて公開 API 経由で、ネットワーク遅延も含まれる。同一マシン、同一時間帯。価格はその日の公開価格で、変わる。もう一つ。どの数字も第三者による検証は受けていない。スクリプトと生の出力はリポジトリにあり、誰でも再実行できる。
再現コマンドと生データは content/jev-vs-deepseek-2026-09/verify/ と content/jev-harness-tutorial-2026-09/verify/ の二つのディレクトリにある。