Jev 和 DeepSeek 做了同一批判断题,差别不在谁更聪明
十个真实场景、66 道有确定答案的题,外加 229 道核对题,三条对比臂。准确率只差几个点,时间差十倍,而概率的用法完全不同。
中文
复制
这不是一篇「谁更聪明」的评测。同一个判断任务,两种做法。一种让模型写字(把答案和概率写成 JSON,再解析),另一种让模型只交答题卡(类型化的选择、分数、概率)。我们拿十个真实场景和两百多道有确定答案的题,把两条路放在同一份输入上跑了一遍。
怎么比的
三个对比臂。第一个是 Jev,它不生成文本,只返回类型化答案和概率。另两个是同一个聊天模型 DeepSeek 的两种模式,它默认带思考(effort 是 high),我们把「默认思考」和「关掉思考」都测了。
公平性上有三件事是刻意做的。同一份材料、同一批题目,两个模型看到的一模一样。一次调用问完一批,不用一问一次来压低对方。聊天模型那一侧开 JSON 模式,也就是给它结构化输出的最好条件,还要求它给出概率,不是只给对错。
题目的真值由构造决定。十个场景里的每一道题,正确答案都是我先写好再跑的,不是事后挑一个好看的解释。
十个场景
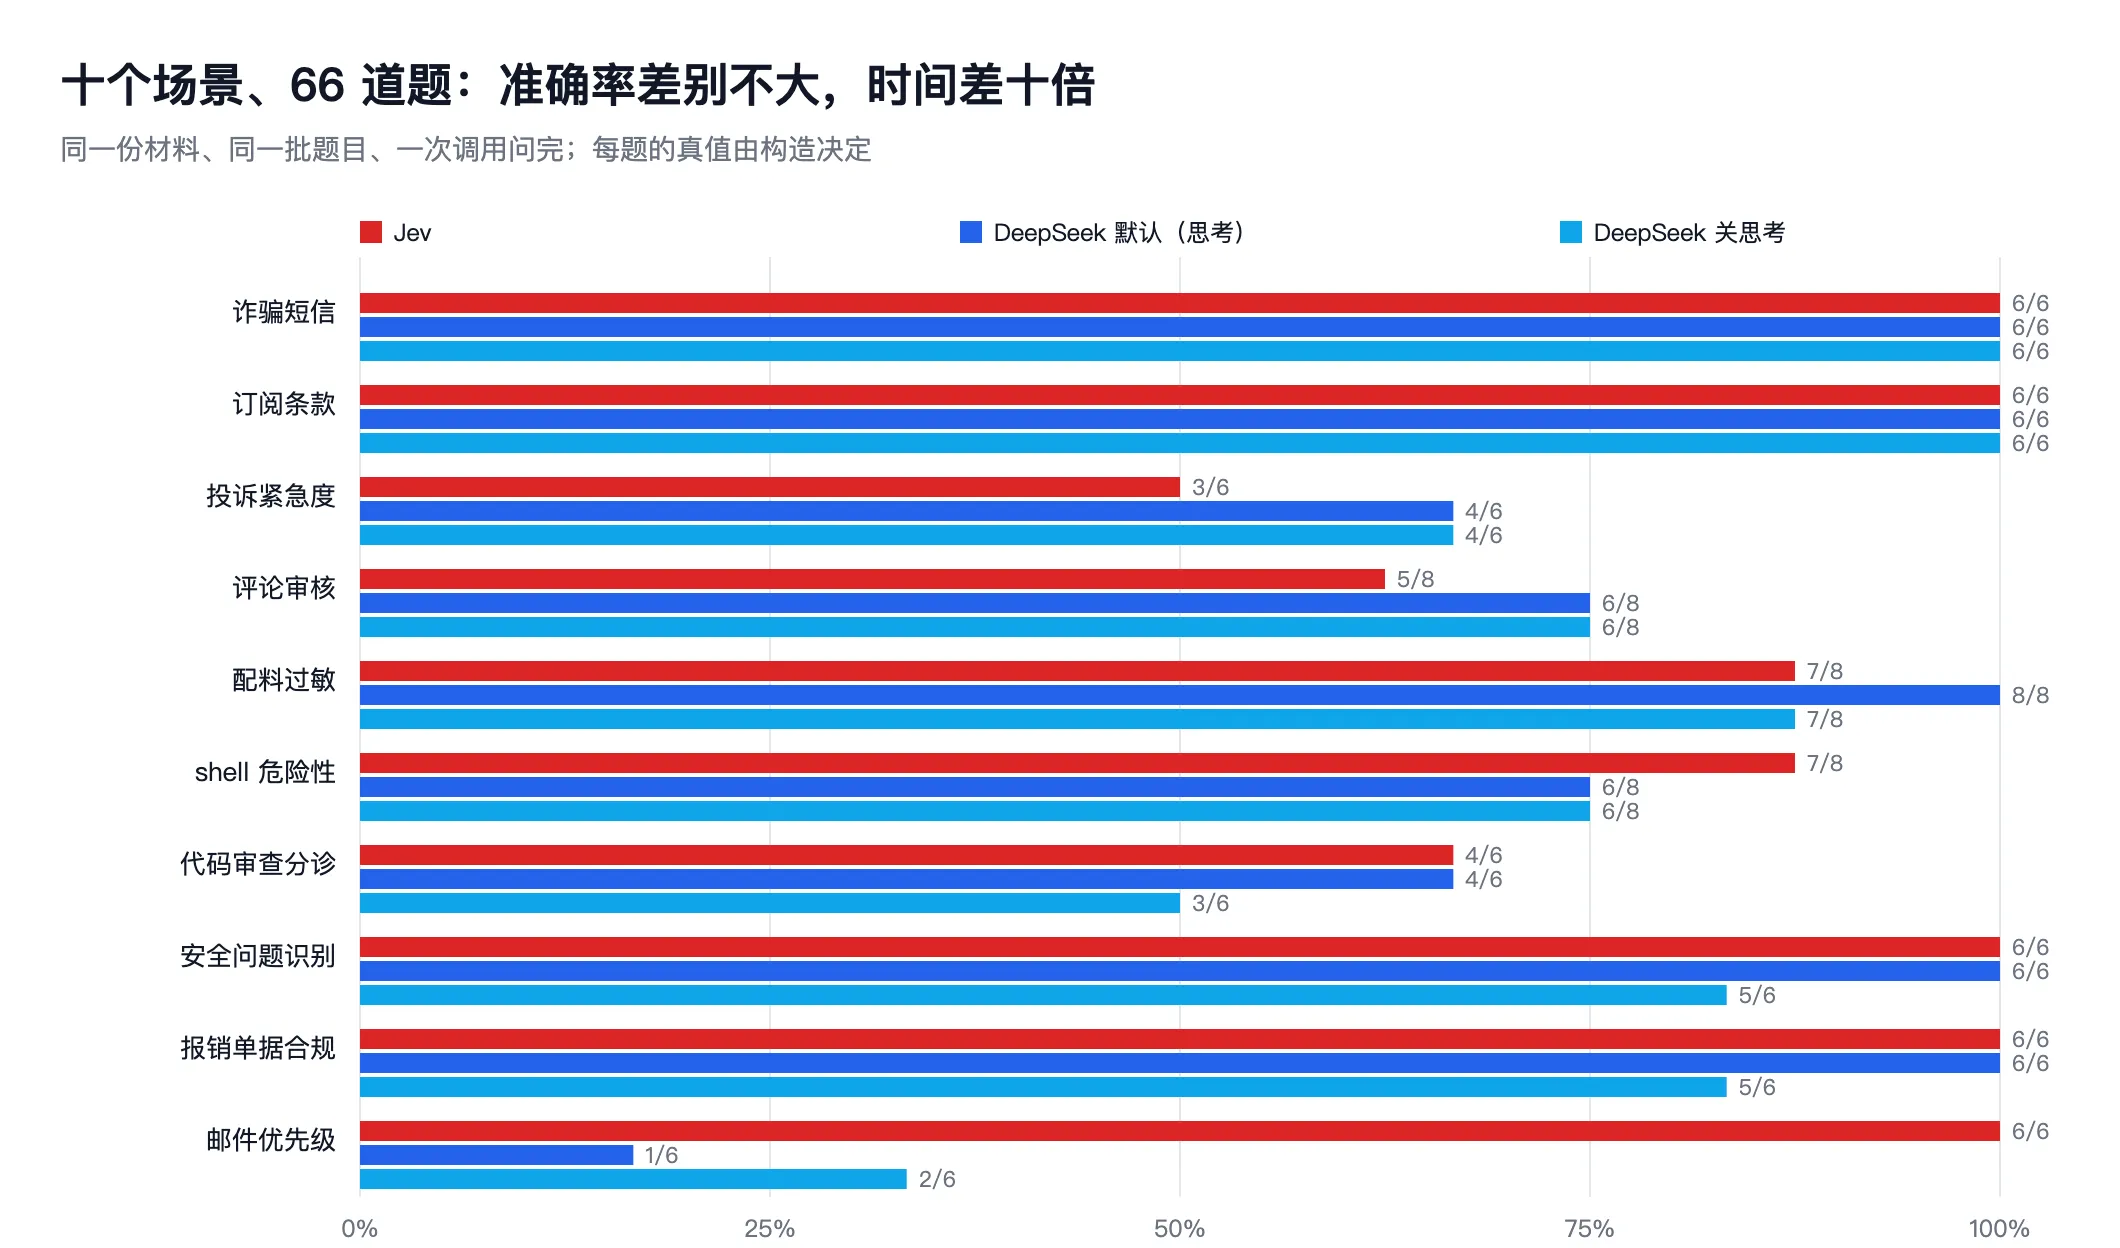
材料是我们自己写的一批,覆盖生活、编程和工作。结果是下面这张图。
几个场景值得单独说。
诈骗短信(6 条,3 条是钓鱼链接、假理赔、杀猪盘)三个臂全对。订阅条款(数字藏在文本里,14 天还是 30 天、提前 7 天还是 30 天)三个臂也全对。这类「找出与原文不符的一条」是它们的共同强项。
配料过敏这一场 Jev 输了一题,而且输得很有意思。材料里有一道「沙茶牛肉」,配料写着沙茶酱。要判断它是否含虾,得知道沙茶酱里有虾米,这是常识。Jev 给了 0.06 的自信,答错了;DeepSeek 默认思考答对了。世界知识的广度上,聊天模型更占优。
评论审核里 Jev 5/8。它把三条我标注为「擦边、需要人看一眼」的评论直接判成了「删除」。但它的置信度分布暴露了它自己也不确定,那三条的置信度是 0.88、0.66、0.59,而明确违规的三条是 0.99、0.96、0.84。换句话说,把阈值卡在 0.9,那三条会自动落到人工队列里。这一点后面还会再说,它是这轮测试里最实用的一条。
投诉紧急度两边的分数都不高(Jev 3/6,DeepSeek 4/6),而且我给 Jev 标注分歧最大的那一条,它恰好给了全场最低的置信度 0.31。等级类判断比是非判断难,这一点两个模型都逃不掉。
shell 命令危险性是 Jev 领先最多的一场。八条命令判「只读 / 可恢复 / 不可逆」,它只错了一条,把一个丢弃未提交改动、实际不可逆的操作判成了可恢复。这一场正是 agent 安全门控的真实用法,生态里已经有项目在做同样的事。
代码审查分诊两个模型都没做好(4/6)。材料里我埋了一些陷阱,比如 i <= a.length 这种越界,以及两段直接就是安全问题的代码(SQL 拼接、硬编码密钥)。Jev 把其中两段安全问题的代码也标成了「有 bug」。不过单问「这段代码有安全问题吗」时它 6/6 全对,看起来是把两件事混在一起问了。
邮件优先级这一场出了本次测试最戏剧的结果。Jev 6/6,DeepSeek 默认思考 1/6。原因是它把量表方向整个答反了,我定义的三档是「可以不管 / 今天回 / 立刻处理」,它把「可以不管」的团建通知答成 2,把「立刻处理」的退款投诉答成 0,几乎完美镜像。
它读得懂邮件。问题出在量表的方向在聊天模型那条路上没有任何结构性保证。用 Jev 时,三档是一个有序列表,方向由契约定死;用聊天模型时,你只能在提示词里写一句话,然后祈祷它记住。
差异一,答案有没有被交出来
真正的分水岭是答案有没有被交出来,答对多少反而次要。
我们做了一轮定向改坏实验。一篇经典的管理学阅读理解加五道单选,标准答案是 1-D、2-D、3-C、4-D、5-B。原题上两个模型都是 5/5。
然后我把第二段里「这些作者对直觉的理解很差」换成「这些作者主要依据管理者自己怎么说,而不是他们实际怎么做」,让第二题的正确答案唯一翻转成 C。
Jev 交回 5/5,第二题从 D 翻成 C,置信度 0.99。 它在读眼前这份被改过的文本。
DeepSeek 那边什么都没交回来。 它跑了 37 秒,推理内容四万字,把 8000 的 token 预算全部烧在思考上,最后 content 是空的。我扒开它的推理过程看过,它其实推到了正确答案 C。答案是有的,只是没交付。
这是 harness 的差别,跟模型聪明与否关系不大。聊天模型的输出是一段文本,它可能在想清楚之前就用完了预算、可能把 JSON 写坏、可能返回一个空的字符串。Jev 的契约是「一次调用返回一个类型化答案」,这件事上没有中间状态。
同一类事情还有一次。邮件优先级那场,DeepSeek 第一次调用 26 毫秒就返回了,没有 token 也没有错误内容,重跑才正常。我把这次标成瞬时故障,不算能力差异,但它确实是一次「打了请求却什么也没拿到」。
差异二,时间和钱
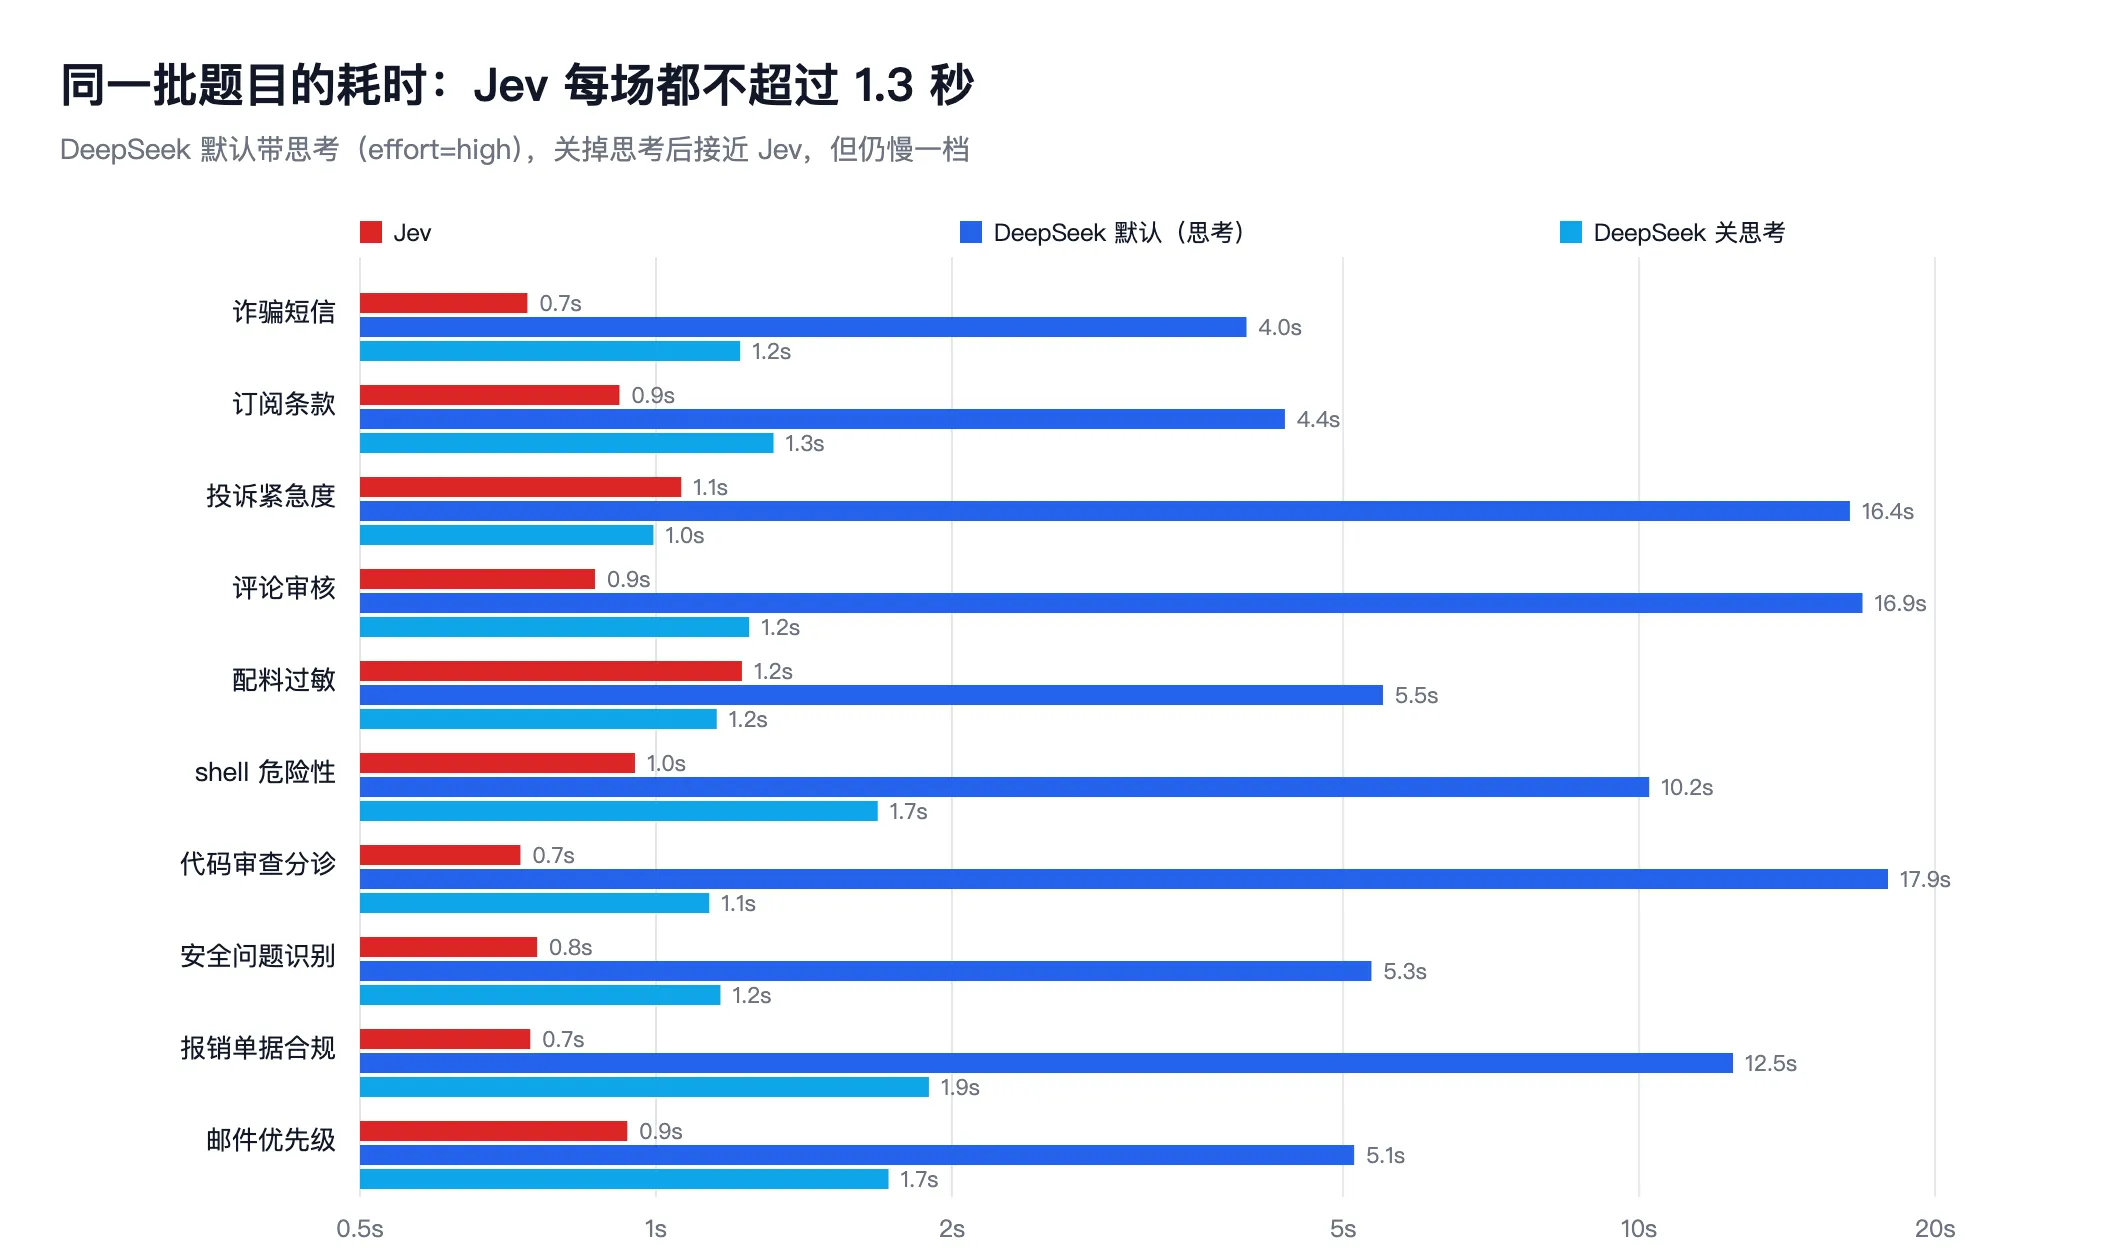
把问题数从 1 加到 20 塞进同一次调用,曲线差别更清楚。
| 一次调用里的问题数 | Jev | DeepSeek 默认思考 | DeepSeek 关思考 |
|---|---|---|---|
| 1 个 | 924ms · 21 输出 token | 1052ms · 66(推理 48) | 1067ms · 17 |
| 5 个 | 718ms · 89 | 3628ms · 688(推理 617) | 829ms · 85 |
| 20 个 | 685ms · 355 | 6975ms · 1608(推理 1327) | 1960ms · 340 |
| 20 个的成本 | $0.00007 | $0.00106 | $0.00030 |
Jev 的耗时基本是平的,问题数翻 20 倍,时间从 924 毫秒变成 685 毫秒,也就是说「加问题几乎不改变响应时间」这个说法在我们手上成立。聊天模型是线性增长,而且默认思考模式下,20 个问题要 7 秒、成本是 Jev 的 15 倍。
价目用的是两边官网当天的公开价。Jev 输入 $0.042 每百万 token、输出不计费;deepseek-flash 输入 $0.15、输出 $0.6(缓存未命中、闲时价格,高峰期翻倍)。聊天模型的成本大头在输出,而它输出的一部分是推理过程。
差异三,概率能不能用
这是最反直觉的一节,也是我们上个月那篇实测的直接延续。
我们把上个月那份 229 题的核对数据集(有确定答案的判断题,题目和材料都是我们自己构造的)喂给三条臂。
| Jev | DeepSeek 默认思考 | DeepSeek 关思考 | |
|---|---|---|---|
| 准确率 | 97.4%(6 错) | 100% | 99.6%(1 错) |
| ECE(越小越好) | 0.084 | 0.0005 | 0.014 |
| 给出 0.00 或 1.00 的题数 | 0 / 229 | 218 / 229 | 46 / 229 |
| 真命题平均概率 / 假命题 | 0.93 / 0.16 | 1.00 / 0.00 | 0.97 / 0.02 |
| 十次调用总耗时 | 35 秒 | 133 秒 | 46 秒 |
| 总成本 | $0.0014 | $0.0186 | $0.0048 |
先看最容易误读的那一格。准确率是 DeepSeek 赢,ECE 看起来也是。 这两个数字要一起读。
DeepSeek 在 229 题里有 218 题直接给出 0.00 或者 1.00。一个只在两端说话的模型,只要它是对的,校准指标就会漂亮得不像话,因为「置信度」这件事根本没有发生。它没有过拟合任何东西,它只是没给这根轴。
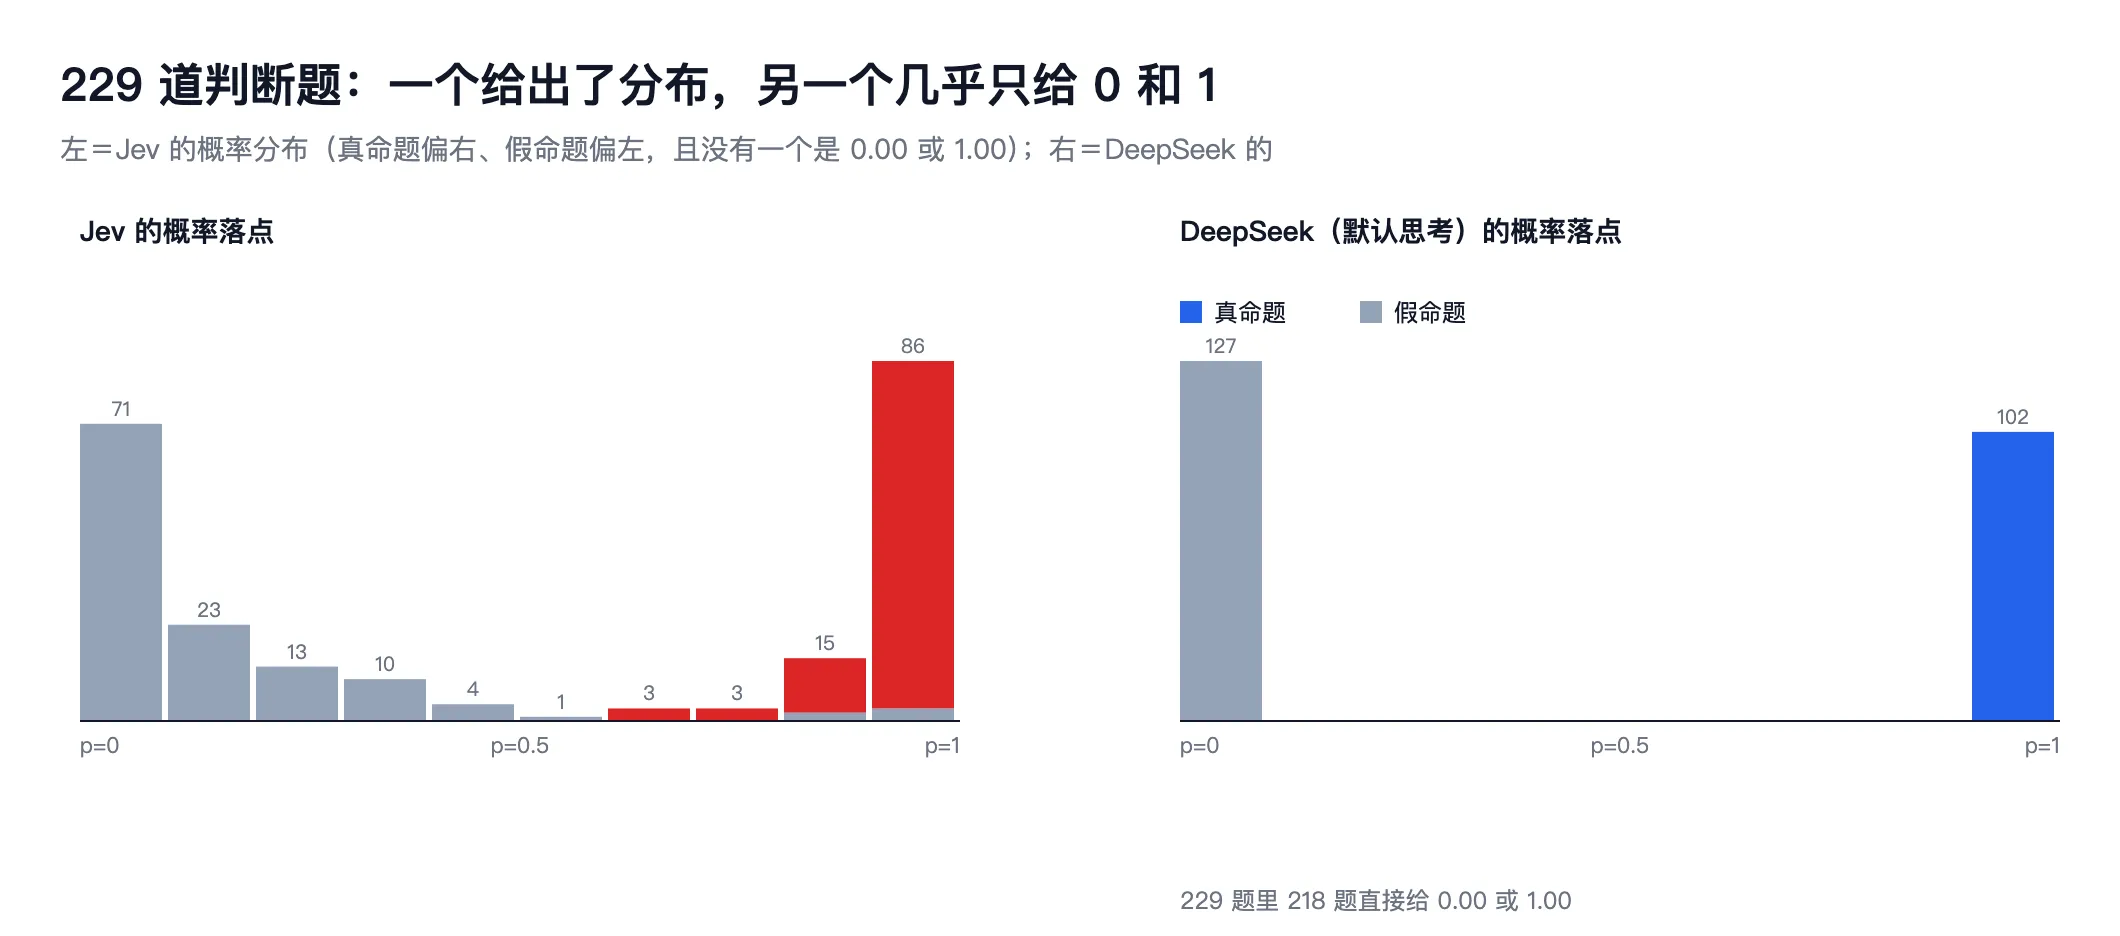
Jev 一个饱和值都没有,概率从 0.05 铺到 0.95,假命题的平均概率 0.16、真命题 0.93。代价是它的 ECE 数字没有聊天模型好看,收益是它给出一根真的能转的旋钮。
| 阈值 | 能自动处理的比例 | 其中错了几题 | 需要人工的量 |
|---|---|---|---|
| 置信度 ≥ 0.9(或 ≤0.1) | 69% | 3 | 31% |
| 置信度 ≥ 0.95(或 ≤0.05) | 45% | 1 | 55% |
卡在 0.9,你能自动处理约七成、错三题;想再稳一点卡到 0.95,自动处理的量掉到四成半、错一题。而 DeepSeek 这根轴上没有可调的地方。它说 100% 都可以自动处理,因为它给每一题都打了满分。一旦它错了,你没有筛子可用。
怎么选
这些数字拼起来其实是一张挺清楚的决策表。
用 Jev 的时候,判断又多又小、延迟要压在毫秒级、你需要在代码里设一个阈值决定「自动还是要人看」、以及你要跑在预算里。它赢的场次里最典型的是机器门控,比如 agent 执行 shell 命令之前先问一句危不危险。
用聊天模型的时候,判断需要世界常识、需要多步推理、或者本来就只有几十条、跑一次不着急看结果。配料过敏那场就是例子。还有一类更现实的用法,让聊天模型做它擅长的事(写、改、总结),把判断交出去。
两者一起用的场合,生成交给聊天模型,核对交给 Jev。你让它写完一段话,再拿原文问一遍「这句有依据吗」,因为一次调用能问一批、每批几十毫秒,全量核对才变得划算。
边界
这份测试有几个必须说清的限制。
我们只测了一个聊天模型(DeepSeek 的 flash 档),换一个更强的模型,准确率和世界常识那一节的结果可能不同。题集是我们自己构造的,材料也是我们自己写的,所以这些数字说明的是两条路的形状,不是排行榜。调用都走公开 API,网络延迟算在里面,同一台机器、同一时段。价格是当天的公开价,会变。还有一条。我们没有第三方复核过任何一个数字,脚本和原始输出都在仓库里,任何人都能重跑。
复现命令与原始数据在 content/jev-vs-deepseek-2026-09/verify/ 与 content/jev-harness-tutorial-2026-09/verify/ 两个目录。