你的智能体这次满分通过,下次还会吗?
IBM Research 给智能体的「一致性」做诊断:GPT-4.1 的 ReAct 智能体在 AppWorld 上平均 77.4% 通过,但五次全过的任务只有 53.0%,差 24.4 个百分点。他们用一次采样找出容易翻盘的决策点、生成一致性准则,把差距砍到 12.0 个点,平均准确率不降。
中文
复制
你的智能体在排练时好好的,到了现场演示却走了另一条路,同一个任务失败了。
在台上这很尴尬。在生产环境里,这是一个可靠性问题:一次成功过的工作流,下次用户提同样的请求时可能就失败。对于对账一笔金融交易、或检查一份合同里有没有某项义务这类关键工作,这可能直接让整件事停摆。
大多数基准把这个波动藏在一个平均值后面。在 AppWorld 上,用 GPT-4.1 的 ReAct 智能体在五次重复中有 77.4% 的运行成功。但它只有53.0% 的任务是五次全过,这是 24.4 个百分点的一致性差距。
大多数基准报告的是前一个数字。我们做了一套办法来测量后一个数字,并且改善它。
在之前的一篇文章里,我们介绍了 ALTK-Evolve:一个把智能体自己过去的轨迹变成可复用准则的系统,准则自动蒸馏出来,在推理时注入回去。它确实能提高任务成功率,但那些结果问的也只是平均情况下的问题。本文介绍一致性准则,这是 altk-evolve 里的一种新准则类型,建立在我们称为一致性分析器(Consistency Analyzer)的诊断工具之上,直接针对这个差距。
太长不看(TL;DR)
- 准确率掩盖了一个不可靠的问题。 一个平均有 77.4% 成功率的 ReAct 智能体(GPT-4.1,AppWorld
test_normal),只有 53.0% 的任务能五次重复全过,这是 24.4 个百分点的一致性差距。在困难任务上这个差距能到 30 个点。 - 我们为这件事做了一件诊断工具。 一致性分析器对智能体自己录下的轨迹做重采样,找出容易翻盘的决策点,也就是模型差一个 token 采样就会做出不同选择的那些步骤。它只需要一条轨迹,不需要标准答案:对轨迹里的每个决策点,用一次请求要 k 个补全(默认 k=5)来重采样,而不是把整个任务端到端重跑。
- 把这个诊断变成准则,差距减半,从 24.4 个百分点降到 12.0 个百分点(同任务 Pass⁵ +16.0 个点,相似任务 +13.0 个点),而平均准确率一点没损失。
- 完整的方法与评测在 arXiv 上的技术报告里。
几乎没人报告的那个指标
标准的智能体评测报告 Mean@k:把基准跑 k 次,取通过率的平均。k 通常是 3,有时干脆是 1。它是每个排行榜上的那个数字,也就是实践中「77% 准确」的含义。
Mean@k 回答的是「这个智能体平均有多好」。它不回答真实用户在意的问题:我要是把一模一样的问题再问一遍,它还会好吗? 要回答那个,你需要 Pass^k:智能体在 k 次运行里全部成功的任务占比。
⚠️ Pass^k 不是 Pass@k。 大家熟悉的 Pass@k 是乐观的,它问的是 k 次尝试里至少有一次成功,当你能够验证并重试时,这是对的问题。Pass^k 是它悲观的那面镜子:每一次都必须成功。同样的字母,相反的问题。永远有 Pass^k ≤ Mean@k ≤ Pass@k。
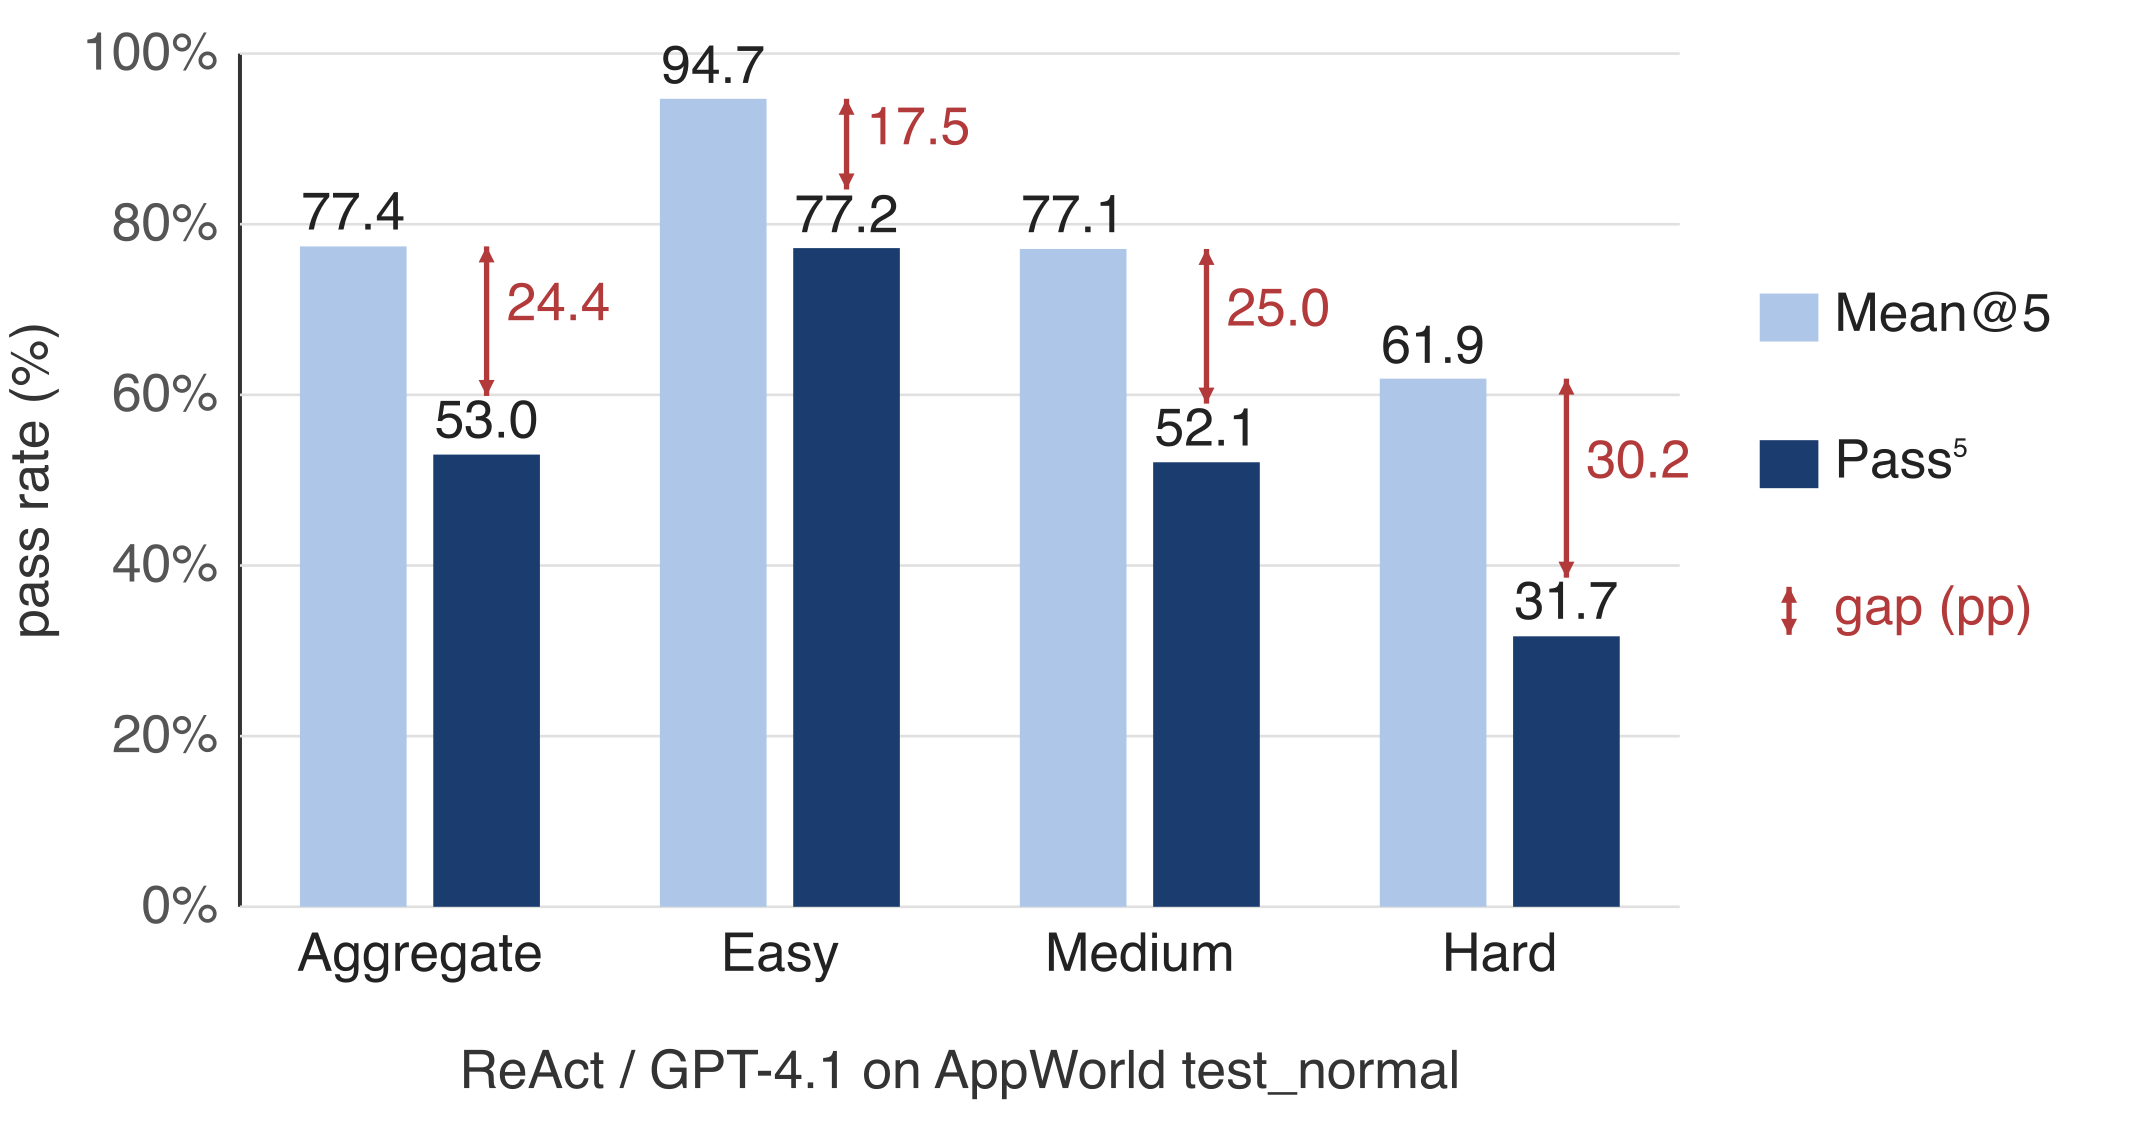
一个由 GPT-4.1 支撑的 ReAct 智能体拿到 77.4% 的 Mean@5,这确实很强。但 Pass^5 只有 53.0%。基准里将近四分之一的任务,是这个智能体有时能解、有时解不了,而任务本身在两次运行之间没有任何变化。我们把这个差距,也就是 Mean@k 减 Pass^k,称为一致性差距。
这不是靠更大的模型就能修掉的能力问题。它是一条正交的轴:一个智能体可以同时既能力强,又不稳定。
智能体为什么会翻盘:尖锐的决策与平坦的决策
每次 LLM 智能体决定某件事,无论是调用哪个 API、传什么参数、要不要重试,这个决定都来自一个关于下一个 token 的概率分布。要紧的是这个分布的形状。尖锐的分布把大部分概率质量压在单个 token 上:后面的候选差得远,于是同样的选择一次又一次出现。平坦的分布把差不多的质量摊在几个几乎并列的 token 上,谁赢几乎等于抛硬币。
形状决定了要多少噪声才能改变结果。尖锐的分布是有韧性的:GPU 浮点运算的非结合性、请求批处理,以及其他平台侧的效应会让数字轻微抖动,但远不足以把明显的赢家换掉。平坦的分布恰好就容易被这种抖动影响:几乎并列的项在小扰动下可能换位。而一条轨迹串起了几十个决策,每一步小小的翻盘概率会累积成相当可观的概率,让某一次运行走上不同的路。24 个点的差距就是这么来的。
这也解释了为什么这个问题不会被你的解码设置治好。贪心解码和固定随机种子管的都是分布如何被变成一个 token,它们对分布本身什么都没说。在托管端点上,概率会从一次运行到下一次运行轻微变化,所以同一个提示、同一个模型、温度设为零,今天可能把一个几乎并列的项解成这边,明天解成那边。
我们的设置: ReAct 智能体跑在温度 0.0,所以上面这些波动没有一项来自普通的采样。
先诊断,再修
这把问题变成了一个搜索:某条给定轨迹里,哪些步骤是平坦的那几个?知道之后你又该怎么办?
一致性准则来自一条两阶段的流水线,它接进 ALTK-Evolve 已有的机制,只是换了一个新的来源信号来决定写什么。
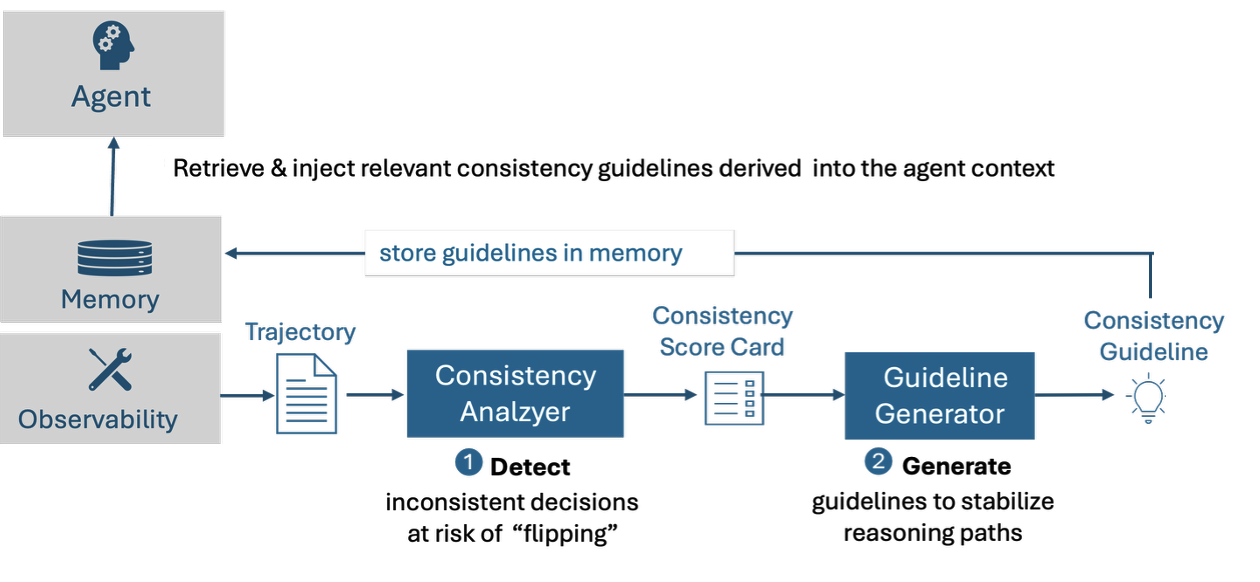
1. 检测:一致性分析器。
给定一条录下来的轨迹,分析器把每个决策步骤用受控的重采样重放一遍,测量模型在该点上的输出实际波动有多大。具体说,这是每个决策步骤多一次模型调用,离线做一次,请求时把采样参数设成一次抽 k 个补全(默认 k=5),并且是针对已经记录下来的上下文重放,不是新的工具调用,不是新的环境交互,也不是把任务再端到端跑一遍。这给出每个决策步骤的一致性分数,写进一张记分卡,精确定位哪些决策在下一次运行时有翻盘风险。检测完全是黑盒的:不需要 logits,不需要模型内部信息,也不需要在你已有的轨迹之外加任何埋点。
2. 生成:有针对性的准则。
每一个被标记的步骤都会变成一条候选一致性准则,用的是 ALTK-Evolve 的标准格式,所以它能直接进现有的存储与检索流水线。下面是一个真实例子,由 GPT-4.1 从 AppWorld 任务「How many activities are done in my bucket list as per my SimpleNote note?」的一条轨迹生成:
[准则 1] 在笔记内容里数复选框式标记时,用锚定到行首的正则匹配,而不是简单的子串计数,因为笔记标题常常在图例行里重复出现这个标记符号。 [准则 2] 对笔记类查询,始终核对搜索结果:检查是否有多个匹配,并在继续之前确认是正确的那条笔记。
这里没有任何任务特有的琐碎知识。字符串计数 bug 和未核实的搜索结果,是在许多 AppWorld 任务里都会出现、且不确定性很高的决策点。这正是要点:分析器瞄准的是不稳定,而不是失败,所以它能抓住那些智能体这次碰巧做对、下次很容易做错的步骤。
看这段两分钟的演示:智能体的五个并行运行在这个任务上因为对计数策略的不确定而分成 3 比 2,把上面这些准则放进上下文后再跑一次,五次全部一致。
结果:差距缩小,准确率不降
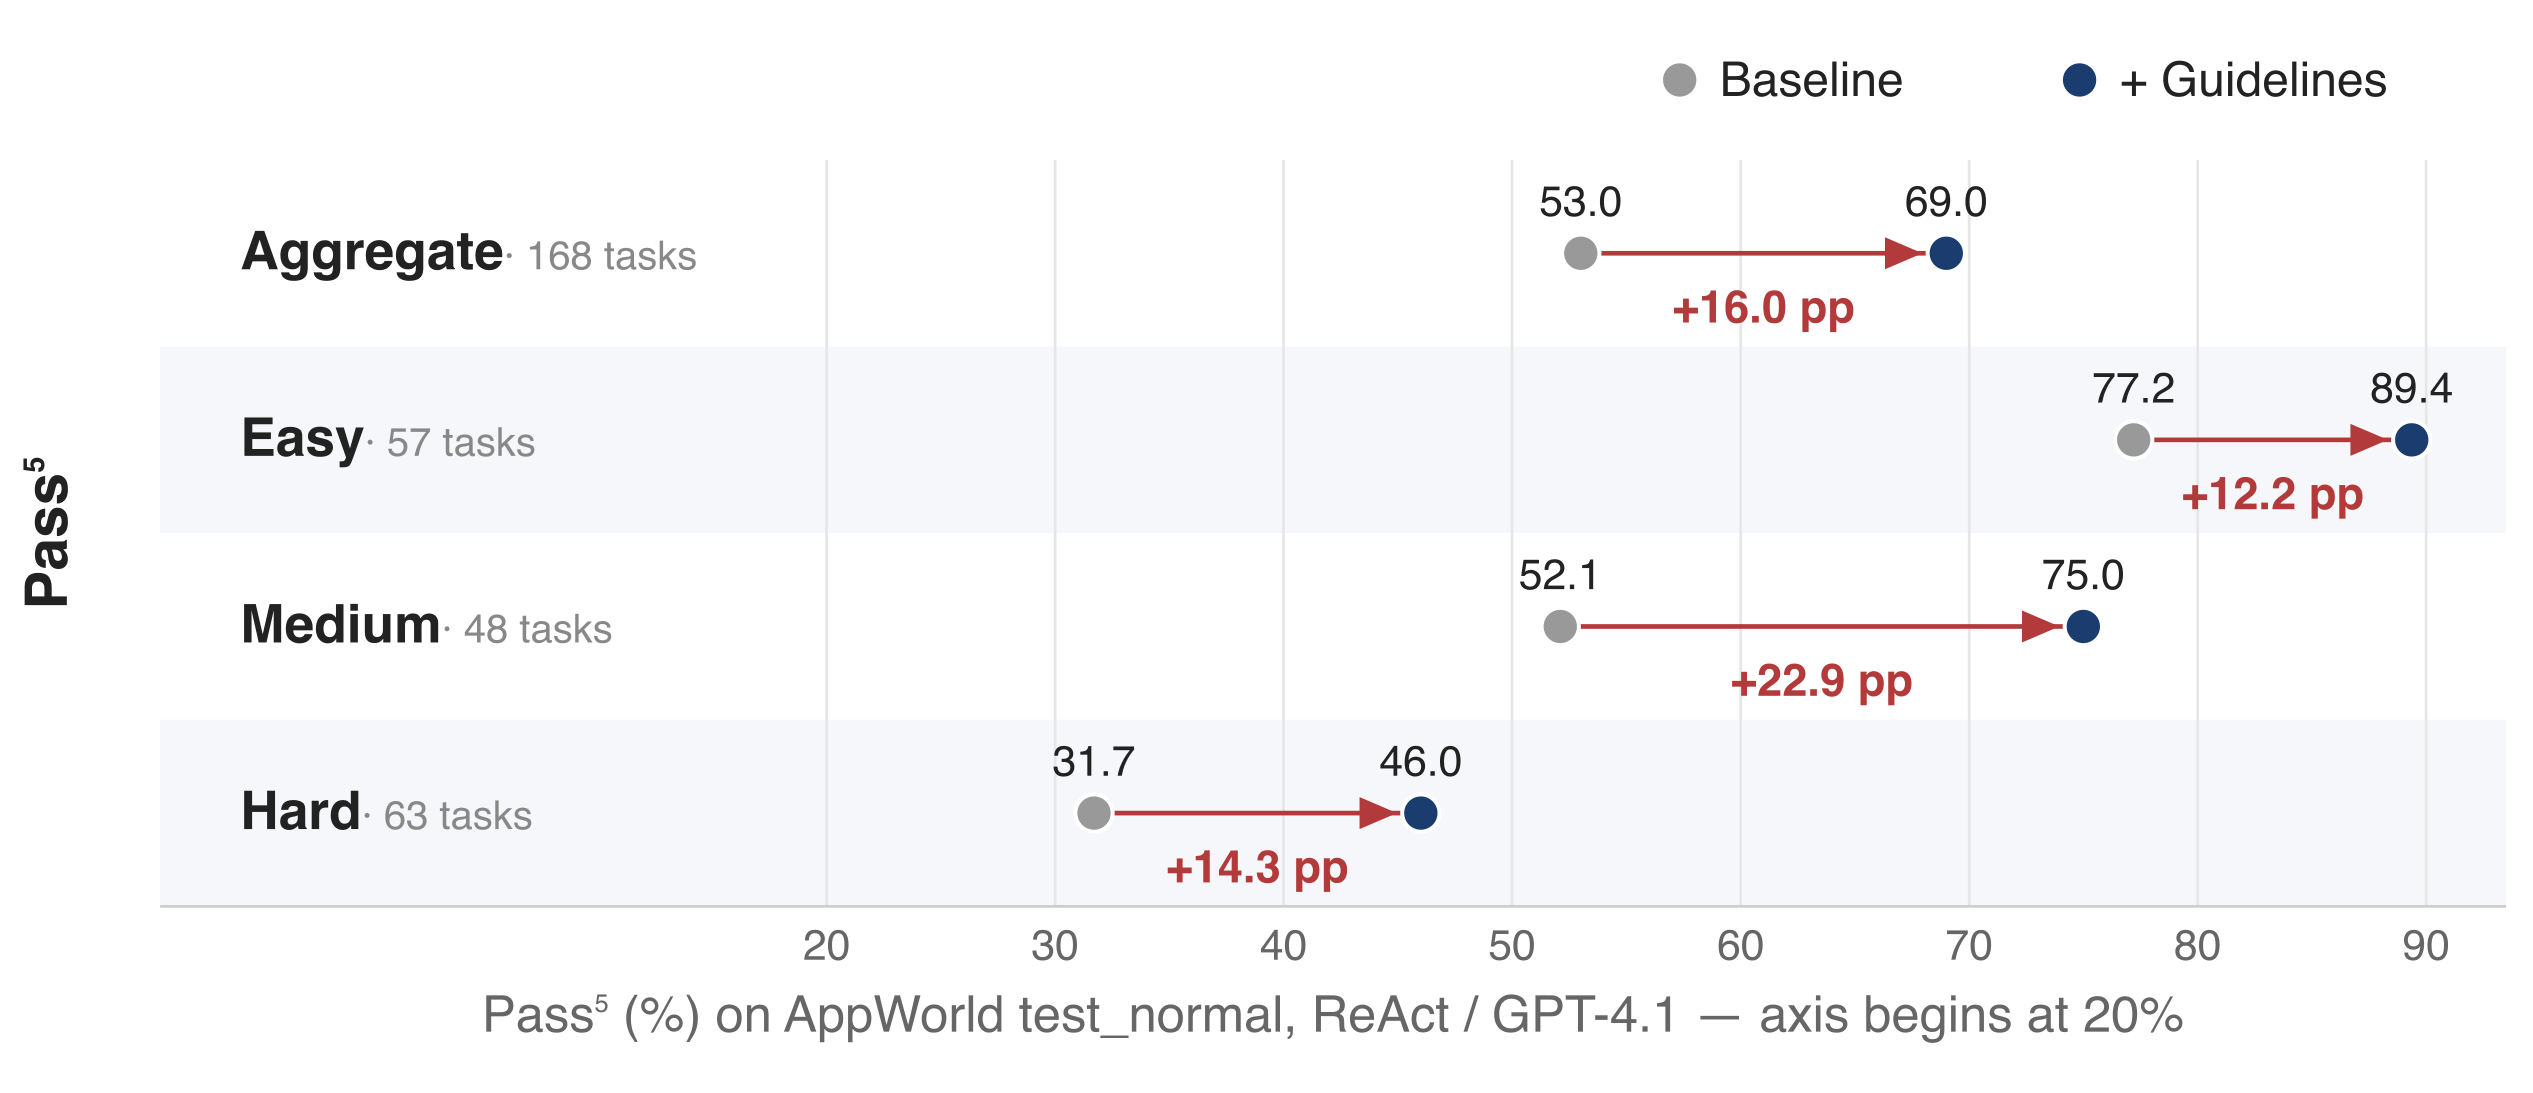
我们在 AppWorld test_normal(168 个任务)上评测,用 GPT-4.1 上的 ReAct 智能体,每个任务从一条基线轨迹生成一致性准则,然后在 5 次全新运行上测试。
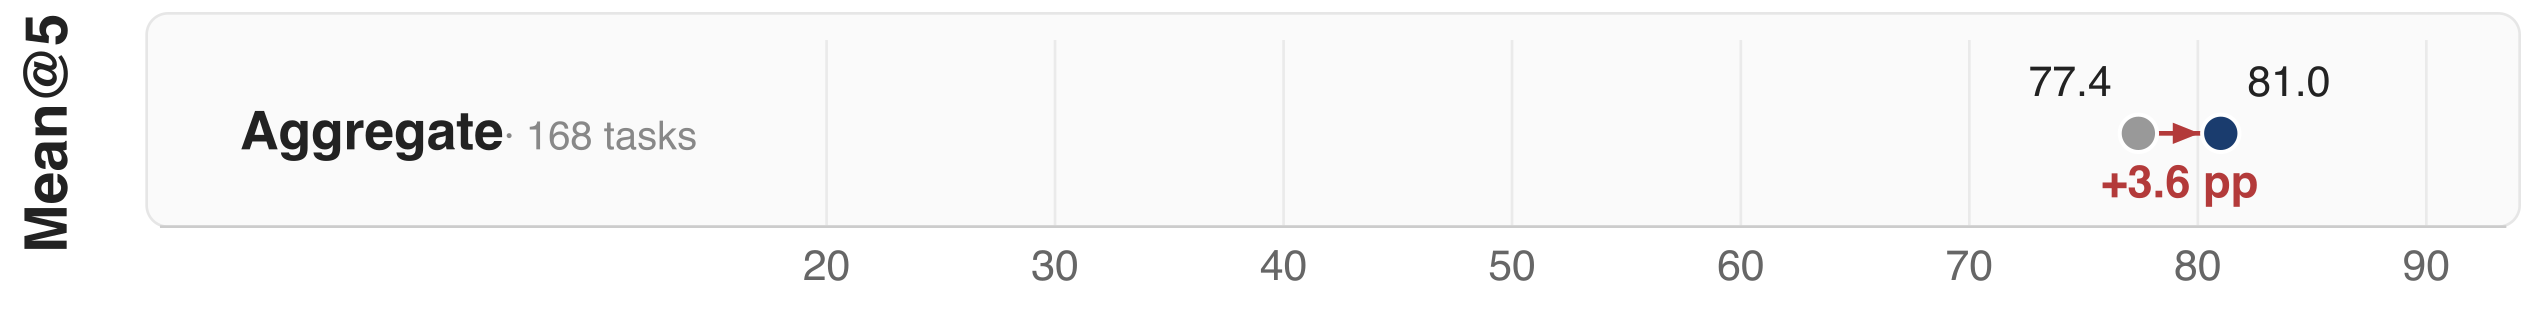
Mean@5(%),汇总值,与上面的 Pass^5 同一量纲。
一致性差距大约被砍掉一半。 汇总的 Pass^5 从 53.0% 升到 69.0%,同时 Mean@5 从 77.4% 升到 81.0%,把「看起来有能力」和「可以指望」之间的距离从 24.4 个百分点收窄到 12.0 个百分点。此前不稳定的任务里,将近三分之一变成了智能体每一次运行都能通过的任务。
中等档和困难档获益最多。 中等 +22.9 个点(相对 +44%),困难 +14.3 个点(相对 +45%),相对幅度上基本持平,绝对值上中等档领先。简单档 +12.2 个点,它本来可提升的空间就最小。这正是设计一致性准则要做的事:找出并稳定那些智能体自身的不确定性正在漏进结果的特定决策点。
Mean@5 从未下降。 保住平均准确率是硬要求,不是加分项:一个靠牺牲 Mean@5 来抬高 Pass^5 的系统,只是把不可靠挪了个地方,并没有修好它。在每个难度档上,平均准确率都保持住或者提高了。
这些准则能泛化,不是在给某一条轨迹打补丁
把它们应用到同一个 AppWorld 场景下另一个不同但相关的任务上(也就是准则被挖掘出来的那个场景的另一个变体),一致性准则仍然把 Pass^5 抬高了 +13.0 个点,只比同任务的数字低 3 个点。从一次运行里得出的准则,不只是在给那次运行打补丁,它抓住了一些能迁移的东西。
更锐利的证据来自一个更弱的模型 gpt-oss-120b。同任务 Pass^5 从一个低得多的基线上升了 +6.0 个点(10.1% → 16.1%),而且有意思的是,相似任务的泛化数字(+8.7 个点)实际上超过了同任务的增益,这说明这些准则抓住的是真正可复用的失败模式,而不是背下某一条轨迹的具体细节。
如果你正在把智能体交付上线
- 把 Pass^k 和 Mean@k 一起报告。 平均值分不出一个可靠的智能体和一个运气好的智能体;即使 k=3,也能暴露出一个你原本不知道自己有的差距。
- 预期这个差距会随难度变大。 你最难的档位,恰恰是单个平均值最容易误导人的地方。
- 别一上来就去找更大的模型。 一致性与能力是正交的。更强的模型会抬高 Mean@k,但不一定缩小一致性差距。
- 诊断不需要判分器,也不需要实时重放。 每个决策步骤多一次 LLM 调用(默认抽 k=5 个补全)就够了:不需要标准答案,不需要拿任务对着环境重跑。这才让它在生产流量上可用,因为在那里你往往连一次端到端重放都做不到。
试试看
试用 ALTK-Evolve:这个开源仓库现在包含了这些实验里用的一致性分析器和一致性准则生成,或者读 arXiv 上的技术报告,看完整方法。
如果你也遇到过那种在自己任务上复现不出来的准确率数字,我们很想听听:你自己智能体里容易翻盘行为的具体例子,正是会塑造我们下一步做什么的那类反馈。开一个 issue 或 discussion。
附录:理解这些指标
- Mean@k。 把任务跑 k 次,报告平均通过率,也就是大多数基准说的「准确率」。
- Pass^k。 智能体在全部 k 次独立运行中都成功的任务占比。永远 ≤ Mean@k。它也是用户把同一个查询跑两次时所体验到的结果。
- Pass@k。 k 次运行里至少一次成功,乐观的那个对应物,在代码生成类论文里很常见。
- 一致性差距。 Mean@k − Pass^k,以百分点计。
相关产物与参考
- ALTK-Evolve 开源仓库:github.com/AgentToolkit/altk-evolve
- 技术报告:arXiv
- 一致性准则演示:2 分钟视频