Jevが構造化出力を再び面白くする
著者は、Jevの価値は主にモデル自体ではなく推論戦略にある可能性があると考えている。返信をchoiceフィールドに事前入力し、制約されたトークンを1つだけ生成すれば、どのLLMでも「秘密のレシピ」の大部分を得られる——彼はQwen2.5-1.5Bで2〜3倍の高速化を試し出した。
日本語
コピー
Jev は構造化出力を再び面白くする
新しいモデルについてブログを書くのは僕の役目じゃない。それは Simon Willison の領分だし、彼はそれがうまい。でも Jev については書いておきたい。ひと味違う1 AI モデル、「System One」2 モデルだ。結論から言うと、普通の構造化出力付き LLM と_それほど_変わらない。ただインターフェースがとてもクールで、もっと一般的になってほしいと思っている。
Jev と LLM の違い
普通の LLM は何らかの人間言語のプロンプトを受け取り、何らかの人間言語の出力を返す。しかも_自己回帰_的にやる。トークンを一つ出し、また一つ出し、それを延々と続ける。
User: Who invented the sandwich?
LLM: The sandwich was invented by the Earl of Sandwich.おかげで極めて柔軟だ。コンピュータにできることなら理論上なんでもできる。その代わり遅くて風変わりでもある。遅いのはトークンごとに生成を一巡させるからで、風変わりなのは人間言語の空間が広すぎて、それで訓練されたモデルがかなり奇妙な挙動を見せるからだ。
Jev は人間言語のプロンプトを受け取るが、人間言語の出力は返さない。構造化出力しか出さない。
User: { state: "What color is the sky?", choices: ["blue", "red", "yellow"] }
Jev: { answer: "blue" }
ここまでは普通だ。LLM にもすでにできる。だが_構造化出力だけ_を出すモデルを作ると、面白くてありがたい性質が手に入る。
Jev は安定して速い
Jev はとにかく速い。 最速の応答は 70 ミリ秒程度で、普通の LLM なら数秒かかる。さらに良いことに、_最も遅い_応答でも 500 ミリ秒しかかからない。構造化出力しかやらないので自己回帰ではない。一回のフォワードパスで多数の問いに並列に答えられる。LLM が構造化出力を出すときは、{、 、answer、: といったトークンを連続するフォワードパスで一つずつ生成しなければならない3。Jev はそれを一発でやる。
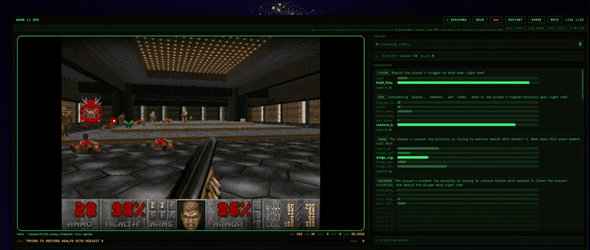
Jev の速さを最も雄弁に示す例は、このモデルが Doom をプレイできることだ。現在のゲーム状態をテキストで表現してモデルに食わせ、選択肢のセットを添える。「トリガーを押し続けるべきか」「今のターゲットは何にすべきか」「ターゲットが X だとしてどのキーを押すか」などなど。それだけで動く。遅延が十分低く、システムが十分賢いので、モデルはリアルタイムでそこそこ上手くプレイできる。
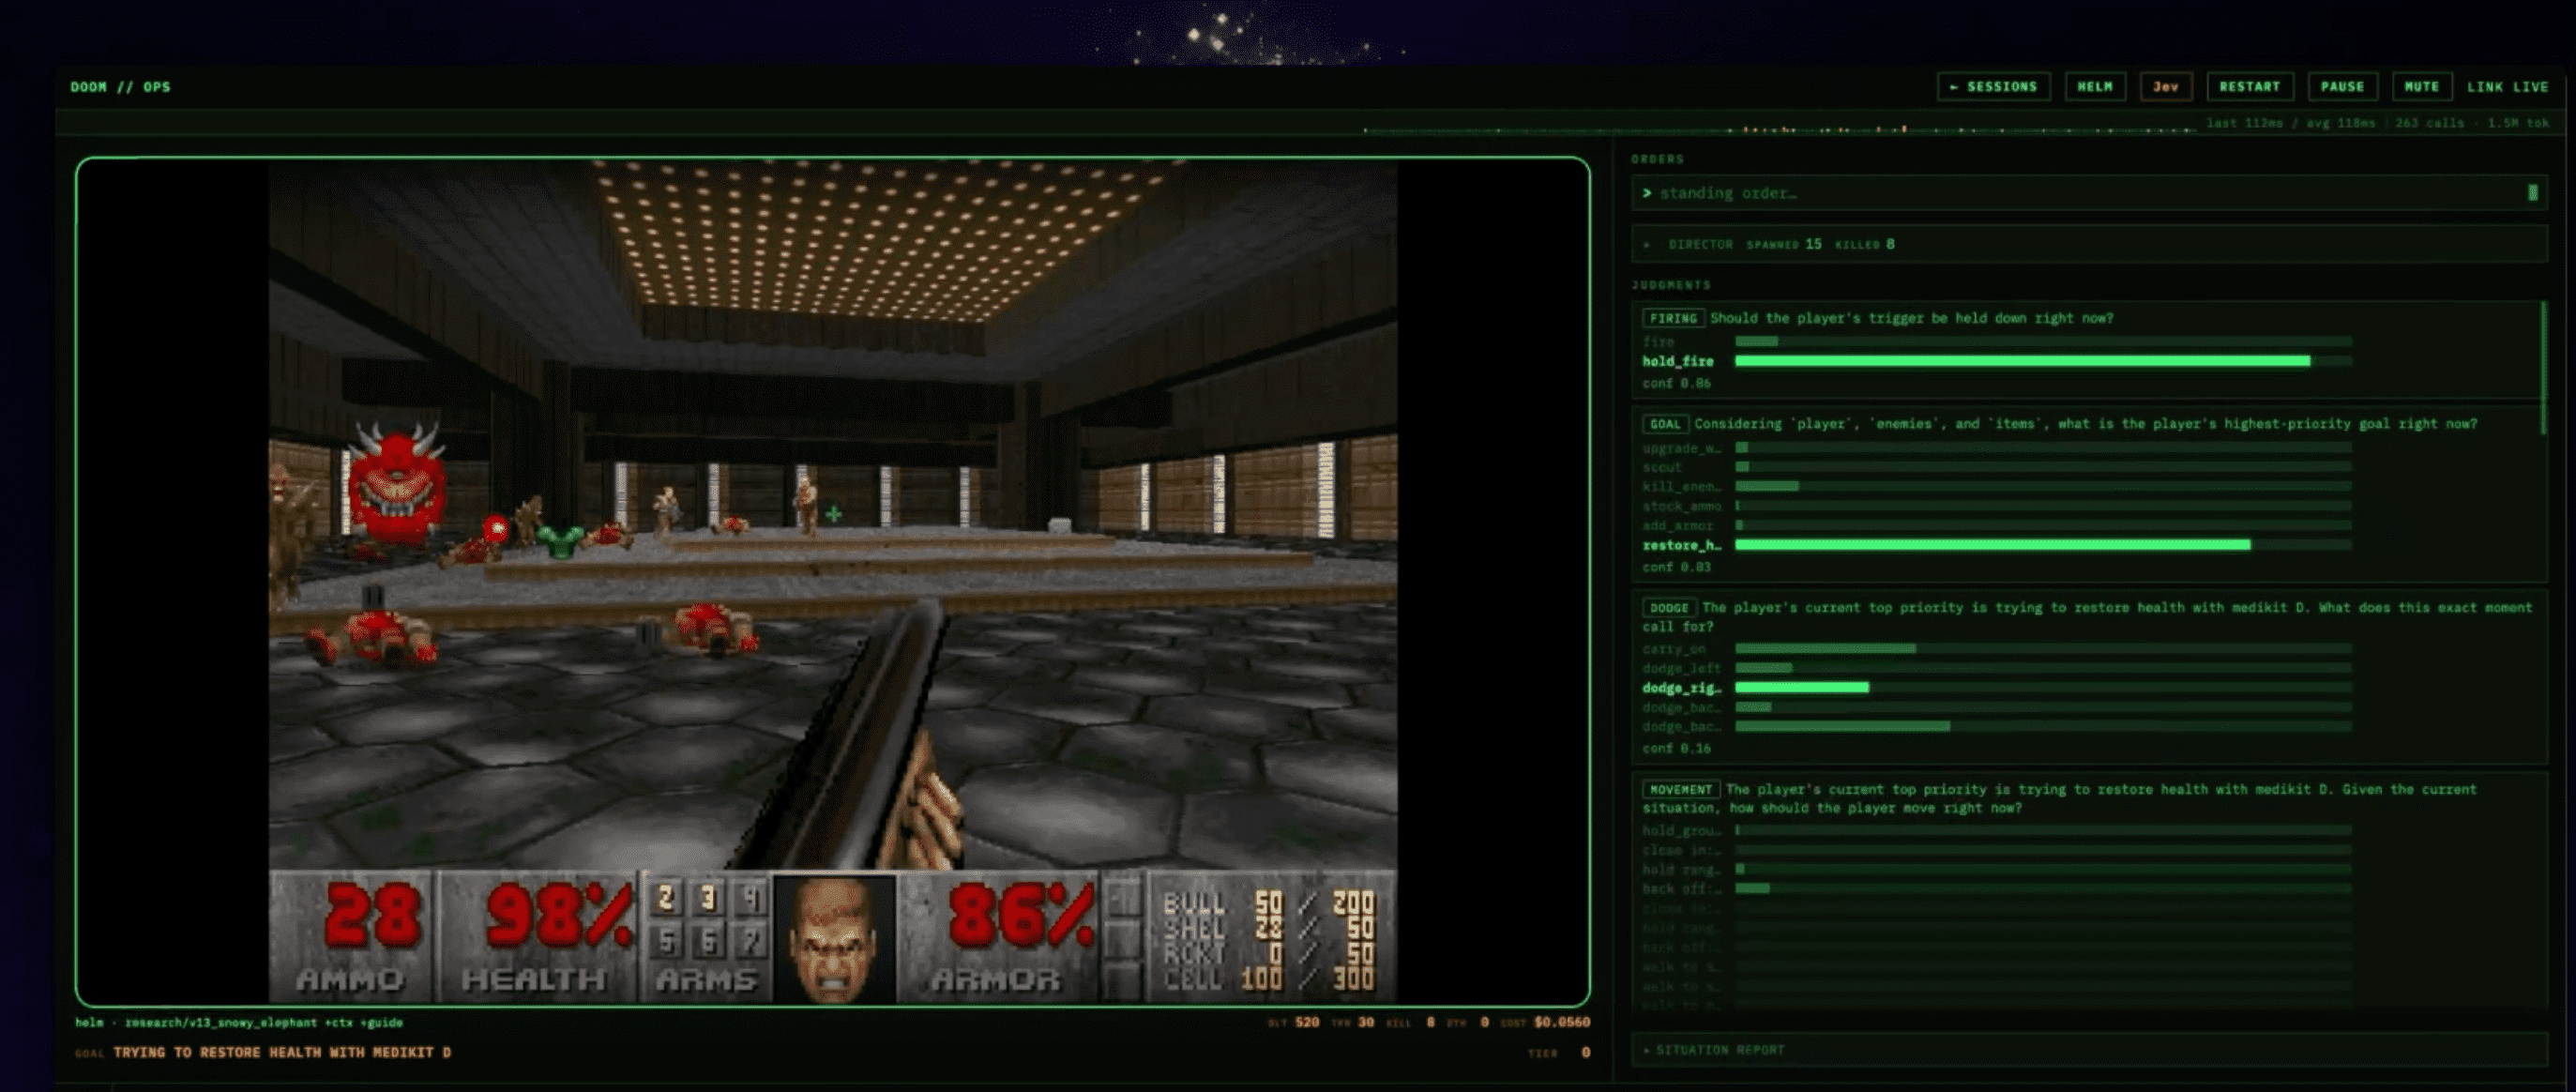
もちろん、Doom をプレイするニューラルネットワークの訓練なんて前からできた。でも Jev は_汎用_知能だ。LLM が確定申告を手伝い、数学の研究をし、Python 環境を直し、詩を書いてくれるように、Jev もゲームを一つ遊ぶ以外のタスクをいろいろこなせる。今の LLM でも Doom はプレイできる(遅いけど)。だが Nelson Elhage のあの言葉どおり、ソフトウェアが速くなるというのは同じタスクが速くこなせるというだけでなく、まったく新しい種類のタスクが可能になるということだ。あらゆる意思決定ポイントに 100 ミリ秒の、極めて安価な知能を注入できるとしたら、どんな新しいプログラムが書けるだろう?
僕にとって、これが Jev の一番エキサイティングなところだ。_速い_構造化出力は、知能に関する本当に新しい計算プリミティブになりうる。これまで自己回帰的なトークン生成の上に山ほどプログラムを積み上げてきたが、出来上がったのはどれも派手なチャットボットに見える。構造化出力に本気で賭ければ、チャットボット以外の AI ユースケースが一気に開けるかもしれない。
速い構造化出力は元々可能だった
Jev に対する僕の最大の不満は、速い構造化出力は元々すでに使えたと思っていることだ。LLM の構造化出力が遅いのは、(a) 誰も気にしていなかった4から、そして (b) 気にしていた人たちが欲しがったのは大きな JSON の塊だったからだ。だから普通は「文法制約付きデコーディング」で実装される。LLM はいつもどおり自己回帰的に出力し、logit サンプラーが構造化出力に合わないトークンを捨てる(たとえば [ がまだ出ていないのに ] は出せない)。
有限の選択肢に対する速くて並列な構造化出力が欲しいだけなら、自己回帰生成は厳密には不要だ。応答を "choice": " でプリフィルしてトークンを一つ生成し5、ユーザーが与えた選択肢に制限すればいい。LLM は入力トークンを全部並列に飲み込むので、構造化出力を丸ごと生成するよりずっと速い。多肢選択は普通の推論バッチ処理で一つのフォワードパスにまとめられる。長い構造化出力は無理だが、その代わりに Jev の「秘密のレシピ」の大部分6が手に入る。System One モデルの速度、安定性、並列性だ。
今日 Jev が発表されたあと、もう試している人がいて、悪くなさそうに見える7。つまり、Jev に本質的な技術的堀はないと思うし、彼らが謳う「キャリブレーションされた意思決定のための強化学習」も新しいスケーリング軸ではない。他のどのラボでも再現はかなり簡単だろうし、個人プログラマが既存のオープンソース LLM を速い Jev 風モデルに改造するのも同じくらい簡単だろう。
それでも Jev は「Qwen-32B-System-One」的なものの大半よりは良いはずだ。構造化出力だけに絞ってモデルをファインチューニングしたり最適化したりするのは、おそらく意味のある優位になる。
知能と幻覚
Jev がフロンティア LLM と同じくらい賢くなることは永遠にないと思う。テスト時計算をまったく使えない8のは大きなハンデで、この種のモデルの上限はおそらく非推論型 LLM の強さあたりに張り付く。実用上、低遅延アプリケーションならそれほど問題にはならないはずだが、これを新しいスケーリング軸とか、より賢いモデルを作る道筋と見なすべきではない。
Jev の開発者たちは、このモデルがハルシネーションの影響を受けないと主張している。私にはそれが意味論上の言い逃れに思える。というのも、Jev は間違いなく誤った選択肢を選ぶからだ(空を「赤」と言うなど)。厳密に言えばそれは単なる_誤り_で、モデルはユーザーが与えた選択肢の中から選んでいるのであって、新しいものをでっち上げているわけではない。とはいえ、同じことは構造化出力を使う普通の LLM にも当てはまるし、それが Jev を実用上より信頼できるものにしているわけでもない。
結論
Jev の価値のうちどれだけがモデル自体にあり、どれだけが「1 問につき 1 トークンだけ生成する」という推論戦略にあるのか、私にはまだわからない。公開されたデータとデモは、私の目には、Terra サイズのモデルを単一トークン推論スタックに差し込めば出てくるものに見える。ただ、関わっている人たちは皆信頼できるし、このモデルが良いものであることも信じている。ただ、LLM に JSON ブロックをトークンごとに出力させることを強制しない対照比較を示してほしいだけだ。
全体として、私は Jev が存在することを嬉しく思い、その成功を願っている。高速な構造化出力というこの領域で本当に競争が起きてほしいし、それが大手ラボに、自らファインチューニングしたモデルの正式版を出すよう促すきっかけになってほしい。GPT-5.6-Terra-System-One は、AI プロダクトを作るのに非常に面白いモデルになるだろう。
Footnotes
-
私は Thinking Machines の「インタラクションモデル」について実際に書いたことがある。これも AI 推論におけるパラダイムの一つで、実質的な違いを生むほど高速なものだ。 ↩
-
彼らは Jev を「System One」LLM と呼んでいる。これは Daniel Kahneman の一部が疑問視されている『ファスト&スロー』に由来する。同書で彼は人間の認知を、稲妻のように速い System One と、ゆっくり反省する System Two に分けている。 ↩
-
「待って、普通の LLM を思い切りプリフィルして、制約付きトークンを 1 つだけ出力させることはできないのか」と思ったなら、そのまま読み進めてほしい。 ↩
-
ツール呼び出しは含まない。ツール呼び出しは組み込みだが、構造化出力はそうではない。 ↩
-
ユーザーの選択肢の一部が単一トークンより長かったらどうするのか。自分では試していないが、それらを単一トークンに変換するか、選択肢の中身ではなく基層で「1/2/3」を出力するようモデルを訓練するか、選択肢の先頭トークンがそれぞれ異なる場合に先頭トークンだけを生成するか、あるいは私がまだ思いついていない別の巧妙な方法があるはずだ。 ↩
-
Jev は生成する確率が「校准済み」だと主張しているが、それが普通の logit 確率以上のものだという証拠は見ていない。おそらく、不確実な状況で正確な対数確率を出すようモデルを促す巧妙な訓練をしたのだろう(たとえばコイントスを予測するとき、モデルに
heads: 50, tails: 50を出力させるなど)。だとしたら、公開文でもっと書いてほしいものだ。 ↩ -
自分で
Qwen2.5-1.5B-Instructを使って試したところ、プリフィルなしの構造化出力に比べて 2〜3 倍の高速化が得られた。 ↩ -
何らかのリカレント Transformer にして、固定回数だけループさせることはできるだろう。だが推論らしきものを少しでも入れると、モデルのレイテンシが遅く予測不能になり、用途が完全に壊れてしまう。 ↩