Jev 让结构化输出重新变得有意思
作者认为 Jev 的价值可能主要在推理策略而非模型本身:把回复预填成 choice 字段、再只生成一个受约束的 token,任何 LLM 都能拿到大部分「秘密配方」——他用 Qwen2.5-1.5B 试出了 2 到 3 倍加速。
中文
复制
我不写关于新模型的博客。那是 Simon Willison 的地盘,而且他很擅长。但我想写写 Jev,它是一种不同1的 AI 模型:「System One」2模型。结果发现,它和普通带结构化输出的 LLM 并没有_那么_不同,但它的接口非常酷,我希望它变得更普遍。
Jev 和 LLM 有什么不同
普通 LLM 接收某种人类语言的提示,产出某种人类语言的输出。它们这样做是_自回归_的:先产出一个 token,再产出下一个,再下一个,如此继续。
User: Who invented the sandwich?
LLM: The sandwich was invented by the Earl of Sandwich.
这让它们极其灵活,因为凡是计算机能做的事它们理论上都能做。但这也让它们慢而古怪。慢,是因为每个 token 都要跑一整轮新的生成;古怪,是因为人类语言的空间太宽,你会在一个用它训练出来的模型上看到相当怪异的行为。
Jev 接收人类语言的提示,但它不产出人类语言的输出。它只产出结构化输出。
User: { state: "What color is the sky?", choices: ["blue", "red", "yellow"] }
Jev: { answer: "blue" }
到这里都还很普通:LLM 已经能做这件事。但结果是,如果你造一个_只_产出结构化输出的模型,你会得到一些有意思且令人想要的性质。
Jev 稳定地快
Jev 总是真的很快。 最快的响应时间大约是 70 毫秒,而普通 LLM 要几秒。更好的是,_最慢_的响应时间也只有 500 毫秒。因为 Jev 只做结构化输出,它不是自回归的:它可以在一次前向传播里并行回答许多问题。当一个 LLM 在产出结构化输出时,它必须用一次次连续的前向传播产出 {、 、answer、: 等等这些 token3。Jev 一次就全做完了。
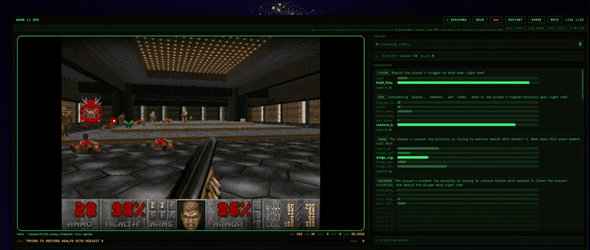
Jev 速度最有说服力的例子是,这个模型能玩 Doom。你可以把当前游戏状态的文本表示喂给模型,再配上一组选择,比如「扳机该不该按住」「当前目标应该是什么」「在当前目标是 X 的前提下该按哪个键」,等等,它就能跑起来——延迟足够低,系统也足够聪明,模型可以实时玩得不错。
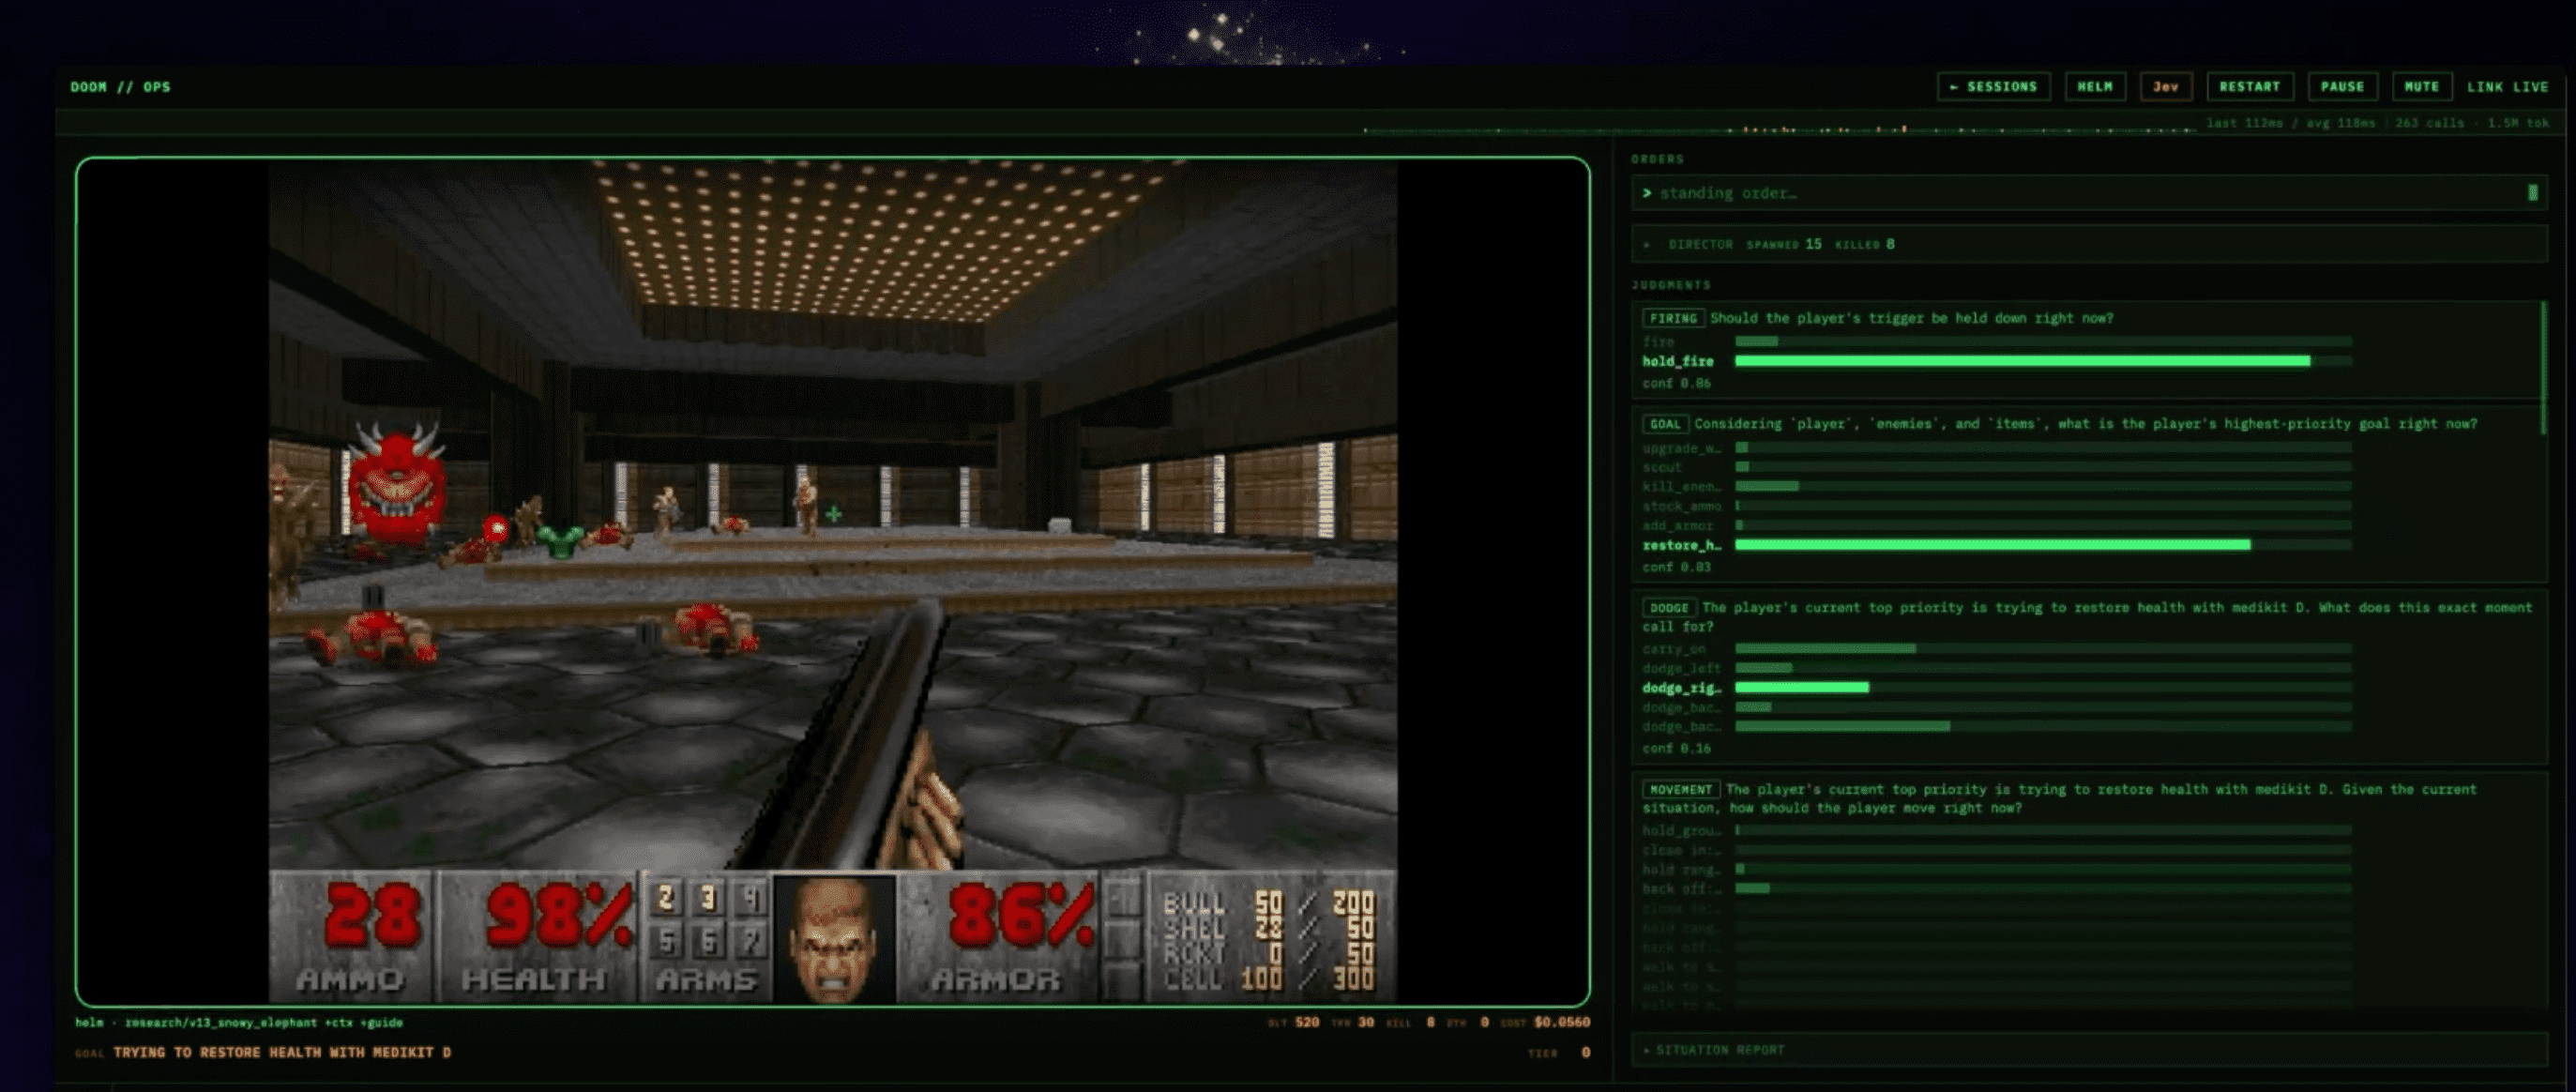
当然,你早就可以训练一个神经网络来玩 Doom。但 Jev 是_通用_智能:就像 LLM 能帮你报税、做数学研究、修你的 Python 环境、给你写首诗一样,Jev 除了玩一个电子游戏之外还能做很多别的任务。当前的 LLM 也能玩 Doom(虽然慢)。但正如 Nelson Elhage 那句名言,软件变快不只意味着同样的任务能做得更快,还意味着我们能做到全新种类的任务。如果在各种决策点注入 100 毫秒的、极其廉价的智能,我们能写出什么样的新程序?
对我来说,这是 Jev 最令人兴奋的地方。_快速_的结构化输出可能成为一种真正新的、关于智能的计算原语。到目前为止,我们在自回归 token 生成之上建了很多程序,它们看起来都像花哨的聊天机器人。狠狠押注结构化输出,也许能解锁一批非聊天机器人的 AI 用例。
结构化输出本来就可以很快
我对 Jev 最大的意见是,我认为快速的结构化输出本来就已经可用。LLM 的结构化输出之所以慢,只是因为 (a) 没人在乎它4,以及 (b) 在乎它的人想要大块的 JSON,所以它通常是用「语法约束解码」实现的:LLM 照常自回归输出,但 logit 采样器会丢掉不符合结构化输出的 token(比如还没出现过 [,你就不能输出 ])。
如果你想要的是针对有限选项的、快速并行的结构化输出,严格说根本不需要自回归生成。你只要把回复预填成 "choice": " 然后生成一个 token5,并限制在用户提供的选项里。因为 LLM 是并行吞下所有输入 token 的,这比生成整个结构化输出快得多。多个选择题可以通过普通的推理批处理合并进同一次前向传播。这不能做长篇的结构化输出,但换来的,是 Jev 那套「秘密配方」里的大部分6:System One 模型的速度、稳定性和并行性。
在今天 Jev 发布之后,已经有人开始试这个了,看起来效果还行7。换句话说,我怀疑 Jev 并没有实质的技术护城河,他们宣称的「为校准决策而做的强化学习」也不是一条全新的扩展轴。对任何其他实验室来说,复现它大概都相当容易;单个程序员把现有的开源 LLM 改造成快速的类 Jev 模型,大概也一样容易。
不过我怀疑 Jev 仍然会比大多数「Qwen-32B-System-One」之类的版本更好。只针对结构化输出微调或优化模型,大概是一项有意义的优势。
智能与幻觉
我怀疑 Jev 永远不会像前沿 LLM 那么聪明。完全用不上测试时算力8是个很大的劣势,很可能把这类模型的上限压在非推理型 LLM 的强度附近。实践中对低延迟应用来说这不该太要紧,但你不该把它看成一条新的扩展轴,或者一条造出更聪明模型的路。
Jev 的开发者宣称它不受幻觉影响。对我来说这像是一种语义上的躲闪,因为 Jev 绝对还是会选错选项(比如把天空说成「红色」)。我想严格说那只是_错误_,因为模型是在用户提供的选项里挑,而不是凭空编造新东西。不过,这些对带结构化输出的普通 LLM 也同样成立,而且它并没有让 Jev 在实践中更可靠。
结论
Jev 的价值有多少在模型本身、有多少在「每个问题只生成一个 token」的推理策略上,我还不清楚。发布里的数据和演示在我看来,像是把任何 Terra 尺寸的模型插进一个单 token 推理栈就能生成的。不过参与的人都很可信,我也相信这个模型不错——我只是希望他们能给出一些不强迫 LLM 逐 token 产出 JSON 块的对照比较。
总的来说,我为 Jev 的存在感到高兴,也希望它成功。我希望快速结构化输出这个领域真的出现一些竞争,也希望它能促使大实验室发布自家为此微调过的模型的正式版本。GPT-5.6-Terra-System-One 会是一个用来构建 AI 产品的非常有意思的模型。
Footnotes
-
我确实写过 Thinking Machines 的「交互模型」,那也是 AI 推理里一种快到足以产生实质区别的范式。 ↩
-
他们把 Jev 称为「System One」LLM,取自 Daniel Kahneman 那本部分已被质疑的《思考,快与慢》,他在书里把人类认知分成闪电般快的 System One 和缓慢反思的 System Two。 ↩
-
如果你在想「等等,难道不能把一个普通 LLM 狠狠预填一下,只产出一个受约束的 token 吗」,接着往下读。 ↩
-
不算工具调用,工具调用是内置的,而结构化输出不是。 ↩
-
如果用户的某些选项比单个 token 长怎么办?我自己没试过,但我确信你可以把它们转成单个 token,或者训练模型在底层输出「1/2/3」而不是选项内容,或者在选项的首 token 各不相同时只生成首 token,或者用我还没想到的别的巧妙办法。 ↩
-
Jev 宣称他们生成的概率是「校准过的」,但我没看到任何证据表明这些不只是普通的 logit 概率。也许他们做了什么巧妙的训练来鼓励模型在不确定情形下给出准确的对数概率(比如预测抛硬币时让模型输出
heads: 50, tails: 50)?如果是这样,我希望他们在发布文里多写一些。 ↩ -
我自己用
Qwen2.5-1.5B-Instruct试了,相比不做预填的结构化输出拿到了 2 到 3 倍的加速。 ↩ -
我想他们可以做某种循环 Transformer,固定循环若干次,但任何看起来像推理的东西都会让模型延迟变慢且不可预测,从而彻底破坏它的用途。 ↩