System Oneモデルでプログラミングする2つのテクニック
著者はQwen3-8BをSystem One分類器として接続した後、2つの手法を試した。階層的目標(10秒ごとに戦略、5秒ごとに戦術、200ミリ秒ごとに実行)とトーナメントサンプリング(一度に100個のリンクを2ラウンドで選別)で、後者はWikiracingで理想的な3リンク経路を見つけた。
日本語
コピー
System One モデルでプログラミングするための2つの技法
最近 Jev を書いた。これは新しい「System One」言語モデルで、出力するのは_意思決定_だけ——ユーザーが用意した選択肢の中から選んだ答えだ。ChatGPT のような従来の LLM に比べれば柔軟性はまるでない1が、その代わりに安定して速い。
Jev がどう動いているのか、正確には分かっていない。拡散だと言う人もいれば、Transformer アーキテクチャに何らかの改造を加えたものだと言う人もいるし、まったく新しい種類のモデルだと言う人もいる。だがそれは重要ではない。ここで論じたように、どんな LLM でも System One モデルに変えるのは難しくない。「トークンを1つ生成する」プロンプトと構造化出力をバッチ化すれば、安定して速い汎用分類器が手に入る。僕は感覚で基本版を組み立てて遊んでみた。これがそれで、Python およそ150行(大半はエラー処理)だ。
モデルに手を加える必要はない。logits が取れて(構造化出力に使う)、プロンプトにデータを事前に詰め込めれば、どんな LLM でも汎用の高速分類器にできる。この種のモデルでプログラミングするのはどんな感じか? 自分のライブラリのデモを配線する過程で2つの技法を学んだので書いておきたい。階層的な目標と、トーナメント式の選択サンプリングだ。
Doom
Qwen3-8B が Doom をプレイしているところ:
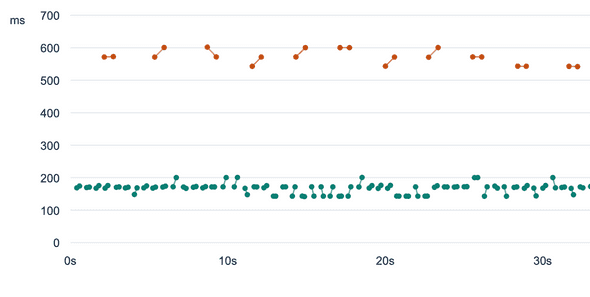
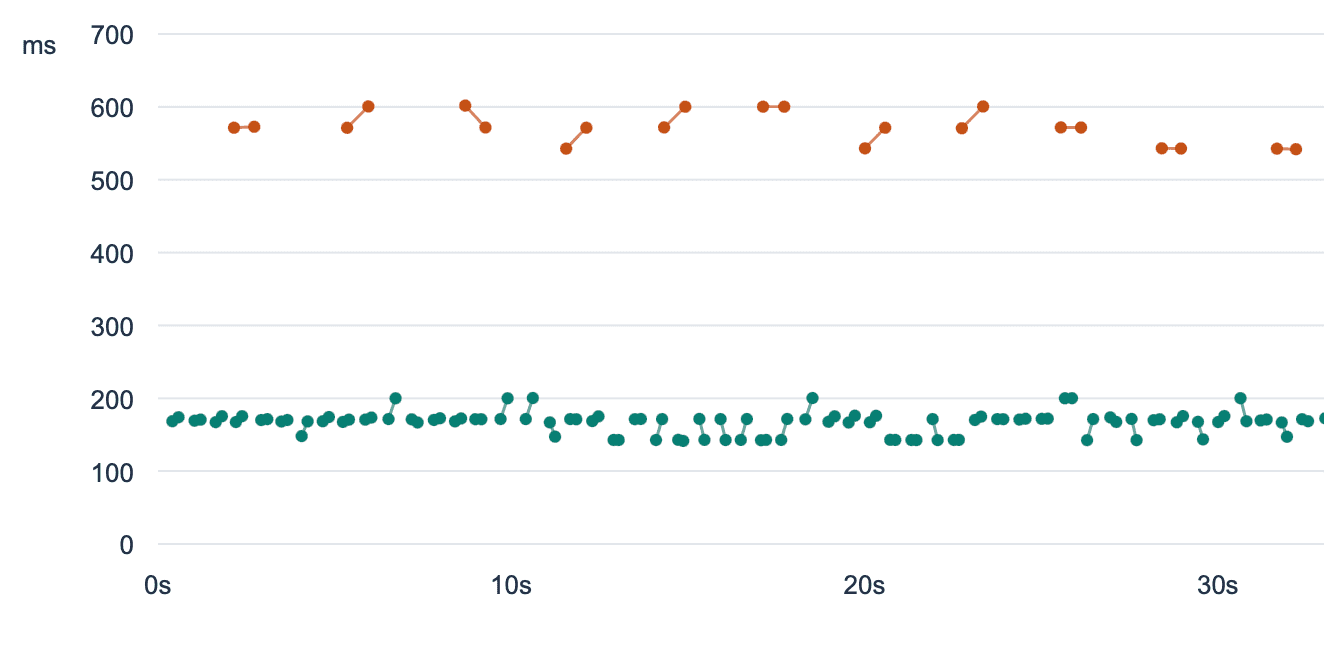
同じモデルが通常のツール呼び出しで Doom をプレイしている動画と比べれば、System One 版のほうがやることが多く、反応も速いのは明らかだ。ツール呼び出し版はおよそ600ミリ秒ごとに1回判断するのに対し、System One 版は190ミリ秒ごとに6〜7回まとめて判断する2:
Qwen3-8B も Jev もテキスト専用モデルなので、どちらのデモにもゲーム状態をテキストに変換する工程が要る。とはいえ、マルチモーダル LLM に差し替えるだけで画像(や音声)入力に対応させるのは簡単だ。
目標とサブ目標
Doom のデモを実装していて面白かったのは、ゲームの入力を選択肢として与えるだけではうまくいかないという点だ。1回のフォワードパス(200ミリ秒)は今のゲーム状態に反応するには十分でも、目下の短期的な目標(「この敵を倒す」「このアイテムを拾う」など)を導き出してそれを選ぶだけの計算量には足りない。そのまま繋いだところ、モデルは100%の時間「射撃」キーを押し続け(まあ、押さない理由もない)、レベル内をあてもなくうろついていた。
解決策は、モデルに固定された短期的な目標の集合(「アーマーを拾う」「敵を殺す」など)から定期的に選ばせ、選ばれた目標を200ミリ秒ごとに走る通常のプロンプトに埋め込むことだった。Jev のデモの Doom 動画を見れば、彼らがまさにこれをやっているのが分かる。僕もそうしたら、モデルはより人間らしいプレイをするようになった。
System One モデルにとって、これは面白い技法だ。ある意味では通常の LLM 推論に相当する。同じ問題により多くの計算量を注ぐ手段を提供しているからだ。リアルタイムシステムがこんなふうに何層もの目標を管理する姿は想像できる:
- 10秒ごとのループで、全体的な戦略目標を決める
- 5秒ごとのループで、(1) に基づいて戦術的なサブ目標を決める
- 1秒ごとのループで、現在の戦術サブ目標を具体的な対象に分解する
- できるだけ速く回る内側のタイトなループ(たとえば100ミリ秒ごと)で、実際にどの入力を有効にするかを制御する
この全体構造は、ゲーム AI やロボティクス AI をやったことがある人には馴染みのはずだ。理論上は (1) を本物の LLM に差し替えて、(2) と (3) の選択肢リストを生成させることもできる。実際にはこれを正しくやるのは難しいだろうし、あらかじめ考えうる目標をすべてリストとして書き出しておくほうがいい。ゲームをプレイする場合や、すでによく理解しているタスクなら、それで十分だ。
Wikiracing
Jev の発表記事にある Wikiracing のデモも実装し直した。Wikipedia の「baseball」ページから「sun」ページへ、できるだけ速くたどり着くというものだ。動画はここで見られるが、Doom のデモほど印象的ではない。
Doom のデモで難しかったのは、モデルを十分速く回し、短期的な計画を維持させることだった。Wikiracing で難しいのは_規模_だ。Wikipedia の「baseball」ページには1000を超える内部リンクがある。Jev は1つの問題につき255個の選択肢しか扱えず、僕の継ぎ接ぎの System One レイヤーも似たようなものだ。技術的にはもっと多くの選択肢に拡張できるが、100個を超えたあたりから機能しなくなる3。
Jev がここで採っているのは「まず独立に採点し、次に明示的に選択する2段階のシステム」だ。僕のところではこれがひどくうまくいかなかった。Jev は信頼度推定を出すように専門に訓練されているぶん、ここで恩恵を受けているのだと思う。Qwen3-8B は数百のリンクに同じ最高スコアを付けてしまい、役に立たない。その結果、2つのページ間の30〜40リンクの経路を見つけるのに数分かかっていた。
僕が代わりに使ったのはトーナメントサンプリングだ。100個のリンクを一度に食わせて1ラウンド選択し、選ばれたリンクで2ラウンド目を行う。これが_非常によく_効いた。モデルは理想的な3リンクの経路を見つけた(興味があれば:「baseball」/「scientific american」/「amateur astronomy」/「sun」)。たくさんの選択肢の中から最良のものを見つけたいなら、このパターンを勧める。普通の LLM は絶対評価よりも相対判断のほうがはるかに得意だ。
結論
System One モデル(高速な汎用分類器)が、チャットボット以外の AI システムを構築するうえで持つ可能性については、今も楽観視している。リアルタイム性が求められる場面や、推論にかかる時間を予測できる必要があるユースケースでは、ツール呼び出しに代わる意味のある選択肢だと感じる。汎用 LLM がドメイン特化モデルにしばしば勝つのと同じように、汎用の System One モデルもドメイン特化の分類器に時に勝つはずだ(ただし、常に大きくて遅い)。
大手ラボが、自社の小型で高速なモデルの「選択だけ」バージョンを出して対抗してくるのは間違いない。Jev が少しでも注目を集めれば、System One Terra や System One Haiku はすぐに出てくるだろうし、私が勘で作った System One ライブラリの「公式」版も必ず出る。こうしたモデルでプログラムを書く最良の方法は、今から探り始めるべきだ。
System One モデルは汎用分類器だと考えればいい。タスクごとに新しい分類器を訓練する代わりに、System One モデルを 1 つ使う。カスタム分類器モデルより大きくて遅いが、はるかに柔軟で、モデルを再訓練せずにプロンプトを調整するだけで微調整できる。
Footnotes
-
厳密には、「次の文字はどれか」という選択問題を出せば、通常の自己回帰 LLM のように振る舞わせることもできる。だが、実際にはうまくいかない。 ↩
-
最初は 4090 を使った。500 ミリ秒ごとに意思決定できたが、Doom には速さが足りなかった。さらに最適化することもできたが、H100 を 10 分だけ借りてデモを録画し、ループを 190 ミリ秒まで縮めた。ツール呼び出し版の Doom デモも H100 で録画したので、この比較は公平だ。 ↩
-
ここには面白い研究課題がある。こうした選択肢をどう実装するかだ。単一トークンで予測できる必要があるからだ。最初はインデックスを使ったが、「ラベル」(選択肢に特定のトークンを対応させる方式)のほうが Wikiracing では_はるかに良い_成績だった(Doom ではそうでもなかった)。選択肢がいくつあれば、ラベルはインデックスより優れるのか。もちろん、モデルを変えて選択肢を直接出力させることもできるが、私は「これらすべてがどんな LLM の推論コードでも実現できる」という考えが気に入っている。 ↩