用 System One 模型编程的两种技巧
作者把 Qwen3-8B 接成 System One 分类器后试出两招:分层目标(每十秒定战略、每五秒定战术、每 200 毫秒执行)与锦标赛采样(一次喂一百个链接分两轮选),后者在 Wikiracing 里找到了理想的三链接路径。
中文
复制
我最近写了 Jev,那是一种新的「System One」语言模型,它只输出_决策_:一组由用户提供的选择题的答案。这意味着它远不如 ChatGPT 这类传统 LLM 灵活1,但换来的是稳定的快。
我们并不确切知道 Jev 是怎么工作的。我见过有人说扩散,有人说是对 Transformer 架构的各种改造,也有人说是某种全新的模型类型。但这不重要。就像我在这里论证过的,把任何 LLM 变成 System One 模型都不难。把「生成单个 token」的提示与结构化输出批处理起来,你就得到一个稳定快速的通用分类器。我凭感觉搭了一个基础版本来玩,在这里,大约 150 行 Python(其中大部分是错误处理)。
注意,这不需要改动模型。只要你能拿到 logits(做结构化输出用)并且能把数据预填进提示,你就能把任何 LLM 变成一个通用的快速分类器。用这种模型编程是什么感觉?在为我的库接线做演示的过程中,我学到两个技巧,想写下来:分层目标,以及锦标赛式选择采样。
Doom
下面是 Qwen3-8B 在玩 Doom:
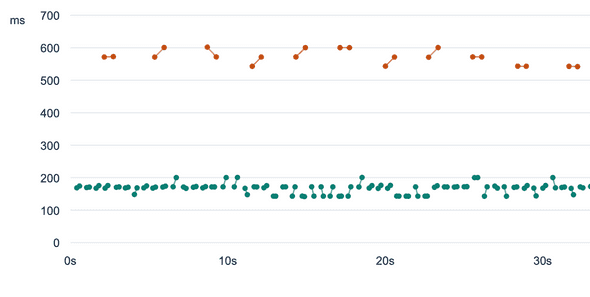
如果你把它和同一个模型用常规工具调用玩 Doom 的视频对比,很明显 System One 版的模型做的事更多、反应更快。工具调用版大约每 600 毫秒做一次决策,而 System One 版每 190 毫秒做六到七次批量决策2:
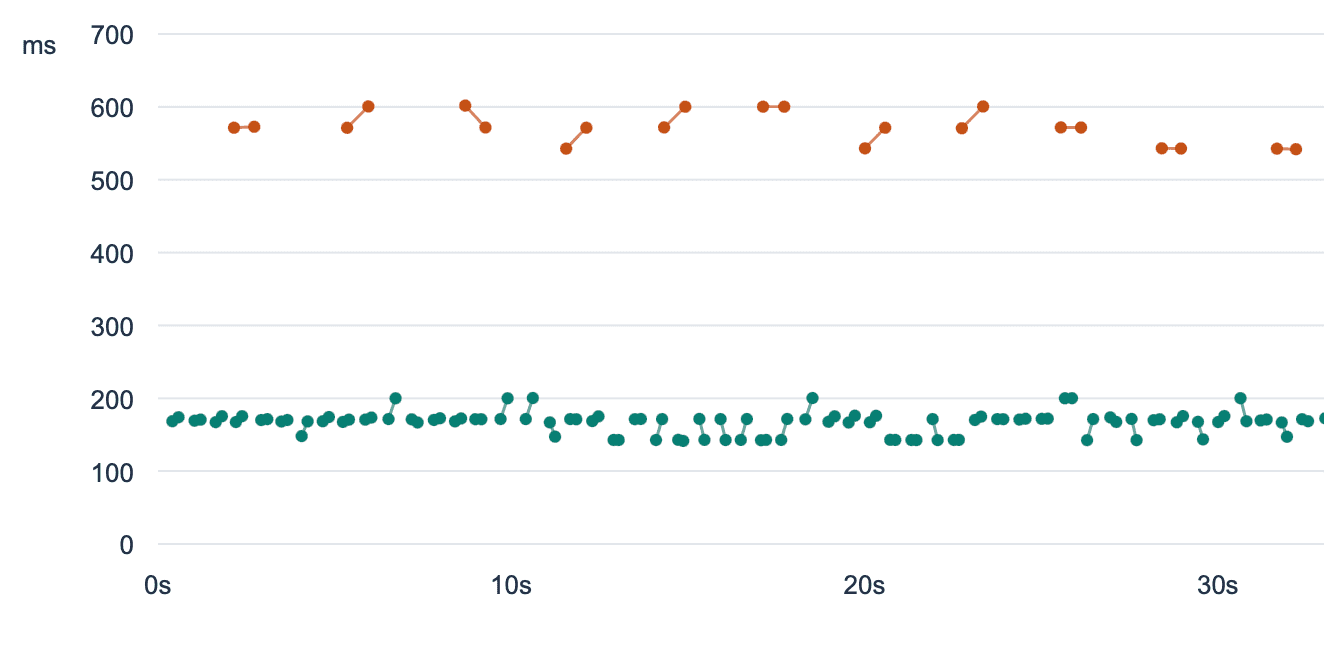
Qwen3-8B 和 Jev 都是纯文本模型,所以两个演示都需要一个把游戏状态转成文本的步骤。不过,要支持图像(或音频)输入也很容易,只要换一个多模态 LLM。
目标与子目标
实现 Doom 演示时有意思的地方在于,仅仅把游戏输入作为选项提供出去,效果并不好。单次前向传播(200 毫秒)足够对当前游戏状态做出反应,但带不来足够的算力去推导出当前的短期目标(比如「干掉这个敌人」「捡起这件物品」)并选择去执行它。我那样接起来的时候,模型 100% 的时间都按着「射击」键(我猜,为什么不呢),然后在关卡里漫无目的地乱逛。
修法是周期性地让模型在一组固定的短期目标之间做选择(比如「捡护甲」「杀敌人」),然后把选中的目标放进那个每 200 毫秒跑一次的常规提示里。如果你去看 Jev 演示里那个 Doom 视频,能看到他们做的正是这件事。我也这么做了之后,我的模型开始以更像人的方式玩。
对 System One 模型来说,这是个有意思的技巧。某种意义上,它相当于常规的 LLM 推理,因为它提供了一种在同一个问题上用更多算力的办法。我能想象一个实时系统用这种方式管理好几层目标:
- 每十秒一个循环,设定总体的战略目标
- 每五秒一个循环,基于 (1) 设定战术子目标
- 每秒一个循环,把当前战术子目标拆成具体靶标
- 一个尽可能快跑的内层紧循环(比如每 100 毫秒),控制实际激活哪些输入
这个总体结构对做过游戏 AI 或机器人 AI 的人来说应该很熟悉。理论上你可以把 (1) 换成一个真正的 LLM,让它为 (2) 和 (3) 生成选项列表。实践中我怀疑这很难做对,更好的办法是提前把所有可能的目标写成一份清单。对玩游戏和已经理解得很透的任务来说,这样完全够用。
Wikiracing
我还重新实现了 Jev 发布文里的 Wikiracing 演示:模型要从维基百科的「baseball」页面出发,尽可能快地导航到「sun」页面。你可以在这里看那段视频,不过它不如 Doom 演示那么惊艳。
Doom 演示的难点是让模型循环得足够快、并坚持短期计划。对 Wikiracing 来说,难点是_规模_:维基百科的「baseball」页面有一千多个内部链接。Jev 单个问题只支持 255 个选项,我那个拼凑的 System One 层也差不多。虽然从技术上说它可以扩展到更多选项,但超过一百个左右之后它就不太管用了3。
Jev 在这里的做法是「先独立打分、再做出明确选择的两阶段系统」。这在我这里效果很差。我认为 Jev 在这里受益于它是专门训练来给出置信度估计的。Qwen3-8B 给了几百个链接同样的最高分,这没什么用。结果它在两个页面之间找一条三四十个链接的路径要花好几分钟。
我改用的办法是锦标赛采样:每次把一百个链接喂进去做一轮选择,再用选出来的链接做第二轮。这个效果_非常好_。模型找到了理想的三链接路径(如果你好奇:「baseball」/「scientific american」/「amateur astronomy」/「sun」)。如果你要在很多选项里找最好的那个,我推荐这个模式。普通 LLM 在相对判断上比在绝对评分上强得多。
结论
我对 System One 模型(快速通用分类器)用来构建不只是聊天机器人的 AI 系统的潜力仍然乐观。感觉对于实时场景,或者你需要可预测推理耗时的用例,这是工具调用的一个有意义的替代。就像通用 LLM 常常胜过领域专用模型一样,我认为通用的 System One 模型有时也会胜过领域专用的分类器(尽管它们总是更大更慢)。
我确实认为大实验室肯定会尝试通过发布自家小而快的模型的「只做选择」版本来竞争。如果 Jev 获得任何关注,我们很快就会看到 System One Terra 和 System One Haiku,也肯定会看到我那个凭感觉搭的 System One 库的「正式」版本。我们现在就该开始摸索用这些模型写程序的最好方式。
你可以把 System One 模型想成通用分类器。不必为每个任务训练一个新分类器,你可以用一个 System One 模型。它比定制的分类器模型更大更慢,但灵活得多,而且你可以通过调整提示来微调它,而不必重新训练模型。
Footnotes
-
严格说,你可以给它「下一个字母是哪个」这种选择题,让它表现得像普通的自回归 LLM,但那样其实行不通。 ↩
-
我一开始用 4090,它能每 500 毫秒做一次决策,但对 Doom 来说不够快。我大概可以再优化,但我干脆租了一台 H100 十分钟来录演示,把循环降到 190 毫秒。工具调用版的 Doom 演示我也是在 H100 上录的,所以这个对比是公平的。 ↩
-
这里有一个有意思的研究问题:这类选项该怎么实现,因为它们必须能被单个 token 预测。我一开始用索引,但发现「标签」(就是挑某个 token 与选项关联)在 Wikiracing 上表现_好得多_(Doom 上则不然)。要有多少个选项,标签才会比索引更好?当然,你可以改模型让它直接输出选项,但我喜欢「所有这些都能在任何 LLM 的推理代码里做到」这个想法。 ↩