1本のライブストリーム、80言語:MoQベースのリアルタイムAI翻訳
Fishjam が MoQ(Media over QUIC)でリアルタイム AI 翻訳を実現:80 以上の言語をオンデマンド生成、ある言語のトラックを購読することがそのリクエストになり、シグナリングもバックエンドも不要;遅延はクライアント側のバッファリングで再生クロックを揃えて解決し、言語を切り替えても映像には触れない。
日本語
コピー
1本のライブ配信、80言語:MoQ によるリアルタイム AI 翻訳
同じライブ配信をスペイン語で見てもいいし、日本語で見てもいい。配信中にメニューから80以上の言語のどれかに切り替えることもできる。翻訳された音声は映像と同期したまま、字幕のように3秒遅れて漂うことはない。
これが translate.fishjam.io だ。ノート PC から配信を始め、スマホでリンクを開き、言語を選ぶと、自分が一度も学んだことのない言語を話している自分の声がリアルタイムで聞こえる。ここから先はその仕組みの話だ。思っているより短い。ほとんどの仕事は MoQ(Media over QUIC)がやってくれているからだ。
構成
使ったのは Gemini 3.5 のリアルタイム翻訳モデルだ。音声を流し込むと翻訳を話して返してくる。モデルはひとつ、音声から音声へ。「文字起こし→翻訳→合成」のパイプラインを面倒を見る必要はない。
リアルタイム文字起こしは今や誰でもやっている。会話をリアルタイムで翻訳するアプリもある。だがそれは常に脇道のチャンネルだ。テキストが映像の横を流れていくか、吹き替えが話し手より遅れて漂う。欲しかったのは本物のほうだ。ひとつの放送で、翻訳された音声がそのまま音声トラックであり、映像と同期している。
だから部品表は短い。
- Web アプリ。配信ページと視聴ページがある。
- Python サービス。音声を Gemini に流し込み、翻訳を publish し返す。
- その間をつなぐ Fishjam の MoQ リレー。
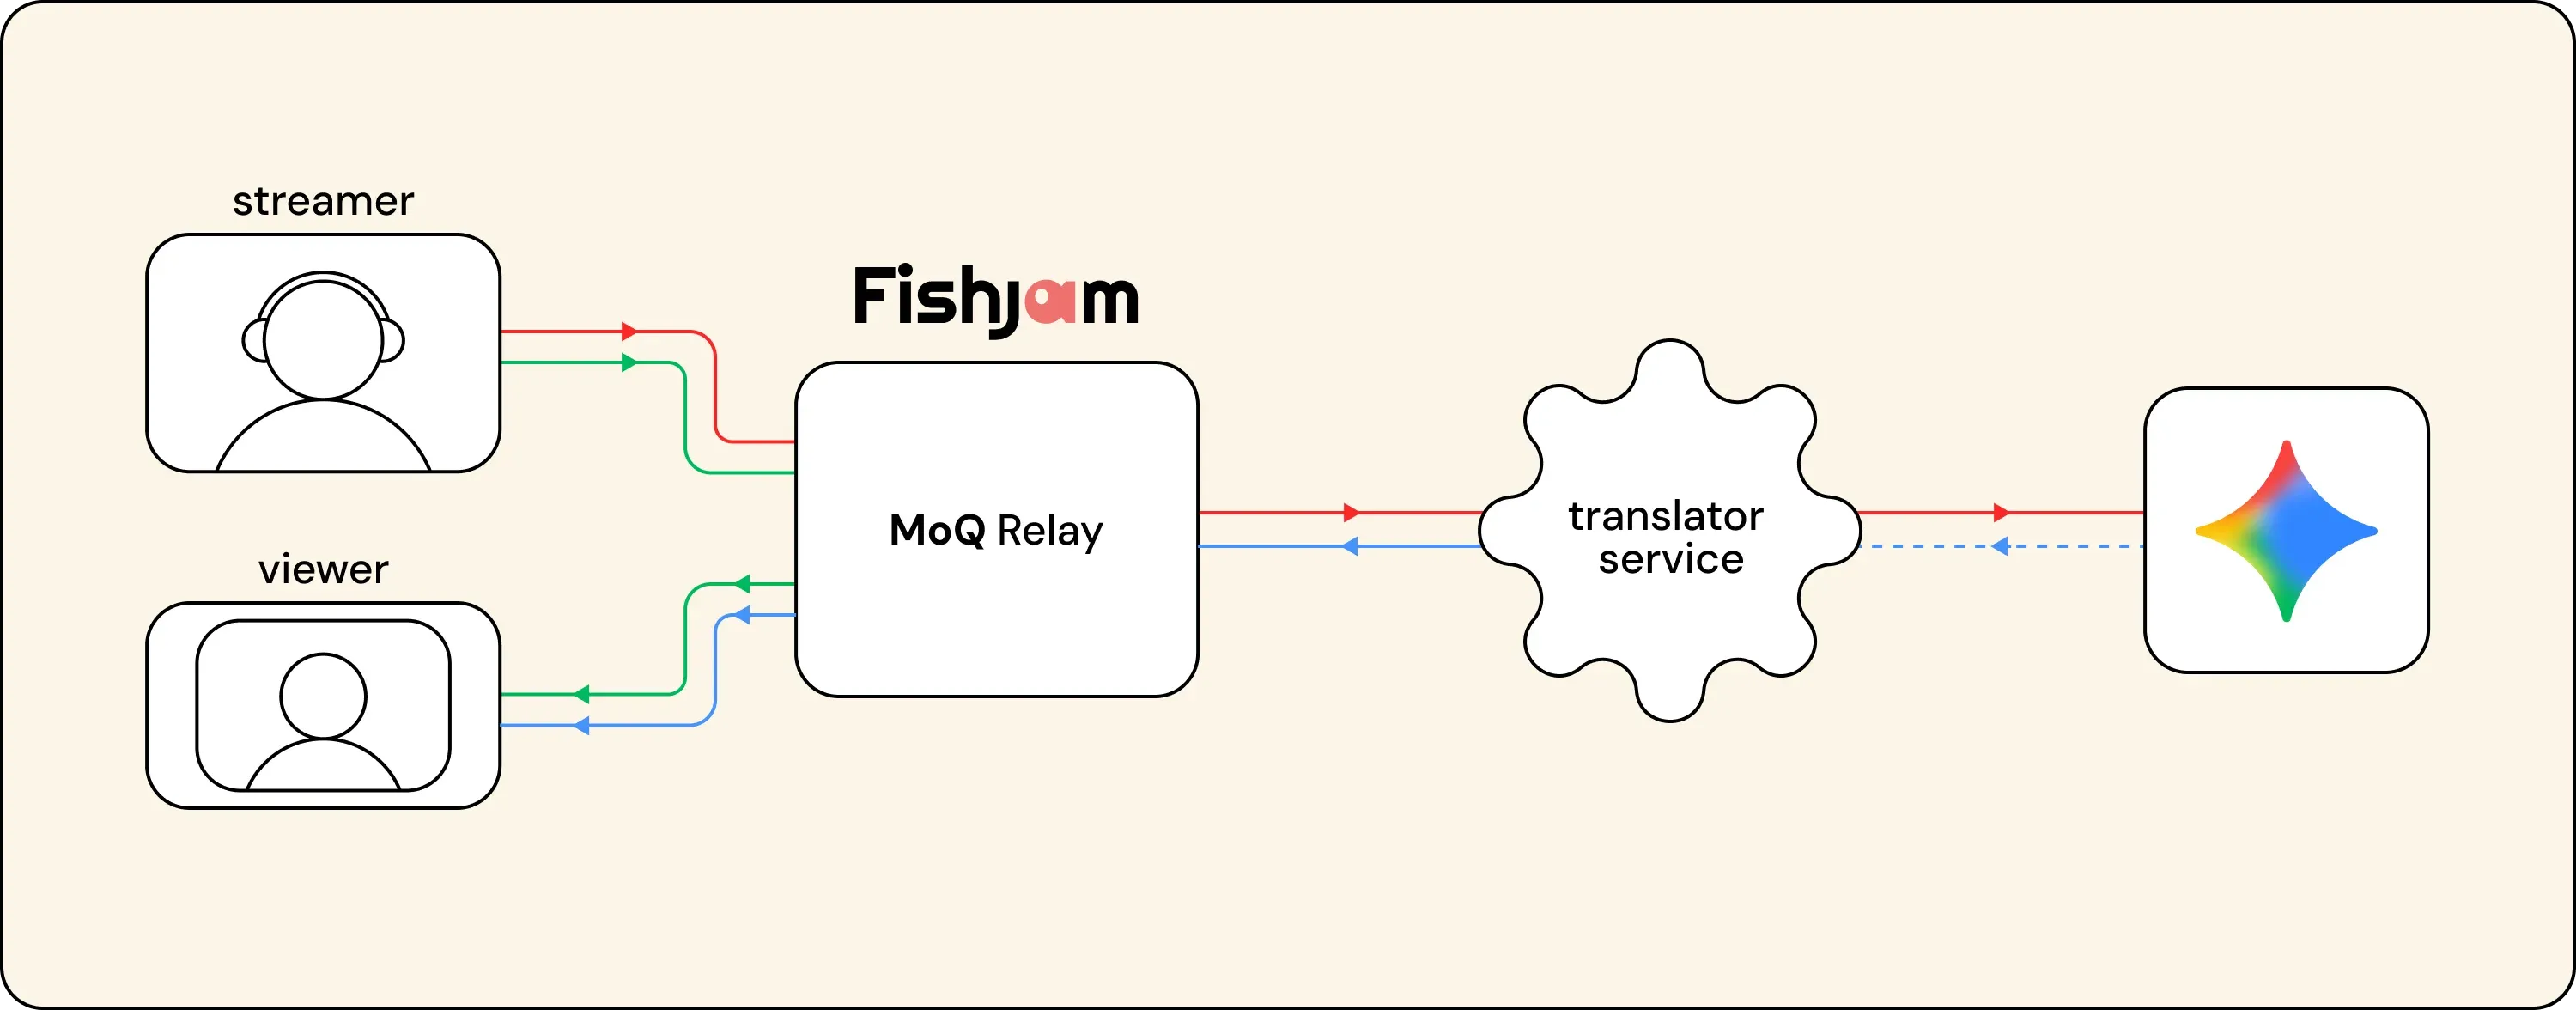
図はこれで全部だ。すべてがリレーのクライアントなので、他に何も出てこない。バックエンドも、シグナリングサーバーも、ブラウザとサービスの間の socket もない。
購読がリクエスト
この部分で MoQ に決めた。
サービスはリレー上の broadcast announcement を監視する。brave-otter に新しいストリームが現れた? なら brave-otter/google/translation に付随する broadcast を announce する。各トラックは言語コードだ。es、pt-BR、ja。字幕は隣の es/transcript.json に住んでいる。
ここからが面白い。これらの翻訳はひとつも動いていない。必要になったときに作られる。
視聴者がスペイン語を選ぶと、そのプレイヤーが es トラックを subscribe する。この subscribe がそのまま API 呼び出しになる。サービスがそれを見て、Gemini セッションを開き、publish を始める。最後のスペイン語視聴者が去ると、セッションは5秒後に終わる。
「翻訳を開始」するエンドポイントはない。設定もない。Web アプリとサービスの間でメッセージは一通もやり取りされない。両者はパスについて合意しているだけだ。
しかもリレーがファンアウトをやるので、スペイン語視聴者が1000人いても Gemini セッションはひとつしか消費しない。モデルの時間は高い。80言語を提供していても、誰かが実際に再生ボタンを押すまでは1円もかからない。誰も日本語を求めなければ、Gemini は日本語の存在すら知らないままだ。
バッファリングという小技
翻訳には物理的な問題がある。モデルは文全体を聞き終えてからでないと、スペイン語でそれを言えない。Gemini にはおよそ2.5秒かかる。パイプライン上のどんな英雄的行為でもこれは直せない。まだ発話されていない単語は翻訳できないのだ。
翻訳が届いた瞬間に再生すると、音声は永遠に映像より遅れ続ける。話し手があるスライドを指して、そのスライドについてのスペイン語が現れるのは、彼がすでに3ページ先へ進んだ後になる。
我々の答えはこうだ。逆らうのはやめて、全部バッファリングする。映像も、元の音声も、何もかも、翻訳が追いつくのに十分なだけバッファリングする。ライブ配信で数秒に気づく人はいないし、「ライブ」だってこれまで一度も本当にリアルタイムだったことなんてない。
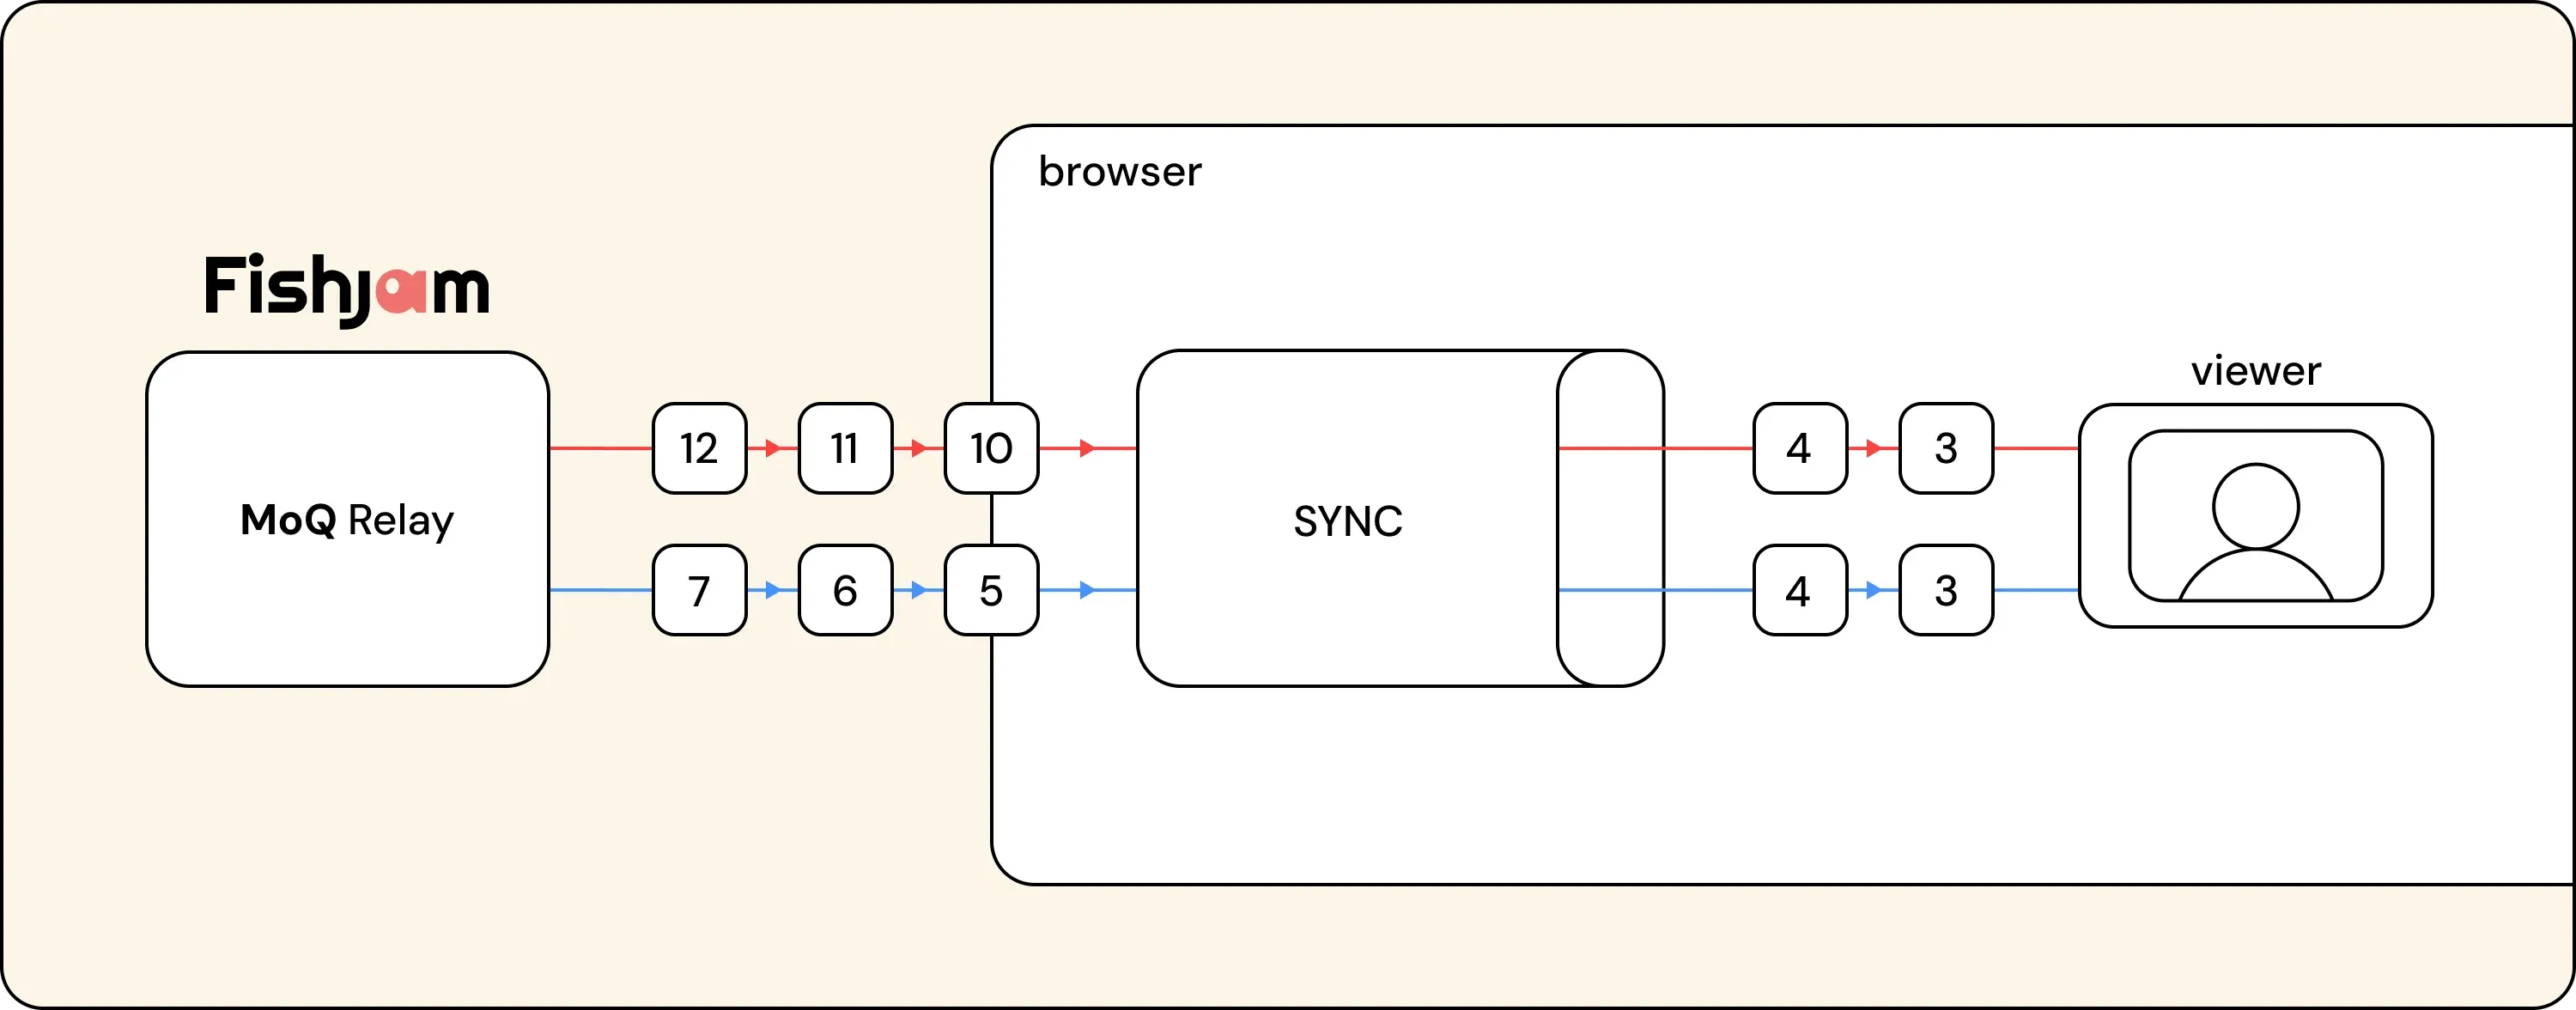
翻訳ごとに独自の再生クロックを持たせ、実測した遅延の分だけオフセットする。だから翻訳された音声は映像とまったく同じ再生ヘッドに乗る。
そして一番いいのは、このバッファリングをすべてクライアント側、つまり視聴者のブラウザでやっていることだ。これが「元の映像と翻訳音声を同期させる」ことを可能にしている。MoQ のおかげでこれはほとんど退屈な作業になる。subscribe する側が自分の再生クロックを持っているので、数秒分のメディアを溜めておくのはただの選択肢だ。publish する側は知らないし、リレーも気にしない。視聴者はそれぞれ好きなだけ違う遅延を選べる。
これを WebRTC でやってみろ。WebRTC の性格は「とにかく早く再生しろ」の一言に尽きる。ジッターバッファはあなたの指揮下になく、playoutDelayHint はあるがままの姿で、複数のトラックをそれぞれ違うオフセットで溜めておくとなれば、canvas にデコードして音声と映像の同期を手作業で組み直す羽目になる。内蔵のプレイヤーを回避するには、ゼロから書くしかない。
バッファリングにはもうひとつおまけがある。映像のタイムラインが一切動かないので、言語を切り替えても映像には決して触れない。スタッターも、再バッファリングもなく、映像はあなたが切り替えたことすら知らない。
切り替え自体について。新しい言語はバックグラウンドで無音のまま温めておき、クロスフェードはそのデコーダが実際に音声を出しているときだけ行う。データが届いた瞬間ではない。データは1秒早く届くので、そのタイミングでフェードすると無音へフェードすることになる。フェードは200ミリ秒、声は文の途中で変わる。
タイムラインを組み直す
翻訳サービスはほとんどが音声パイプラインで、そのパイプラインのほとんどは時間の処理だ。
Gemini はしゃべっては止まる。翻訳音声の一区切り、話し手が話し続けている間の沈黙、また一区切り。これらの断片を素朴につなぎ合わせると、翻訳トラックは現実より先に走り出し、あの慎重に積み上げたクロック計算が全部崩れる。
だからサービスはタイムラインを組み直す。Gemini の各レスポンス間のギャップを測り、そのギャップを出力トラックに保つ。同時に各境界でエンコーダをリセットし、コーデックが音声を隙間の向こうへ引きずらないようにする。翻訳トラックは結局、話し手が止まるあたりで止まる。これがこのトラックを揃えられるものにしている。
字幕も同じ扱いだ。サービスは各字幕に、それが由来する音声区間のクロックスタンプを押す。プレイヤーは、再生中の音声がそのスタンプを越えるまで字幕を表示しない。そうしないと、音声が読み上げられる前に字幕がネタバレしてしまう。
面白いのは、字幕が追うのは今聴いている言語であって、さっき切り替えた言語ではないことだ。言語を切り替えている最中も、クロスフェードが実際に起きる瞬間まで古い字幕が流れ続ける。
公平に言っておくと
- ある言語の最初の聴衆は、セッションが立ち上がるまで数秒待つ。このコールドスタートの税は誰かが払わなければならない。モデル自身もウォームアップが必要で、最初の数文が最も粗く、話し手に適応するにつれて品質は上がっていく。
- 数秒の遅延は放送なら問題ないが、会話には最悪だ。これは1対多の設計であり、通話に使うものではない。
- うまく扱えるのは単一の話し手だけ。クロストークはどの翻訳モデルにとっても難問で、今日のモデルの扱い方は……かなり複雑だ。
試してみる
デモは translate.fishjam.io、コード(Web アプリと翻訳サービス)は Fishjam のサンプルリポジトリにある。
このパターンは翻訳以外にも一般化できる。ストリームを消費して何らかの派生結果(文字起こし、モデレーション、吹き替え)を出すものなら何でも、同じようにリレーに普通のクライアントとして差し込める。リレーは Fishjam の一部なので、今日にでも自分のものを差し込める。
この道ではずいぶん遠回りしてきた。リアルタイム文字起こしを作り、マルチスピーカーの音声エージェントも作った。これはその集大成といったところだ。