一条直播流,80 种语言:基于 MoQ 的实时 AI 翻译
Fishjam 用 MoQ(Media over QUIC)做实时 AI 翻译:80 多种语言按需生成,订阅某个语言的轨道就等于发起那次请求,没有信令也没有后端;延迟靠客户端缓冲对齐播放时钟解决,切换语言不碰视频。
中文
复制
同一条直播,你可以用西班牙语看,用日语看,或者从菜单里中途切换成 80 多种语言里的任意一种,翻译出来的语音与画面保持同步,而不是像字幕那样落后三秒。
这就是 translate.fishjam.io。在笔记本上推流,用手机打开链接,选一种语言,然后就能听见自己说着一种你从没学过的语言,而且是实时的。本文剩下的部分讲它是怎么做到的。它比你想的要短,因为大部分活儿是 MoQ(Media over QUIC)干的。
搭建
我们拿到了 Gemini 3.5 的实时翻译模型。你把音频流进去,它把翻译说出来:一个模型,语音到语音,没有需要照看的「转写—翻译—合成」流水线。
现在人人都做实时转写。有些应用甚至能实时翻译对话。但它始终是一条侧信道:文字在视频旁边滚动,或者配音落在讲话人后面飘。我们想要的是真的那种:一场广播,翻译后的语音就是音轨本身,与画面同步。
所以零件清单很短:
- 一个 Web 应用,有推流页和观看页。
- 一个 Python 服务,把音频喂给 Gemini,再把翻译发布回来。
- 中间一个 Fishjam 的 MoQ 中继。
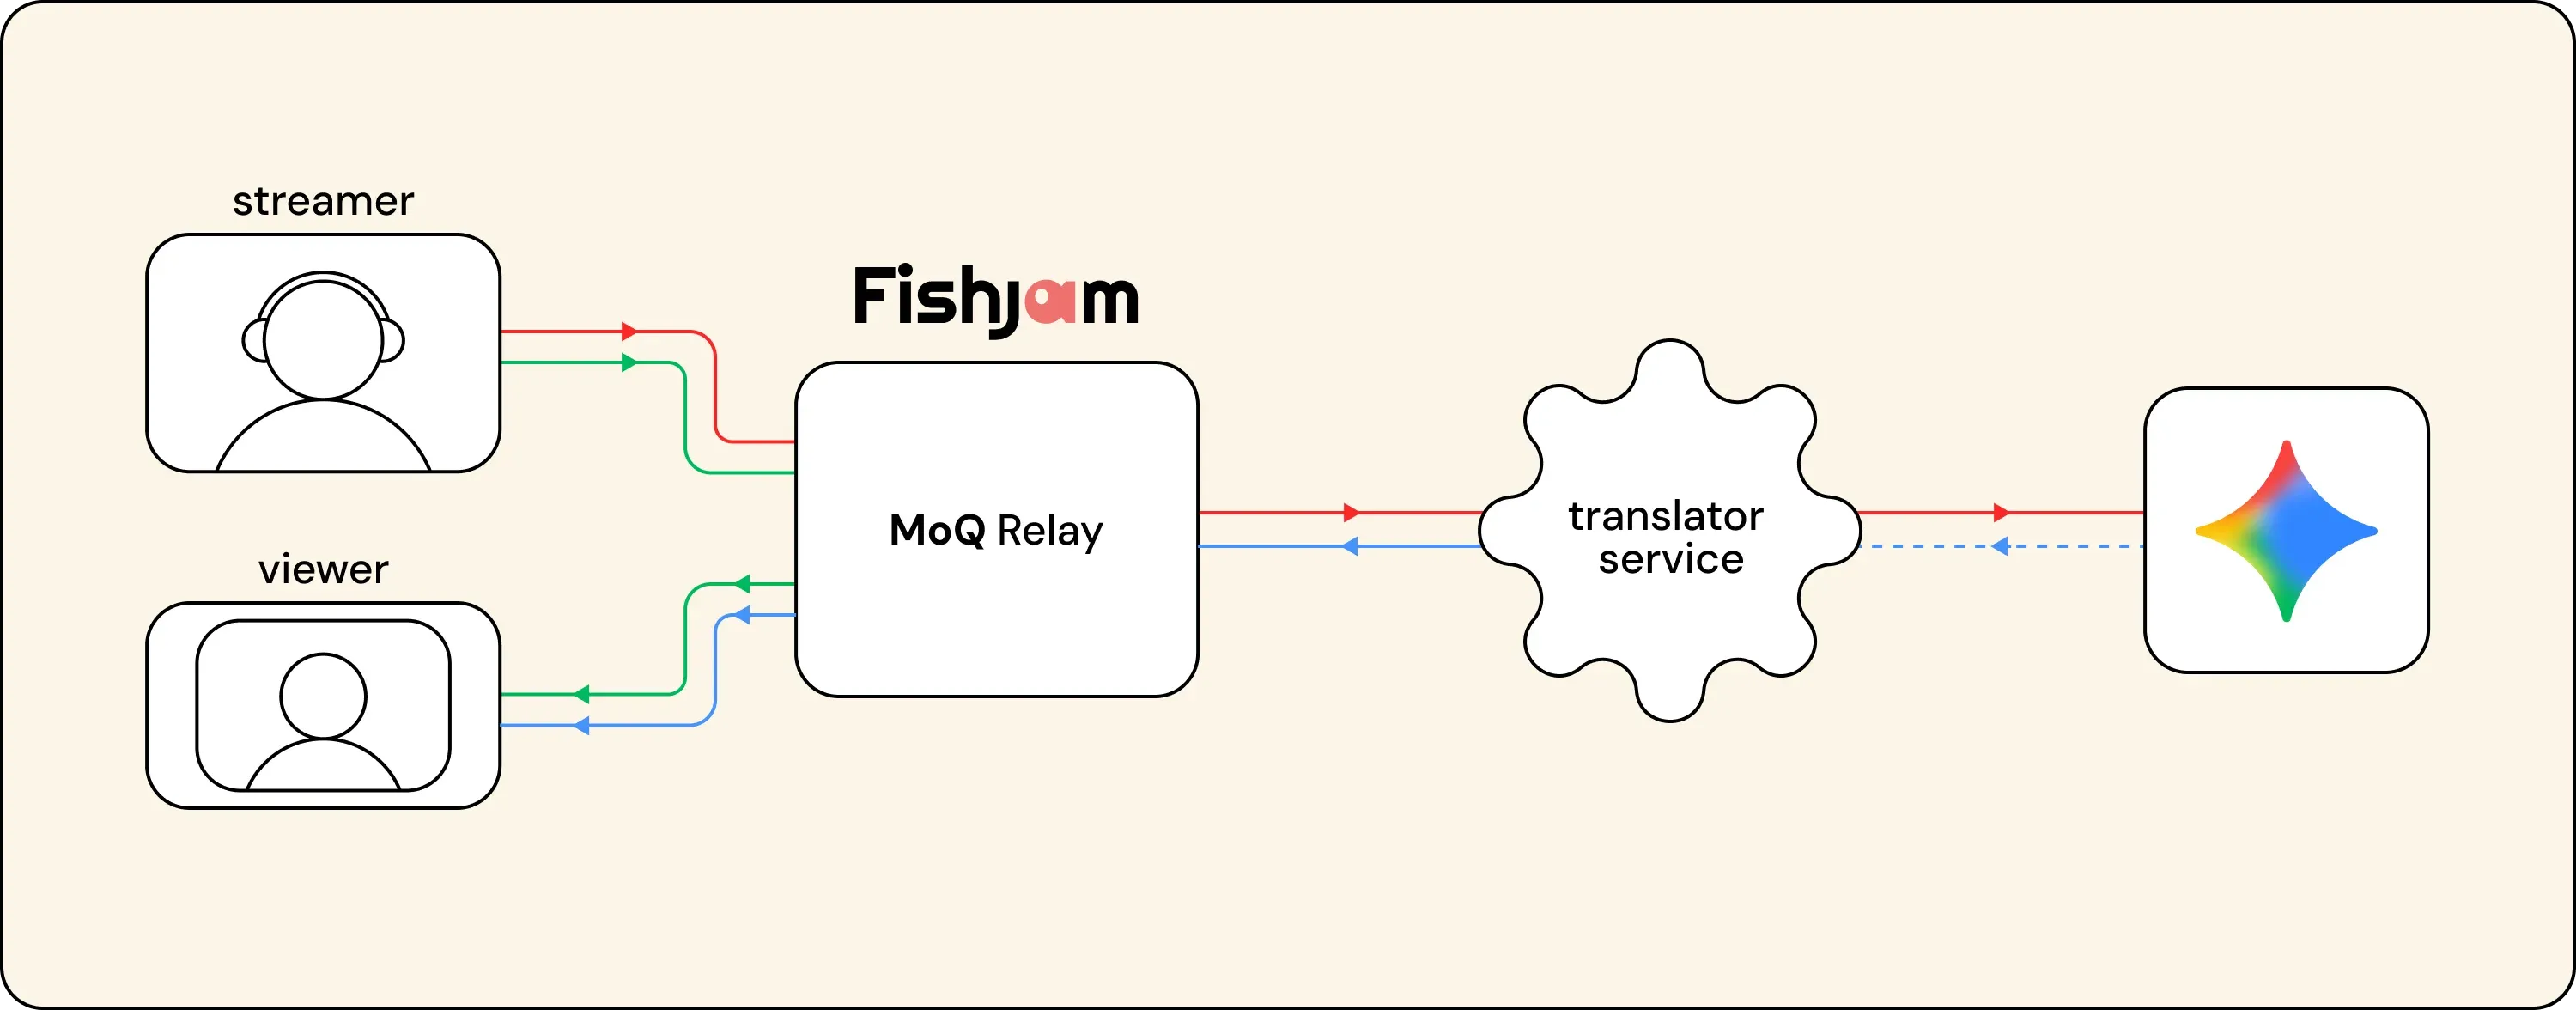
整张图就是这样。所有东西都是中继的客户端,所以图里没有别的东西:没有后端,没有信令服务器,浏览器和服务之间也没有 socket。
订阅就是请求
这一部分让我们认定了 MoQ。
服务监听中继上的广播声明。有新流出现在 brave-otter?它就在 brave-otter/google/translation 声明一个伴随广播,其中每条轨道是一个语言代码:es、pt-BR、ja。字幕住在隔壁的 es/transcript.json。
接下来是有意思的地方。这些翻译一个都没在跑。它们是按需创建的。
当某个观众选了西班牙语,他的播放器就订阅 es 轨道。这次订阅就是那次 API 调用。服务看到它,开一个 Gemini 会话,开始发布。当最后一个西班牙语听众离开,会话在五秒后结束。
没有「开始翻译」这种端点。没有配置。Web 应用和服务之间一条消息都不交换。它们只是约定了路径。
而且中继会做扇出,所以一千个西班牙语观众只花掉一个 Gemini 会话。模型时长很贵;提供 80 种语言在有人真的按下播放之前不花一分钱。如果没人要日语,Gemini 根本不会听说日语这回事。
缓冲这个花招
翻译有一个物理问题:模型必须先听到整句话,才能用西班牙语说出来。Gemini 大约需要 2.5 秒。任何流水线上的英雄主义都修不好这一点:你没法翻译还没被说出来的词。
翻译一到达就播放,声音就会永远落在画面后面。讲话人指着某张幻灯片,讲那张幻灯片的那句西班牙语却在他已经翻过三页之后才出现。
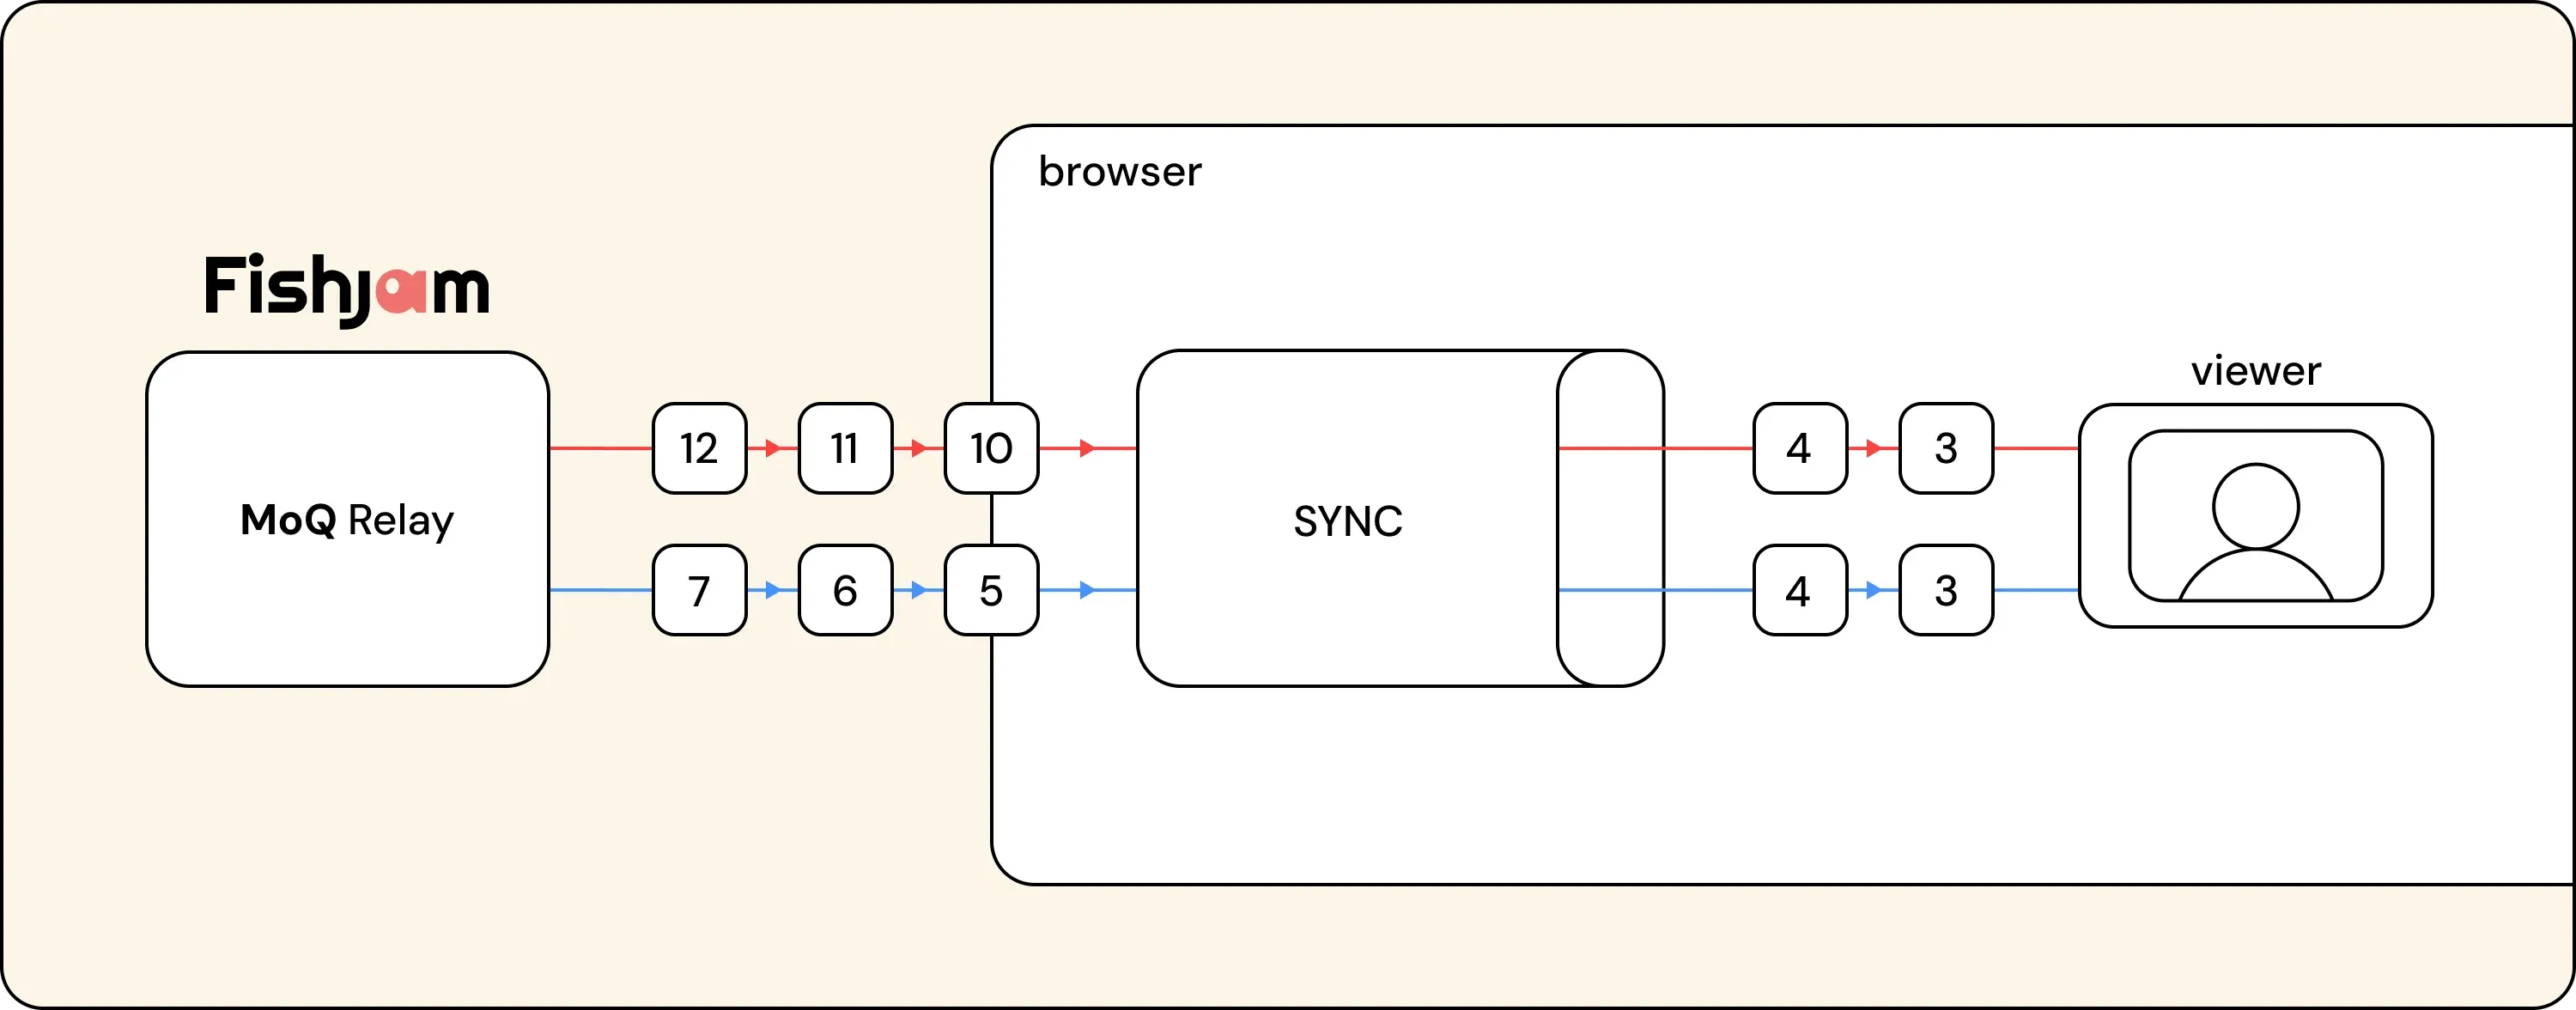
我们的解法:别对抗了,全都缓冲起来。视频、原始音频,所有东西,缓冲到足够翻译追上来为止。在一场直播里没人会注意到几秒钟;「直播」本来也从来没那幺实时。
每一路翻译都有自己的播放时钟,按它实测的延迟做了偏移,所以翻译后的语音会落在与视频完全相同的播放头上。
而且最妙的是:这些缓冲我们全部做在客户端,也就是观众的浏览器里。这才让「把原始视频与翻译语音同步起来」成为可能。MoQ 让这件事几乎变得无聊:订阅者拥有自己的播放时钟,所以压住几秒钟的媒体只是个选择。发布端不知道,中继不关心,而且每个观众想要的话都能选一个不同的延迟。
现在换成 WebRTC 试试。它的全部性格就是「尽快播放」:抖动缓冲不归你指挥,playoutDelayHint 是什么样就是什么样,而把多条轨道按不同偏移压住,意味着你得解码到 canvas、再手工重建音视频同步。为了绕开它内置的那个播放器,你得从零写一个。
缓冲还白送第二个好处:视频时间线从不动,所以切换语言永远不会碰到视频:不卡顿、不重新缓冲,画面甚至不知道你切换过。
切换本身:新语言在后台静音预热,我们只在它的解码器真的在产出音频时才做交叉淡入,而不是数据刚到就淡入——数据会早到一秒,那时候淡入会把你淡进一片寂静。淡入用 200 毫秒,声音就在一句话中间变了。
重建时间线
翻译服务大部分是音频管道,而这条管道大部分是在处理时间。
Gemini 说话是一阵一阵的:一段翻译语音,讲话人继续说时的静默,又一段。把这些片段天真地拼接起来,你的翻译轨道就会跑到现实前面,上面那些小心的时钟计算全都崩掉。
所以服务会重建时间线:它测量 Gemini 各次响应之间的间隔,并在输出轨道里保留这些间隔,同时在每个边界重置编码器,免得编解码器把音频抹过一段空隙。翻译轨道最终大致在讲话人停顿的地方停顿。这才让它有了可对齐的可能。
字幕受到同样对待。服务给每条字幕盖上它来自的那段音频的时钟戳,播放器会一直按住它,直到你正在听的音频越过那个戳。否则字幕就会在声音说出来之前剧透这句话。
有意思的是:字幕跟随的是你正在听的语言,而不是你刚点的那个:切换语言的过程中,旧字幕会继续跑到交叉淡入真正发生的那一刻。
说句公道话
- 一种语言的第一个听众要等几秒钟,等会话起来。总得有人付这个冷启动的税。模型自己也要预热:最开始的几句是它最粗糙的,随着它适应讲话人,质量会往上爬。
- 几秒延迟对广播没问题,对对话很糟糕。这是一个一对多的设计;别拿它去做通话。
- 我们只把单个讲话人处理得好。串音对任何翻译模型都是难题,而今天的模型处理它的态度……相当复杂。
试一试
演示在 translate.fishjam.io,代码(Web 应用和翻译服务)在 Fishjam 的示例仓库里。
这个模式能泛化到翻译之外:任何消费一条流、并发布某种派生结果的东西(转写、内容审核、配音)都能以同样的方式插进中继,作为又一个普通客户端。中继是 Fishjam 的一部分,所以你今天就能把自己的东西插进去。
我们在这条路上绕了很久:之前做过实时转写,也做过多讲话人的语音 agent。这一个像是收成。