物理学者のように LLM を剪定する:ブロック除去を Ising 最適化問題として扱う
ブロックを丸ごと消すのが手軽な高速化だが、どれを消すかは多体問題になる。Multiverse Computing はこれを制約付き二値最適化に書き直し、Ising 模型の低エネルギー状態を高スコアのモデルに対応させた。
日本語
コピー
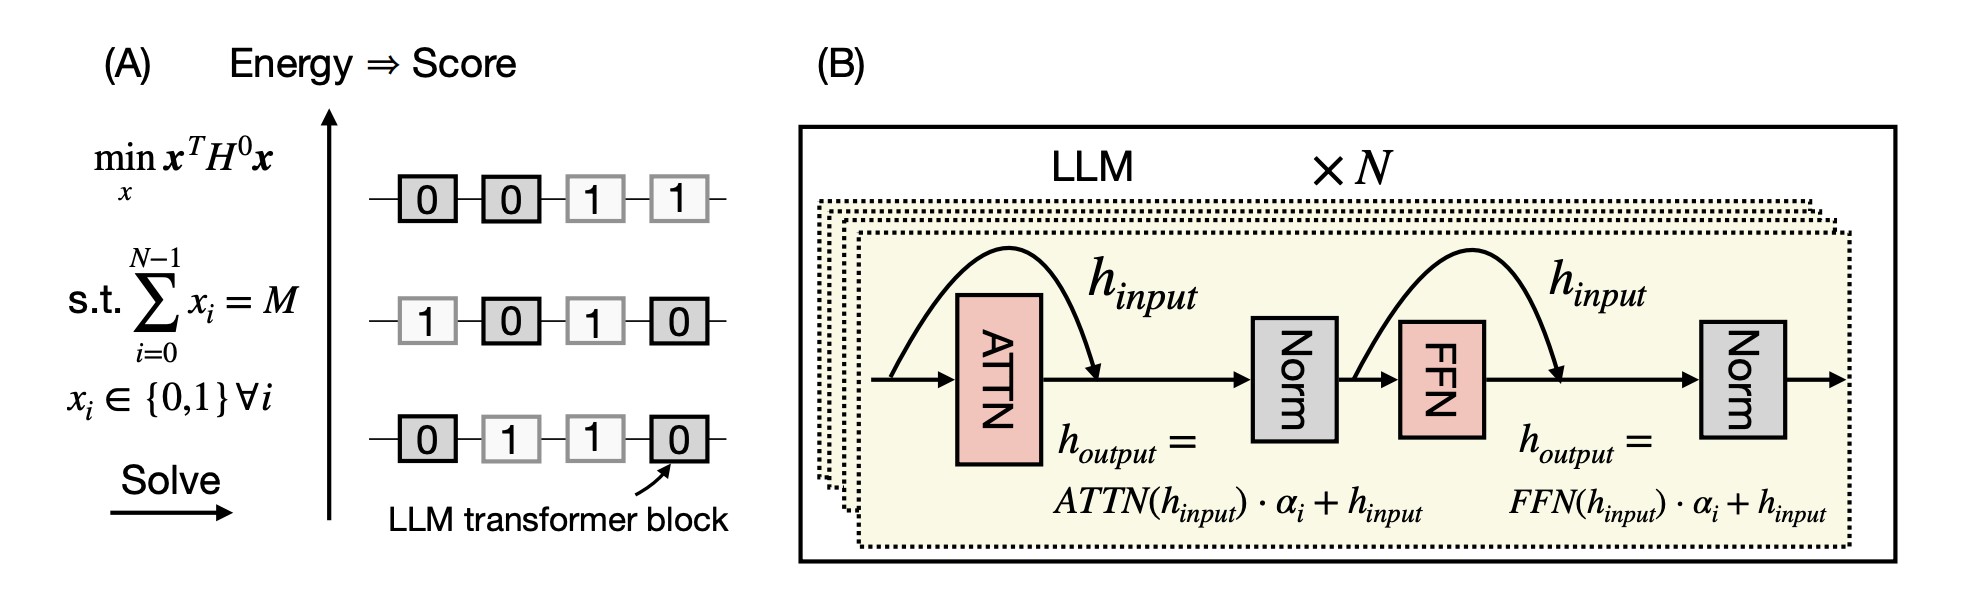
大規模言語モデルを高速化する最も安上がりな方法のひとつは、最も乱暴でもある。transformer ブロックを丸ごと消してしまうのだ。モデルは実際に短くなるので、ブロック除去(深さ方向のプルーニングとも呼ばれる)はメモリ削減だけでなく予測可能な推論高速化をもたらし、量子化や低ランク圧縮ともきれいに組み合わせられる。難しいのは、_どの_ブロックを切るかを決めることだ。選び方を間違えればモデルは即座に壊れる。しかも任意のブロックを除去したときの効果は、同時にどのブロックを除去するかによって変わる。選択同士が相互作用しているのだ。つまりこれは順位付けの問題ではなく組み合わせ問題であり、相互作用する二値変数をもつ組み合わせ問題こそ、スピン系の物理が本来記述するためにあるものだ。
最新論文 LLM Compression by Block Removal with Constrained Binary Optimization では、この対応関係を正面から扱った。ブロック選択を制約付き二値最適化(CBO)問題として定式化し直したのである。これはそのまま Ising glass に対応する。全結合の相互作用をもち、「上向き」スピンの数が固定された無秩序スピン系だ。このスピン系のエネルギーは、プルーニング後のモデルがベンチマークで実際に取るスコアの、強力かつ安価な代理指標になることが分かった。つまりベンチマークを一切走らせることなく、膨大な候補構成を順位付けし、その中の難しいインスタンスを Multiverse で使い続けてきた古典および量子インスパイア系のソルバーに渡せる。深い圧縮領域では効果が大きい。Llama-3.3-70B-Instruct を 50% 圧縮したとき、MMLU で同種のブロック除去手法の最良のものより 23 ポイント近く 上回った。
なぜブロック選択は多体問題なのか
既存のブロック除去手法のほとんどは、各ブロックを単独で採点し、重要度が低そうなものから削除する。使うのはマグニチュード、感度、「ブロック影響度」といったヒューリスティクスだ。物理の言葉で言えば、これらは_平均場_的手法である。各ブロックの寄与を他のブロックから独立したものとして扱う。ちょうど平均場理論がスピンの近傍を平均場で置き換えるのと同じだ。もうひとつの近道は連続したブロックをひとまとまりで除去する方法で、問題は小さくなるが、探索空間の大部分を捨てることになる。
問題は、ブロックが独立ではないという点にある。実在の磁石のスピンが独立でないのと同じだ。ブロック 20 を除去するとモデルが傷むかどうかは、ブロック 19 や 24 も同時に除去するかによって変わる。これがふたつの決定の間の相互作用、すなわち結合である。モデルが深く異質なほど、これらの結合を無視する代償は大きくなる。とくに多数のブロックを一度に除去したいときはそうだ。本当に必要なのは、ブロックの組み合わせ空間を、互いがどう相互作用するかを考慮しながら探索することだが、組み合わせの数は指数関数的に増え、総当たりは絶望的に見える。そしてこここそ統計物理の道具が本領を発揮する領域だ。指数的に巨大な構成空間があり、そこに二体の結合が乗っている。
着想:ブロック選択をエネルギー最小化問題にする
各 transformer ブロックに二値変数を付ける。0 は保持、1 は除去で、下向きか上向きのスピンだと思えばよい。次にモデルの損失をこれらの変数について二次までテイラー展開し、(近似的な)Hessian 行列を得る。この Hessian の対角成分は各ブロック単独の重要度であり、非対角成分こそブロック間の二体結合、つまり平均場的手法が捨てている多体の物理である。
この書き換えによって「どのブロックを除去すべきか」はきれいな最適化問題になる。N 個のブロックのうちちょうど M 個を除去するという制約のもとで、エネルギー xᵀH⁰x を最小にする M 個のブロックの組を見つけるのだ。数学的には制約付き二値最適化問題、物理的には Ising glass である。全結合の結合スピン系で、磁化が保存される(除去数の固定が全スピンの固定に対応する)。ここで確立した重要な性質は、このエネルギーが下流の品質の強い代理指標になるということだ。スピン系の低エネルギー状態は、高性能なプルーニング済みモデルに対応する。 エネルギーを最小化することとベンチマークスコアを最大化することが、同じひとつの探索になる。
ブロック選択は制約付き二値最適化問題となり、Ising glass の低エネルギー状態を探すことと等価になる。各解は N 個のブロックからどの M 個を削除するかに対応する。右:Hessian を構成するため、各ブロックの残差パスに結合変数 α を挿入する。出典:論文図 1。
この手法が実用的なのはコストのためだ。Hessian、つまりすべての結合は、小さなキャリブレーションデータセットでの順伝播と逆伝播から一度だけ計算すればよい。あとはどの候補構成の評価も安価なエネルギー計算ひとつで済み、実モデルを走らせる必要もベンチマークを回す必要もない。しかも結合は圧縮目標に依存しないので、同じ Hessian をさまざまな M の求解に使い回せる。
求解:厳密に解けるなら厳密に、無理なら量子または量子インスパイア手法で
ほとんどのモデルでは構成空間は広いが、なお全列挙できる。エネルギーの計算が十分安いので、単一 GPU での総当たりで数百億通りのスピン構成まで調べられる。数百万通りなら数秒だ。ここで扱える中で最も難しいケース、Llama-3.3-70B の 80 ブロックから 8 個を削除する場合(約 290 億通り)には、およそ 2 日かかった。
さらに上へ行くと、厳密な手法は通用しなくなる。ここで問題を Ising グラスとして書き下すことが二度目の見返りを生む。等価な QUBO 形式(制約をペナルティ項に吸収させたもの)にすれば、まったく同じタスクを、こうした Hamiltonian のために作られた高度に最適化された古典・量子・量子インスパイアードのソルバーに渡せる。量子アニーリング、QAOA、tabu search、そして専用の branch-and-bound だ。我々は、オープンソースの tabu ソルバーが_数秒_で確実に最低エネルギー状態に到達することを確認した。しかも、ブルートフォースで検証できる最も難しいケースにおいてもそうだ。つまり、配置の列挙がまったく現実的でないモデルに対しても、この手法はスケールする。Multiverse が主戦場とするソルバーを使って、だ。
ここに微妙だが重要な点がある。最適化の通念とは逆だ。通常、CBO やアニーリングのソルバーは、真の基底状態を見つけられるかどうかで評価される。我々に基底状態は要らない。必要なのは、質の高い低エネルギー状態を少数、素早く生成することであり、こちらのハードルはずっと低い。だからこそ軽量なソルバーが我々によく効き、同時にいくつも走らせる余裕も生まれる。
なぜ低エネルギー準位のスペクトル全体が重要なのか
エネルギーは品質の強い代理指標だが、完璧ではない。だから単一の最低エネルギー状態が常に最良のモデルとは限らない。これは欠陥ではなく特徴であることが分かった。ひとたび Hamiltonian を立てれば、基底状態と低励起状態を読み出すのはほぼただ同然で、脆い一つの答えではなく、試せる質の高い候補の刈り込み集合が手に入る。基底状態だけでなく励起状態を探ることは、それ自体が物理学の活発な研究領域であり、ここでの実務者の実際の要求にちょうど対応している。
具体例を挙げる。Llama-3.1-8B-Instruct で 16/32 個のブロックを除去する場合、上位の状態のほとんどはモデル末尾のブロックを切る傾向があり、これは先行研究の予想と一致する。だが第 17 励起状態は、モデルの先頭付近のブロックを除去することを初めて提案したもので、軽度の再トレーニング後、この構成は複数のベンチマークで基底状態を上回った。これは「最良の刈り込みは中盤から後半にかけての連続したブロックだ」という通説を直接覆すものであり、問題の完全な多体構造を尊重することがなぜ報われるかを示している。
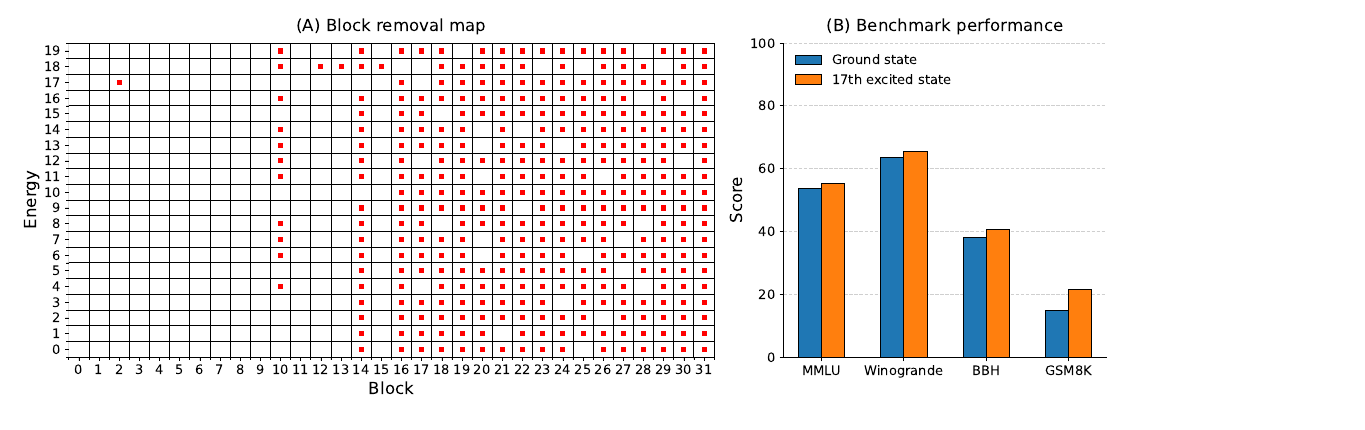
左:エネルギーの低い 20 個の状態がそれぞれどのブロックを除去したか(赤 = 除去済み)。右:第 17 励起状態は前方のブロックを一つ除去し、再トレーニング後に複数のベンチマークで基底状態を打ち負かした。最良のモデルは基底状態ではなく励起状態である。出典:論文図 2。
結果
Llama-3.1-8B-Instruct、Qwen3-14B、Llama-3.3-70B-Instruct において、我々の手法(CBO)は最先端のブロック除去ベースラインと同等かそれ以上であり、圧縮が激しくなるほど差が開く。
最も明瞭な優位は、再トレーニングなしの Llama-3.3-70B-Instruct の深い圧縮で現れる。80 個中最大 24 個のブロックを除去する範囲では、CBO と block influence はほぼ互角だ。だが 32/80 と 40/80 では決定的に引き離し、最も深い設定では MMLU で 23 点近い差をつけ、我々が試したすべてのベンチマークでベースラインを上回った。Qwen3-14B では、40 個中 12 個のブロックを除去したとき、CBO は MMLU で約 10 点リードする。軽い圧縮では各手法は同程度の性能で、これは当然だ。結合関係は深く切るほど効いてくる。
| Llama-3.3-70B-Instruct、再トレーニングなし | 除去したブロック数 | MMLU |
|---|---|---|
| 元のモデル | 0 | 82.2 |
| CBO(我々の手法) | 32 / 80 | 76.6 |
| Block influence | 32 / 80 | 59.3 |
| CBO(我々の手法) | 40 / 80 | 76.9 |
| Block influence | 40 / 80 | 54.0 |
40/80(50% の深さ)で、CBO は MMLU を 77 付近に保つのに対し、最強のベースラインは 50 台まで落ち込む。出典:論文表 2。
稠密 Transformer だけの話ではない
現代の異種アーキテクチャではブロックの除去はずっと難しい。異なる種類のブロックが交互に並ぶからだ。だが Ising の形式化はそんなことを気にしない。各位置にどの種類のブロックが座っていようと、結合は結合だ。これをストレステストするため、我々はこの手法を NVIDIA-Nemotron-3-Nano-30B-A3B-FP8 に適用した。Mamba2、attention、MoE 層を不均一なパターンで交互に積んだハイブリッドモデルで、再トレーニングは一切行っていない。
我々の形式化にはスタックが均質だと仮定する箇所がどこにもないので、そのまま移行できる。MoE 層を 2〜3 個、あるいは attention 層を 2 個除去する場合、CBO が見つけた構成は AIME25 と GPQA の両方で block influence を上回った。この結果は、こうしたハイブリッドモデルに冗長性が確かに存在すること、ただしその分布は均一でないことも裏づけている。ある専門家層は他のものよりはるかに捨てやすいのだ。そしてこの手法が良い切断点を見つけられるのは、結合した構成の空間を探索する力による。ここでも稠密モデルでの規則は成り立つ。最適な構成は多くの場合、基底状態ではなく励起状態である。
なぜこれが Multiverse Computing に適しているのか
乱雑な機械学習の問題を Ising ハミルトニアンとして定式化し直し、物理学のために作られた古典および量子インスパイアードの最適化ツールで解く——これは Multiverse が最も得意とするところであり、私たちの圧縮スタック全体を貫く発想でもある。ブロック除去はスタックの他の要素——量子化、低ランク/SVD 圧縮、幅のプルーニング、知識蒸留による修復——と組み合わせて使える。つまり、より大きなパイプラインに組み込まれるのであって、それと競合するものではない。
テイラー展開の導出、QUBO マッピング、ソルバーのベンチマーク、キャリブレーションデータセットのアブレーション、結果の完全な表など、技術的な詳細を知りたい場合は、Hugging Face で全文を読むか、あなたのモデルへの応用について私たちのチームに相談してほしい。コードは github.com/CompactifAI/Block_removal_through_constrained_binary_optimization でオープンソース公開している。