LLM政策:進展を何としてでも求める
KDEのLLMフレンドリー草案が炎上し削除、GNOMEではあらゆるLLM貢献を禁止する非公式草案が登場、議論の核心はFLOSSの集産主義と完成主義の対立にある。
もっと見る LLM
ホームKDEのLLMフレンドリー草案が炎上し削除、GNOMEではあらゆるLLM貢献を禁止する非公式草案が登場、議論の核心はFLOSSの集産主義と完成主義の対立にある。
言語モデルの「形」は harness に合わせるべきなのか、逆に harness がモデルの形に合わせるべきなのか。ChatGPT 以降のモデル設計をめぐる短い考察。
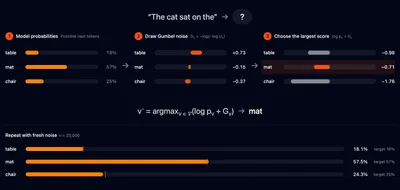
テキスト透かしは出力分布、堅牢性、検出コストの間でトレードオフが必要。vLLMの記事ではレッドグリーンリスト、Gumbelノイズサンプリングなど数種類の手法と、それぞれがどのような条件で破られるかを解説。
TypeSafe の Jev はテキスト生成を型付きの意思決定に置き換え、速度と価格で優位に立つ。だが著者は堀が浅いと見る。能力が汎用モデルに吸収されれば OpenAI などが追随するだけだ。
Nathan Lambert が米国議会議員向けに行ったオープンウェイトモデルのブリーフィング。中国は2025年7月以降 Hugging Face のダウンロード数で逆転し、AAII でも先行。米国のトップラボは閉鎖的になり、地位が揺らぐ。
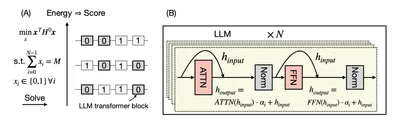
ブロックを丸ごと消すのが手軽な高速化だが、どれを消すかは多体問題になる。Multiverse Computing はこれを制約付き二値最適化に書き直し、Ising 模型の低エネルギー状態を高スコアのモデルに対応させた。
Nandakishor Mukkunnothは2025年3月にJevの非自己回帰意思決定モデルを作り、それについて長い記事を書いたと述べている。私は彼が引用した2本の論文を読み、彼の2026年のモデルを229問の細粒度問題で走らせたが、見えたものはこの話とは少し違っていた。
著者はZstd実装の評価で26のテスト/検証プロンプト条件と4つのskillを試したが、ほぼどれも平均を上回らず、Defaultの方が平均より高かった。agentは技術を表面的に使い、無関係な性質を証明し、ランダム入力で同じエラーパスにぶつかり、同じバグを2つの「差分」実装に書き込むことさえある。
Gemini 3.8 Live と Extended Thinking がリリース、音声対話で複雑な推論、リアルタイムビジョン、バックグラウンドタスクを会話を中断せずにサポート。
Novita AIがChordをオープンソース化、W4A16 MoE CUDAカーネル群。公開されているHummingと比較し、層ごとの実測でH200ではレイテンシ最大1.33倍削減、未チューニングのB300では最大2.15倍削減。
作者はLLMの「知能」は統計的な錯覚であり、その仕組みは霊媒のコールドリーディング詐欺と同源だと考える。観客の自己選別、場面の前提設定、確認的な陳述による主観的検証の誘発であり、RLHFは口調でしか順位付けできないため、モデルをバーナム的陳述を生成する機械へと最適化してしまったのだ。
Mistralが30億ユーロのシリーズDラウンドの資金調達を完了、Samsung Electronicsが主導し、評価額は210億ユーロ超。欧州テック企業史上最大の株式調達。
著者は、Jev の価値は主にモデル自体ではなく推論戦略にある可能性があると考えている。返信を choice フィールドに事前入力し、制約されたトークンを 1 つだけ生成すれば、どの LLM でも「秘密のレシピ」の大部分が得られる。彼は Qwen2.5-1.5B で 2〜3 倍の高速化を試し出した。
Google Research の Retrieve-for-Train は、軽量な拡散モデルを強化学習で一度だけ訓練し、 推論時の思考予算を迂回して一貫した fan-out 検索結果を 1 回の順伝播で生成する。
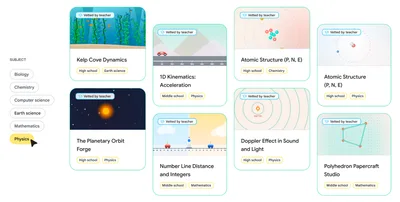
Google Research は教師が生成 UI で任意の STEM トピックのインタラクティブシミュレーションを生成できるようにし、教師が審査した 30 以上のモジュールを公開、12 名の教師の平均評価は 10 点満点中 8 点。
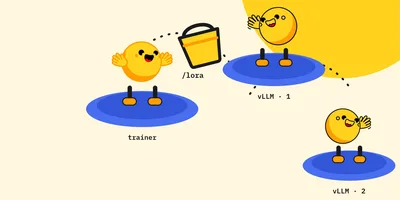
AsyncGRPOTrainer が rank-1 LoRA adapter だけを学習・同期し、HF Jobs 間は NCCL ではなく Storage Bucket 経由。500 ステップの学習が 3 時間 27 分から 53 分に短縮。
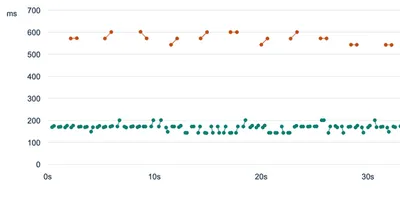
著者はQwen3-8BをSystem One分類器として接続した後、2つの手法を試した。階層的目標(10秒ごとに戦略、5秒ごとに戦術、200ミリ秒ごとに実行)とトーナメントサンプリング(一度に100個のリンクを2ラウンドで選別)で、後者はWikiracingで理想的な3リンク経路を見つけた。
Mistral は欧州のエネルギー事業者の Fortran 77 を 4 万行、C++ へ移行した。まず数値の一致を確かめる検証基盤を作り、100 を超える agent でドキュメントを補い、最終的に「人がコーディングとテストを回し、agent がレビューする」中間路線に落ち着いた。完全自律は採らなかった。
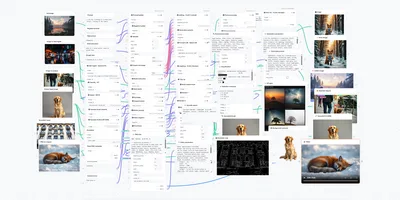
Hugging Face は AUTOMATIC1111 のほとんどの機能を同じ Gradio ワークフローキャンバス上に再構築しました。11 本のメディアパイプライン、73 個のノードで、テキストから画像生成、高解像度修復、画像から画像生成、プロンプトマトリクス、VLM 逆推論、検出からマスクへの変換、アノテーター、PNG Info、画像から動画への変換をカバーし、各出力ノードは自動的に REST エンドポイントと MCP ツールにもなります。
ChatGPT Admin Console の Analytics は Work と Codex の使用量、コスト、タスクのインサイトを集約し、管理者が AI の使われ方を把握できるようにします。
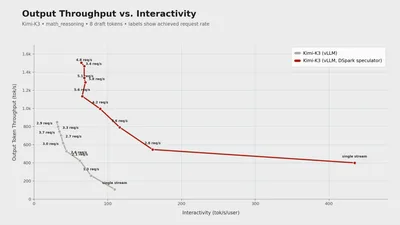
vLLMがSpeculatorsトレーニングライブラリを2.8兆パラメータのKimi K3対応に拡張:4ビット量子化ターゲットモデルに5層・50億パラメータのDSparkドラフトモデルを組み合わせ、数学推論の単一ストリーム対話性が約110から約435 tok/s/userに向上、同時実行時に同じ対話性で出力スループットが最大約3.5倍、初回トークン中央値は100ミリ秒のみ増加。
ChatGPTがSponsored Agentsの広告テストを開始、ユーザーは広告をクリックして企業がスポンサーするagentと対話可能、HubSpotとShopifyの統合も追加。
OpenAIが法務向けAstraを発表、GPT‑6 AstraはVals AIの法的検索ベンチマークで合格率54.0%、ウェブ検索版から40%向上。
Fishjam が MoQ(Media over QUIC)でリアルタイム AI 翻訳を実現:80 以上の言語をオンデマンド生成、ある言語のトラックを購読することがそのリクエストになり、シグナリングもバックエンドも不要;遅延はクライアント側のバッファリングで再生クロックを揃えて解決し、言語を切り替えても映像には触れない。