AIにUIを作らせるが、選択問題だけをやらせる
大規模モデルにUIのJSONを直接書かせると、存在しないコンポーネントをでっち上げたり、勝手に文言を作ったり、壊れたとしても結果が返ってくるまで分からない。json-renderは発想を変え、UI構築を2つの有限な選択肢に分解し、モデルは選ぶだけ、コードが組み立てる。
日本語
コピー
大規模モデルにUIを直接書かせたことは、おそらくあるだろう。コンポーネント名を間違え、文言をでっち上げ、JSONを壊し、しかも何を書いたかは結果が返ってくるまで分からない。json-render が最近公開した実験は、そのやり方を変える。「UIを組み立てる」という作業を2種類の有限の選択問題に分解し、モデルは選ぶだけ、組み立てはコードがやる。
まず、従来の2つのやり方の欠点
モデルにUIを出力させる方法は、たいてい2通りある。
ひとつは木構造全体を書かせる方法で、コンポーネント名も属性も文言も、すべてモデルの管轄になる。{"type":"Card","props":{"title":"账号设置"}} のような構造なら、モデルが書けないはずはない。問題は、登録していないコンポーネントや定義していない属性、そして意味不明な中国語の文言まで書けてしまうことだ。何を書いたかは結果を受け取ってから分かるので、検証は事後の後始末にしかならない。
もうひとつは、コンポーネントごとに会話を分けるか、次の一手をモデル自身に決めさせる方法。こちらは1つのUIに何度も往復が発生し、前に選んだ内容を後からまた送り直すことになる。
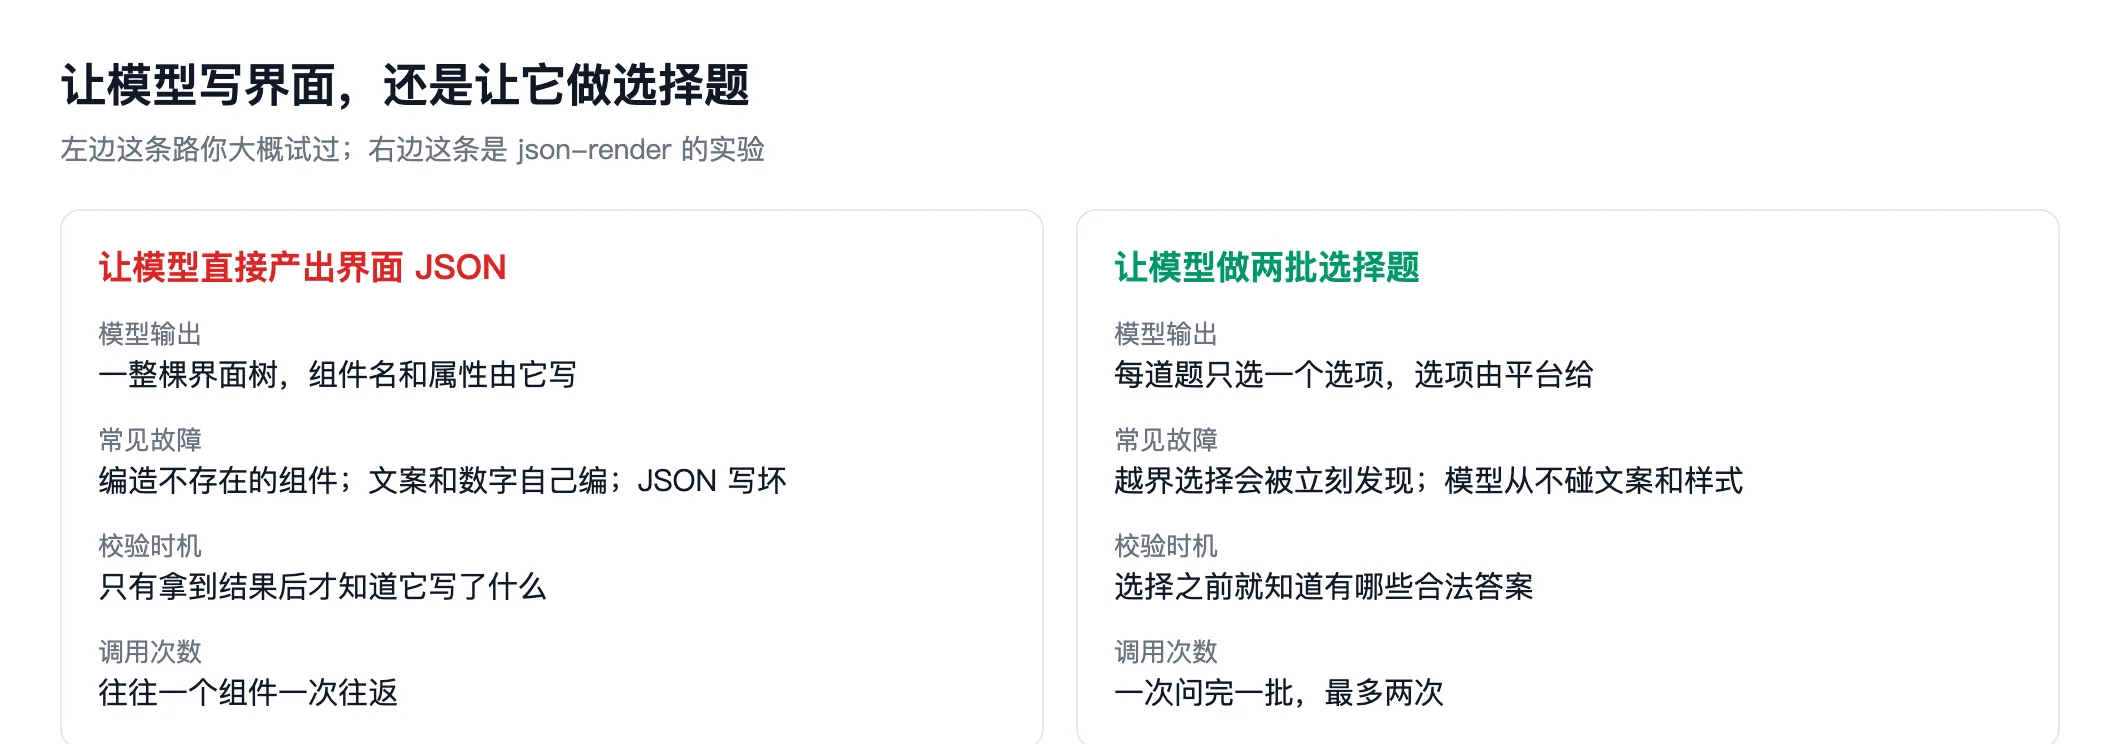
json-render の実験は、まさにこの問題を狙っている。やることは一行で言える。モデルにやらせることを、すべてプラットフォーム側が用意した選択肢から一つ選ぶことに変える。
「書く」を「選ぶ」に変える
「決定モデルでインターフェースを組む」という言い方を初めて見たときは、「ここはボタンか入力欄か」といった細かい判断を扱うのだと思った。コードを読み終えてみると、はるかに踏み込んでいて、組み立ての工程全体を二組の問いに分解していた。
一組目はメンバーを問う。一回の呼び出しで候補をすべて聞く。最外層にどの要素を使うか、このコンポーネントが要るか、いくつ要るか。二組目は位置を問う。実際に選ばれた要素だけをもう一度問い、どの要素のどのスロットに付くのか、兄弟の中で何番目か。
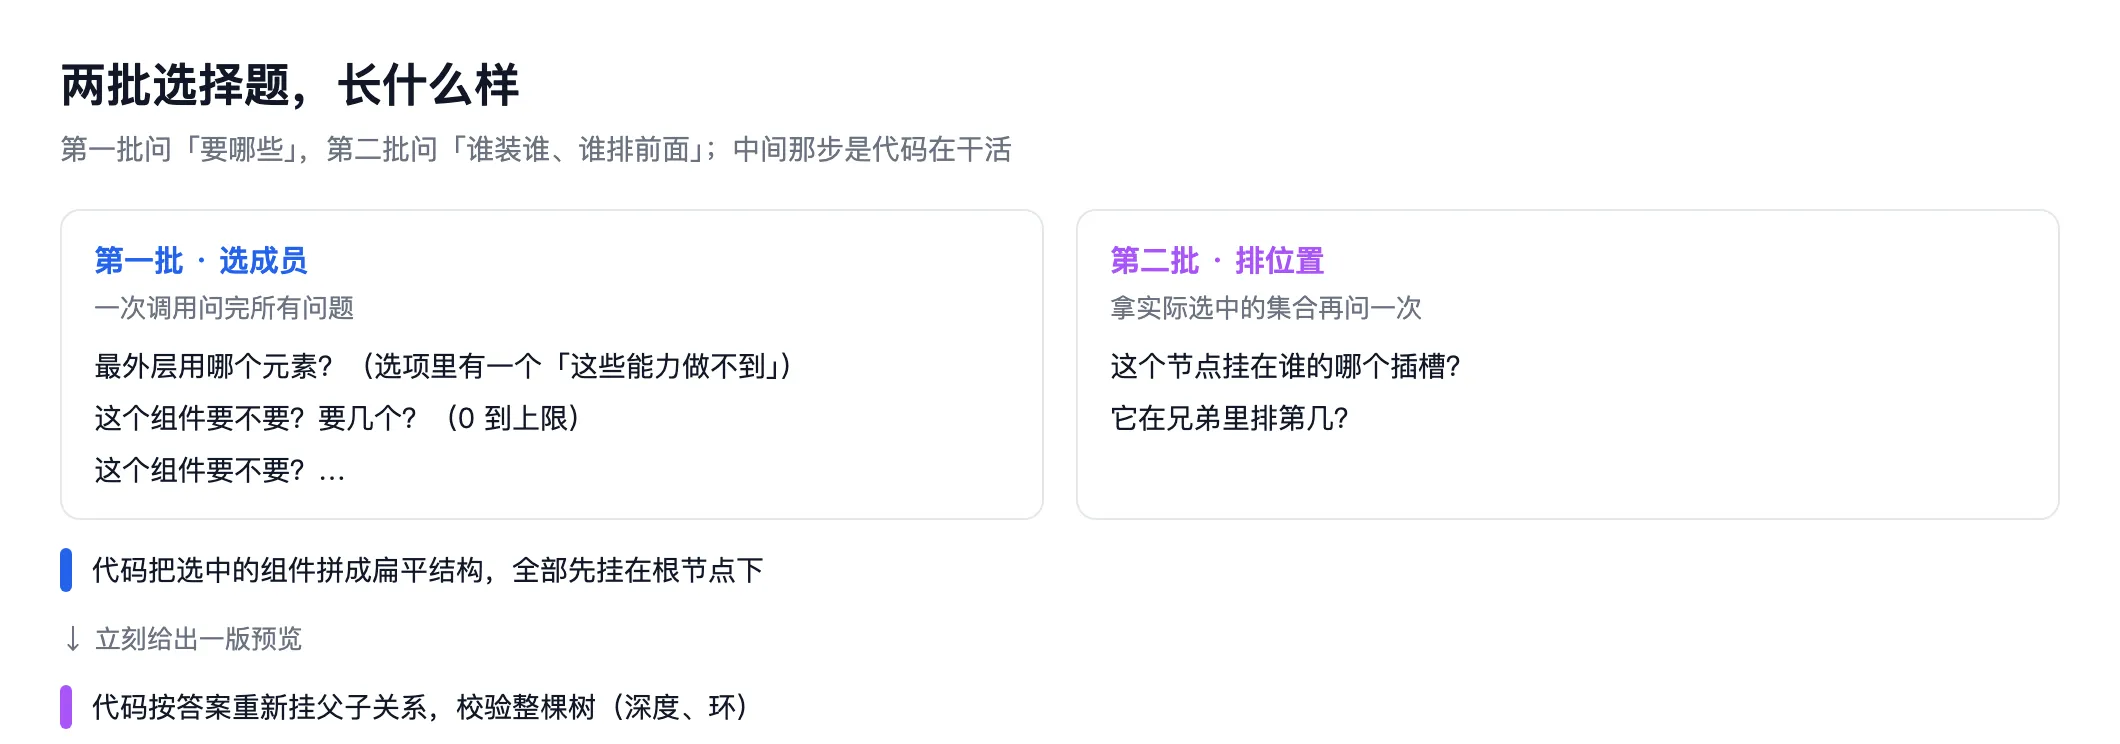
いくつかの細部は個別に触れておく価値がある。どれも「生成を選択に変える」ときに必ず払うことになるコストだ。
各設問の選択肢は有限でなければならない。だから棒グラフと折れ線グラフは同じ設問の排他的な選択肢として並べられ、モデルが両方を同時に選ぶことはありえない。繰り返し使えるコンポーネント(カード、スタック、グリッド)は個数を問う設問になり、選択肢は0から上限までの数字だ。外側のrootの設問には「これらの能力では実現できない」という特別な選択肢もある。手持ちの候補では求められたものを組み上げられないとモデルが判断したとき、無理にでっち上げるのではなく、そのまま棄権できる。
2回目の設問には明らかな落とし穴がひとつあり、他人のコードにはそれがはっきり書かれている。「このノードを誰の下にぶら下げるか」を問う設問では、各候補ノードが自分自身を除外する必要がある。さもないと自分が自分の親になり、循環が生まれる。コードのコメントはさらに厳しいことを補足している。個々の選択が単体で見て合法でも、組み合わせると深さ制限を超えたり循環したりしうるので、木全体を公開前に完全に検証しなければならない。
単一ルート・単一スロットのときは、2回目をまるごとスキップする。実に実用的な判断で、往復を1回節約できるなら節約する。
何を送り、何を受け取るか
この仕組みは Vercel AI Gateway の実験的な評価エンドポイントを使う。モデル id はtypesafe-ai/jev、リクエストボディは TypeSafe ネイティブの形そのままだ。
{
  "state": {
    "user_request": "设计一个用户资料卡",
    "context": { "platform": "……" },
    "guidance": "……",
    "capabilities": [
      { "id": "card", "description": "Card: a bordered container for a compact form" },
      { "id": "avatar", "description": "Avatar: the user's profile picture, bound to the record" }
    ]
  },
  "questions": {
    "root": {
      "type": "choice",
      "instructions": "Choose the outermost element for user_request.……",
      "criteria": { "card": "……", "stack_vertical": "……", "unavailable": "……" }
    },
    "select_1": { "type": "choice", "instructions": "……", "criteria": { "omit": "……", "use:avatar": "……" } }
  }
}このデータで最も重要な判断をひとつ訳すと、送られるのはユーザーのリクエストと候補の説明だけだ。コンポーネントの実際の props、状態バインディング、フォームにユーザーがすでに入力した値は、モデルには送られない。つまりモデルは「アバターというコンポーネントがあり、ユーザーレコードにバインドされている」ことは見えるが、そのレコードに何が書かれているかは見えず、ましてユーザーが入力したメールアドレスなど見えない。
返ってくるのは各設問の選択と、Gateway が透過的に渡してくる信頼度だ。
{
  "answers": { "root": { "type": "choice", "choice": "card" } },
  "providerMetadata": { "typesafe": { "confidence": { "root": 0.73 } } },
  "usage": { "inputTokens": 1234 }
}コードはここで私の気に入っていることをひとつやっている。型安全性を契約として使うのだ。すべての回答は設問が提示した選択肢の中になければならず、提供されていない選択肢が現れたら、クライアントは知らん顔して描画を続けるのではなく、その場でエラーを投げる。
選択から描画できるデータへ
1回目の回答を受け取ってからの流れはこうだ。コードは選ばれたコンポーネントをフラットな構造に組み上げ、各要素をまずルートノードのデフォルトスロットの下にぶら下げ、検証を1回通し、そのままプレビューを1版フロントエンドに送る。ユーザーはまず何かを見て、それから配置を待つ。
2回目の回答が戻ると、コードはプライベートなコピーの上で親子関係を付け替え、木全体の深さと循環を検証し、最終構造を送る。
ブラウザに送られるのはパッチのストリームで、各パッチは前の版と新しい版の差分を記録し、そこにいくつかのメタ情報(このステップにどれだけかかったか、入力トークンをどれだけ消費したか)が付く。だからフロントエンドはキャンバス全体を再描画する必要がなく、ユーザーが画面上で加えた編集が1回の上書きで流し去られることもない。
「画面を組み立てる」1回のコストはおおよそこの数字だ。評価エンドポイントは入力トークンで課金され、入力は100万トークンあたり0.042ドル、出力は課金されず、1回の設問群で1回の呼び出しと数える。json-render の playground では、1リクエストの上限は評価14回、要素14個、ネストの深さ4層、1回の呼び出し10秒、1ラウンド55秒だ。
この方法の境界
これは文章を書かない。 ここが最も誤解されやすい点だ。モデルは候補からコンポーネントを選べるし、リクエスト内で引用符に括られたタイトルを追加のタイトル候補としてコピーすることもできるが、あなたが求めているあの紹介文をでっち上げることはできない。だから playground にあるフィールド、ラベル、ユーザープロフィール、売上データは、すべてプラットフォームが事前に用意したものだ。自分で接続するときも同じで、文章とデータはあなたのレコード、辞書項目、フォーム定義から供給しなければならない。
構造のルールは依然として人が書く。 これが私が最も指摘したい箇所だ。compose.tsにはハードコードされた設計上の常識が詰まっている。ログイン画面にはメール、パスワード、送信ボタンが必要だ。見出しとフォームフィールドを横並びのボタン行に入れてはいけない。カードの中にもう一つ余計な縦スタックを詰め込まない。これらはすべてエンジニアがプロンプトに書き込むもので、モデル自身がこうした判断をするわけではない。
信頼度は品質のゲートではない。 ドキュメントには率直に書かれている。信頼度は表示されるが、統一的に使えるしきい値はない。同じリクエストの中で複数の配置の選択がどれも妥当でありうるのは、この種のタスクそのものの性質であって、モデルの較正が狂っているわけではない。
結果は部分的でありうる。 完了イベントには3種類の終了理由がある。正常終了、モデルができないと表明した、あるいは呼び出し回数か要素数の上限に達した。しかも完了と印された結果でも部分的な構造にすぎないことがあり、ドキュメントは完了は正しさを意味しないとはっきり書いている。この点はほとんどの製品より誠実だと私は思う。
参考にすべき3点
私たちは先月 Jev を実測し、その確率は正解率としては使えないが、「人に渡すかどうか」のスイッチとしては使えるという結論に達した。json-render のこの実験は別の使い方を示している。モデルが責任を負うべきでないことを、モデルの手から取り上げるのだ。
第一に、検証できるものはコードに任せる。 木の深さ、循環の有無、選択肢が範囲を超えていないか、文章がどこから来るか、すべてコードが決める。モデルが担うのはただひとつ、すでに用意された答えの集合の中から選ぶことだけだ。自由度は最小限に抑えられ、誤りの余地も最小限に抑えられる。
第二に、モデルに棄権の選択肢を残す。 unavailableという選択肢は少しも派手ではないが、最も収拾がつきにくい失敗を避けてくれる。つまり、使える材料が手元にないのに、それでも無理やり画面を組み上げてしまう事態だ。
第三に、「設問群」をインターフェース設計として扱う。 1回の呼び出しでメンバーに関する設問をすべて聞き、2回目でようやく位置を聞く。この順序は適当に決めたものではない。メンバーの選択が、その後どんな設問を出せるかを決めるのだから、順序には実際の根拠がある。ついでにレイテンシも「コンポーネントごとに1往復」から最大2回に圧縮される。
この道のコストもはっきりしている。モデルは何も新しいものを書かないので、その上限はあなたがどれだけ候補を用意したかで決まる。候補の作りが粗ければ、出てくる画面も粗い。あのハードコードされた設計上の常識も、こう教えてくれる。「画面を組み立てる」という作業のうち一部の判断は、今のところまだ人が明示的に書かなければならない。モデルは「ログイン画面にどのフィールドが必要か」を自分で判断できる段階にはまだ達していない。
素材の入口はすべて json-render リポジトリにあり、コードコメントのほうがドキュメントより詳しい。プロトコルアダプタは packages/core/src/experimental-evaluator.ts、2 種類の問題をどう出すかは experimental-composition-batch.ts、候補の定義は apps/web/lib/jev/grammar.ts にある。公式の説明は json-render.dev/docs/jev を参照。