让 AI 搭界面,但只让它做选择题
让大模型直接写界面 JSON,它会编出不存在的组件、自己编文案,写坏了还得等结果回来才知道。json-render 换了个办法,把搭界面拆成两批有限的选项,模型只挑,代码负责拼。
中文
复制
让大模型直接写界面,你大概试过。它会把组件名写错、把文案编出来、把 JSON 写坏,而你要等结果回来才知道它写了什么。json-render 最近放出一个实验,换了个路子,把「搭一个界面」拆成两批有限的选择题,模型只负责选,代码负责拼。
先看两条老路的毛病
让模型产出界面,通常是两种做法。
一种让它写整棵树,组件名、属性、文案全归它管。{"type":"Card","props":{"title":"账号设置"}} 这种结构,模型当然写得出来,问题是它也能写出你根本没注册的组件、没定义的属性,以及一段莫名其妙的中文文案。你拿到结果后才知道它写了什么,校验只能做事后补救。
另一种是每个组件单开一次对话,或者让它自己决定下一步。结果是一个界面要来回好几趟,前面选了什么后面还得再传一遍。
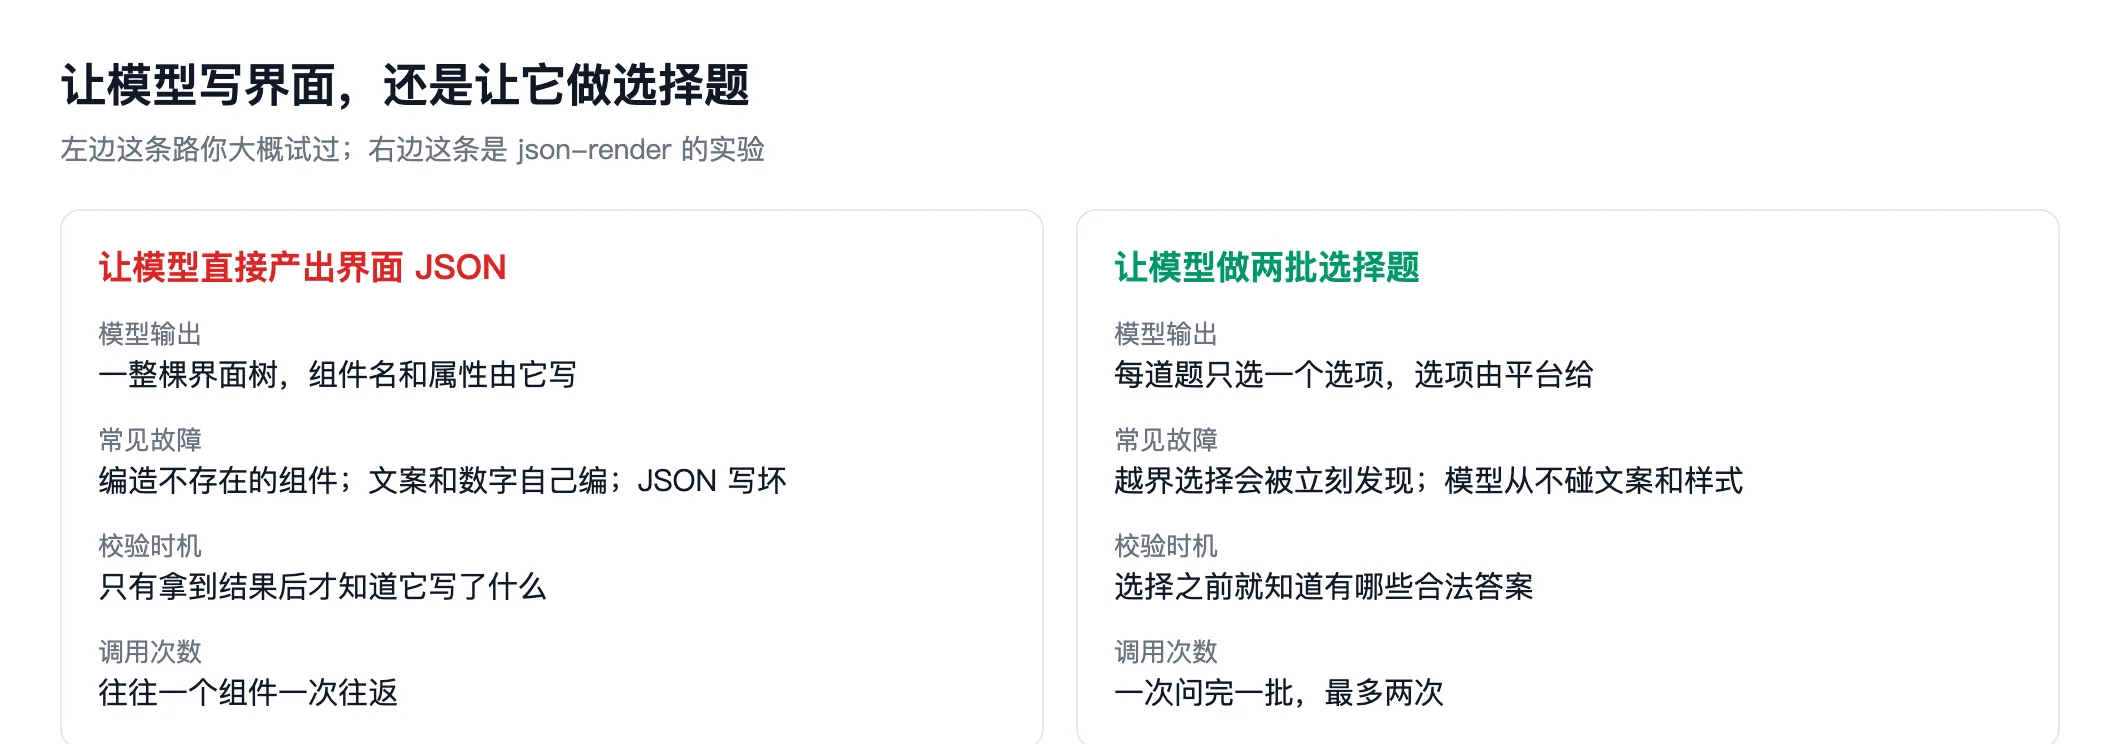
json-render 的实验瞄准的是这个问题。它的做法一句话能说完,让模型做的每一件事,都变成在一组由平台写好的选项里挑一个。
把「写」改成「选」
第一次看到「用决策模型搭界面」这个说法,我猜它管的是「这里放按钮还是输入框」这类零碎决策。翻完代码才发现激进得多,它把整个组装过程拆成了两批问题。
第一批问成员,一次调用问完所有候选,最外层用哪个元素、这个组件要不要、要几个。第二批问位置,拿真正选中的那几个元素再问一次,它挂在谁的哪个插槽、在兄弟里排第几。
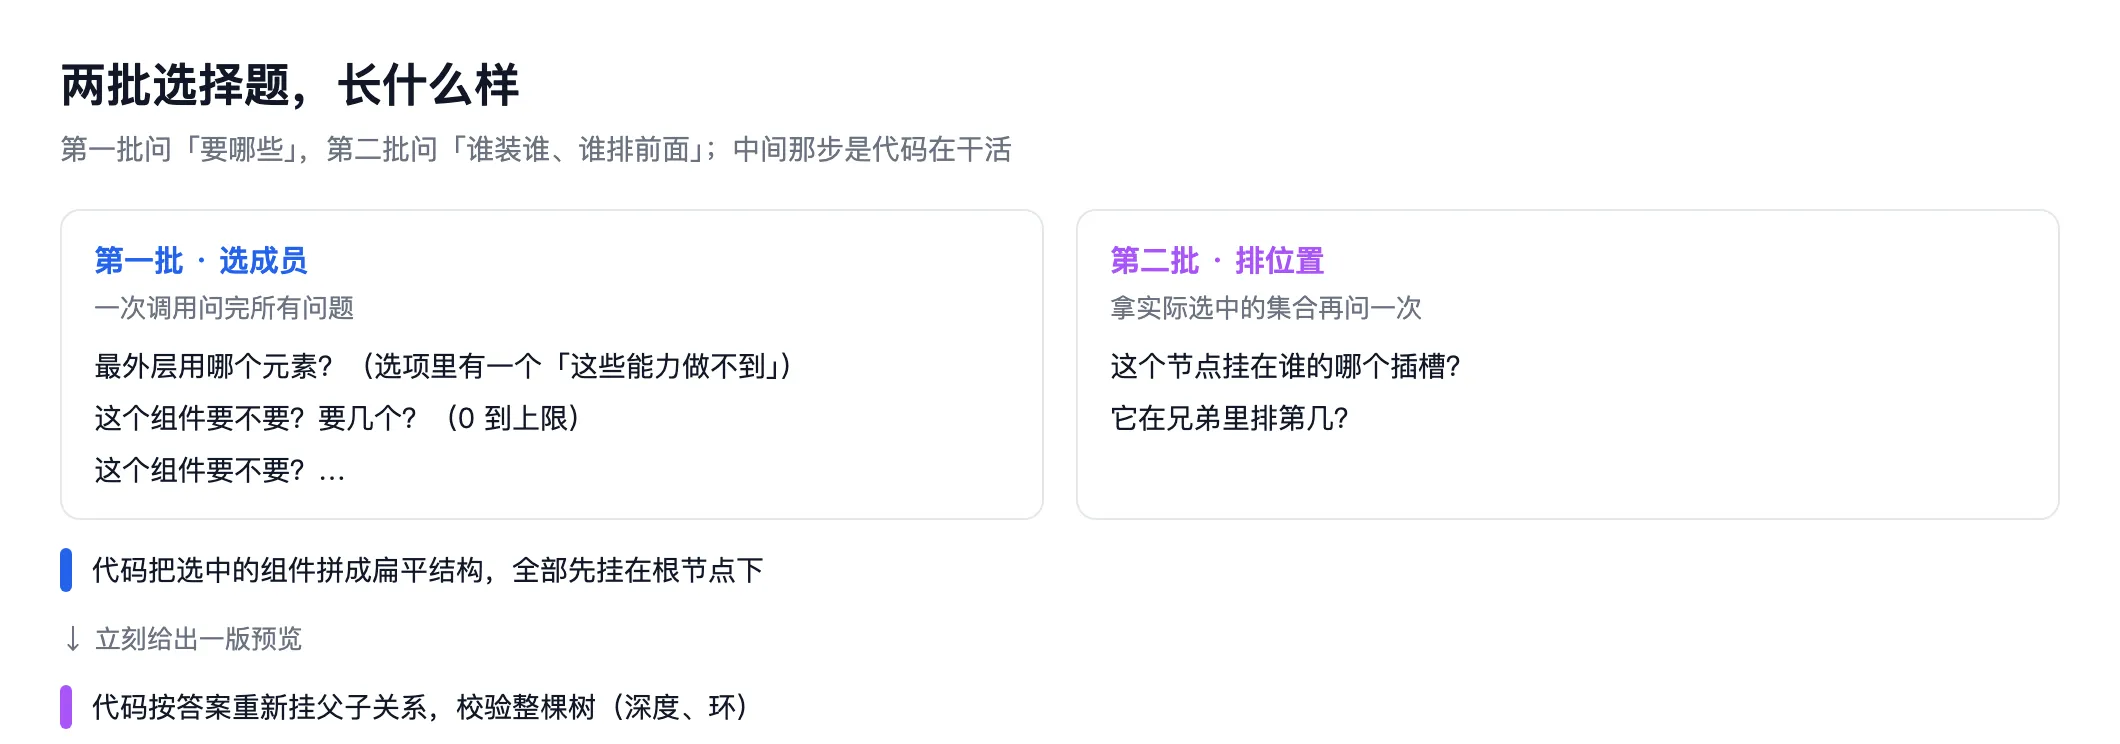
几个细节值得单独说,它们都是「把生成变成选择」时必须付的账。
每道题的选项必须是有限的。所以柱状图和折线图被放进同一道题当互斥选项,模型不可能同时选中两个。可重复的组件(卡片、堆叠、网格)变成一道计数题,选项是 0 到上限的数字。外层的 root 题里还有一个特殊选项,叫「这些能力做不到」,模型觉得手里的候选凑不出你要的东西时,可以直接弃权,而不是硬拼一个出来。
第二批的问题里有一个明显的坑,别人的代码里写得很清楚。给「这个节点挂到谁下面」出题时,每个候选节点都要把自己排除掉,否则它会给自己当爹,画出环。代码的注释还补了一句更狠的话,就算每个选择单独看都合法,拼起来仍然可能超过深度限制或者成环,所以整棵树必须在发布之前完整校验一遍。
单根加单插槽的时候,第二批直接跳过。这一点挺务实,能省一次往返就省。
发出去什么,收回来什么
这套东西走的是 Vercel AI Gateway 的实验评估端点,模型 id 写 typesafe-ai/jev,请求体就是 TypeSafe 原生的形状。
{
  "state": {
    "user_request": "设计一个用户资料卡",
    "context": { "platform": "……" },
    "guidance": "……",
    "capabilities": [
      { "id": "card", "description": "Card: a bordered container for a compact form" },
      { "id": "avatar", "description": "Avatar: the user's profile picture, bound to the record" }
    ]
  },
  "questions": {
    "root": {
      "type": "choice",
      "instructions": "Choose the outermost element for user_request.……",
      "criteria": { "card": "……", "stack_vertical": "……", "unavailable": "……" }
    },
    "select_1": { "type": "choice", "instructions": "……", "criteria": { "omit": "……", "use:avatar": "……" } }
  }
}翻译一下这段数据里最关键的一个决定,发出去的只有用户请求和候选描述。组件真正的 props、状态绑定、表单里用户已经填进去的值,都不发给模型。也就是说模型能看到「有个组件叫头像,绑定到用户记录上」,看不到那个记录里写了什么,更看不到用户输入的邮箱。
收回来的是每道题的选择,外加 Gateway 透传过来的置信度。
{
  "answers": { "root": { "type": "choice", "choice": "card" } },
  "providerMetadata": { "typesafe": { "confidence": { "root": 0.73 } } },
  "usage": { "inputTokens": 1234 }
}代码在这里做了一件我很喜欢的事,它把类型安全当成契约来用。每个答案都必须在题目给出的选项里,出现一个没提供过的选项,客户端直接抛错,而不是揣着明白装糊涂继续渲染。
从选择到能渲染的数据
拿到第一批答案后的流程是这样的。代码把选中的组件拼成一个扁平结构,每个元素先挂在根节点的默认插槽下,校验一遍,然后立刻推一版预览给前端。用户先看到东西,再等排列。
第二批答案回来后,代码在私有副本上重挂父子关系,校验整棵树的深度和环,然后推送最终结构。
推给浏览器的是补丁流,每一条记录前一版和新版本之间的差异,外加一些元信息(这一步花了多久、烧了多少输入 token)。所以前端不需要重新渲染整个画布,用户在界面上做的编辑也不会被一次覆盖冲掉。
一次「搭界面」的成本大致就是这个数,评估端点按输入 token 计费,输入每百万 token 0.042 美元,输出不计费,一批问题算一次调用。json-render 的 playground 里,一个请求的上限是 14 次评估、14 个元素、嵌套深度 4 层、单次调用 10 秒、整轮 55 秒。
这套办法的边界
它不会写文案。 这是最容易被误解的一点。模型能从候选里挑组件,也能把请求里用引号括起来的标题抄进去当一个额外的标题候选,但它编不出你要的那句介绍文字。所以 playground 里那些字段、标签、用户资料、销售数据,全是平台提前准备好的。你自己接的时候也一样,文案和数据得由你的记录、词条、表单定义来提供。
结构规则还是人写的。 这是我最想指出来的一处。compose.ts 里塞满了硬编码的设计常识,登录界面需要邮箱、密码和提交按钮,标题和表单字段不能放进横向的按钮行,不要再往卡片里塞一个多余的垂直堆叠。这些都由工程师写进提示词,模型自己不做这种判断。
置信度不是质量闸门。 文档里写得很直白,置信度会显示出来,但没有统一的阈值可用。同一次请求里,多个排列选择都可能是合理的,这是这类任务本身的性质,不是模型没校准好。
结果可能是部分的。 完成事件里有三种结束原因,正常结束、模型表示做不到、或者撞上了调用数或元素数上限。而且一个标记为完成的结果也可能只是部分结构,文档明确写了完成不等于正确。这一点我认为比多数产品诚实。
值得借鉴的三点
我们上个月实测过 Jev,结论是它的概率不能当正确率用,但可以当「要不要交给人」的开关。json-render 这个实验给出了另外一种用法,把模型不该负责的事情从它手里拿走。
第一,能校验的东西交给代码。 树的深度、有没有环、选项有没有越界、文案从哪来,全是代码说了算。模型只负责一件事,在一组已经准备好的答案里挑。它的自由度被压到最小,出错的空间也就被压到最小。
第二,给模型留一个弃权的选项。 unavailable 这个选项一点都不花哨,但它避免了最难收场的一种失败,也就是模型手里明明没有能用的材料,还是硬拼一个界面出来。
第三,把「一批问题」当成接口设计。 一次调用问完所有成员问题,第二轮才问位置,这个顺序不是随手定的。成员的选择决定了后面能提哪些问题,所以顺序有真实依据。它顺便把延迟从「每个组件一次往返」压到了最多两次。
这条路的代价也很清楚。模型不会写任何新东西,所以它的上限取决于你准备了多少候选。候选准备得糙,出来的界面就糙。那句硬编码的设计常识也提醒我们,「搭界面」这件事里有一部分判断目前还得人来写清楚,模型还没到能自己判断「登录界面该有哪些字段」的地步。
原始材料的入口都在 json-render 仓库里,代码注释写得比文档细。协议适配器在 packages/core/src/experimental-evaluator.ts,两批问题怎么出在 experimental-composition-batch.ts,候选定义在 apps/web/lib/jev/grammar.ts。官方说明在 json-render.dev/docs/jev。