Ternary Bonsai 2 27B:体積 9 分の 1、ベンチマーク性能の 98.2% を保持
Qwen3.8 27B をベースに三値重みで 5.9GB(重みあたり 1.76 実効ビット)まで圧縮し、総合ベンチマークの 98.2% を保持。RTX 5090 で 143 トークン/秒、Apache 2.0 で公開。
日本語
コピー
2 か月前、私たちは第一世代の Bonsai 27B モデルを公開し、27B 級のマルチモーダルモデルをローカルデバイスで効率よく動かせるまで圧縮できることを示した。本日、Ternary Bonsai 2 27B を公開する。これまでで最も高性能なモデルだ。
Ternary Bonsai 2 27B は Qwen3.8 27B をベースに、推論・コーディング・視覚・agentic 能力を高めつつ、Bonsai シリーズを特徴づける配備プロファイルを維持している。すなわち、大幅に小さいメモリフットプリント、高いローカルスループット、優れたエネルギー効率だ。
Ternary Bonsai 2 27B は三値 {−1, 0, +1} の重みと FP16 のグループ単位スケーリングを使い、重みあたり 1.76 実効ビット、モデル全体で 5.9GB を実現している。低ビット表現は言語モデル全体にエンドツーエンドで適用される。262K トークンのコンテキストウィンドウ、テキストと画像のマルチモーダル入力に対応し、Apache 2.0 ライセンスで公開される。
フル精度の対応モデルと比べて、Ternary Bonsai 2 27B は体積が 9 倍以上小さく、同時に総合ベンチマーク性能の 98.2% を保持している。この水準の保持率では、圧縮そのものが「配備の解禁」になる。能力はほぼそのままで、動かせる場所がはるかに増えるのだ。
第一世代の Bonsai 27B からの変化
第一世代の Bonsai 27B は重要なマイルストーンだった。27B 級の知能をローカルデバイスで動かす実用的な道を示した。Bonsai 2 27B が狙うのは次の段階、すなわち実際のローカルアプリケーションに必要なモデル品質とランタイム性能の向上だ。前世代の Bonsai 27B と比べて、Bonsai 2 27B は次をもたらす。
- より強いベースモデル、Qwen3.8 27B
- フル精度モデルに対する総合能力保持率 98.2%
- 推論・コーディング・視覚・長期的な agentic 性能の改善
同じ配備点で、より高い能力
推論・数学・コーディング・指示追従・視覚・agentic なツール使用をカバーするベンチマーク群で、Ternary Bonsai 2 27B は 83.9 を記録し、Qwen3.8 27B の総合性能の 98.2% を保持している。
| 能力 | Ternary Bonsai 2 27B | Qwen3.8 27B | Qwen3.6 27B |
|---|---|---|---|
| Agentic とツール呼び出し(τ²-bench、BFCLv3) | 77.57 | 79.74 | 80.05 |
| コーディング(HumanEval+、LiveCodeBench v6、MBPP+、BigCodeBench) | 81.58 | 82.17 | 82.57 |
| 指示追従(IFBench、IFEval) | 82.66 | 81.25 | 74.53 |
| 知識と推論(MMLU-Redux、GPQA Diamond、AA-LCR) | 83.95 | 86.66 | 84.71 |
| 数学(AIME 2026、AIME 2025、GSM8K、MATH-500) | 96.57 | 97.06 | 94.64 |
| 視覚(CharXiv、A-OKVQA、OmniDocBench v1.6、RealWorldQA、OCRBench v2) | 78.59 | 81.64 | 79.82 |
| 総合 | 83.9 | 85.4 | 83.6 |
図 I: Ternary Bonsai 2 27B(thinking モード)のベンチマークスコアを、フル精度の Qwen3.8 27B および Qwen3.6 27B のベースラインと比較したもの。各ベンチマークの詳細はホワイトペーパーに記載。
重要なのは総合スコアだけではなく、能力がどこで保持されているかだ。コーディングエージェント、ツール使用システム、マルチモーダルなワークフロー、長期タスクは、小さな誤りが多くのステップで積み重なるため、モデルの劣化に特に敏感である。Bonsai 2 27B はこうした領域でまさにフル精度モデルの性能の大半を保ちながら、メモリフットプリントはその何分の一かで動く。
フル精度モデルや他の低ビット代替と比べて、Bonsai 2 27B は「知能密度」において外れ値だ。多くの低ビット代替は、コーディング・視覚・agentic なツール使用の実質的な能力を犠牲にして初めて配備可能になる。Bonsai 2 27B は、より高い能力とより低いメモリ使用量の両方向へフロンティアを押し広げる。
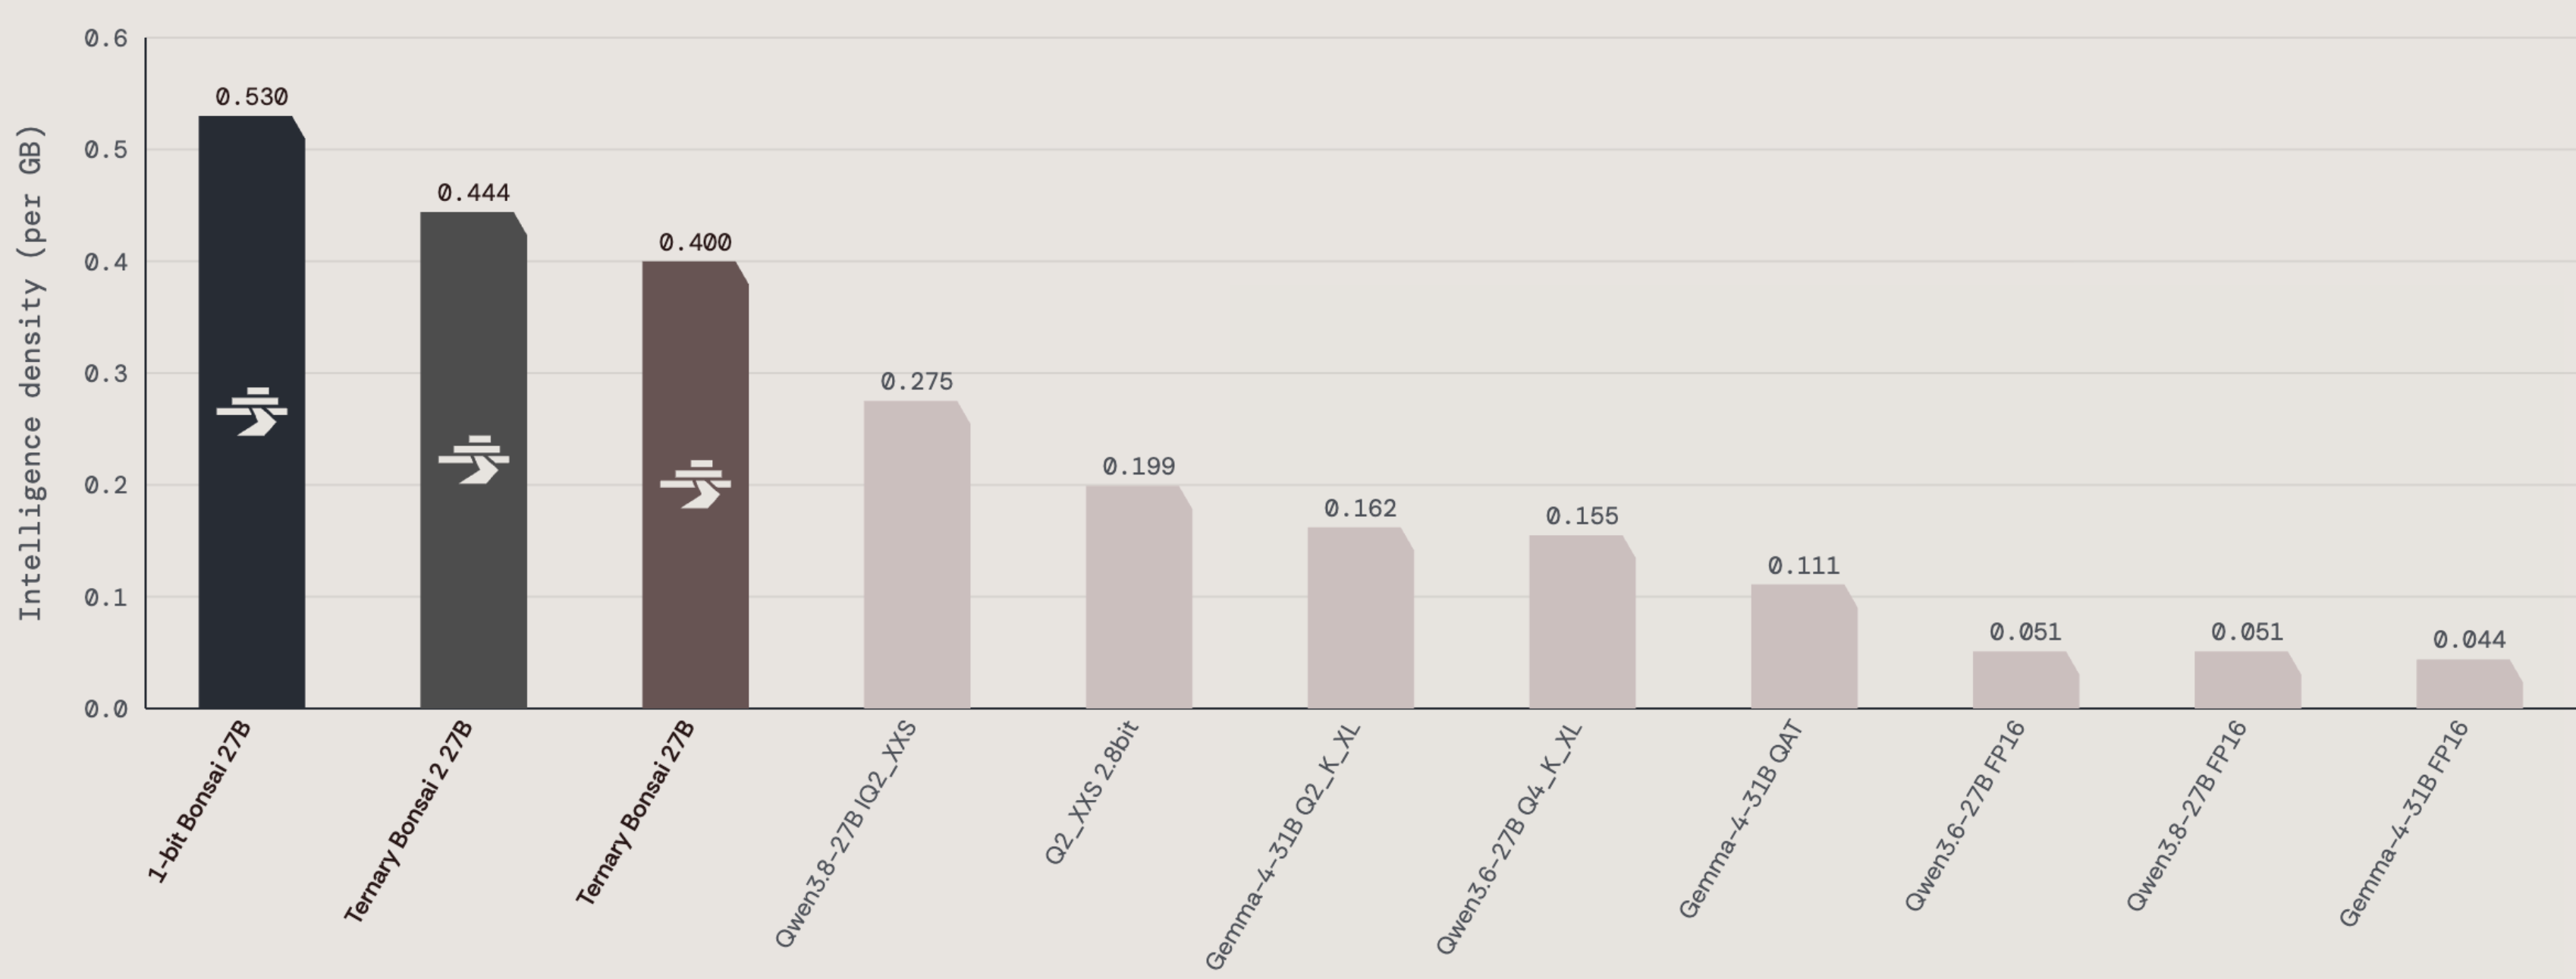
図 II: Ternary Bonsai 2 27B と同パラメータ帯の他モデルとの知能密度(1GB あたり)比較。
デモ I:NVIDIA GeForce RTX 5090 上で Ternary Bonsai 2 27B が動かす Cline のコーディングエージェント。
Bonsai 2 27B によって、ローカルモデルは本物の知識労働を担い始められる。コーディングエージェントのループ、computer-use ワークフロー、プライベートな文書分析、マルチモーダルなデバッグ、そしてハイブリッドなオーケストレーション——機密性の高い処理や高頻度の処理はローカルが担い、必要なものだけを選択的にクラウドへ送る形だ。
スループットとエネルギー効率
Ternary Bonsai 2 27B は NVIDIA GeForce RTX 5090 で最大 143 トークン/秒、M5 Max で 46.8 トークン/秒に達する。RTX 4090 では、Ternary Bonsai 2 27B は 1 トークンあたりわずか 0.714 mWh しか消費せず、フル精度で動かす 8B モデルよりエネルギー効率が 40% 高い。
コーディングアシスタントにとって、高いスループットは編集とデバッグのループが速くなることを意味する。マルチモーダルエージェントにとっては、スクリーンショット・文書・ツール呼び出しをより速く反復できることを意味する。プライベートなローカルワークフローにとっては、同じデバイスでより多くの有用な推論を回せ、バッテリーが長持ちし、常にクラウドを呼ばずに背後で動き続けるアシスタントへの現実的な道が開けることを意味する。
このリリースが重要な理由
Ternary Bonsai 27B と比べて、新しい Ternary Bonsai 2 27B はフル精度モデルに対する保持率を 95% から 98% 超へと引き上げた。これは大きな改善であり、現行リリースを実用上ほぼ「ロスレス」にしている。低ビットモデルが AI 配備の最良の方法になり得るという見方を、さらに強固にするものだ。
その影響はローカル推論にとどまらない。低ビットモデルは、デバイス・ワークステーション・データセンターをまたいで AI システムの経済性とアーキテクチャを変え得る。同じメモリ枠に大きなモデルを収め、同じハードウェアでより多くのユーザーに提供し、推論あたりのエネルギーを下げ、何をローカルで動かし何をクラウドに送るかを動的に決めるハイブリッド構成を可能にする。
問われるのは「モデルがどれだけ賢いか」ではなく、ますます「与えられたメモリ・計算・電力の予算内で、どれだけ有用な知能を届けられるか」になっていく。能力が伸び続けながらこれらの要件が大きく下がるなら、将来のモデルの配備範囲はスタック全体に広がる——個人のデバイスから大規模データセンターまで。
対応プラットフォーム
Bonsai 2 27B は CUDA 経由で NVIDIA GPU 上で、また独自の低ビットカーネルを通じて MLX 経由で Apple デバイス(Mac、iPhone、iPad)上で動作する。モデル重みは本日より Apache 2.0 ライセンスで提供される。
圧縮・評価・ベンチマーク手順の技術的な詳細はすべてホワイトペーパーで公開している。