Ternary Bonsai 2 27B:体积缩小 9 倍,保留 98.2% 基准表现
基于 Qwen3.8 27B 的三值权重模型把体积压到 5.9GB(每权重 1.76 有效比特),综合基准保留 98.2%,在 RTX 5090 上跑到 143 token/秒,并按 Apache 2.0 发布。
中文
复制
两个月前,我们发布了第一代 Bonsai 27B 模型,证明 27B 级别的多模态模型可以被压缩到足以在本地设备上高效运行。今天,我们发布 Ternary Bonsai 2 27B,这是我们迄今最强的模型。
Ternary Bonsai 2 27B 基于 Qwen3.8 27B,在推理、编码、视觉与 agentic 能力上都更强,同时保持了 Bonsai 系列一贯的部署特性:内存占用大幅缩小、本地吞吐高、能效更好。
Ternary Bonsai 2 27B 使用三值 {−1, 0, +1} 权重,配合 FP16 的分组缩放,做到每个权重 1.76 有效比特,模型总体积 5.9GB。低位表示在整个语言模型上端到端应用。它支持 262K token 上下文窗口、文本与图像的多模态输入,并以 Apache 2.0 许可发布。
与其全精度对应模型相比,Ternary Bonsai 2 27B 体积缩小 9 倍以上,同时保留了 98.2% 的综合基准表现。在这种保留水平下,压缩本身就成了「部署解锁」:能力几乎不变,但能跑的地方多得多。
相比第一代 Bonsai 27B 有什么变化
我们的第一代 Bonsai 27B 是一个重要节点:它提供了一条把 27B 级智能放到本地设备上的实用路径。Bonsai 2 27B 关注的是下一步——提升真实本地应用所需的模型质量与运行时表现。与前一代 Bonsai 27B 相比,Bonsai 2 27B 带来:
- 更强的基座模型,Qwen3.8 27B
- 相对全精度模型的综合能力保留率提升到 98.2%
- 推理、编码、视觉与长程 agentic 表现均有改善
同样的部署位置,更高的能力
在一套覆盖推理、数学、编码、指令遵循、视觉与 agentic 工具使用的基准中,Ternary Bonsai 2 27B 得分 83.9,保留了 Qwen3.8 27B 综合表现的 98.2%。
| 能力 | Ternary Bonsai 2 27B | Qwen3.8 27B | Qwen3.6 27B |
|---|---|---|---|
| Agentic 与工具调用(τ²-bench、BFCLv3) | 77.57 | 79.74 | 80.05 |
| 编码(HumanEval+、LiveCodeBench v6、MBPP+、BigCodeBench) | 81.58 | 82.17 | 82.57 |
| 指令遵循(IFBench、IFEval) | 82.66 | 81.25 | 74.53 |
| 知识与推理(MMLU-Redux、GPQA Diamond、AA-LCR) | 83.95 | 86.66 | 84.71 |
| 数学(AIME 2026、AIME 2025、GSM8K、MATH-500) | 96.57 | 97.06 | 94.64 |
| 视觉(CharXiv、A-OKVQA、OmniDocBench v1.6、RealWorldQA、OCRBench v2) | 78.59 | 81.64 | 79.82 |
| 综合 | 83.9 | 85.4 | 83.6 |
图一: Ternary Bonsai 2 27B(thinking 模式)的基准得分,对比全精度 Qwen3.8 27B 与 Qwen3.6 27B 基线。完整的逐项结果见白皮书。
关键结果不只是综合得分,而是能力保留在哪些地方。编码 agent、工具使用系统、多模态工作流与长程任务对模型退化格外敏感,因为小的错误会在很多步之后累积。Bonsai 2 27B 恰恰在这些方面保留了全精度模型的绝大部分表现,而内存占用只是其中一小部分。
与全精度模型以及其他低位替代方案相比,Bonsai 2 27B 在「智能密度」上是个异类。许多低位方案之所以能部署,是以牺牲编码、视觉或 agentic 工具使用的实际能力为代价的。Bonsai 2 27B 把前沿同时推向了更高的能力与更低的内存占用。
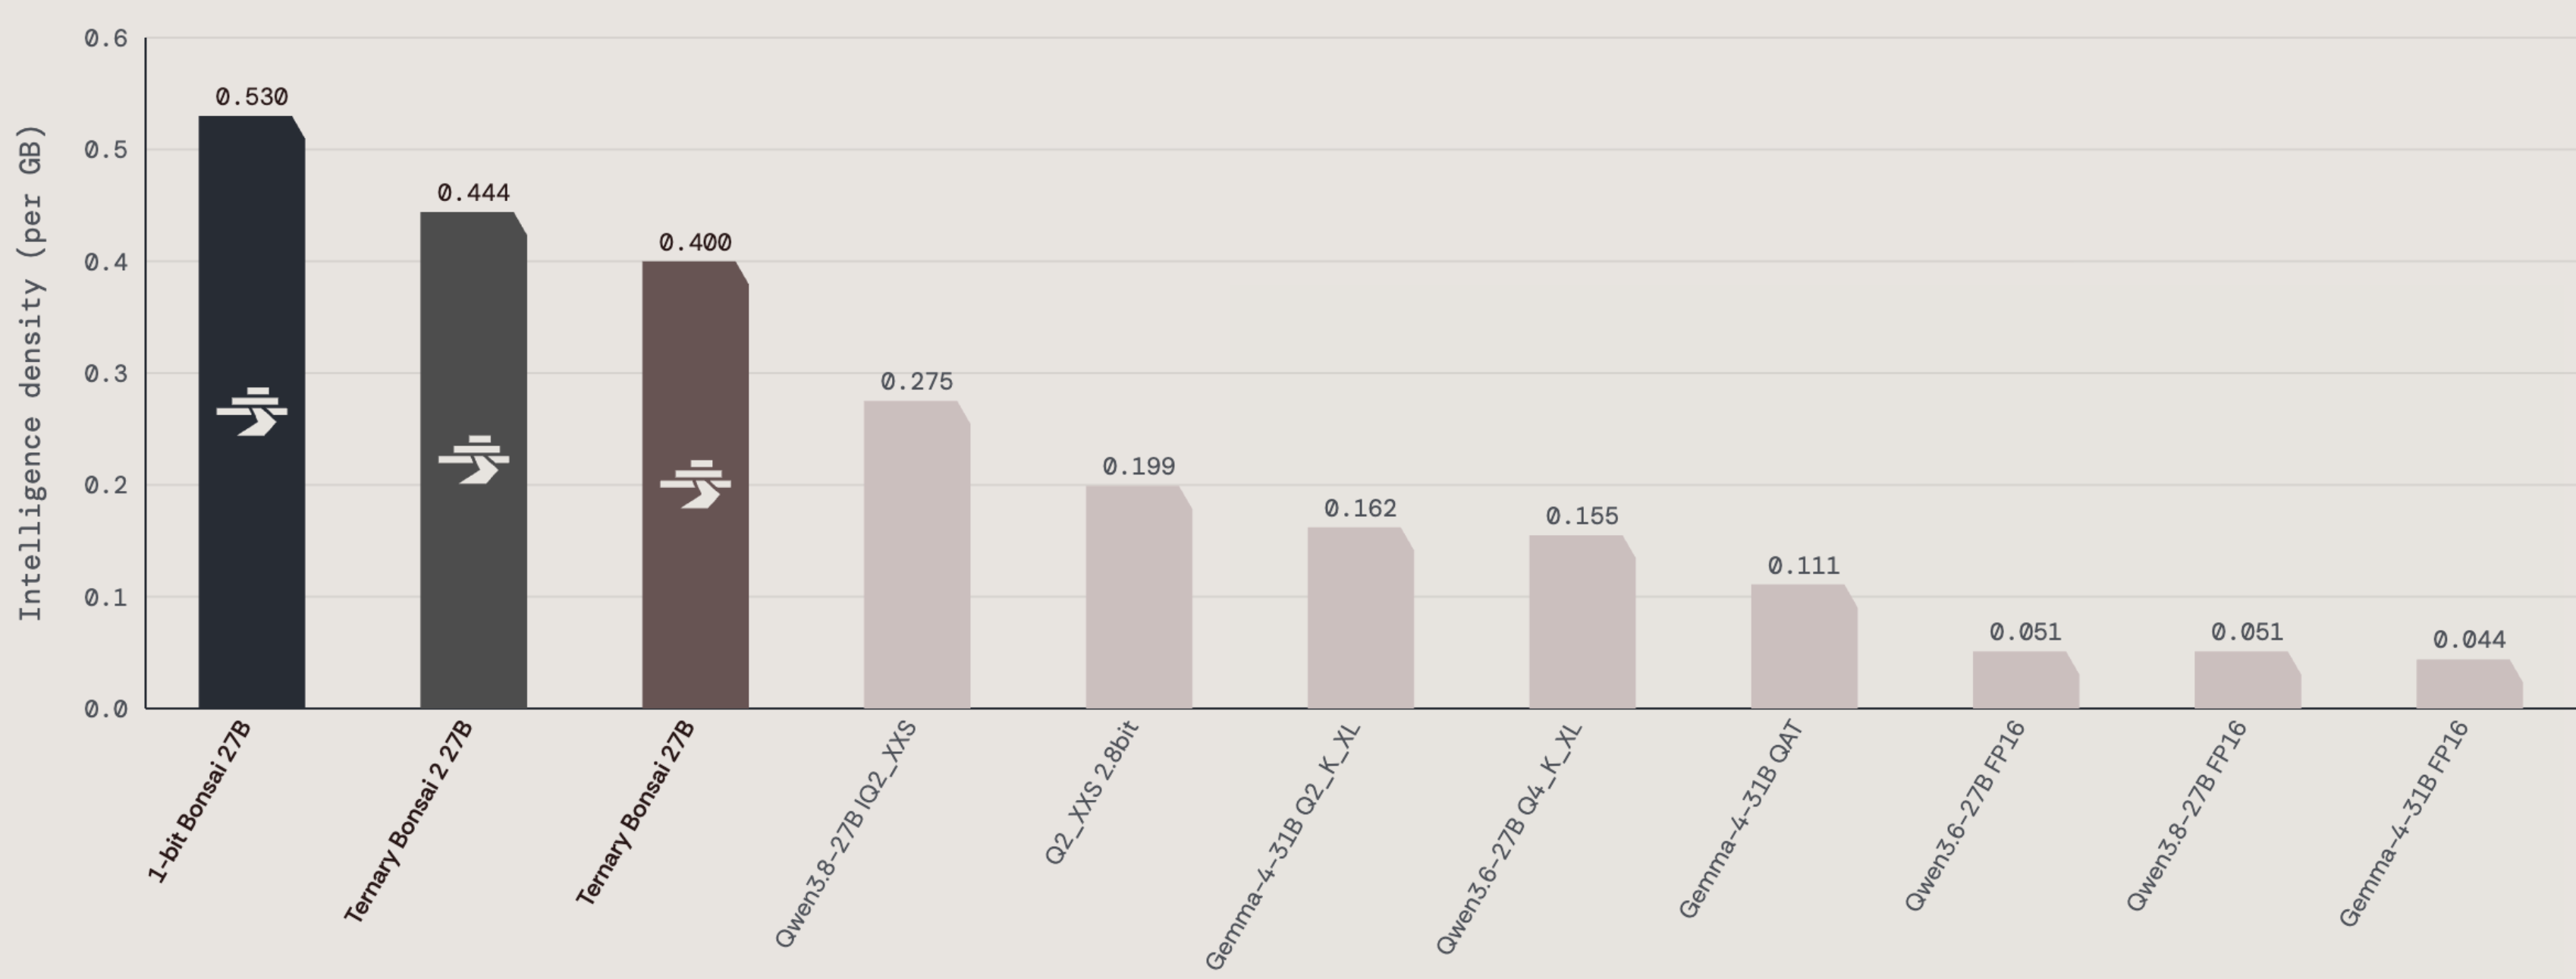
图二: Ternary Bonsai 2 27B 与同参数级别其他模型在智能密度(每 GB)上的对比。
演示一:在 NVIDIA GeForce RTX 5090 上由 Ternary Bonsai 2 27B 驱动的 Cline 编码 agent。
有了 Bonsai 2 27B,本地模型可以开始承担真正的知识工作:编码 agent 循环、computer-use 工作流、私有文档分析、多模态调试,以及混合编排——由本地模型处理敏感或高频的任务,并有选择地把部分任务上交云端。
吞吐与能效
Ternary Bonsai 2 27B 在 NVIDIA GeForce RTX 5090 上可达 143 token/秒,在 M5 Max 上为 46.8 token/秒。在 RTX 4090 上,Ternary Bonsai 2 27B 每次 token 仅消耗 0.714 mWh,比一个以全精度运行的 8B 模型能效高 40%。
对编码助手来说,更高吞吐意味着更快的「改—调」循环。对多模态 agent 来说,意味着在截图、文档与工具调用之间更快迭代。对私有本地工作流来说,更好的能效意味着同一台设备上能跑更多有用的推理、更长的续航,以及一条更现实的路:助手可以常驻后台,而不必不停调用云端。
为什么这次发布重要
相比 Ternary Bonsai 27B,新的 Ternary Bonsai 2 27B 把相对全精度模型的能力保留率从 95% 提升到了 98% 以上。这是一个显著的改进,让当前版本在实用意义上接近「无损」。它也进一步坐实了一个判断:低位模型可以是部署 AI 的最佳方式。
其影响远不止本地推理。低位模型可以改变跨设备、工作站与数据中心的 AI 系统经济学与架构:在同样的内存范围内装下更大的模型、在同一套硬件上服务更多用户、降低每次推理的能耗,并让混合系统能够动态决定哪些跑在本地、哪些跑在云端。
问题将越来越不是「模型有多强」,而是「在给定的内存、算力与功耗预算内,能交付多少有用的智能」。如果能力能继续扩展、而这些要求又大幅下降,未来模型的部署空间就会在整个栈上展开:从个人设备到大规模数据中心。
平台覆盖
Bonsai 2 27B 通过 CUDA 在 NVIDIA GPU 上运行,也通过自定义低位 kernel、经 MLX 在 Apple 设备(Mac、iPhone、iPad)上运行。模型权重现已按 Apache 2.0 许可提供。
关于我们的压缩、评测与基准流程的全部技术细节,见我们的白皮书。