作文を書かないAIは、採点マシンである
Jevは記事を書かず、判断だけを行う。選択問題と正誤問題のセットだと考えてほしい。あなたが出題し、Jevが解答用紙を提出して確信度を示す。この記事では、Jevに何ができるのか、なぜ安いのか、そしてその確率をなぜそのまま正答率として使えないのかを説明する。
日本語
コピー
AIはとっくに文章を書ける。本当に難しいのは、それをあなたの代わりに決めさせることだ。ある会社が、文章を書かないモデルだけを作った。Jevという。この記事では、それが実際に何をしているのかを平易な言葉で説明する。
まず、何をしないのか
文章は書かない。要約もしない。翻訳もしない。Jevを使っても、整った文が返ってくることは一度もない。
手抜きではない。文章を書くという工程をまるごと外した代わりに、得たものは確かだ。速く、安く、そして与えられた問いにしか答えない。
選択問題のセットだと思えばいい
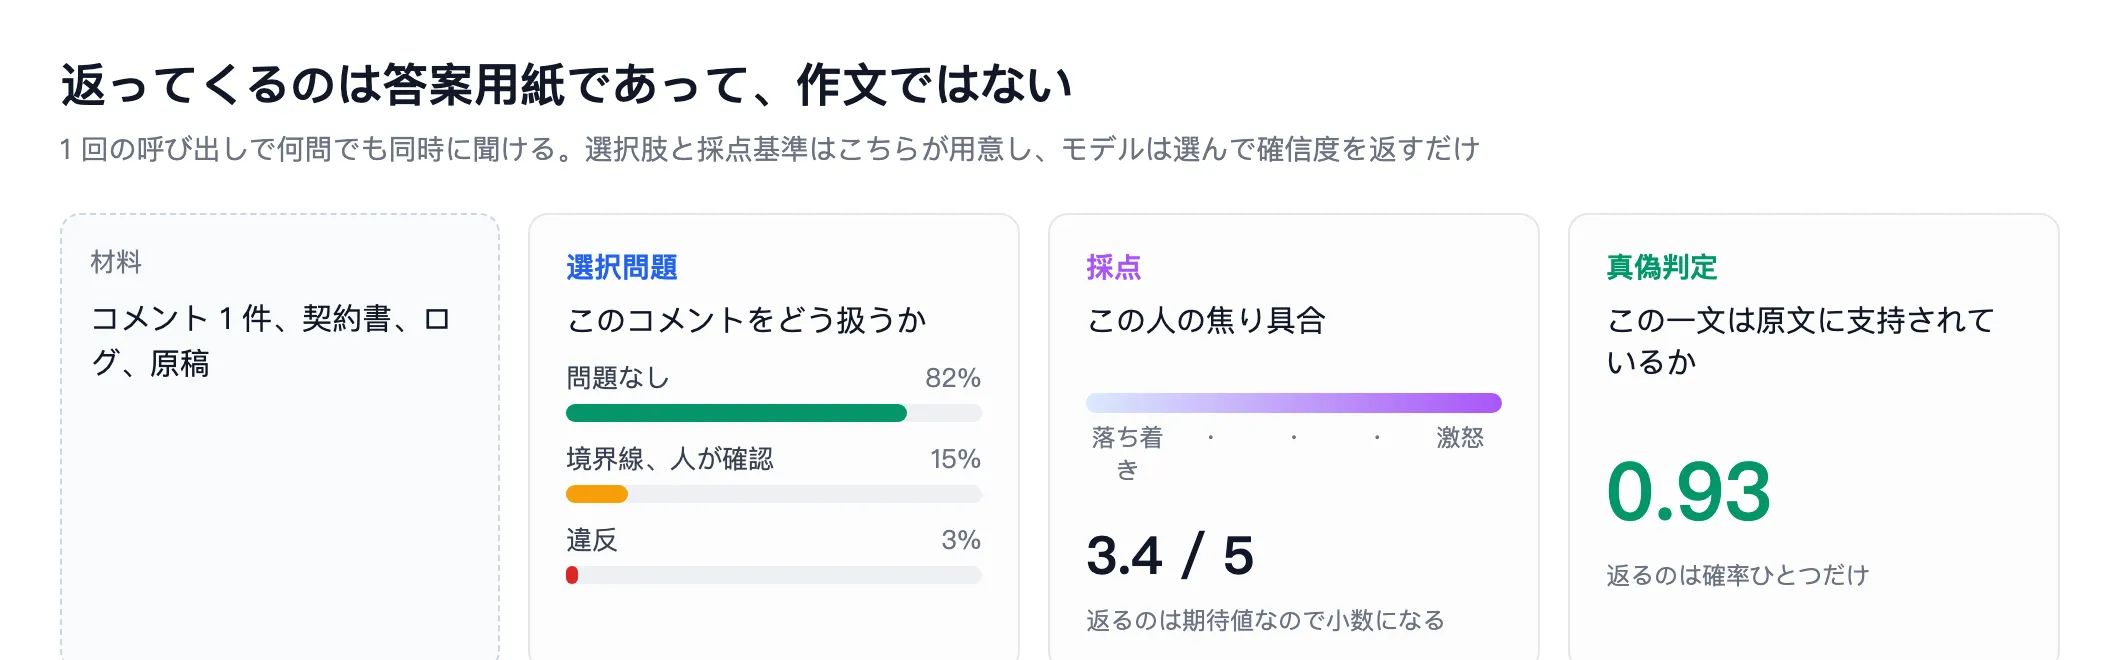
理解するには、自分が試験問題を作る側だと想像すればいい。材料をひとつ渡し、設問をいくつか渡す。返ってくるのは解答用紙一枚だ。
問題の形は三つしかない。
- 単一選択。 選択肢の中から選ばせる。たとえば「正常 / グレー / 違反」。返ってくるのは、どれを選んだかと、各選択肢の確率。選択肢はこちらが渡すので、宣言していないカテゴリを勝手に作る余地がない。ここがチャットモデルとの最大の違いだ。
- スコアリング。 「とても穏やか」から「非常に怒っている」まで、尺度を自分で定義する。返ってくるのは点数で、小数でも構わない。尺度全体の期待値を返しているからだ。
- 真偽判定。 ある陳述が成り立つかどうかを問い、0 から 1 の確率だけが返ってくる。
一度の呼び出しで何問でも同時に聞ける。問題どうしは互いに影響せず、それぞれ独立に答えるので、「出典のない断言がないか」「トーンは適切か」「どのカテゴリに入れるべきか」を一本の原稿に対して一度に問い合わせられる。順番待ちは要らない。
これが解くのは「判断」が多すぎるという問題
コンテンツ業界ではこの数年、AI の文章がうまいか下手かが議論されてきた。実際に AI を製品に組み込んだ人に聞けば、詰まるのは別のところだと答える。
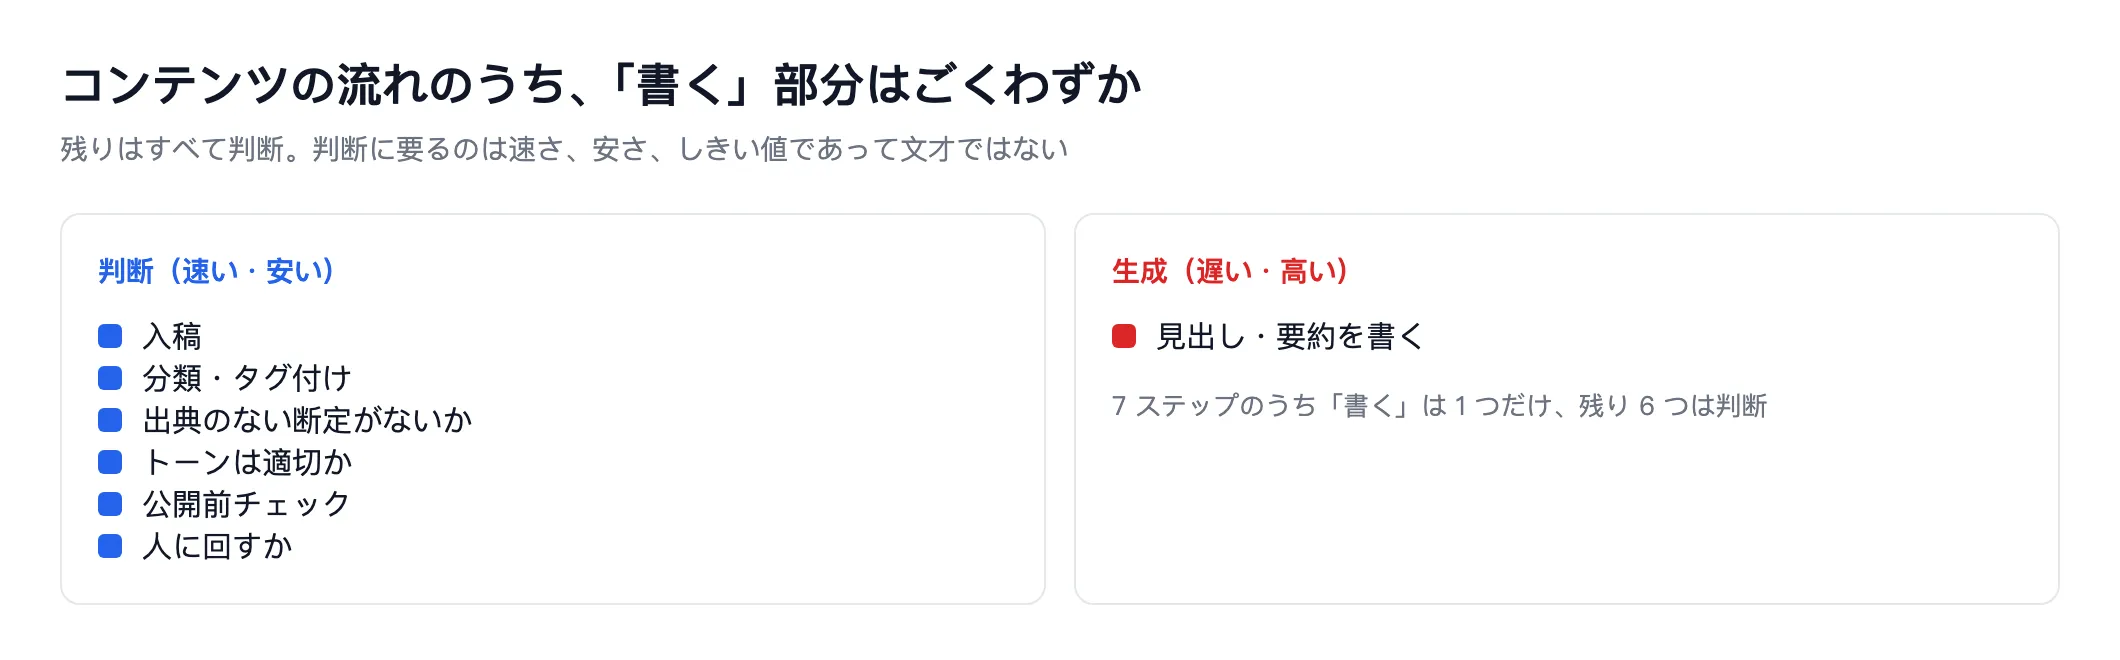
コンテンツのパイプラインで、文字を書く工程はせいぜい一、二か所しかない。タイトルを書く、要約を書く、その程度だ。残りはすべて判断である。
いくつか特に典型的な判断がある。
- コメント審査。 「正常 / グレー / 違反」の3段階に分ける。肝は「グレー」の扱いで、曖昧なものは機械に推測させるのではなく人に回す。
- 古いコンテンツへのタグ付け。 20年間タグ付けをしてこなかったサイトで、記事が数千本。1本につき単一選択が1問と真偽問題が数問あれば回せる。
- 公開前のセルフチェック。 この原稿に出典を補うべき断言はないか、トーンがずれていないか、過去の記事と重複していないか。
- agentのコマンドに危険度を付ける。 AIコーディングアシスタントが何かのコマンドを実行しようとしたとき、まず読み取り専用か、復元可能か、不可逆かを問い、閾値を下回ったら止めて人に聞く。
- モデルルーティング。 このメッセージは最も高いモデルに載せる価値があるか、それとも小型モデルや普通のコードで足りるか。
これらの仕事に共通するのは、速くて量が多いことだ。必要なのは安く、速く、そして 「自信がない」と言える判断レイヤーである。
その確率は何のためにあるのか
ここが普通のAIと最も違う点だ。
普通のチャットモデルも「信頼度」を出せるが、その数字は使いにくい。ある人が製品に組み込んで試したやり方は、閾値を1つ置き、確信度が0.9を超えたら自動実行、下回れば人に回すというものだった。結果、モデルが出す数字は情報量がないことが多かった。
自社で確定した答えのある真偽問題を一批用意し、同じモデルに、確率の出し方だけを変えて聞いたことがある。結果は毎回1.00を報告するか、その数字が何を指すのかすら一貫しないかのどちらかだった。同じプロンプトで、半分の回答は数字を判定への自信と解釈し、残りの半分は判定が成立する確率と解釈した。
だから確率を受け取ったら、まず自分で検証する。 これはこの種の数字に共通する問題で、Jevも例外ではない。TypeSafe自身の評価ページにも、モデルの出力をそのまま読んで得た確率は、与えた選択肢上で正規化された相対値にすぎず、客観的な正解率とは違うと明記されている。
実際どれくらい速くて安いのか
TypeSafeはいくつかの実ワークフローの評価を公開している。同じワークフローをJevと最も高いモデルにそれぞれ任せ、精度、1回あたりのコスト、1回あたりの所要時間を比べるやり方だ。
| 精度 | 1回あたりのコスト | 1回あたりの所要時間 | |
|---|---|---|---|
| Jev | 67.8% | 0.0004ドル | 0.4秒 |
| 最強の比較対象モデル | 73%〜74% | 0.08〜0.18ドル | 23〜38秒 |
約200倍安く、約50倍速く、精度は5〜6ポイント低い。 これは同社が出した数字で、こちらで実際に測ったわけではない。ただしワークフローも問題も評価ページで公開されているので、自分で確かめられる。
早期に試用枠を獲得した人たちの数字も一致している。ある人は1000本以上の論文要約を24トピックに分類し、8セント、1本あたり中央値256ミリ秒で終えた。別の人は9万8000件の商品分類を10分で走らせた。
ただし、自分で計算すべき勘定がある。節約できる割合は、パイプラインの中で「判断系の呼び出し」が占める割合に、その部分で節約できる割合を掛けたものになる。 1本の原稿の生成に4ドルかかり、判断に8セントしかかからないなら、判断側がさらに10倍安くなっても焼け石に水だ。まず自分の請求がどこに消えているかを見るべきである。
必ず覚えておくべき2つの落とし穴
第一に、問題は小さく分解する。 「この原稿は良いか」と聞いてはいけない。そういう問題は総合判断を要し、これは苦手だ。公式もこの種のタスクを「不向き」リストに入れている。長い推論の連鎖が必要なもの、専門領域のもの、そして文字を生成する必要があるものすべてだ。正しいやり方は3つの小問に分けること、たとえば出典のない断言はないか、トーンは合っているか、この欄に適しているか、そしてコード側で重み付けする。
第二に、同じ一批の問題同士は互いを参照できない。 それぞれが独立に答えるので、後の問題は前の問題の答えを手に入れられない。本当につなげる必要があるなら、2回目のリクエストを送る。
また、現時点では文字しか扱えない。画像や音声は別のモデルで先に文字へ変換する必要があり、その工程の時間とコストも計算に入る。
一言でいえば
生成能力はずっと前から足りている。自動化を止めているのは、自分で送り出してよいかどうかだ。Jevのようなモデルが売っているのはこの「送り出す勇気」であり、「人に見せるべきか」をコードの中で調整できる閾値に変える。
向いているのは、繰り返しが多く、量が多く、間違えても大事にならない判断だ。結果の責任を単独で負わせる場面には向かない。TypeSafeも利用の指針でこの点に触れており、金融、医療、法律といった領域では振り分けにだけ使い、最終判断は人に残すとしている。
その確率が本当に信頼できるのかについては、先月もっと厳しい実測を行い、8通りの「モデルから確率を引き出す」方法を並べて比べた。詳細はそちらにある。