不写作文的 AI,是一台判卷机
Jev 不写文章,只做判断。把它想成一套选择题加判断题,你出题,它交答题卡并标出把握。这篇讲清它能干什么、为什么便宜,以及那个概率为什么不能直接当正确率用。
中文
复制
AI 早就会写东西了。真正难的那一步,是让它替你做决定。有家公司专门做了一台不写字的模型,叫 Jev。这篇文章用大白话讲清它到底在干什么。
先说它不干什么
它不会写稿、不会总结、不会翻译。你用 Jev 的时候,拿不回任何一句成文的话。
这不是它偷懒。它把写字这件事整个去掉了,换来的东西很实在。快、便宜,而且它只会答你给的题。
把它当成一套选择题
要理解它,就想象你在出卷子。你给它一段材料,再给它几道题,它交回一张答题卡。
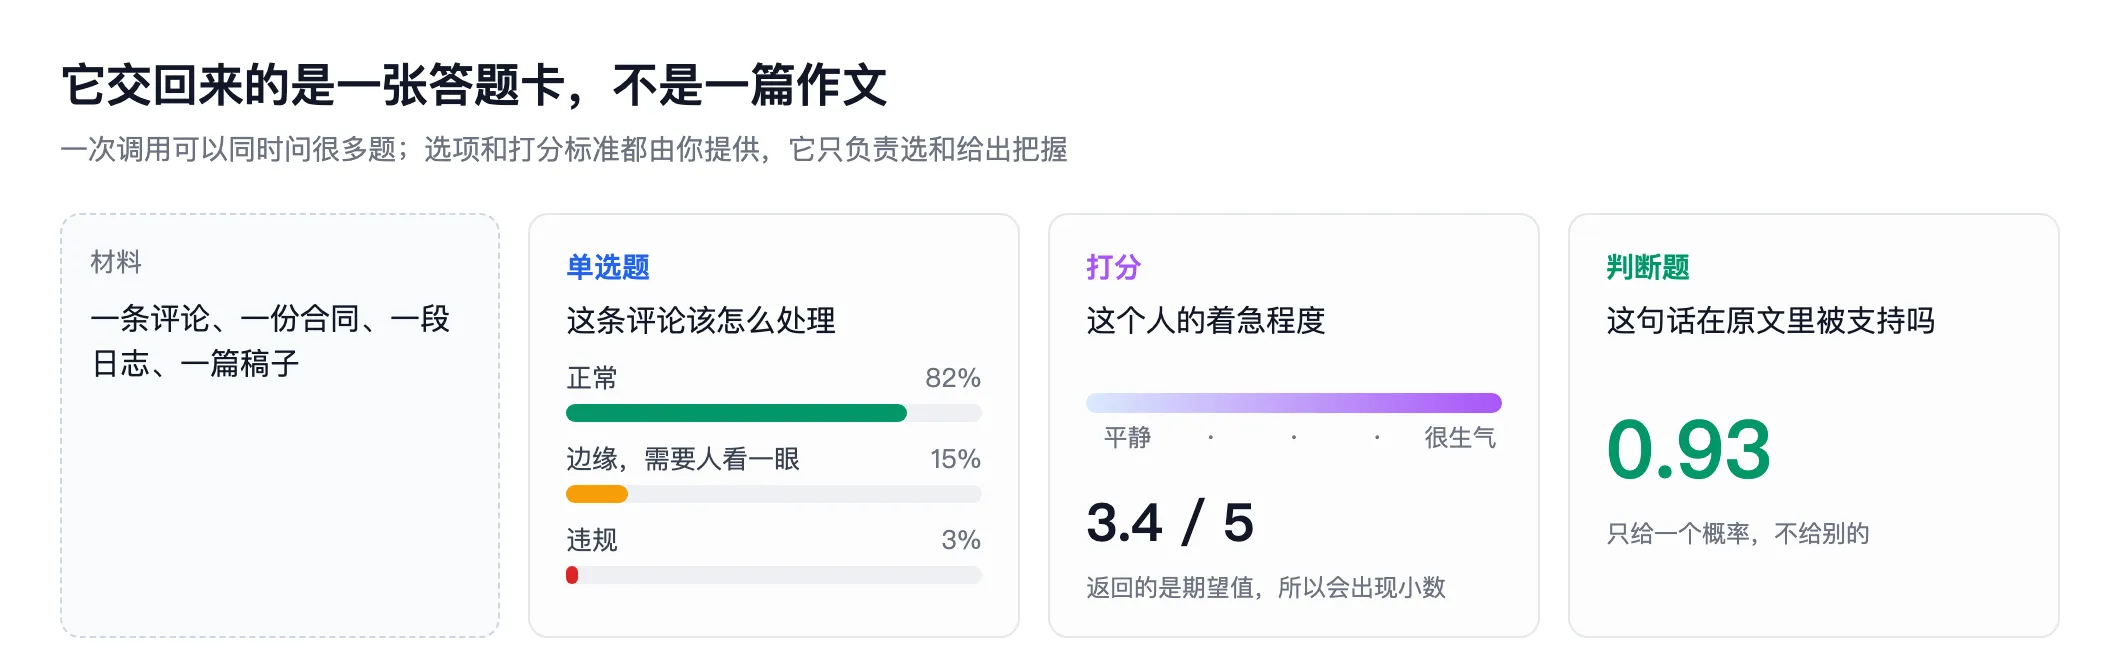
题目只有三种形状。
- 单选题。 你在选项里挑,比如「正常 / 边缘 / 违规」。它回你选了哪个,以及每个选项的概率。选项是你给的,所以它没机会发明一个你没声明过的类别。这是它和聊天模型最大的区别。
- 打分题。 你定义一个量表,比如从「很平静」到「非常生气」。它给你一个分数,可以是小数,因为它给的是整条量表上的期望值。
- 判断题。 你问一句陈述成立不成立,它只回一个 0 到 1 的概率。
一次调用可以同时问很多题。这些题之间互不影响,各答各的,所以一篇稿子可以一次问完「有没有缺少出处的断言」「语气合不合适」「该进哪个栏目」,不用排队。
它解决的问题,是「判断」太多
内容行业这几年都在讨论 AI 写得好不好。真把 AI 塞进产品的人会告诉你,卡住的地方在别处。
一条内容流水线里,需要写字的环节其实只有一两个,比如写标题、写摘要。剩下的全是判断。
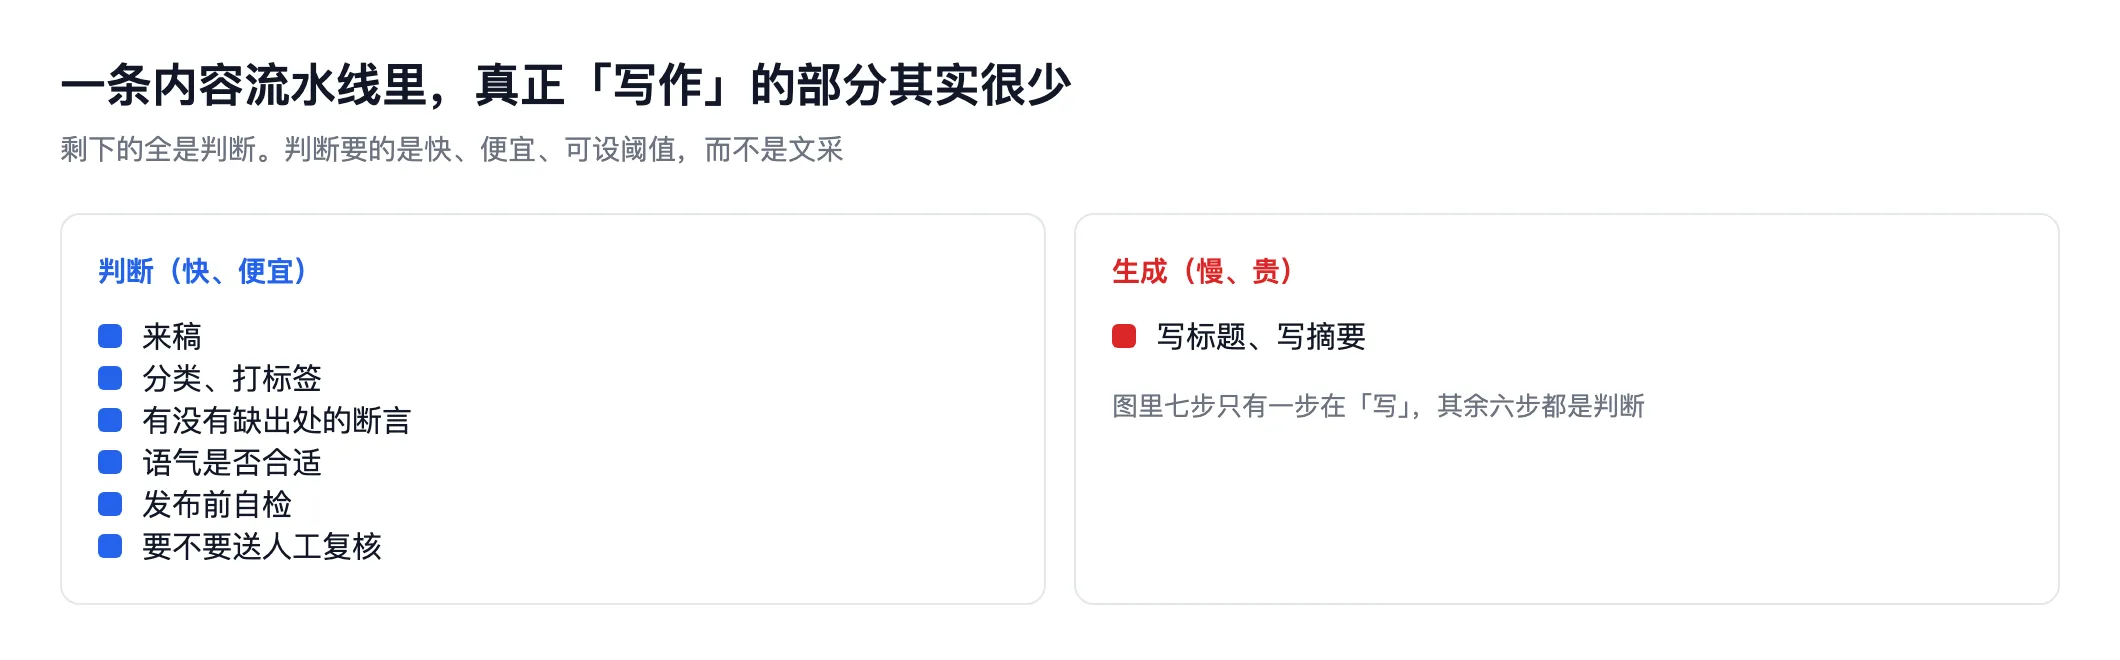
这些判断里有几个特别典型的。
- 评论审核。 分成「正常 / 边缘 / 违规」三档。最关键的是那个「边缘」档,模棱两可的东西应该交给人,而不是让机器猜。
- 给老内容打标签。 一个网站二十年没做过标签,几千篇文章,一篇一个单选择题加几个判断题就能跑完。
- 发布前自检。 这篇稿子有没有需要补出处的断言,语气是否跑偏,和旧文有没有重复。
- 给 agent 的命令判危险等级。 一个 AI 编程助手想执行某条命令,先问一句这是只读的、可恢复的、还是不可逆的,答案低于阈值就停下来问人。
- 模型路由。 这条消息值不值得上最贵的模型,还是小模型或者普通代码就够了。
这些活的共同点是又快又多。你需要的是一个便宜、快、并且敢说「我不确定」 的判断层。
那个概率是干什么用的
这是它跟普通 AI 最不一样的地方。
普通聊天模型也能给你一个「置信度」,但那个数字很难用。有人把它接进产品试过,做法是设一道阈值,把握高于 0.9 才自动执行,低于就交人工。结果发现,模型给的数字经常没有信息量。
我们自己出过一批有确定答案的判断题,问的模型是同一个,只换取概率的方式。结果要么每次都报 1.00,要么连这个数字指什么它自己都不统一。同一个提示词下,一半的回答把数字当成对判定的把握,另一半当成判定成立的概率。
所以拿到概率的第一件事,是自己验一遍。 这是这类数字的通病,Jev 也不例外。TypeSafe 自己的评测页面也写明,直接读模型输出得到的概率,只是在你给的这几个选项上归一化过的相对值,不等于客观正确率。
它到底有多快多便宜
TypeSafe 自己公布了几个真实工作流的评测,做法是同一个工作流分别交给 Jev 和最贵的模型,比较准确率、每次成本、每次耗时。
| 准确率 | 每次成本 | 每次耗时 | |
|---|---|---|---|
| Jev | 67.8% | 0.0004 美元 | 0.4 秒 |
| 最强的对照模型 | 73% 到 74% | 0.08 到 0.18 美元 | 23 到 38 秒 |
便宜约两百倍,快约五十倍,准确率低五到六个百分点。 这是它家自己给的数字,我们没有亲自测过,但他们把工作流和题目都公开在评测页上,可以自己去核。
早期拿到试用资格的人跑出来的数字也对得上。有人把一千多篇论文摘要分成二十四个主题,花了八美分,每篇中位 256 毫秒。有人跑九万八千条商品分类,十分钟跑完。
不过有一笔账要自己算。省钱的比例,等于你流水线里「判断类调用」占的份额,乘以那部分省下的比例。 如果一篇稿子的生成要花四美元、判断只花八美分,那么判断这一侧再便宜十倍也帮不上忙。先看清楚自己的账单花在哪。
两个必须记住的坑
第一,题目要拆小。 别问「这篇稿子好不好」,那种题需要综合判断,它做不好,官方也把这类任务列进了「不适合」清单,包括需要长链推理的、专业领域的、以及任何需要生成文字的。正确的做法是拆成三小题,比如有没有缺出处的断言、语气对不对、适不适合这个栏目,然后自己在代码里加权。
第二,同一批题目之间不能互相引用。 它们各答各的,后的题拿不到前的题的答案。真需要串起来,就发第二次请求。
另外它现在只吃文字。图片、音频要先由别的模型转成文字,那一步的时间和钱也要算进去。
一句话
生成能力早就够用了,卡住自动化的地方是敢不敢让它自己发。Jev 这类模型卖的就是这份「敢」,把「要不要叫人看一眼」变成代码里一个可以调的阈值。
它适合那些重复、量大、出错了也不至于出大事的判断,不适合需要它独立承担后果的场景。TypeSafe 在自己的使用建议里也写了这一点,金融、医疗、法律这类领域只拿它做分流,最终决定仍然留给人。
至于那些概率到底可不可信,我们上个月做过一次更硬的实测,把八种「从模型拿概率」的方式摆在一起比过,细节在那篇里。