あなたのエージェントは今回満点で合格したが、次回もそうなるだろうか?
IBM Researchがエージェントの「一貫性」を診断:GPT-4.1のReActエージェントはAppWorldで平均77.4%合格だが、5回すべて合格したタスクは53.0%のみで、24.4ポイントの差。彼らは1回のサンプリングで覆りやすい意思決定点を見つけ、一貫性基準を生成し、差を12.0ポイントまで削減、平均精度は落ちなかった。
もっと見る LLM
ホームIBM Researchがエージェントの「一貫性」を診断:GPT-4.1のReActエージェントはAppWorldで平均77.4%合格だが、5回すべて合格したタスクは53.0%のみで、24.4ポイントの差。彼らは1回のサンプリングで覆りやすい意思決定点を見つけ、一貫性基準を生成し、差を12.0ポイントまで削減、平均精度は落ちなかった。
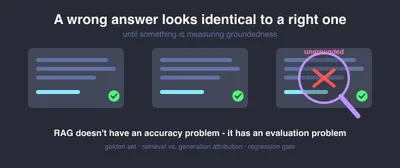
社内ポリシーボットはデモでは完璧に答えたのに、本番稼働後はすでに置き換えられた旧ポリシーに基づいて自信満々に回答し、いつ劣化が始まったかを知らせるシグナルも一切ない。この記事では、そのための回帰ゲートの作り方を解説する。
かつて素人スクレイパーを阻んでいた技術的障壁は、たまたま大規模言語モデルが最も得意とする種類のタスクにそれぞれ対応している。長年防御に携わってきた人物がそれらを一つずつ分解し、どの壁がどこで崩れたのか、そして防御がなぜ形骸化している可能性があるのかを説明する。
自己完結型のHTML成果物はモデルによって生成され、顧客データプラットフォーム上でホストされるため、プラットフォームは作者を信頼できないものと見なさなければならない。なぜなら、プロンプトインジェクションによって生成ページのスクリプトが閲覧者のブラウザで実行される可能性があるからである。
674行のSQLパターンライブラリにより、Claudeは3100万行のDuckDB上で4.6万回のクエリを平均2〜3秒で返す。
エラーを記録することとエラーから学ぶことは別物だ。6つのagent memoryシステムのうち4つは否定的な判定を含むフィードバック入力を公開しているが、Mnemoverse自身が公表した測定ではこのシグナルはほとんど呼び出されていない。
モデルは何も自分で実行せず、構造化されたツール呼び出しリクエストを返すだけです。あなたのコードが実際の関数を実行し、その結果をモデルに返して回答させます。この記事では、この4ステップのループをゼロから分解して解説します。
GPT-6 Astraの公開後、著者は「モデルがどれだけ強いか」から、より見落とされがちな問題へと目を向けた。モデルが強くなっていることを、私たちは一体どうやって知るのか。ベンチマークは飽和し、代理指標が使われ、真値の出所は複雑で、採点方法も変わる。記事はスコアを見るときに問うべき5つの問いを提示する。
AI にブログ記事、リサーチレポート、メモのような実質的な内容のテキストを書かせるのは、十分な要点と文脈を与え、後から自分で編集したとしても、ほぼ決してすべきではないと著者は主張する。書くこと自体が思考であり、AI の文章は気づきにくいところで曖昧に誤り、明示しなければ失礼かつ人を誤導するからだ。
Dan Luu は 2025 年初から、LLM を使うときに頭を切る人々を見てきた。結論は明快だ。LLM が「頭を切っても」平均的なソフトを作れるほど強くなったら、会社は LLM をループで走らせてその人を解雇すればいい。
「モデル × 推論設定」19 構成の総当たり戦。Codex Astra が全勝で首位、Grok 系は 43 分でコマンド 6 バッチのみ・戦闘ユニットゼロ、Claude Fable だけが経済とテックを真面目に回した。著者の結論は、初心者レベルを超えた agent は皆無。
Bend 2 のデモは「法則」の宣言に 58 行、証明に 442 行。著者は同じプログラムを形式検証の SPARK で作り直し、不変条件を示すだけで GNATprove が 12 項目すべてを検証したと指摘する。
Gowers は「危機に直面している」ことに同意しつつ、「概念的理解が問題解決より上位」という唯一の正解には与しない。数学者の動機をスペクトラムとして捉え、モデルが人間を全面的に超える未来と、公開が国際的に制限される未来を比較する。
著者は毎日の 7 割以上を AI 対応に費やし、仕事の楽しみを失ったと書く。規制を求める一方で拡大を続ける AI 企業、脆弱性の発見に資源を投じるセキュリティ業界、「ループに入った人間」のゴム印化を批判する。
Qwen3.8 27B をベースに三値重みで 5.9GB(重みあたり 1.76 実効ビット)まで圧縮し、総合ベンチマークの 98.2% を保持。RTX 5090 で 143 トークン/秒、Apache 2.0 で公開。
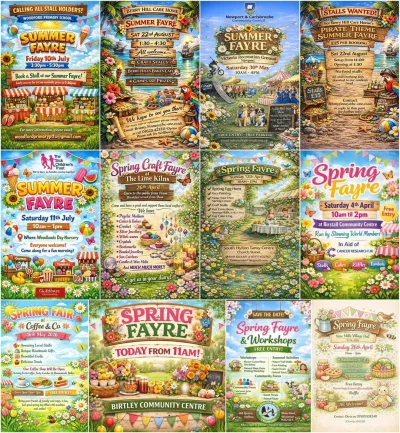
著者は同じ架空のイベント情報で ChatGPT に何度もスタイルを変えさせ、バウハウスからリソグラフ、パンク・ファンジン、日本風ミニマルまで作らせて、AI ポスターの画一性は能力ではなく指示の問題だと示した。
LLMが記事をベルビータチーズに変えないための2つのルール:提案された言い回しは使わず、初稿への褒め言葉も信じない。
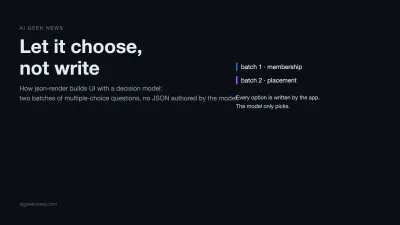
大規模モデルにUIのJSONを直接書かせると、存在しないコンポーネントをでっち上げたり、勝手に文言を作ったり、壊れたとしても結果が返ってくるまで分からない。json-renderは発想を変え、UI構築を2つの有限な選択肢に分解し、モデルは選ぶだけ、コードが組み立てる。
2026年のローカルAIモデル6選:データをデバイス外に出さずに実行でき、プライバシーとオフライン能力を両立。
TypeSafeはAIの意思決定をコードの制御フローに組み込み、リアルタイム適用の遅延はわずか150ms、ビッグデータ処理コストを100分の1に削減。
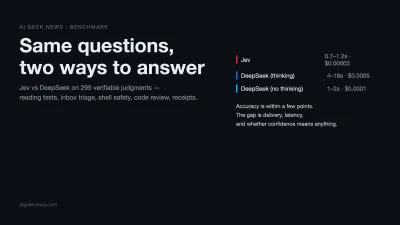
10の実シナリオ、確定的な答えを持つ66問、さらに229の検証問題、3つの比較アーム。精度差はわずか数ポイント、時間差は10倍、そして確率の使い方はまったく異なる。
AI SREとコーディングアシスタントのマーケティングフレームは分化:前者はSREを置き換えるものとして位置づけられ、後者はエンジニアの増強ツールとして包装されている。
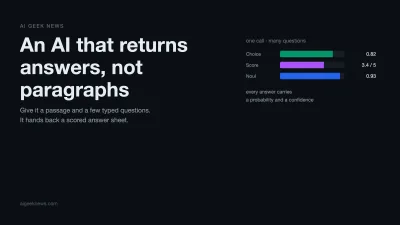
Jevは記事を書かず、判断だけを行う。選択問題と正誤問題のセットだと考えてほしい。あなたが出題し、Jevが解答用紙を提出して確信度を示す。この記事では、Jevに何ができるのか、なぜ安いのか、そしてその確率をなぜそのまま正答率として使えないのかを説明する。
Adam Langley が Lean で Zstandard の解凍器を書き、型レベルの不変条件を型シグネチャとして書き下し、 証明本体を LLM に埋めさせた記録。