スマホでオフライン動作するローカルモデル6選:パラメータ数、サイズ、それぞれの得意分野
2026年のローカルAIモデル6選:データをデバイス外に出さずに実行でき、プライバシーとオフライン能力を両立。
日本語
コピー
AITop 6 ローカルAIモデル:プライバシー最大化とオフライン対応(2026)

Piotr Zborowski
Mateusz Słuszniak2026年9月8日•10分で読める AI
2026年に注目すべきローカルAIモデル6選:プライバシー最大化とオフライン対応
Piotr Zborowski
Mateusz Słuszniak2026年9月8日•10分で読める この記事の内容 AIはとうの昔に、私たちのデバイス上のあらゆるアプリの中核になった。次に見る動画を勧め、誤字を直し、画像を生成し、あるいは質問に答えてくれる。だが、この滑らかな体験には代償がある。AIサービスに依存すれば、必ずコストがかかる。AIシステムとやり取りするたびに、私たちはたいていデータ(プライバシー情報を含む)をリモートサーバーへ送り、応答を待ち、途中で何も起きないことを祈っている。ここからは、AIがあなたのデバイス上で動く新しい時代だ。読み進めれば、ローカルAIを使う利点、試す価値のあるモデル、そして自分のモバイルアプリにローカルAIモデルを組み込む方法が分かる。
最も普及しているAIモデルはどう動くのか
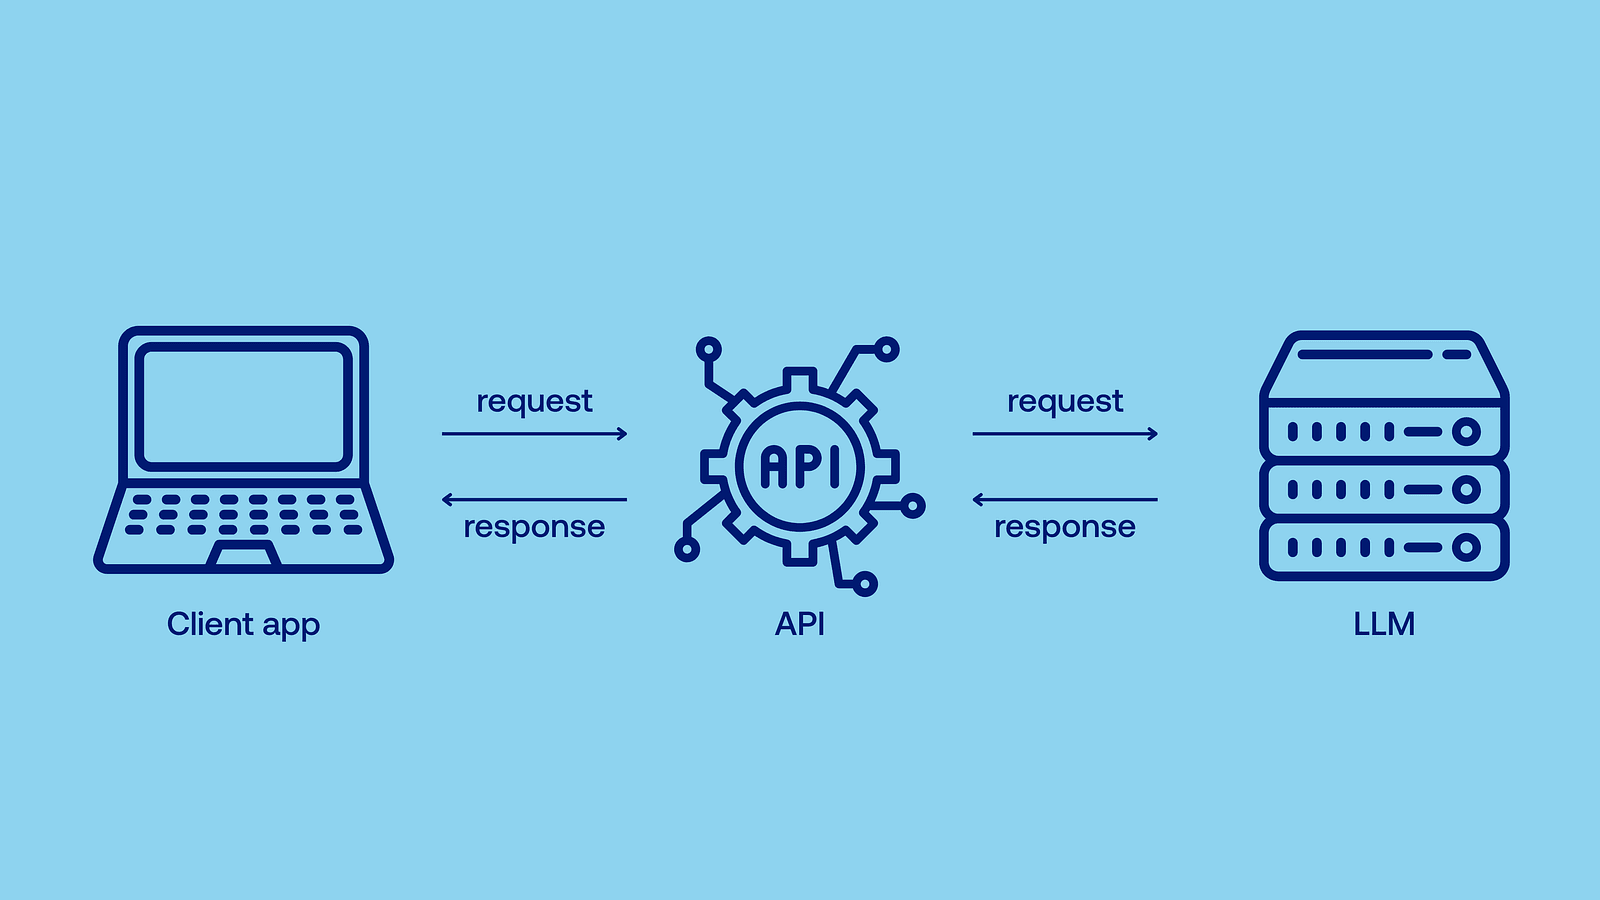
最先端のAIモデルを動かすには膨大な計算資源が要る。何しろパラメータ数は1兆を超えることもある(1の後に0が12個続く数字だ)。ほとんどの人は自分のデバイスでこれをこなせない。だからGPT-4.1のようなモデルはクラウドモデルとして動く。計算はすべてローカルで行われるのではなく、 ブラウザからサービス提供元へリクエスト(API呼び出し)を送り、モデルは彼らの強力なサーバー上で実行され、計算結果が返ってくる。重い計算を自分で担う必要はない。待つだけだ。
ローカルAIモデルの利点
ローカルAIとは、あなたのデバイス上で直接動くAIモデルを指す。 リモートAPIに依存せず、データが生成されたその場で即座に応答する。先ほど触れたように、最も普及しているモデルは一般ユーザーのデバイスには重すぎる。だからローカルで動かすのはより小さなモデルで、通常は数十億パラメータ程度だ。大手企業のフラッグシップモデルも同様にオープンソースではない。OpenAIのGPT-4.1やAnthropicのClaude Opus 4がそうだ。 ガレージにスーパーコンピュータを置いたところで、ローカルで動かすことはできない。オンラインでより大きなモデルが使えるなら、なぜわざわざ小さなモデルを自分で動かすのか。理由は少なくともいくつかある。
プライバシーが強い
ローカルAIなら、データはデバイスから一切出ていかない。サービス提供元がそれをモデルの学習や広告に使うことはなく、セキュリティ侵害が起きても外に漏れない(企業の機密データを扱うときは特に役立つ)。クラウドもなければ、仲介者もいない。
拡張性が高い
クラウドAIは需要の増大に直面すると、規模が大きくなるにつれて処理遅延や呼び出しコストの上昇が起きうる。拡張はセキュリティリスクも膨らませる。機密情報を守りながら手軽に拡張するなら、ローカルAIしかない。開発者はクラウドインフラの利用量増加に対応するためにアーキテクチャを調整する時間を費やさずに済む。
コストが低い
普及しているモデルはプロプライエタリで、token(語句を構成するテキストの最小単位。質問も回答も数える)単位か月単位の課金だ。オープンソースモデルをローカルで動かせば、電気代がほぼすべての出費になる。サブスクリプションは不要だ。
遅延が極めて小さい
オンラインAPIを使う場合、まずデータを送り出し、処理が終わるのを待ってから受け取る。どの段階にも時間がかかる。ローカルAIは応答が生成されたその瞬間に届く。
オフラインで使える
ネットがなくても問題ない。ローカルAIは飛行機の中でも、遠隔地でも、ネットワークが不安定な場所やまったくない場所でも動く。どれだけ多くの場面をカバーできるか想像してみてほしい。
安定性は比類ない
世界中で何人のユーザーがモデルを使っていようと、あなたのネット接続がどれほど良かろうと、ローカルAIの挙動は常に変わらない。あるモデルを動かすのに十分な性能のデバイスが1台あればいい。
カスタマイズ性が高い
オープンソースのローカルモデルは、自分のデータで再学習やファインチューニングができる(この手法を検索拡張生成、つまりRAGと呼び、React Native RAGを使えば簡単に構築できる)。つまり、社内のナレッジベースを使ってAIモデルの回答をより正確にできる。モデルのデプロイと更新も完全に自分の管理下に置ける。
モバイルAI
ローカルAIはあらゆるエッジデバイスをカバーするが、真のチャンスは低消費電力のモバイルデバイス(スマートフォン、タブレット、組み込みシステム、ウェアラブル)にある。 こうしたデバイスは、ネットワークの届かない場所に持ち出される可能性が最も高く、リアルタイムの音声翻訳や視覚タスクのようにレイテンシの要件が厳しい用途、あるいはプライバシーが気になる用途に向いている。Software Mansionでは、クライアント案件でも社内案件でも、ローカルAIの可能性をしばらく前から検証してきた。さまざまなシナリオで特に使い勝手が良かった6つのローカルAIモデルを紹介する。
トップ6のローカルAIモデル
Gemma 4 E2B
Gemma 4はGoogleが新たに公開したオープンモデルで、E2Bはモバイル向けに作られたバージョンだ。「E」はeffective(有効)を意味する。ディスク上は51億パラメータを抱えるが、巧妙な埋め込みの工夫により、実際に計算に使われるのは約23億だけ。だからこそ、通常ならこの規模のモデルを載せられないハードウェアでも動く。マルチモーダルでもあり、テキストを読み、画像を見て、音声を聞く。すべてオフラインで完結し、140以上の言語に対応する。
- パラメータ数:5.1 B(有効2.3 B)
- サイズ:10.2 GB(BF16)/ 2.6 GB(int4)
Qwen 3.5-2B
昨年紹介したQwen 3 1.7Bの直系の後継モデルで、中国の大手Alibabaのものだ。ユーザーが英語を話さないなら、依然として第一候補になる。Qwen3.5シリーズは200以上の言語と方言をカバーしているからだ。テキストだけでなく画像も扱える。ハイエンドのスマートフォンだけを対象にするなら、4B版を選べばいい。
- パラメータ:2 B
- サイズ:4 GB(BF16)/ 1.1 GB(int4)
Mistral 3 3B
昨年はフランスのスタートアップMistral AIのMistral 7Bを紹介しつつ、実質ノートPC向けのモデルだと率直に注意を促した。Ministral 3はその問題を解決している。3B版はスマートフォンに難なく収まり、Apache 2.0ライセンスで、画像も理解できる。とりわけ得意なのは面倒な作業だ。ドキュメントから構造化データを抽出したり、アプリが実際にパースできるクリーンなJSONを返したりする。
- パラメータ:3 B
- サイズ:6 GB(BF16)/ 2 GB(int4)
LFM2.5-1.2B
このリストの他のモデルは、まず大きなモデルがあり、それが縮小されたものだ。Liquid AIは逆を行く。LFM2は最初からスマートフォンの制約を前提に設計され、その結果は覆しがたい。最小のバージョンはGalaxy S25 Ultraで毎秒200トークン以上を生成し、iPhone 13 Miniのような古いデバイスでも余裕で動く。高速で信頼性の高いツール呼び出しに対応する。
- パラメータ:1.2 B
- サイズ:2.4 GB(BF16)/ 0.7 GB(int4)
Moonshine v2
この記事はテキストを読み書きするモデルだけの話ではない。音声認識の推薦枠はMoonshine AIのMoonshine v2が取った。実際に存在する音声だけを処理するため、スマートフォン上でリアルタイム字幕に追従できる。サイズは3種類あり、英語の重みはMITライセンス。その他の言語には別のコミュニティライセンスが適用されるので、リリース前に確認しておこう。
- パラメータ:34 M / 123 M / 245 M
- サイズ:68 MB / 246 MB / 490 MB(BF16)、37 MB / 135 MB / 270 MB(int8)
Harrier-oss-v1-0.6b
最後の枠は、一切文字を書かないモデルに譲る。MicrosoftのHarrierのような埋め込みモデルはテキストをベクトルに変換し、アプリはキーワードではなく意味で検索できるようになる。これはオンデバイスRAGに欠けていたもう半分だ。上記のどれかのモデルを自分のドキュメントや社内wiki、長年のノートに向けておけば、データはスマートフォンから出ていかない。HarrierはMITライセンスで、検索タスクにおいて7Bパラメータ以下のオープンソース埋め込みモデルをすべて上回る。React Native RAGと組み合わせて使おう。
- パラメータ:0.6 B
- サイズ:1.19 GB(BF16)/ 0.63 GB(int8)
スマホでローカル AI モデルを試す
理屈はもう十分。ここからは実際に動かしてみよう。こうしたローカル AI モデルを実環境で試せるようにと、私たちは Private Mind というアプリを作った。オフラインで動く AI チャットアプリだ。すべては手元のデバイス上で完結し、モデルは好きなだけ使えて、すでにあるハードウェア以外に費用はかからない。App Store と Google Play の両方で配信中だ。
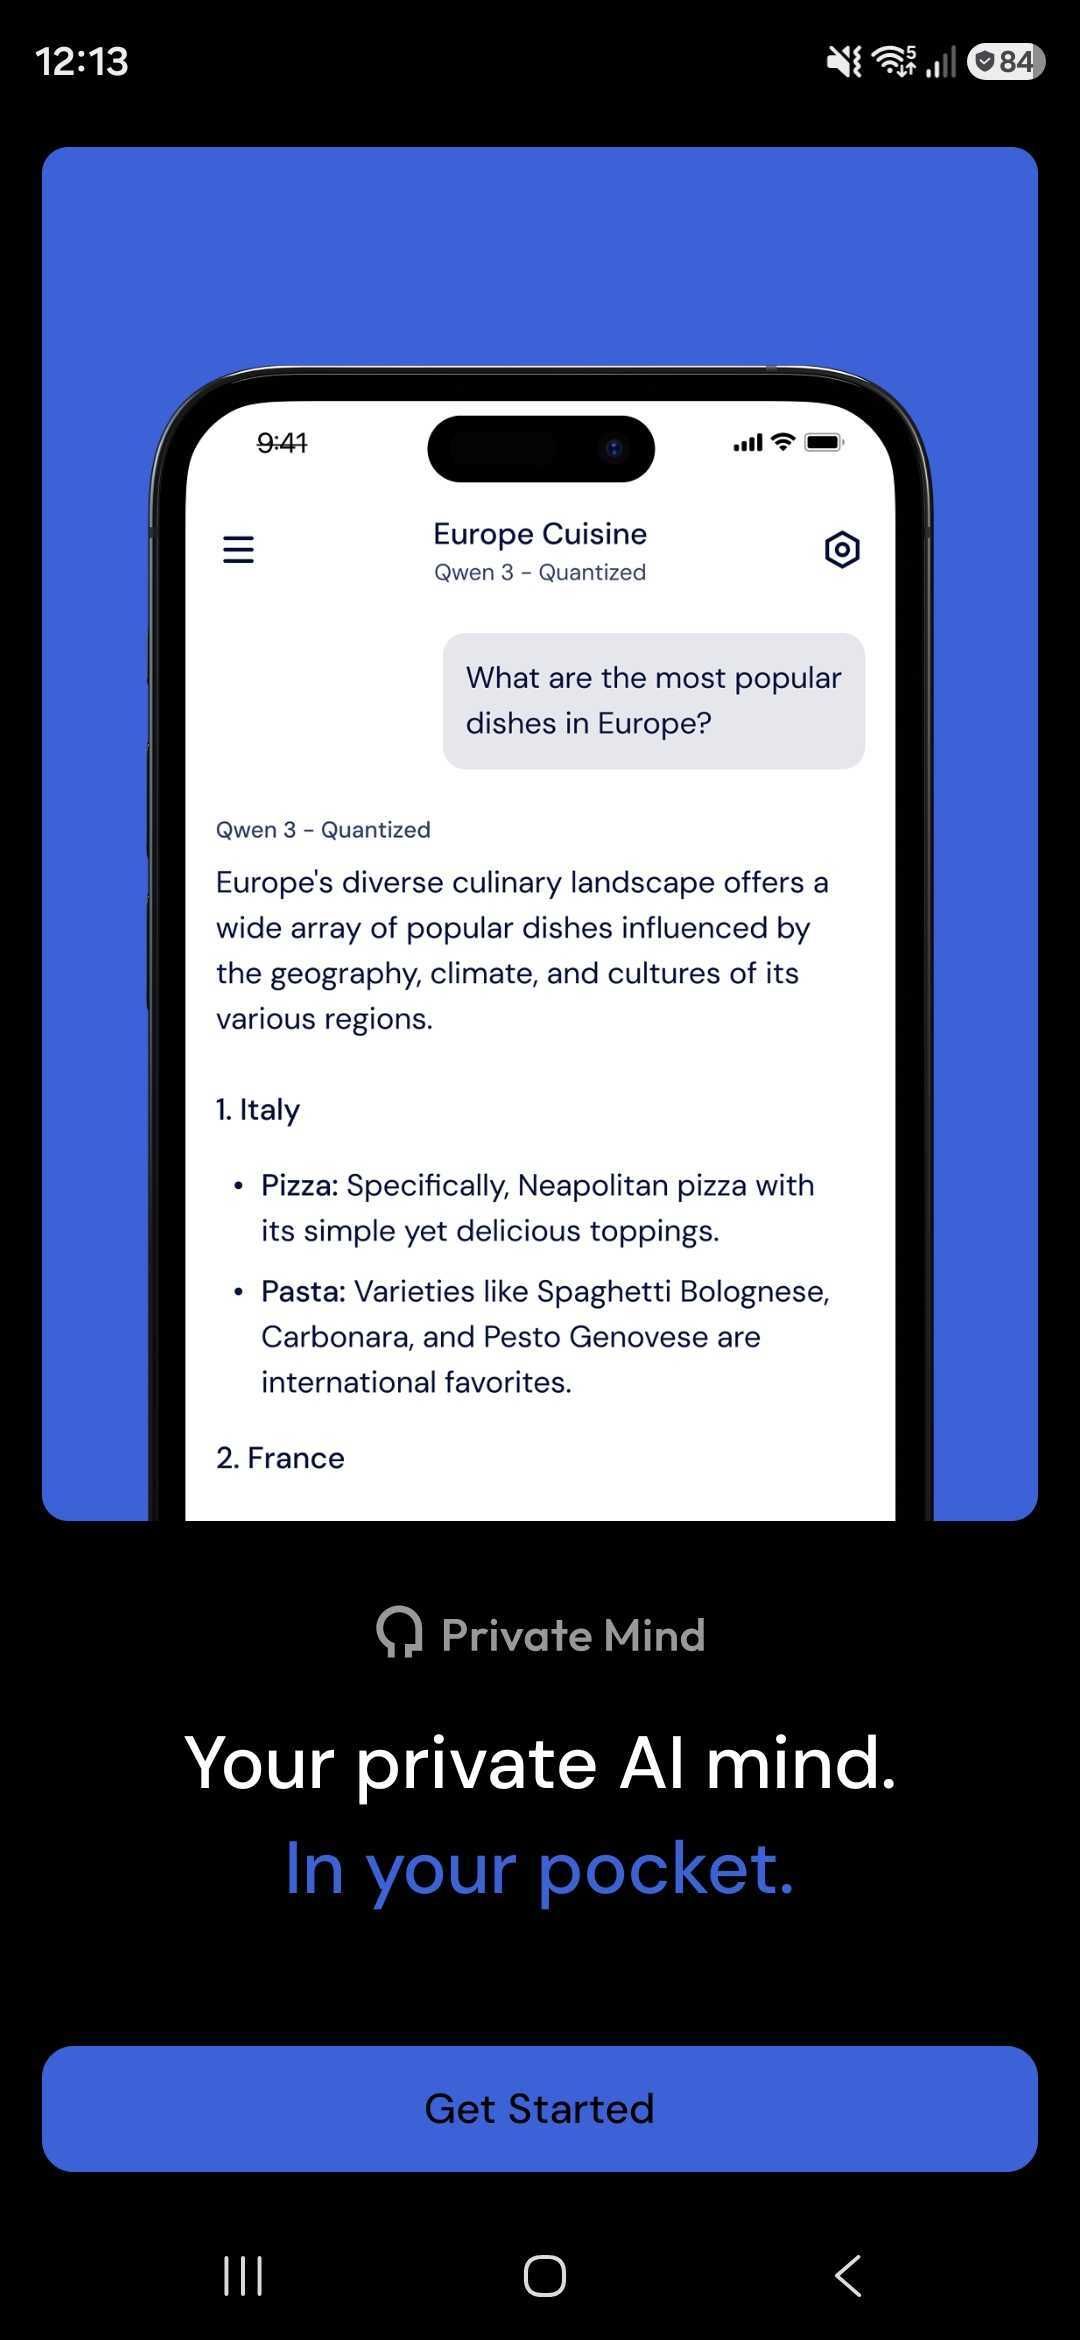
中身をざっと見る
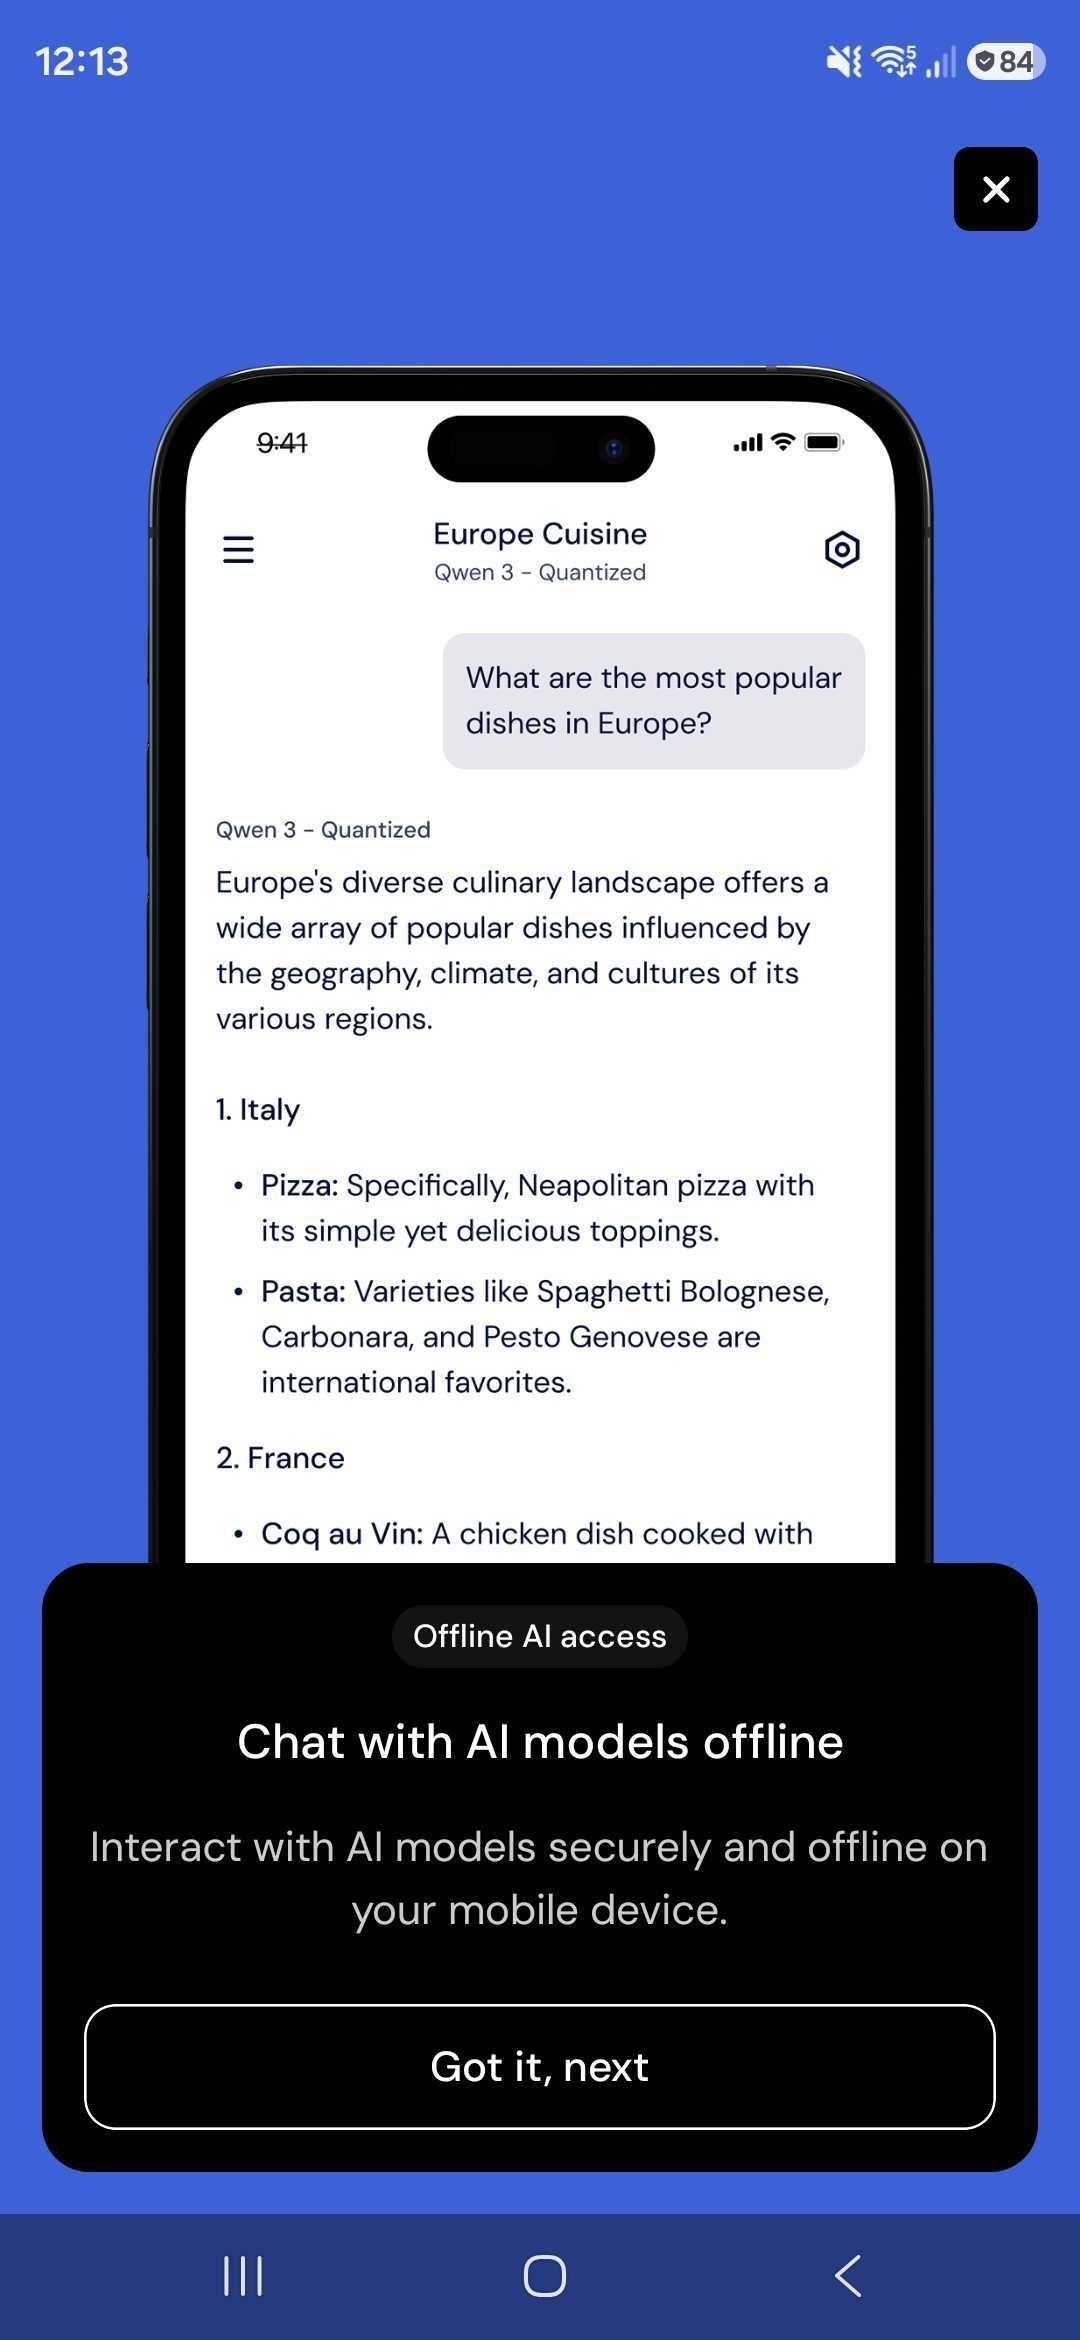
アプリを初めて開くと、Private Mind で何ができるかを紹介する短いガイドが流れる。モデルをデバイスにインストールしてしまえば、アプリがネットワークに接続することはもうない。飛行機の中でもチャットの体験はまったく同じだ。そもそも処理の流れのどこにもサーバーが存在しないからだ。
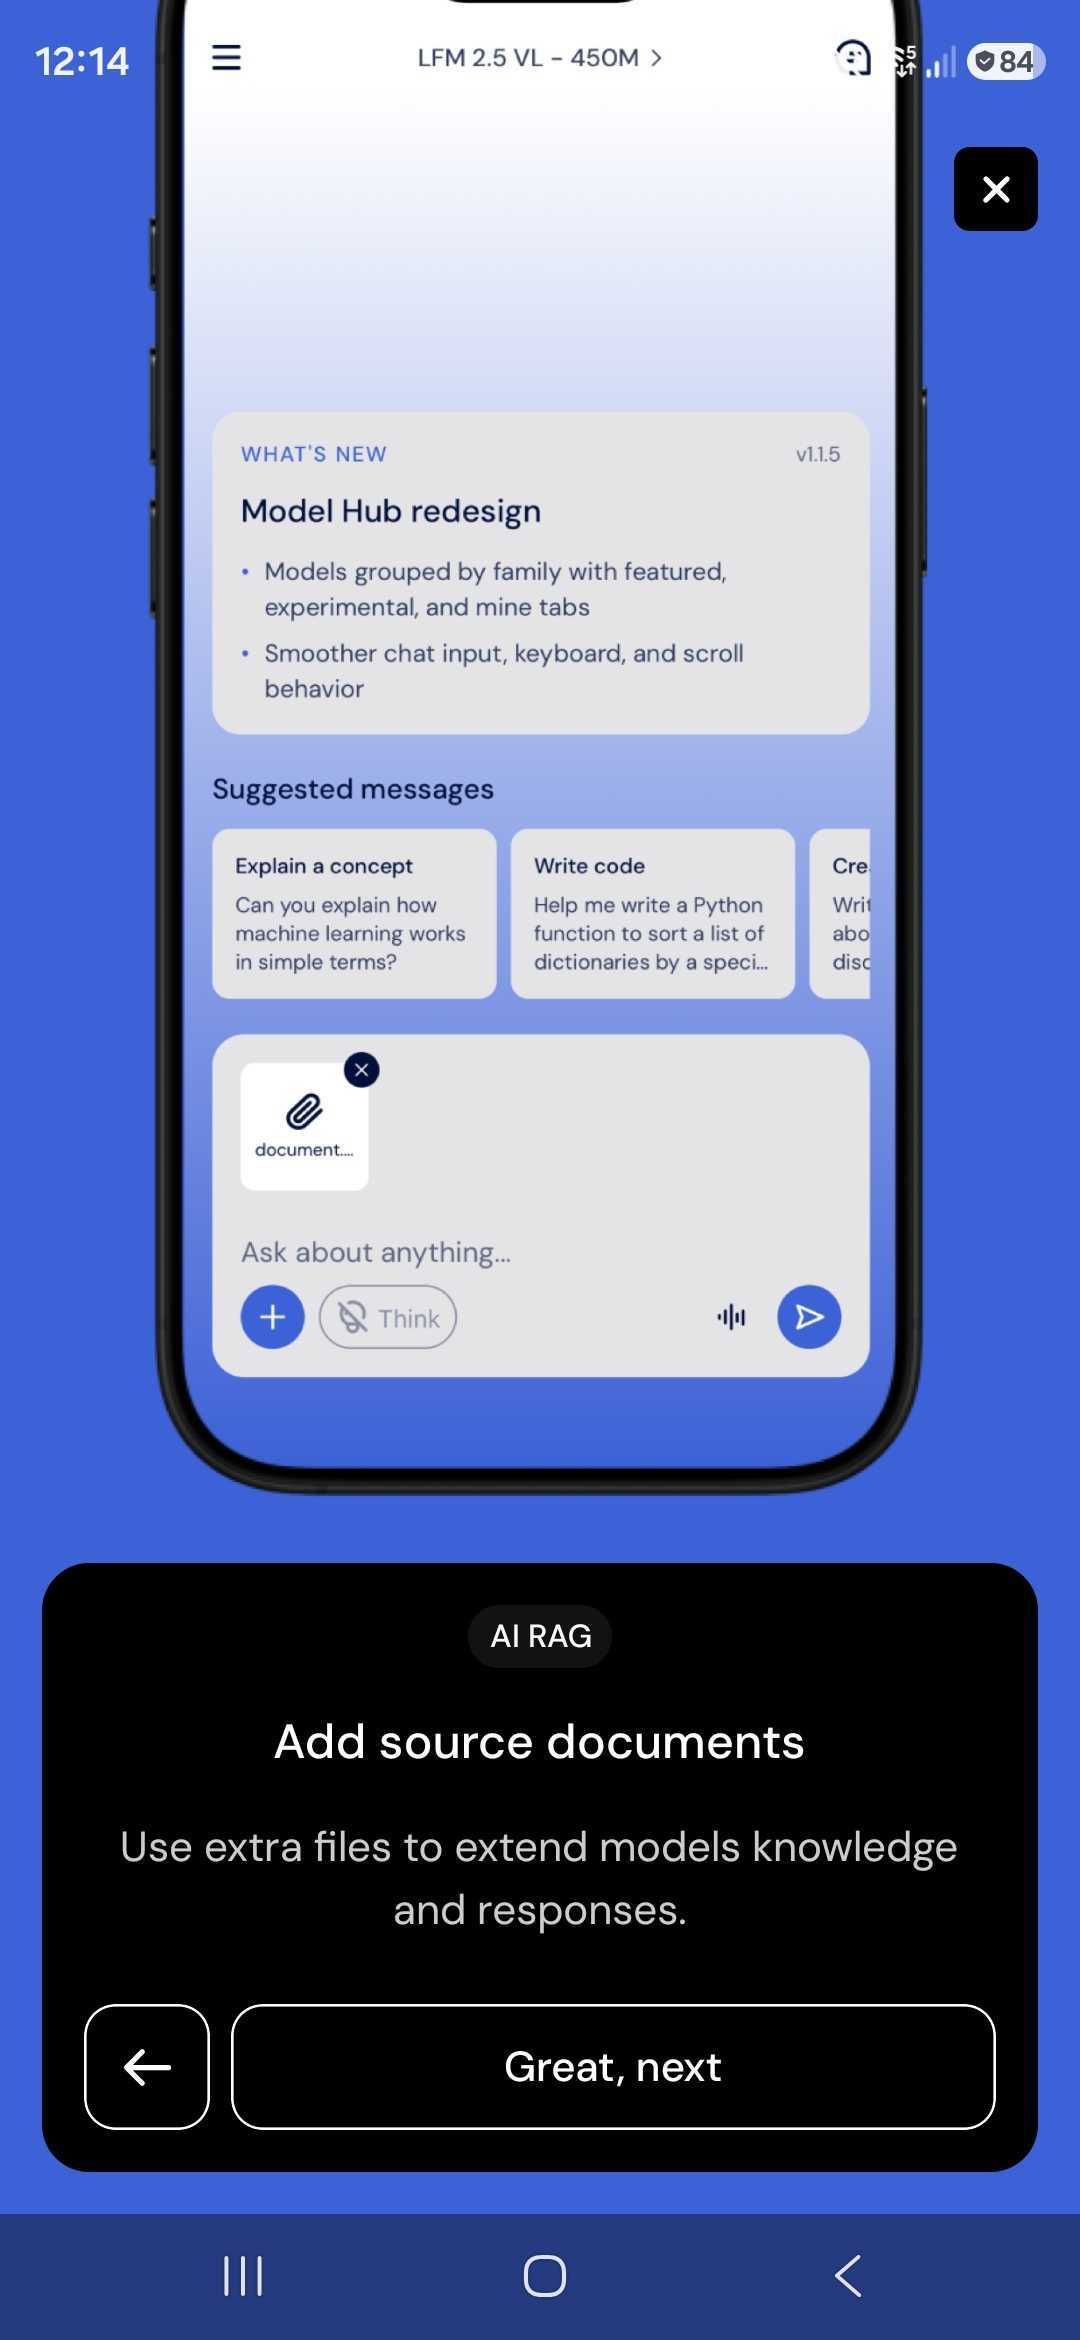
会話にファイルを添付すると、モデルはそれを踏まえて答え、元の段落を指す引用を返す。スマホ上でエンドツーエンドに動く検索拡張生成だ。同じ仕組みは React Native RAG を使って自分のアプリに組み込むこともできる。
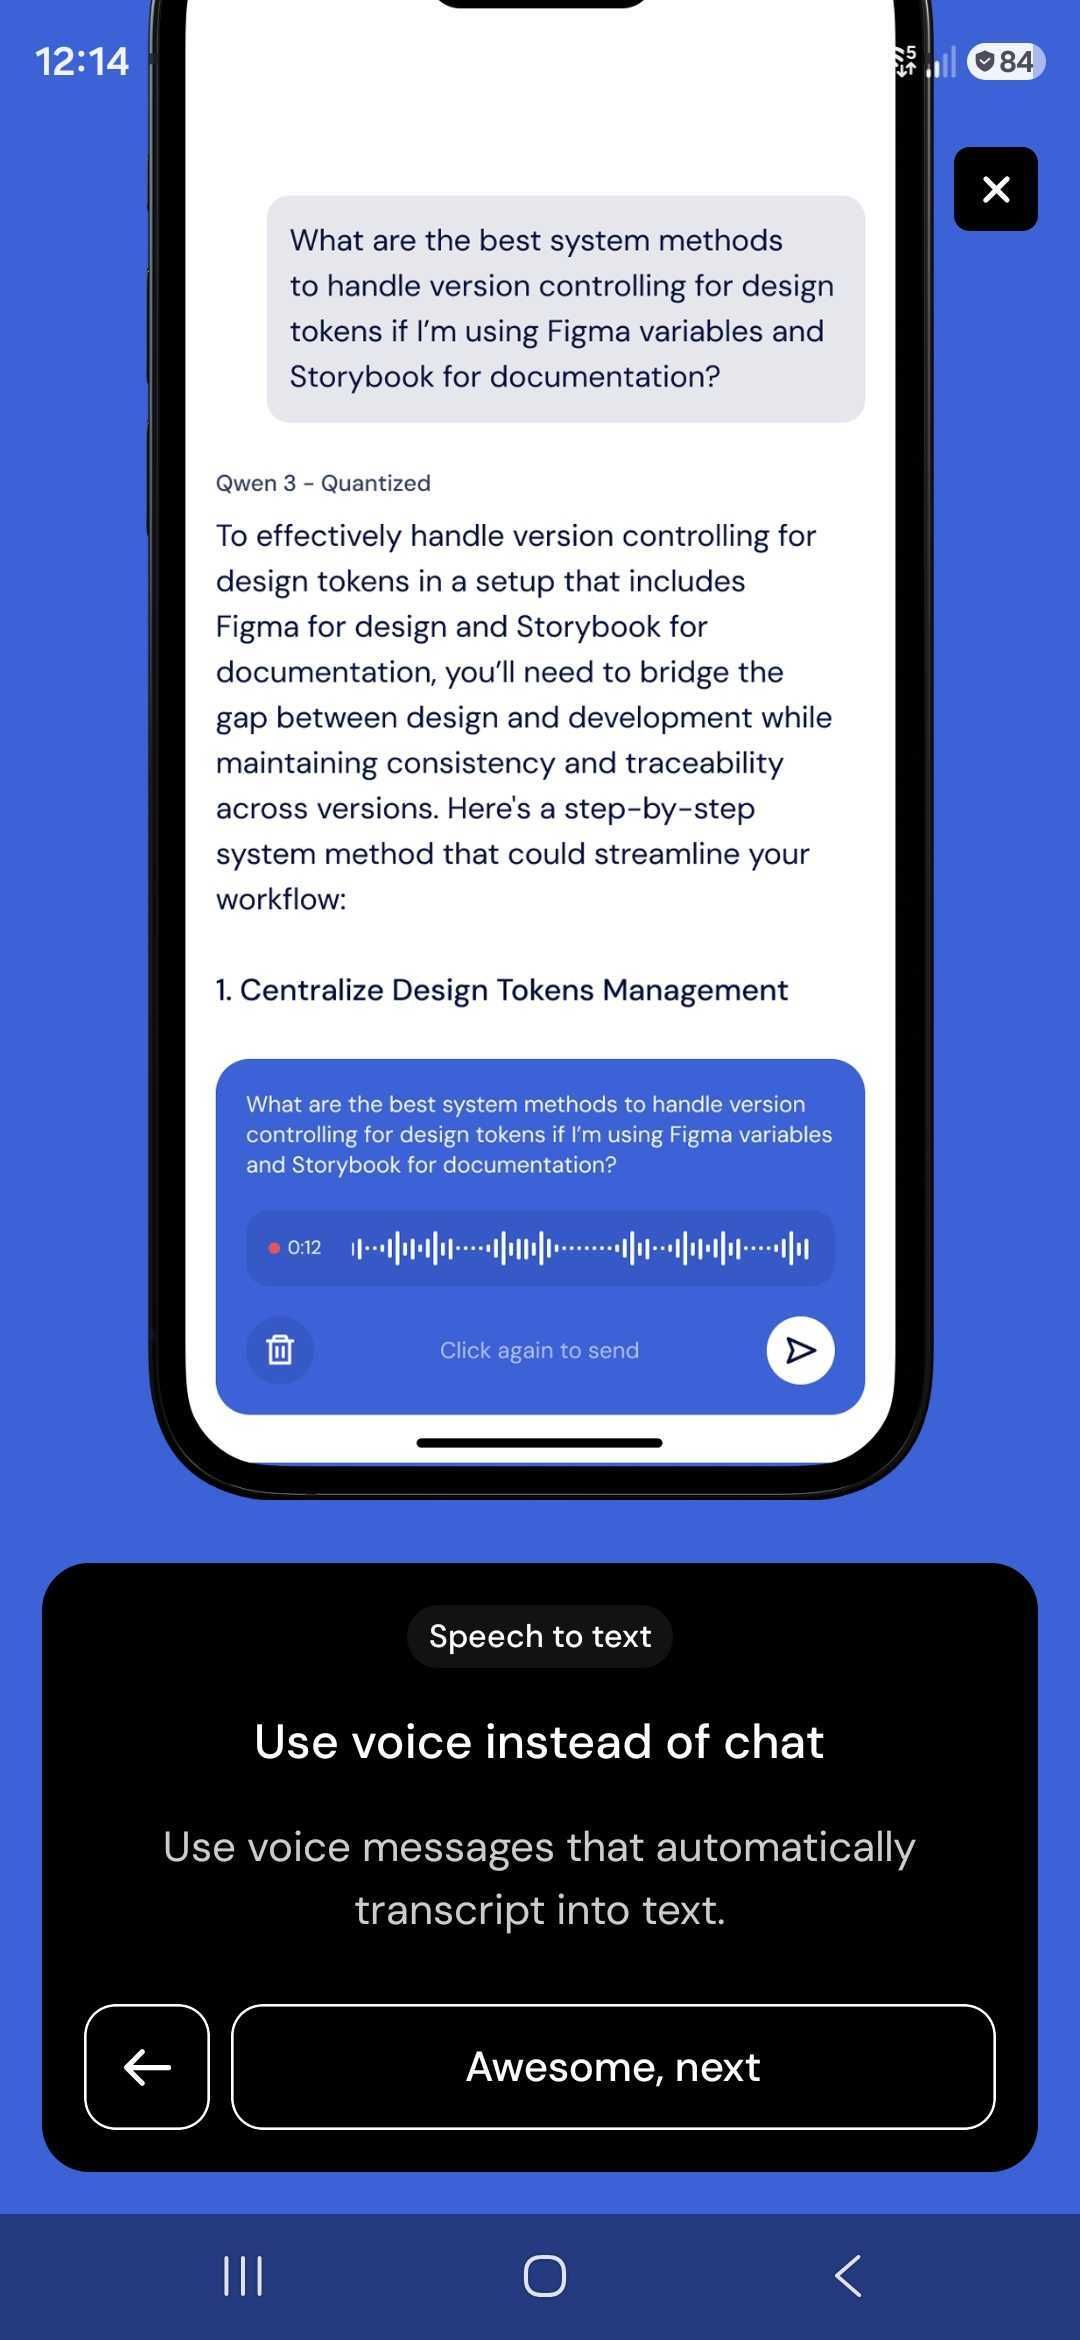
スマホのキーボードで長いプロンプトを打つのは苦痛なので、音声を録音して文字起こしできるようにした。音声はローカルで処理され、外部の文字起こしサービスには送られない。
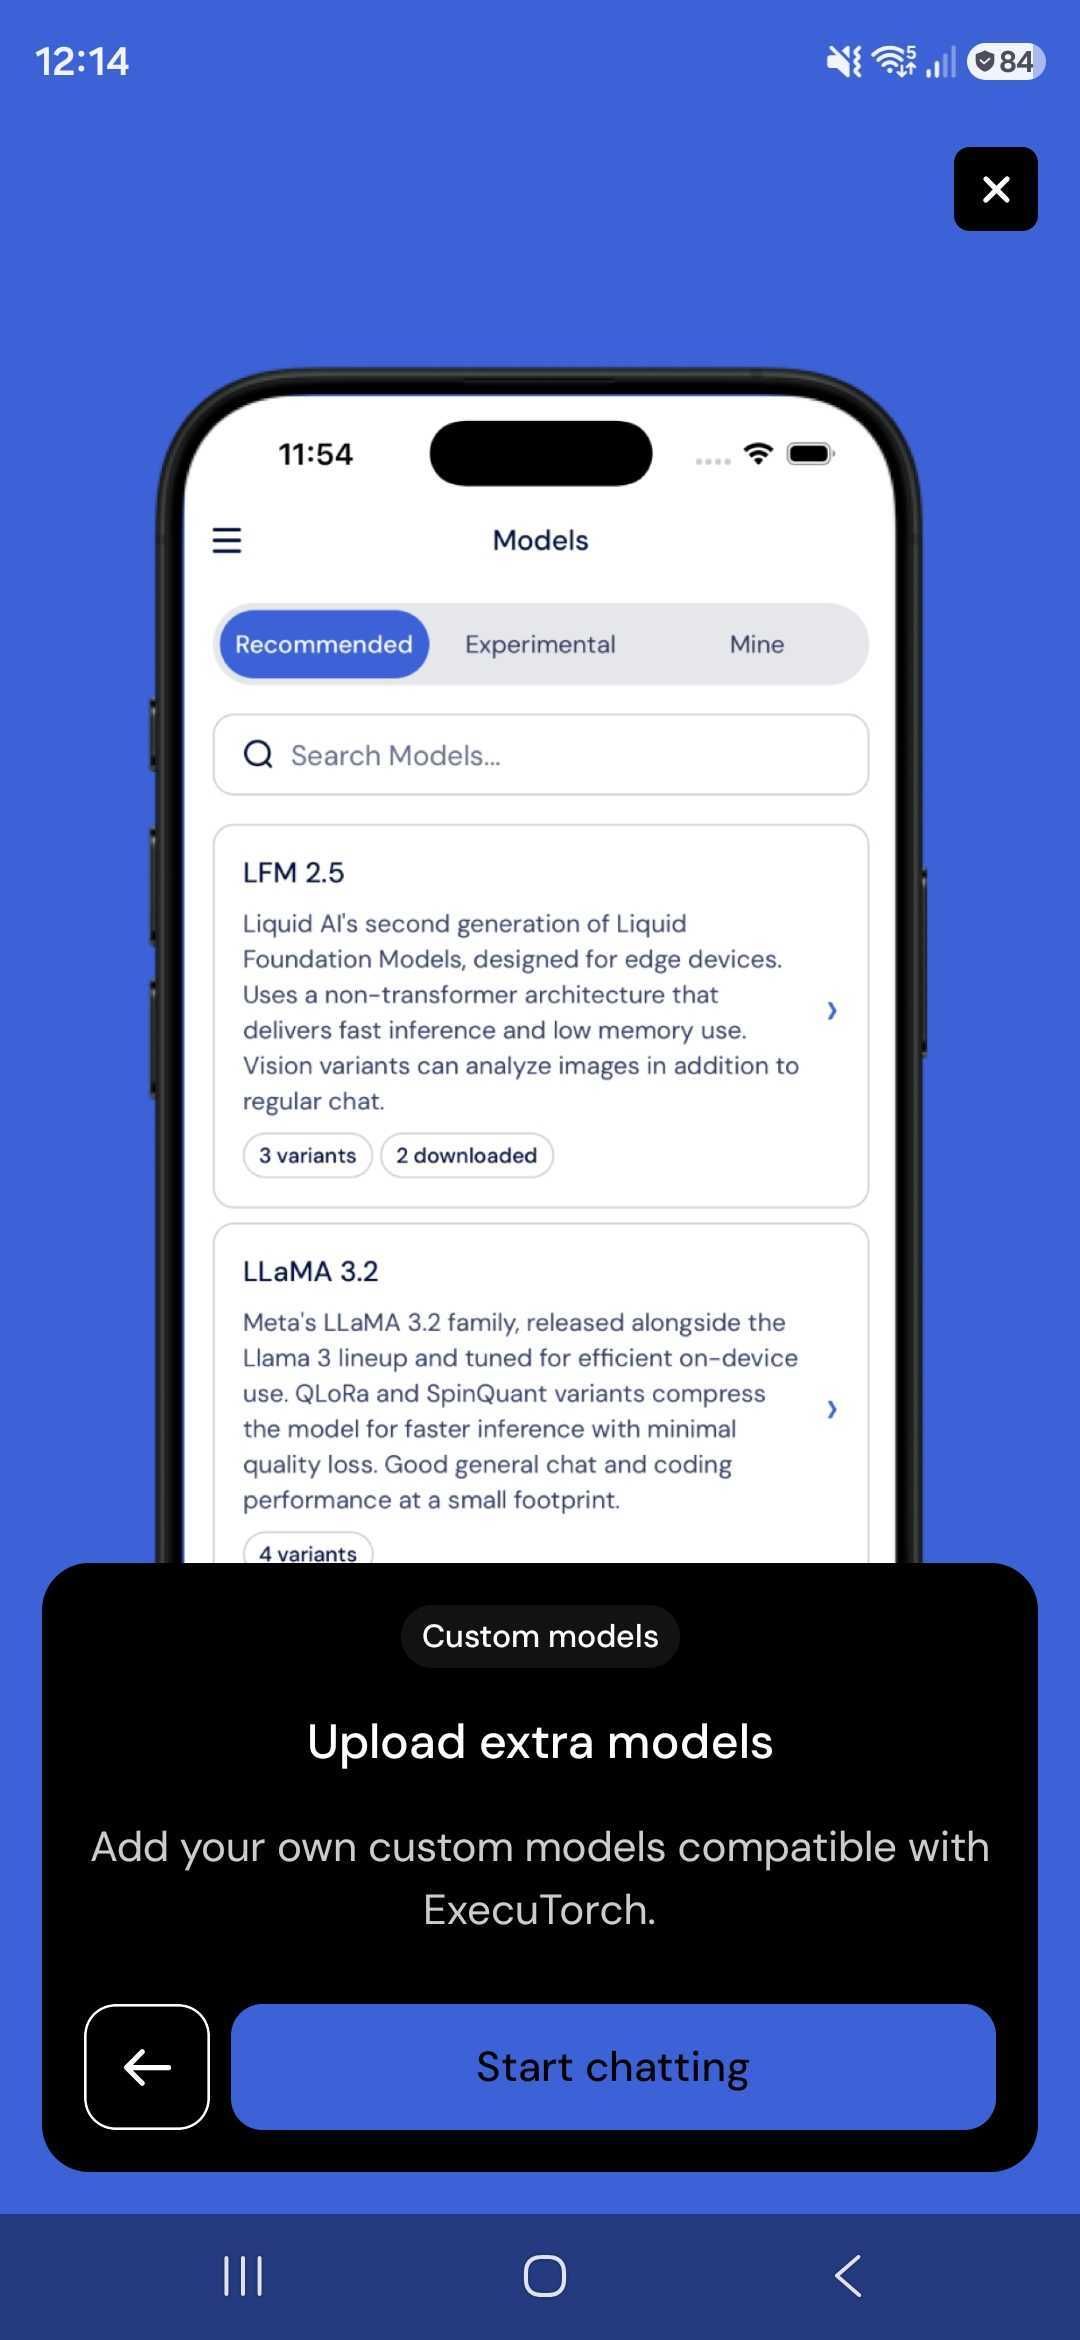
おすすめのリストは出発点にすぎず、縛りではない。ExecuTorch .pte 形式でエクスポートされたモデルなら何でもサイドロードできる。外部 URL からでもローカルファイルからでもよく、huggingface.co/software-mansion で公開しているモデルも含まれる。モデルは系列ごとにまとまり、Recommended、Experimental、Mine の 3 つのタブに分かれている。各系列にはバリアントがいくつあるか、そのうちいくつをダウンロード済みかが表示される。
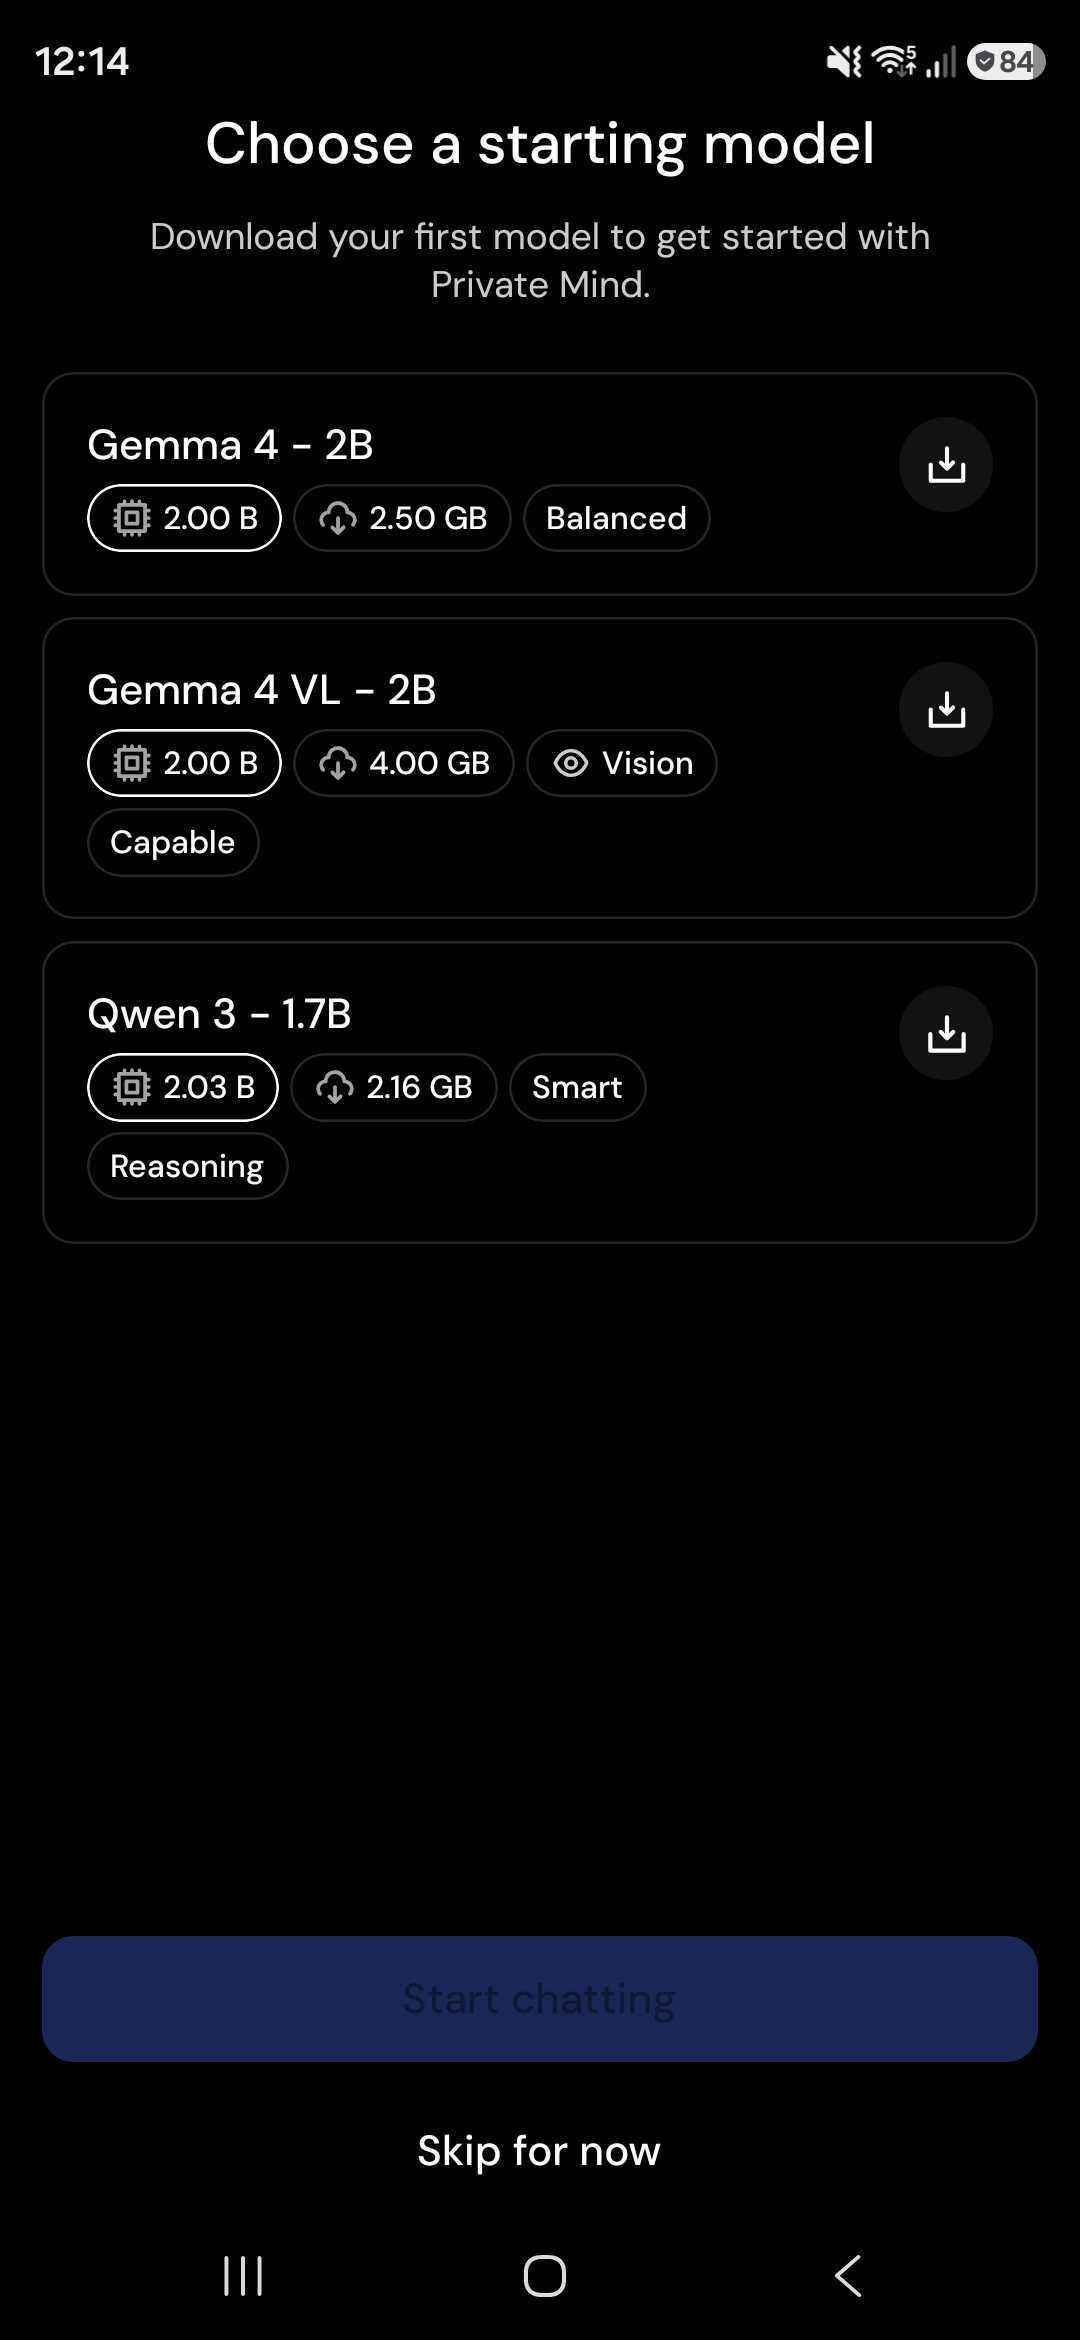
ガイドを見終われば、あとはモデルを選んでダウンロードするだけだ。各カードにはパラメータ数、ダウンロードサイズ、そしてそのモデルが何を得意とするかを示すタグ——Balanced、Vision、Smart、Reasoning——が並ぶ。名前から推測するのではなく、実際の用途に合わせて選べる。ここは別に触れておきたい点だが、アプリはあなたのデバイスで動くモデルしか提示しない。4 GB の重みをダウンロードさせておいて、ロード時にメモリに収まらないと判明する、といったことは起きない。Private Mind はモデルのリストと現在動いているハードウェアを突き合わせ、合わないものは除外する。
ダウンロードが終わると、新しい会話が始まる。現在のモデルは画面上部に表示され、別のモデルへの切り替えはタップ 1 回で済む。おすすめのメッセージですぐに試せて、Think トグルは対応モデルで拡張推論を有効にし、+ ボタンはドキュメントの添付、波形アイコンは音声メッセージの送信に使う。
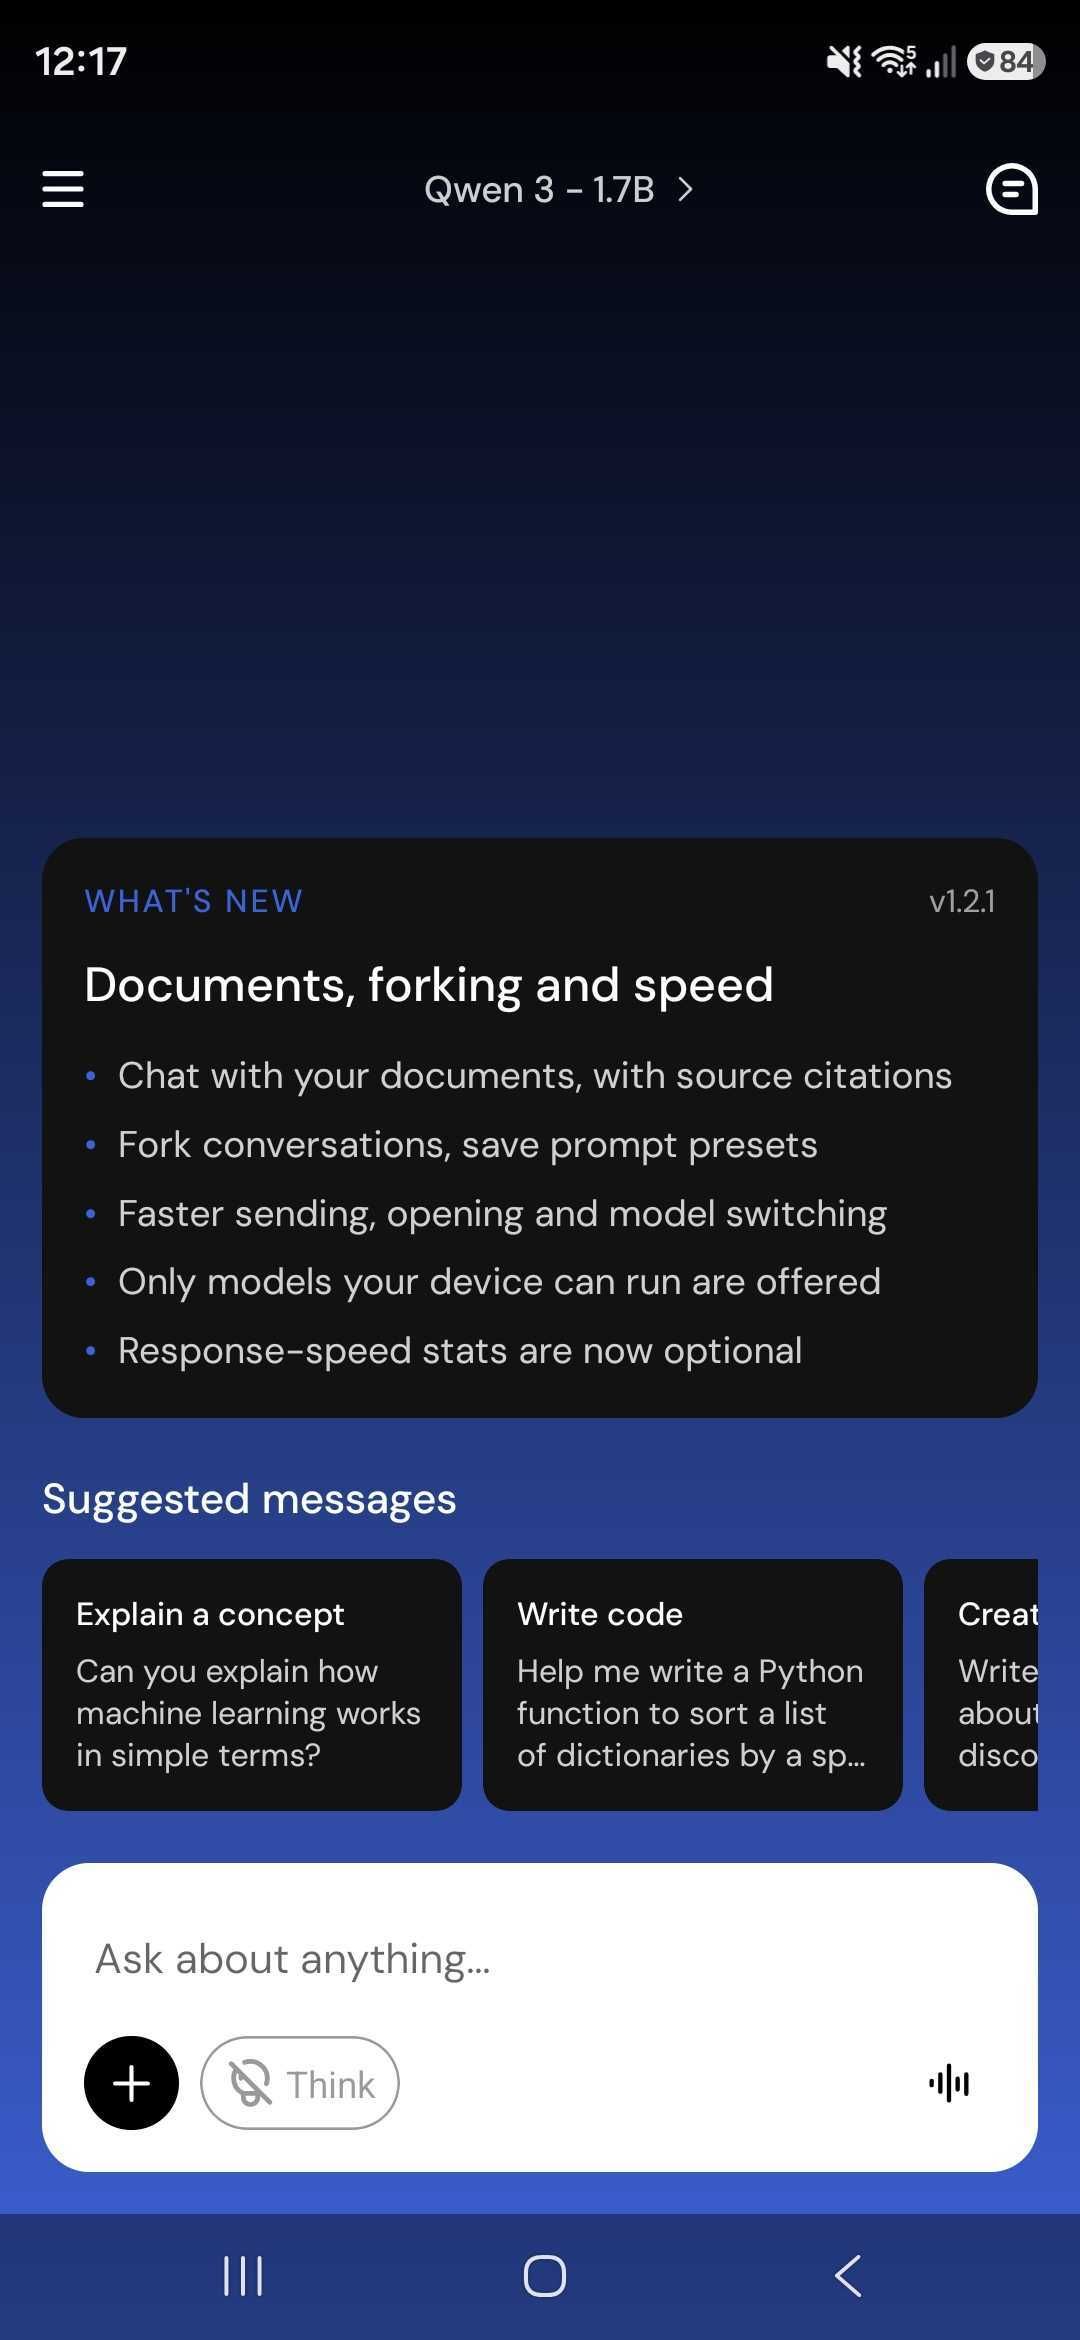
質問を投げると、答えはトークンごとにストリーミングで返ってくる。すべてスマホのメモリ上で動くモデルが生成したものだ。
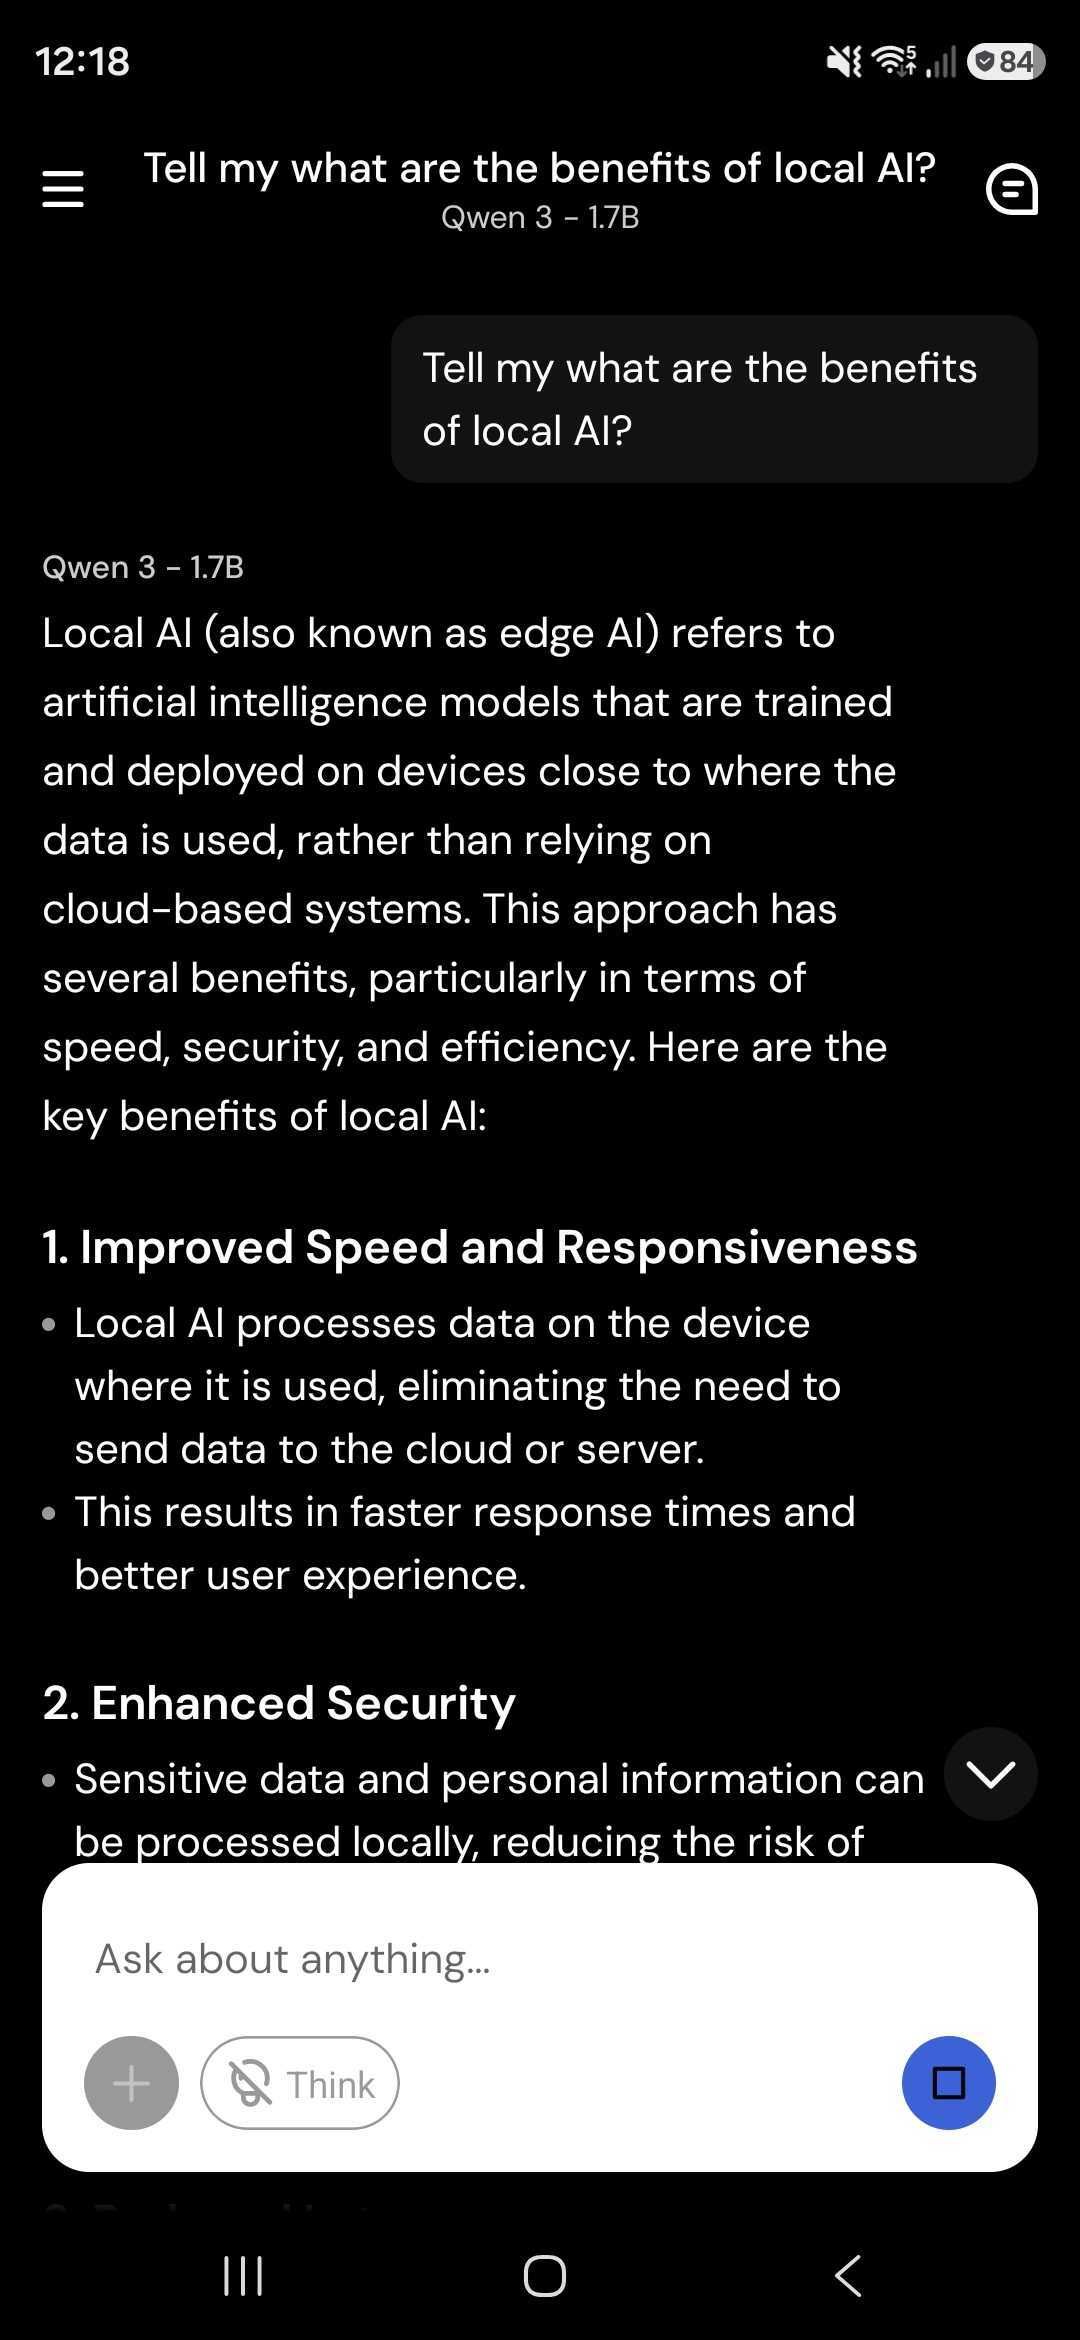
会話は分岐できるので、元のスレッドを失わずに別の方向を試せる。プロンプトプリセットを使えば、繰り返し使う system prompt を保存しておける。
自分のアプリにローカル AI モデルを組み込む
Private Mind は React Native ExecuTorch の上に作られている。これも私たち Software Mansion が手がけた技術だ。AI モデルをデバイス上で直接動かすための宣言的な方法を提供し、土台には ExecuTorch がいる。ExecuTorch は Meta のフレームワークで、スマートフォンやマイコンといったデバイス上でモデルを実行できるようにする。React Native ExecuTorch は React Native とネイティブプラットフォームの機能をつなぎ、AI モデルをローカルで最高水準の性能で動かせるようにする——深いネイティブ開発や機械学習の知識は一切要らない。つまり、自分のアプリを開発中なら、React Native ExecuTorch を使えばローカル AI 機能の実装はずっと楽になる。
- React Native ExecuTorch のウェブサイト
- React Native ExecuTorch の GitHub リポジトリ
- React Native ExecuTorch のドキュメント
身近に React Native 開発をわかる技術者がいなければ、いつでも私たちに相談してほしい。私たちは Software Mansion——ソフトウェア開発のコンサルティング会社で、React Native のコアコントリビューターであり、AI とマルチメディアの専門家でもある。projects@swmansion.com までメールを送り、あなたのプロジェクトで何の役に立てるかを話そう。