六个能在手机上离线跑的本地模型:参数量、体积与各自擅长什么
2026年6款本地AI模型盘点:数据不出设备即可运行,兼顾隐私与离线能力。
中文
复制
AITop 6 本地 AI 模型:隐私最大化与离线能力(2026)

Piotr Zborowski
Mateusz Słuszniak2026年9月8日•10 分钟阅读 AI
2026 年最值得关注的 6 款本地 AI 模型:隐私最大化与离线能力
Piotr Zborowski
Mateusz Słuszniak2026年9月8日•10 分钟阅读本文内容 人工智能早已成为我们设备上各类应用的重要组成部分。它为我们推荐下一个要看的视频,纠正拼写错误,生成图片,或者回答我们的问题。但这种流畅的体验并非没有代价——依赖 AI 服务商是要付出成本的。你与 AI 系统的每一次交互,通常都意味着把数据(包括隐私信息)发送到远程服务器,等待响应,然后祈祷中间别出什么岔子。我们正在进入一个新时代:AI 就运行在你的设备上。继续往下读,你会了解使用本地 AI 的好处、哪些模型值得一试,以及如何在自己的移动应用中引入本地 AI 模型。
最流行的 AI 模型是如何工作的?
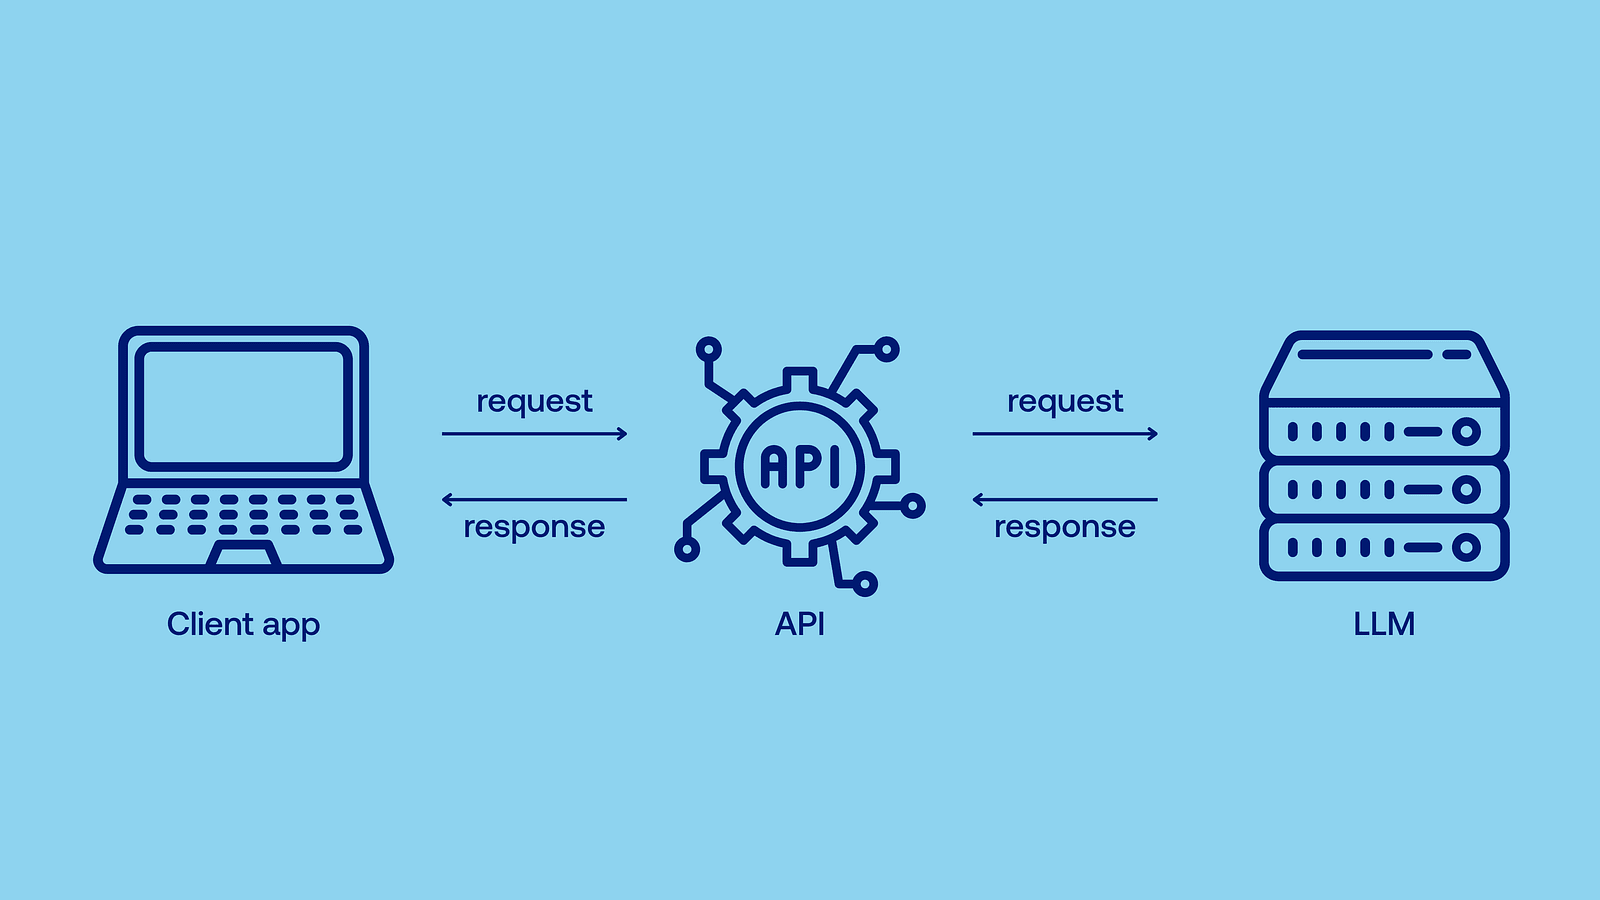
运行最先进的 AI 模型需要大量算力——毕竟,它们的参数量可以超过一万亿(也就是 1 后面跟着十二个零!)。我们大多数人无法在自己的设备上完成这件事,因此像 GPT-4.1 这样的模型以云端模型的方式运行:一切并非在本地计算, 而是你通过浏览器向服务商发送一个请求(API 调用),模型在他们强大的服务器上运行,然后返回计算结果,你无需承担任何繁重的计算工作。等着就行。
本地 AI 模型的优势
本地 AI 指的是直接在你的设备上运行的 AI 模型。 它们不依赖远程 API,数据一生成就能立刻响应。前面我提到过,最流行的模型对普通用户的设备来说负担太重,所以你在本地跑的是更小的模型,通常只有几十亿参数。头部公司的旗舰模型同样不是开源的,比如 OpenAI 的 GPT-4.1 或 Anthropic 的 Claude Opus 4。 就算你车库里摆着一台超级计算机,也没法在本地跑起来。既然在线就能用更大的模型,何必费劲自己跑一个小模型?理由至少有这么几个。
隐私更强
用本地 AI,数据从不离开你的设备。服务商不会拿它去训练模型或投广告,就算发生安全泄露也不会外流(处理公司敏感数据时,这一点尤其有用)。没有云端,没有中间商。
扩展性更好
云端 AI 面对不断增长的需求,规模一上去就可能出现处理延迟或更高的调用成本。扩展还会带来更大的安全风险——要想轻松扩容又保住机密信息,本地 AI 才是出路。开发者不必花时间调整架构来应对云端基础设施用量的增长。
成本更低
流行模型都是专有的,按 token(构成词句的文本小单位,提问和回答都算)或按月计费。在本地跑开源模型,电费基本就是全部开销。不需要订阅。
延迟极低
用在线 API 时,你得先把数据发出去,等它被处理完再传回来——每一步都要花时间。本地 AI 则在响应生成的那一刻就交付给你。
可离线使用
没网?没关系。本地 AI 在飞机上、在偏远地区,以及任何网络不稳定或压根没有网络的地方都能用。想想这能覆盖多少场景吧。
稳定性无可匹敌
无论全球有多少用户正在使用模型、你的网络连接有多好,本地 AI 的表现始终如一。你只需要一台性能足够运行某个模型的设备。
可定制性高
开源本地模型可以基于你自己的数据重新训练或微调(这种做法叫检索增强生成,即 RAG,用 React Native RAG 就能轻松搭建这类模型)。也就是说,你可以用公司内部的知识库让 AI 模型的回答更准确。模型的部署和更新也完全由你掌控。
移动端 AI
本地 AI 覆盖所有边缘设备,但真正的机会在低功耗移动设备上(手机、平板、嵌入式系统、可穿戴设备)。 这些设备最可能被你带到没有网络的地方,用于实时语言翻译或视觉任务,对延迟要求极高,或者涉及你比较在意的隐私问题。在 Software Mansion,我们测试本地 AI 的可能性已经有一段时间了——既为客户项目,也为内部项目。下面来看看我们在各种场景中发现特别好用的 6 个本地 AI 模型。
6 个顶级本地 AI 模型
Gemma 4 E2B
Gemma 4 是 Google 新推出的开放模型,E2B 是专为移动设备打造的版本。“E”代表 effective(有效)。该模型在磁盘上带有 51 亿参数,但借助一种巧妙的嵌入技巧,实际参与运算的只有约 23 亿。正因如此,它才能跑在通常装不下这种规模模型的硬件上。它还是多模态的:Gemma 4 能读文本、看图像、听音频,全部离线完成,支持 140 多种语言。
- 参数量:5.1 B(有效 2.3 B)
- 体积:10.2 GB(BF16)/ 2.6 GB(int4)
Qwen 3.5-2B
这是去年我们推荐的 Qwen 3 1.7B 的直接继任者,来自中国巨头 Alibaba。如果你的用户不说英语,它仍然是首选,因为 Qwen3.5 系列覆盖 200 多种语言和方言。它不仅能处理文本,还能处理图像。如果你只面向旗舰手机,那就选 4B 版本。
- 参数:2 B
- 体积:4 GB(BF16)/ 1.1 GB(int4)
Mistral 3 3B
去年我们推荐了法国初创公司 Mistral AI 的 Mistral 7B,并坦率地提醒它其实是一款笔记本级模型。Ministral 3 解决了这个问题。3B 版本可以轻松装进手机,采用 Apache 2.0 许可,并且能理解图像。它尤其擅长那些苦活累活:从文档中提取结构化数据,或者返回你的应用真正能解析的干净 JSON。
- 参数:3 B
- 体积:6 GB(BF16)/ 2 GB(int4)
LFM2.5-1.2B
这份榜单上的其他模型都是先有大模型,再被缩小。Liquid AI 反其道而行。LFM2 从第一天起就是针对手机的约束条件设计的,结果也很难反驳:他们最小的几个版本在 Galaxy S25 Ultra 上每秒生成超过 200 个 token,在 iPhone 13 Mini 这样的老设备上依然跑得很轻松。它支持快速可靠的工具调用。
- 参数:1.2 B
- 体积:2.4 GB(BF16)/ 0.7 GB(int4)
Moonshine v2
这篇文章可不只是讲读写文本的模型!Moonshine AI 的 Moonshine v2 拿下了我们语音识别推荐的位置。它只处理实际存在的音频,因此能在手机上跟上实时字幕。它有三个尺寸,英语权重采用 MIT 许可。其他语言则适用单独的社区许可,发布前记得确认。
- 参数:34 M / 123 M / 245 M
- 体积:68 MB / 246 MB / 490 MB(BF16),37 MB / 135 MB / 270 MB(int8)
Harrier-oss-v1-0.6b
最后一个位置,留给一个从不写字的模型。Microsoft 的 Harrier 这类嵌入模型能把文本转成向量,应用因此可以按语义而非关键词来检索。这正是端侧 RAG 缺失的另一半。把上面任意一个模型指向你自己的文档、公司 wiki 或多年的笔记,数据始终不会离开手机。Harrier 采用 MIT 许可,在检索任务上胜过所有 7B 参数以下的开源嵌入模型。搭配 React Native RAG 使用。
- 参数:0.6 B
- 体积:1.19 GB(BF16)/ 0.63 GB(int8)
在手机上试试本地 AI 模型
理论说够了,该动手了。为了让你在真实场景中测试这些本地 AI 模型,我们专门做了一个应用——Private Mind,一款离线 AI 聊天应用。一切都在你自己的设备上运行,模型想用多久就用多久,除了已有的硬件之外不花一分钱。App Store 和 Google Play 均已上架:
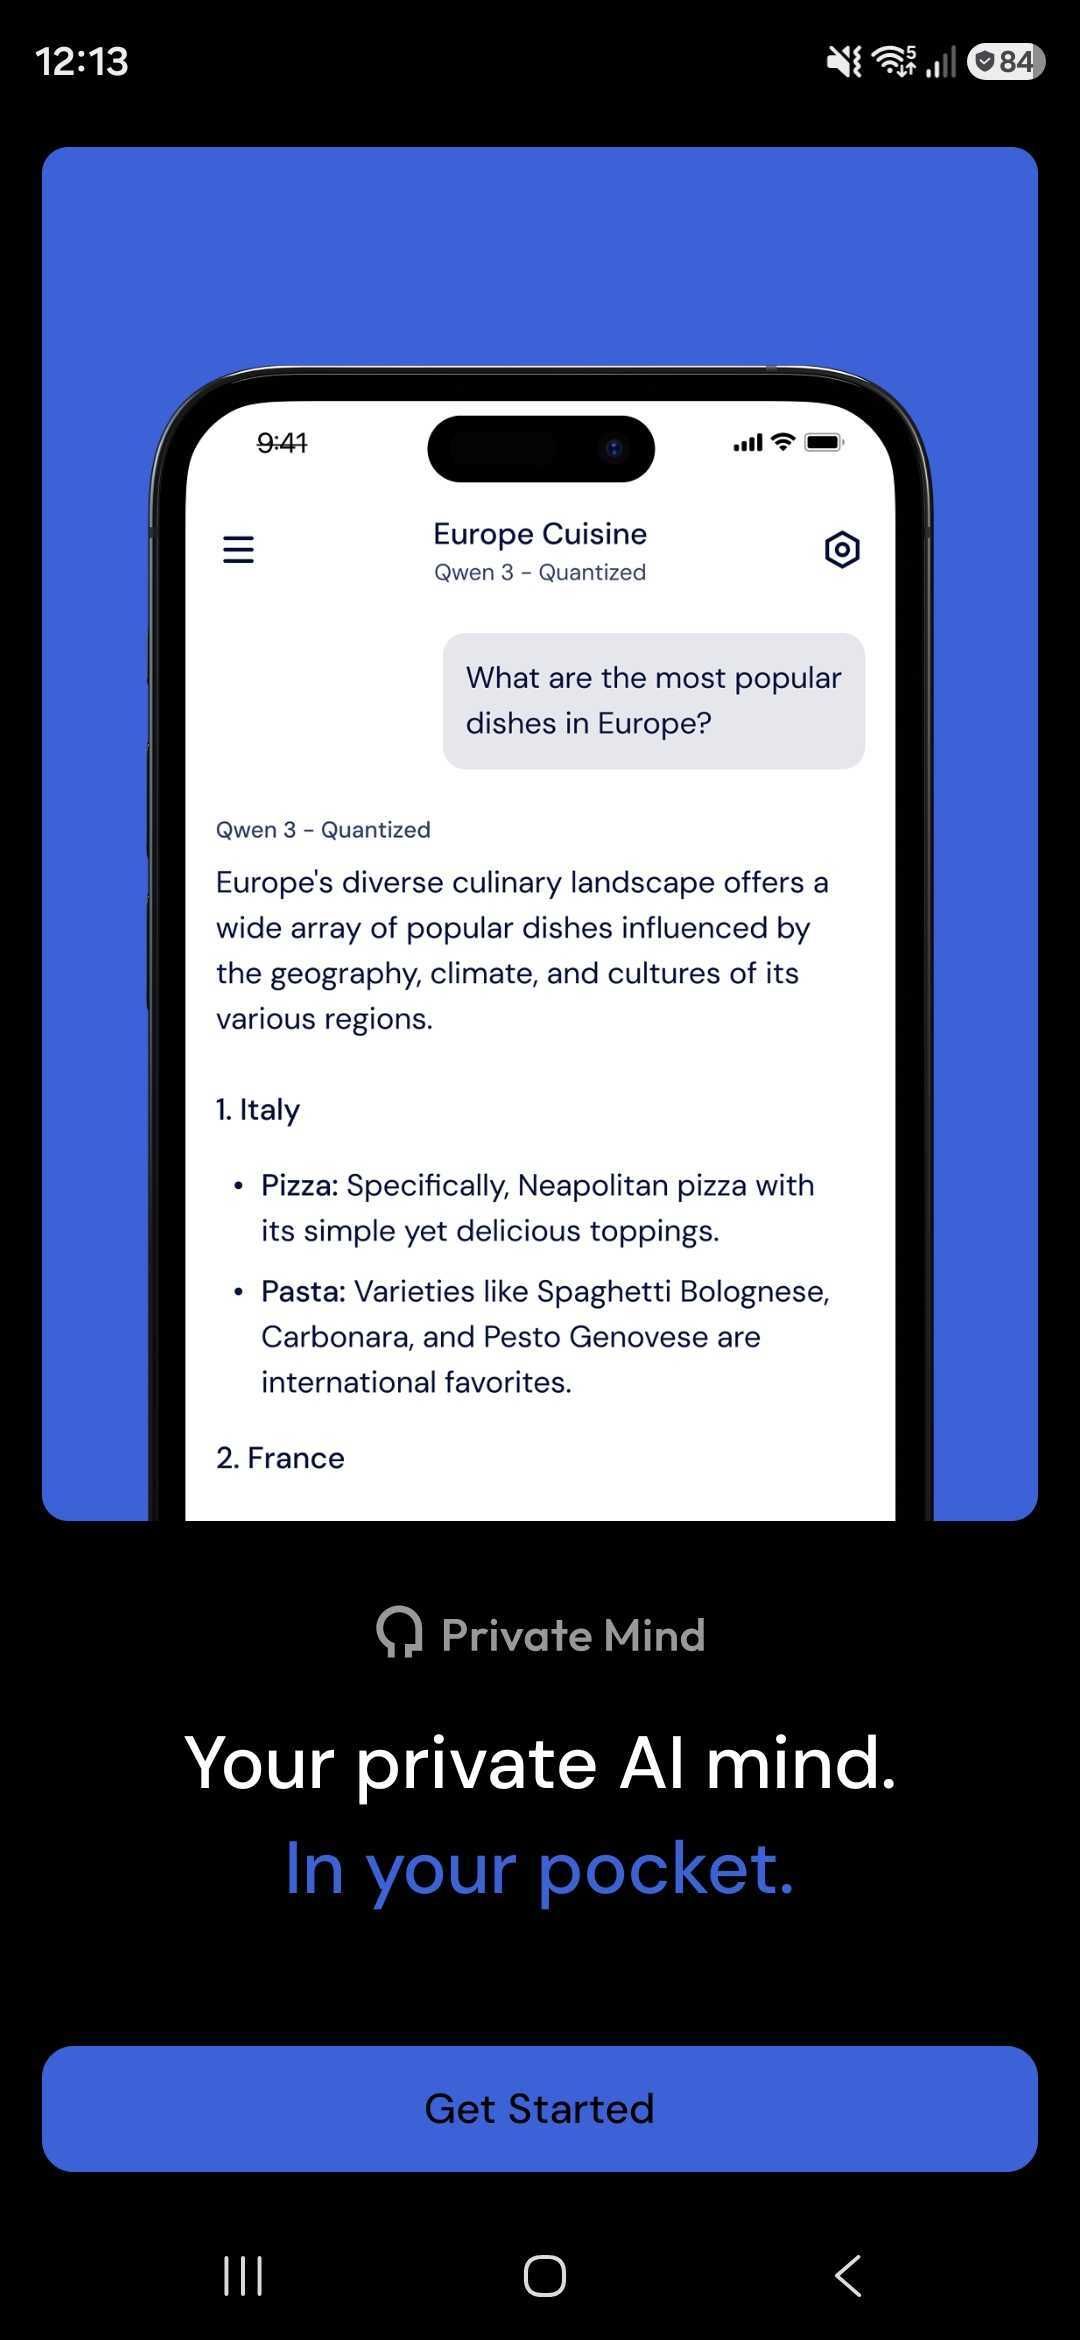
快速看看里面有什么
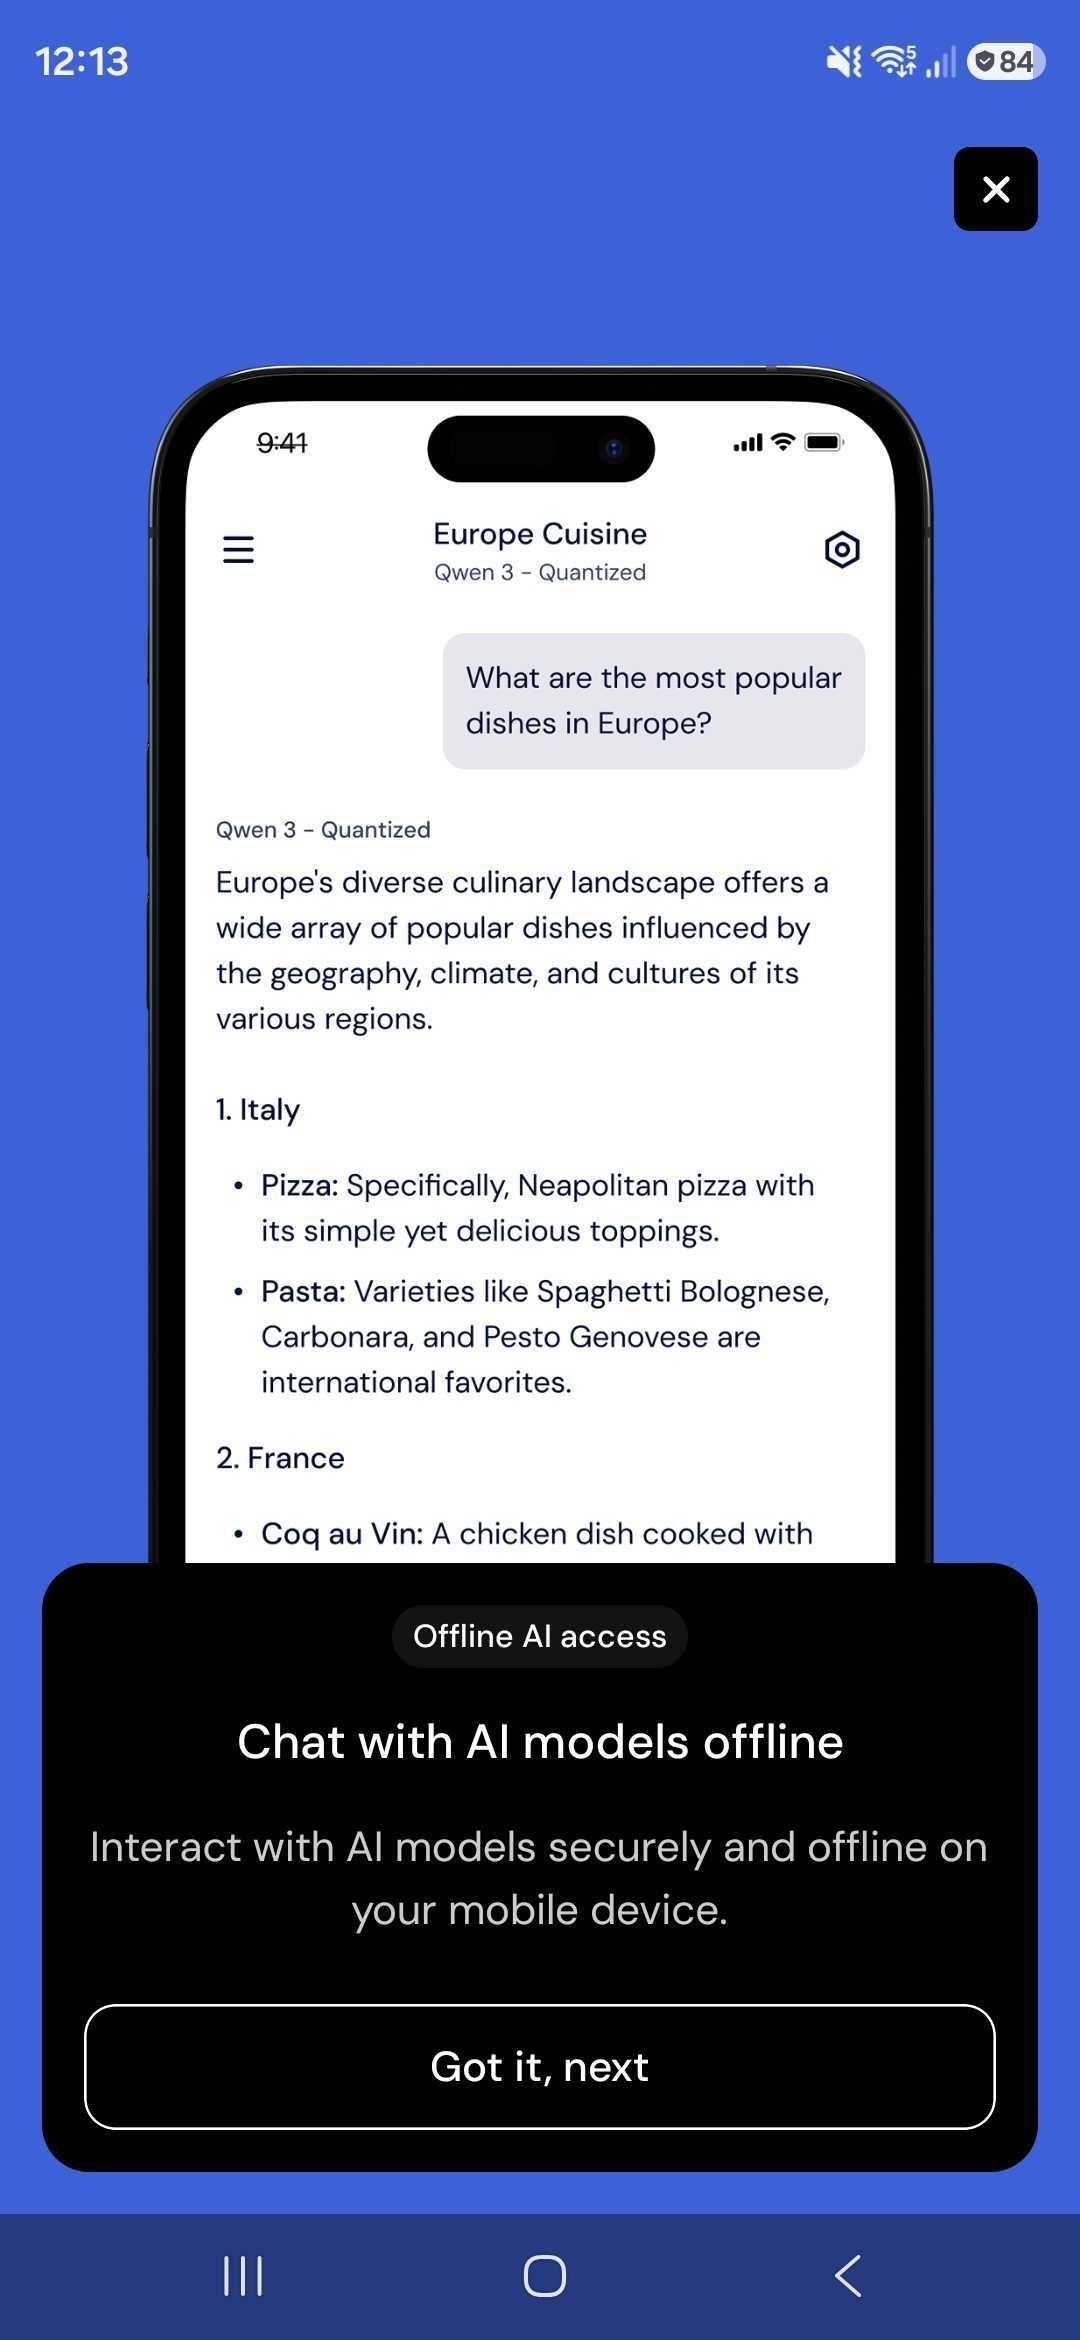
首次打开应用时会有一段简短引导,介绍 Private Mind 能做什么。模型一旦装到设备上,应用就再也不需要联网。在飞机上聊天体验完全一样,因为整个流程里本来就没有服务器。
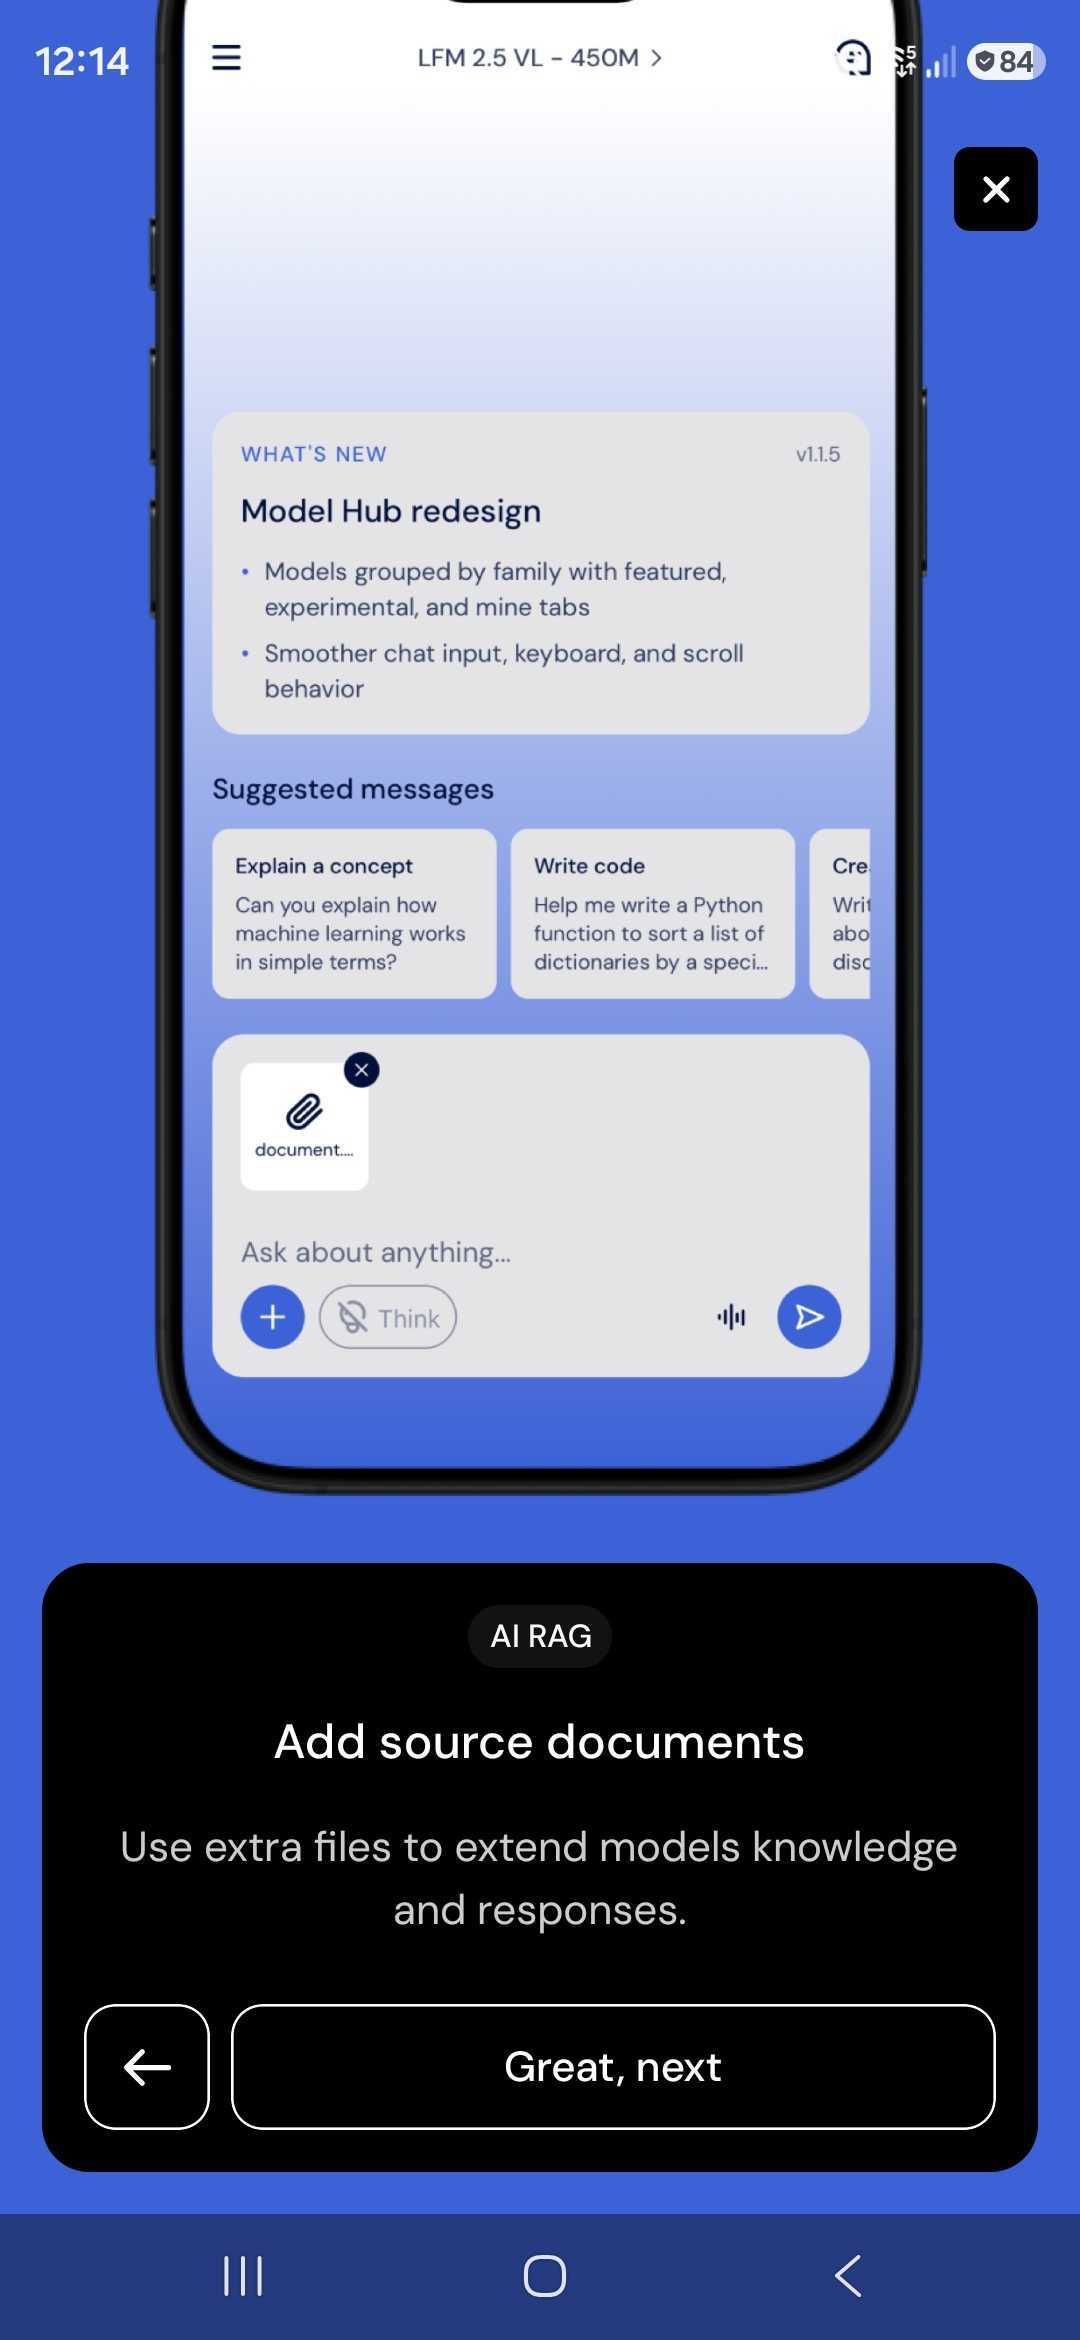
给对话附上一个文件,模型就会基于它作答,并给出指向原文段落的引用。这就是在手机上端到端运行的检索增强生成。你也可以用 React Native RAG 把同样的方案做进自己的应用。
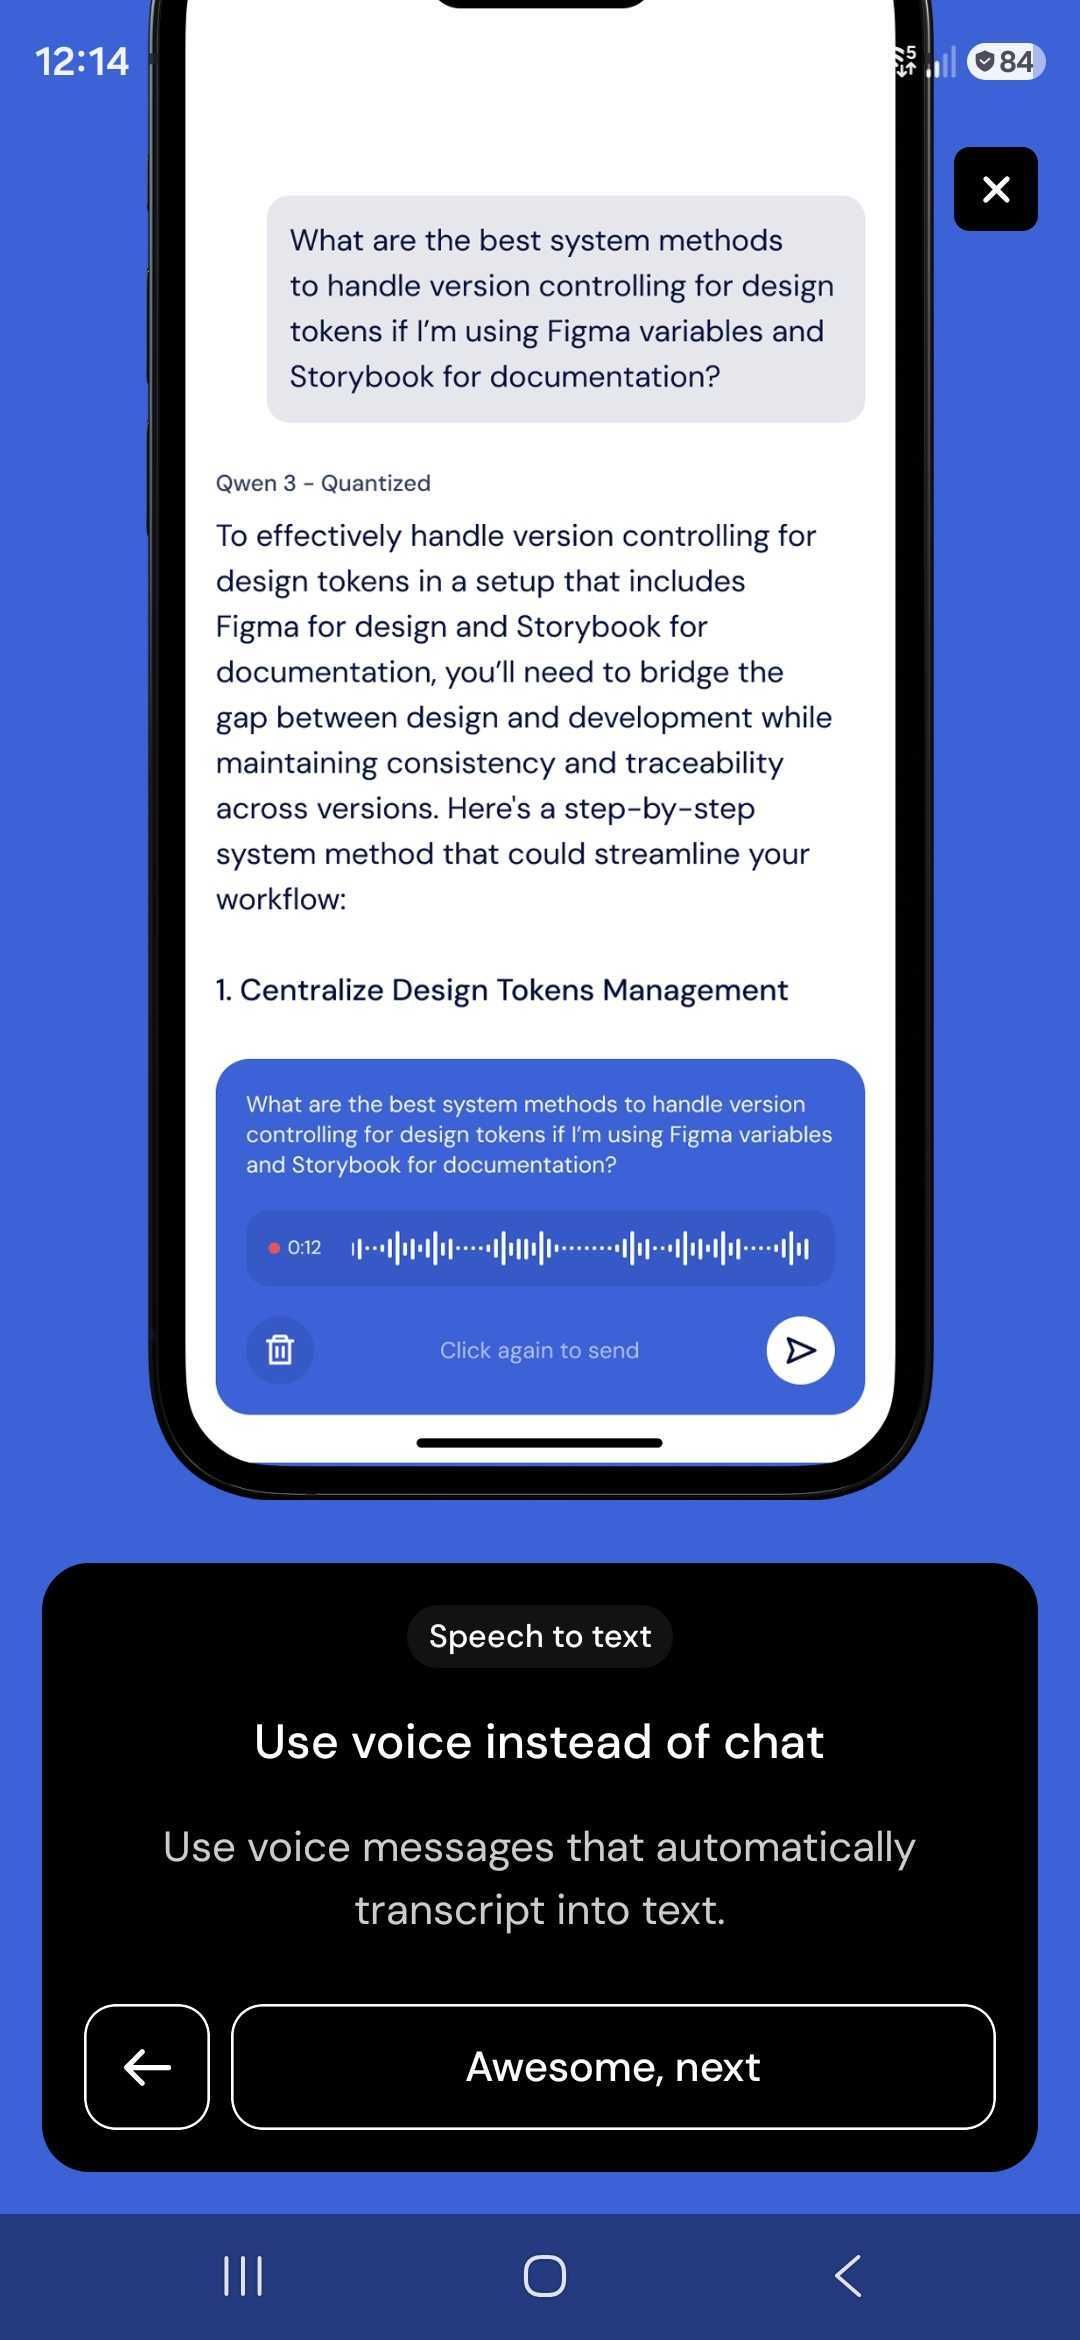
在手机键盘上敲长提示词很痛苦,所以你可以改录一段语音,再转写成文字。音频在本地处理,不会送去外部转写。
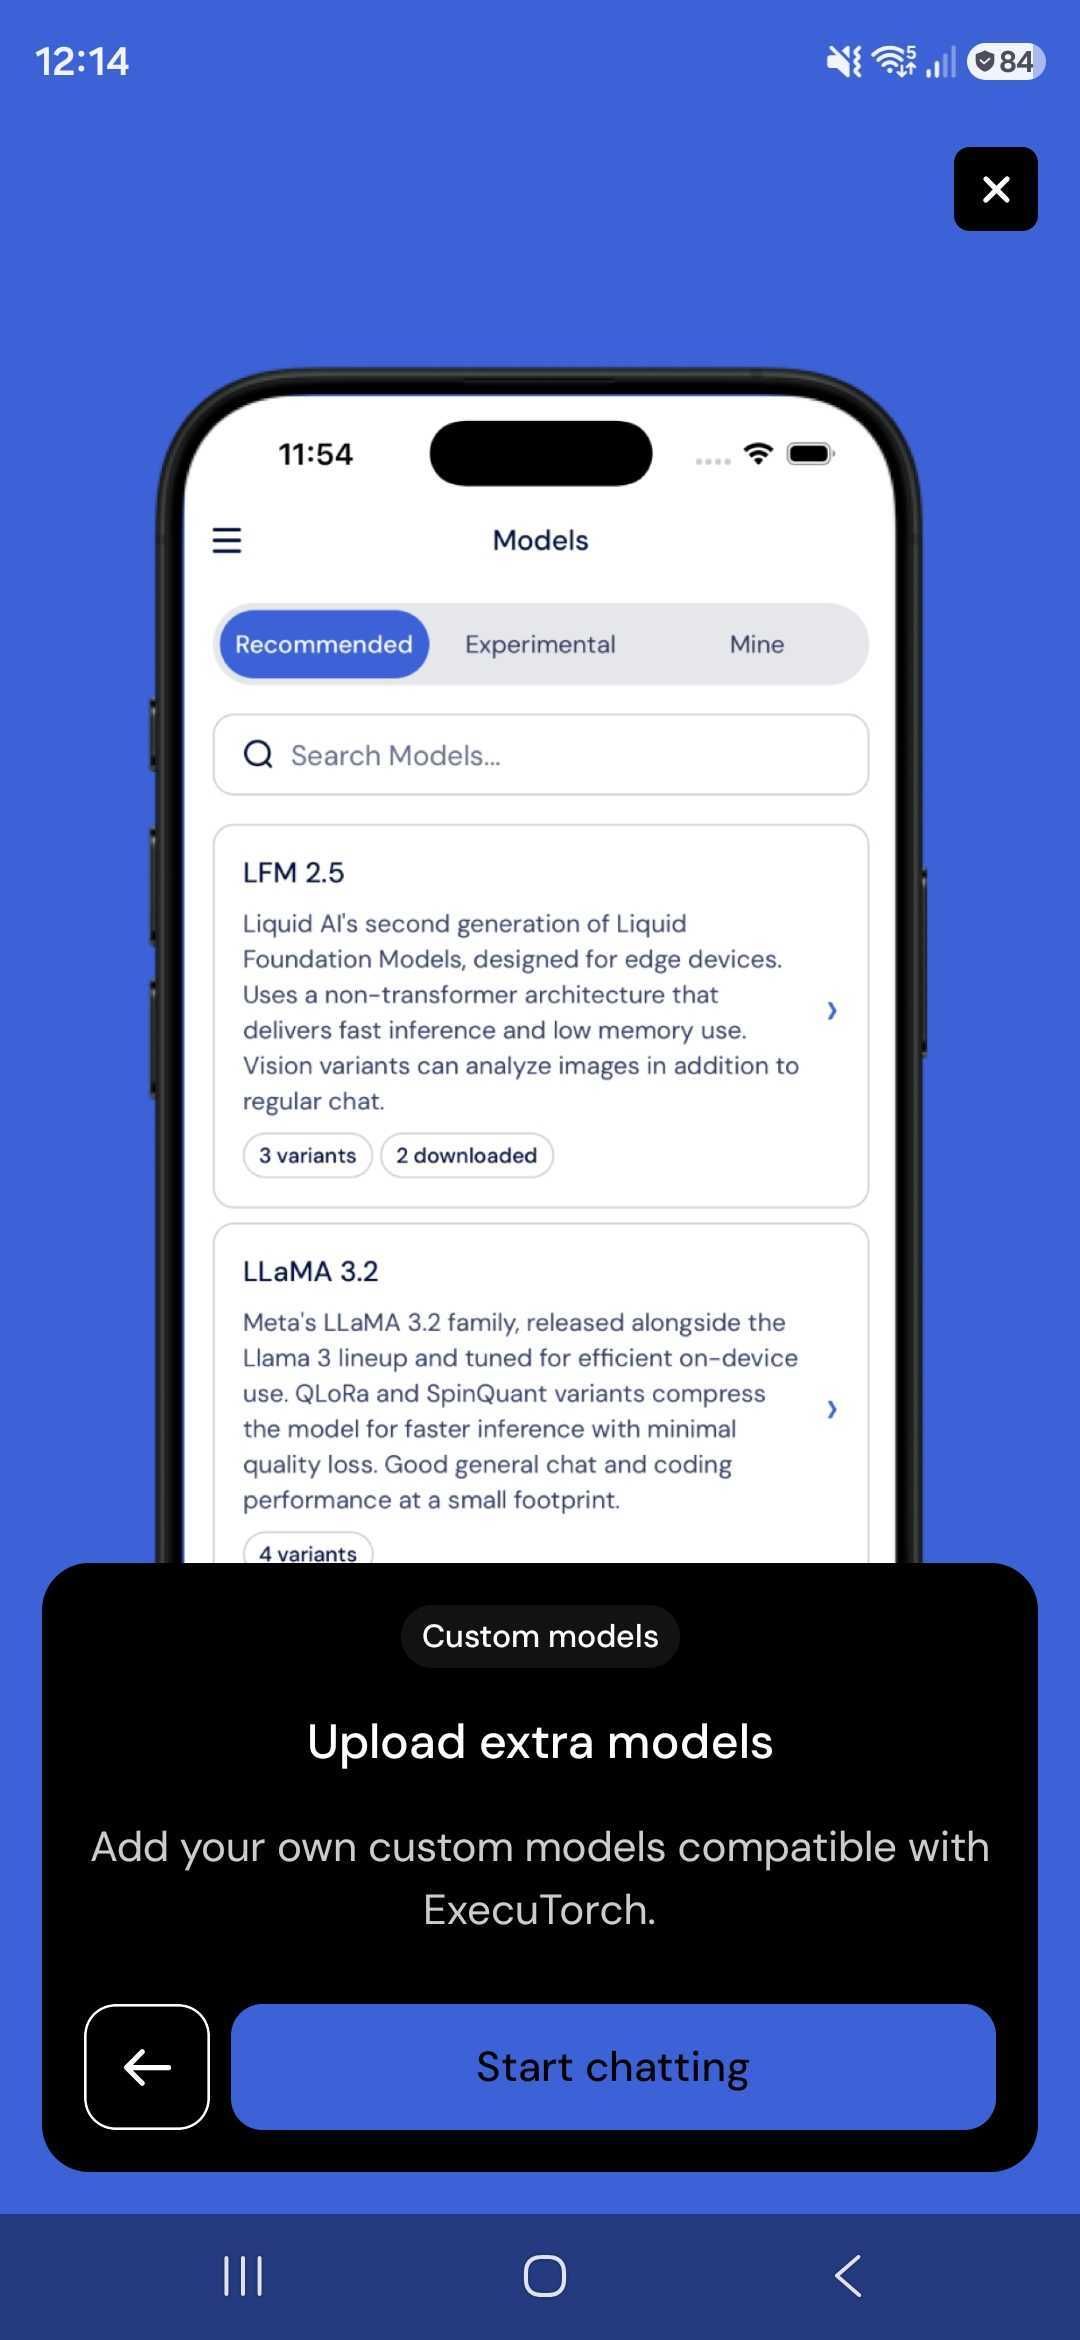
推荐列表只是起点,而非限制。任何导出为 ExecuTorch .pte 格式的模型都可以侧载,来源可以是外部 URL,也可以是本地文件——包括我们在 huggingface.co/software-mansion 上发布的模型。模型按系列分组,分布在 Recommended、Experimental 和 Mine 三个标签页中,每个系列都会显示有多少个变体,以及你已经下载了其中多少个。
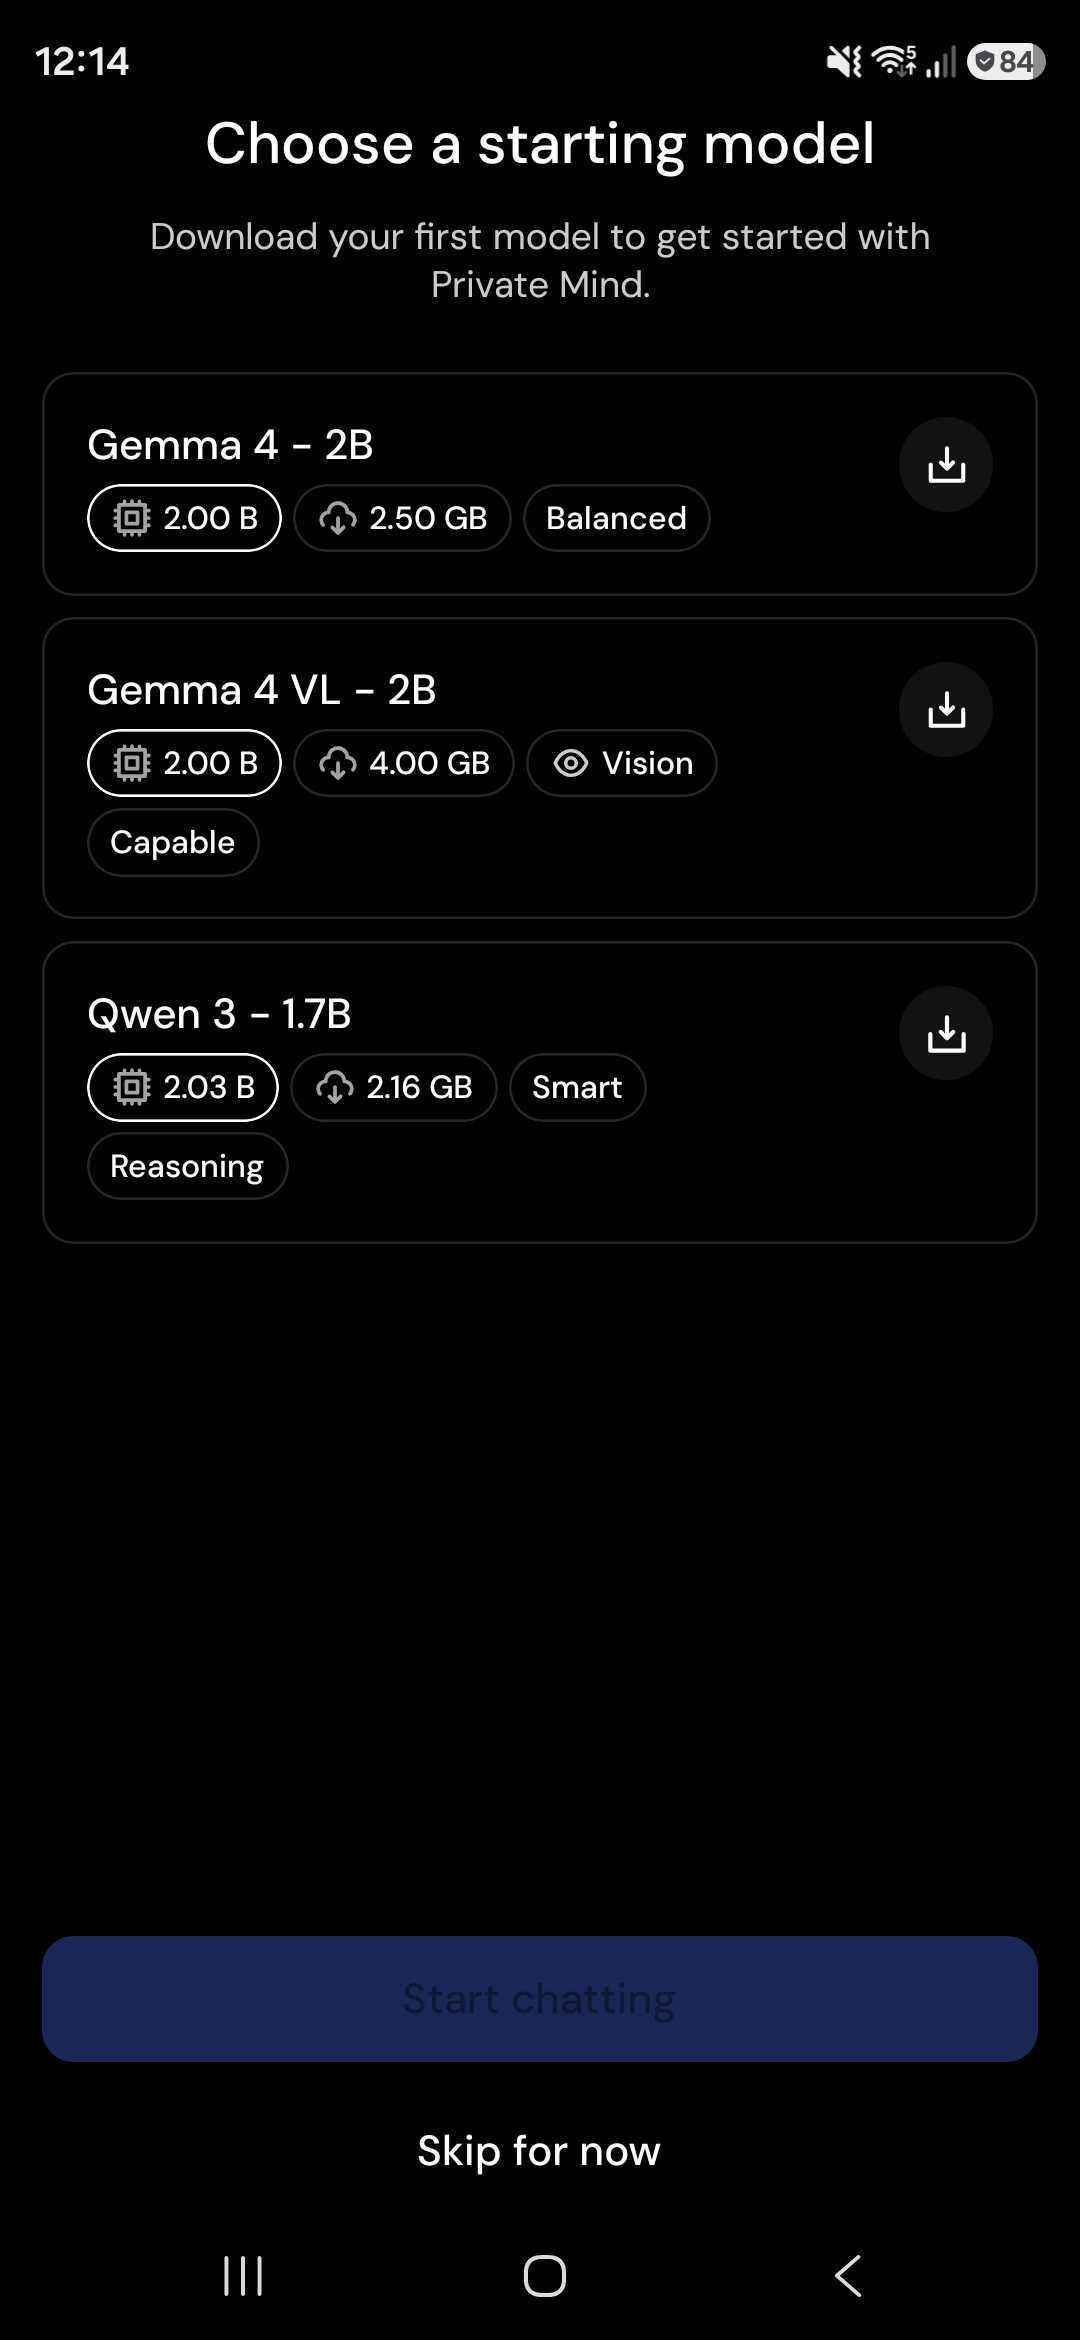
看完引导之后,就可以选一个模型下载了。每张卡片会显示参数量、下载体积,以及几个描述模型擅长什么的标签——Balanced、Vision、Smart、Reasoning——这样你可以根据实际用途来挑模型,而不是靠名字猜。有一点值得单独说:应用只会提供你的设备跑得动的模型。它不会让你下载 4 GB 的权重,然后在加载时才发现内存装不下——Private Mind 会拿模型列表和当前运行的硬件做比对,把不合适的过滤掉。
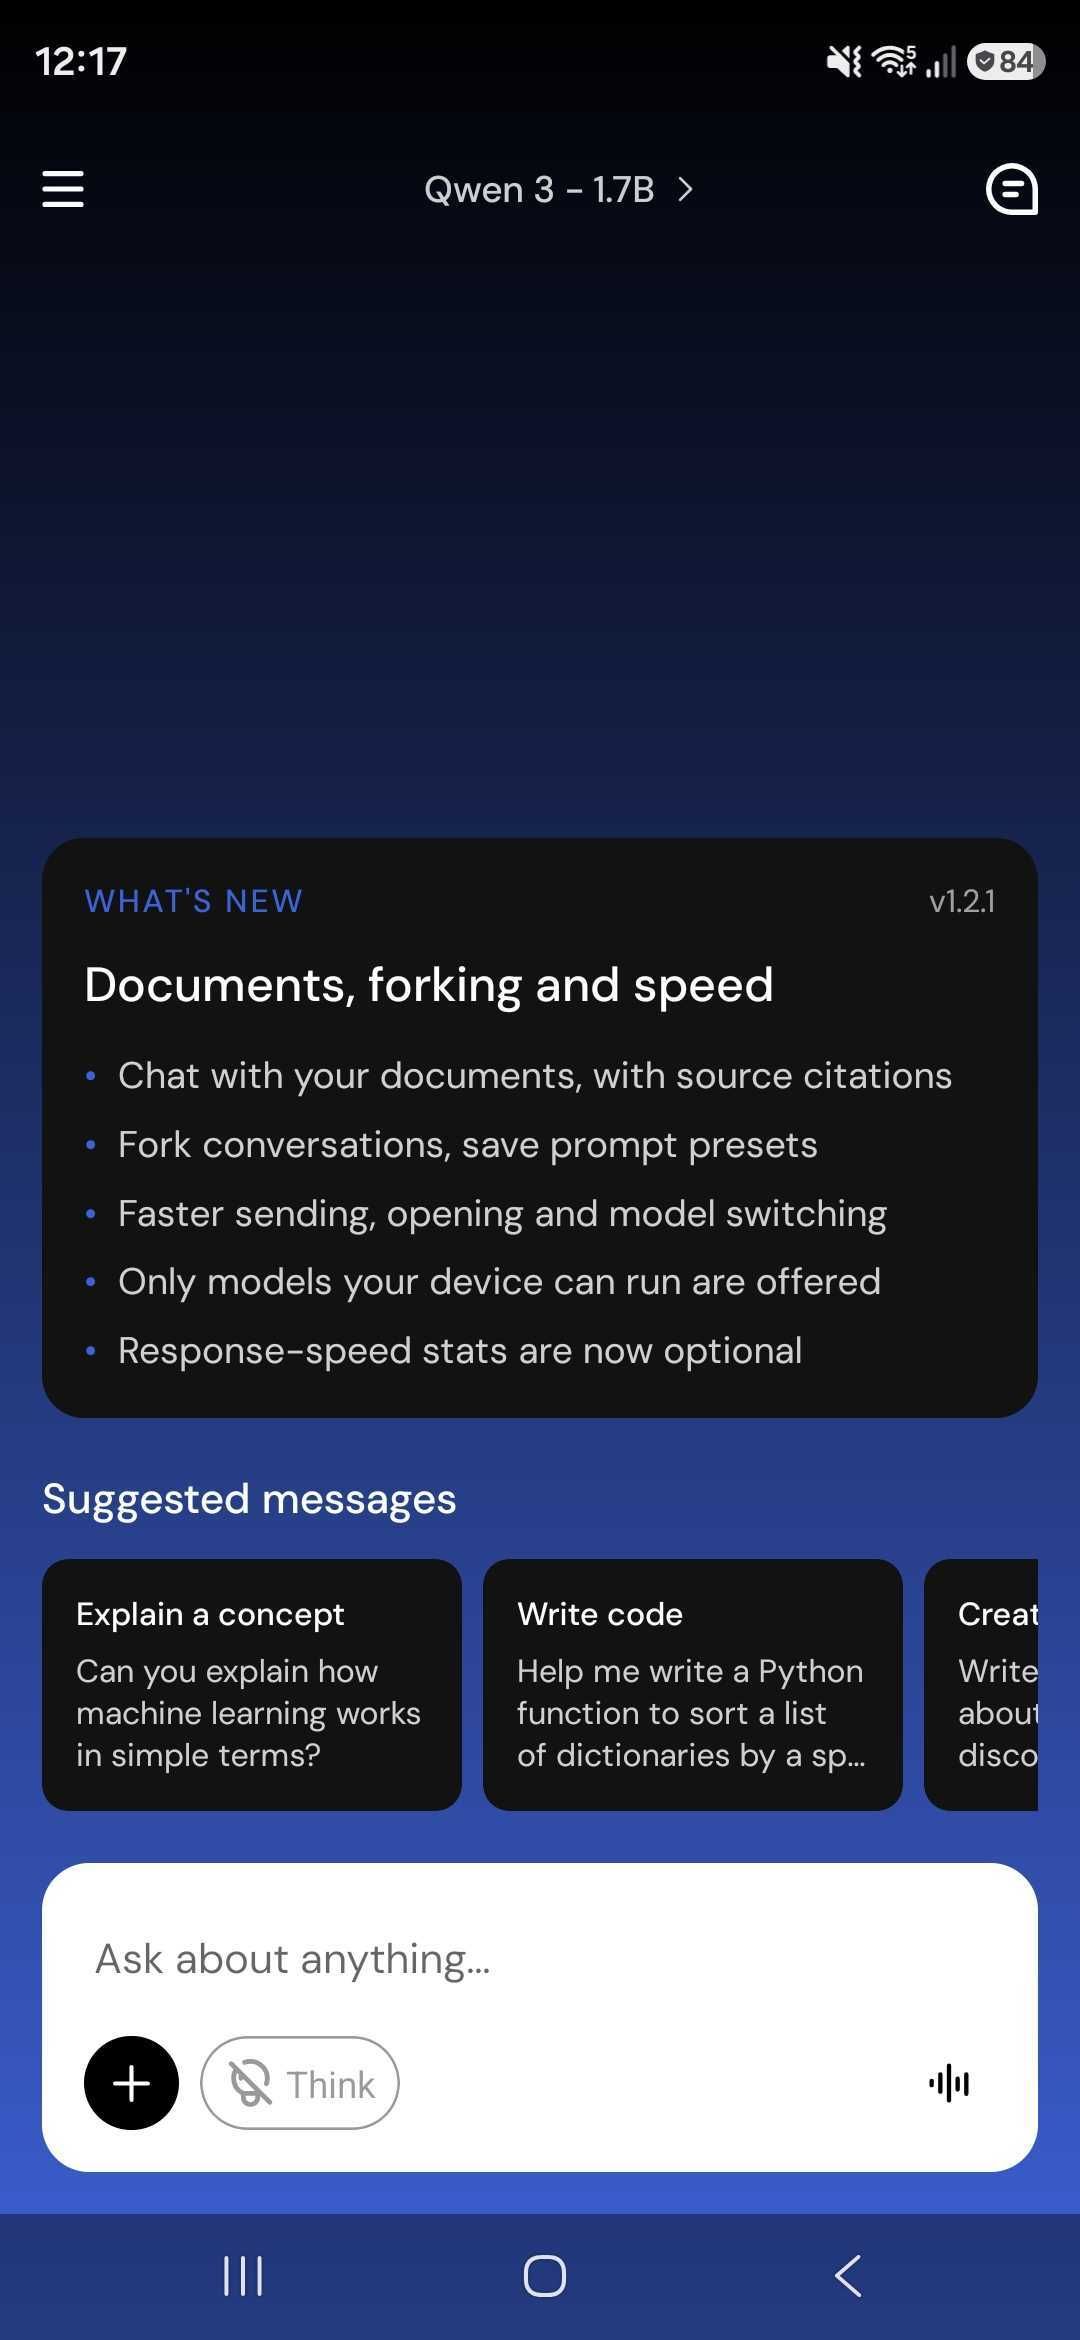
下载完成后,你会进入一个新的对话。当前模型显示在屏幕顶部,切换到另一个模型只需轻点一下。建议消息让你可以立刻上手试试,Think 开关会为支持的模型开启扩展推理,+ 按钮用来附加文档,波形图标则用来发语音消息。
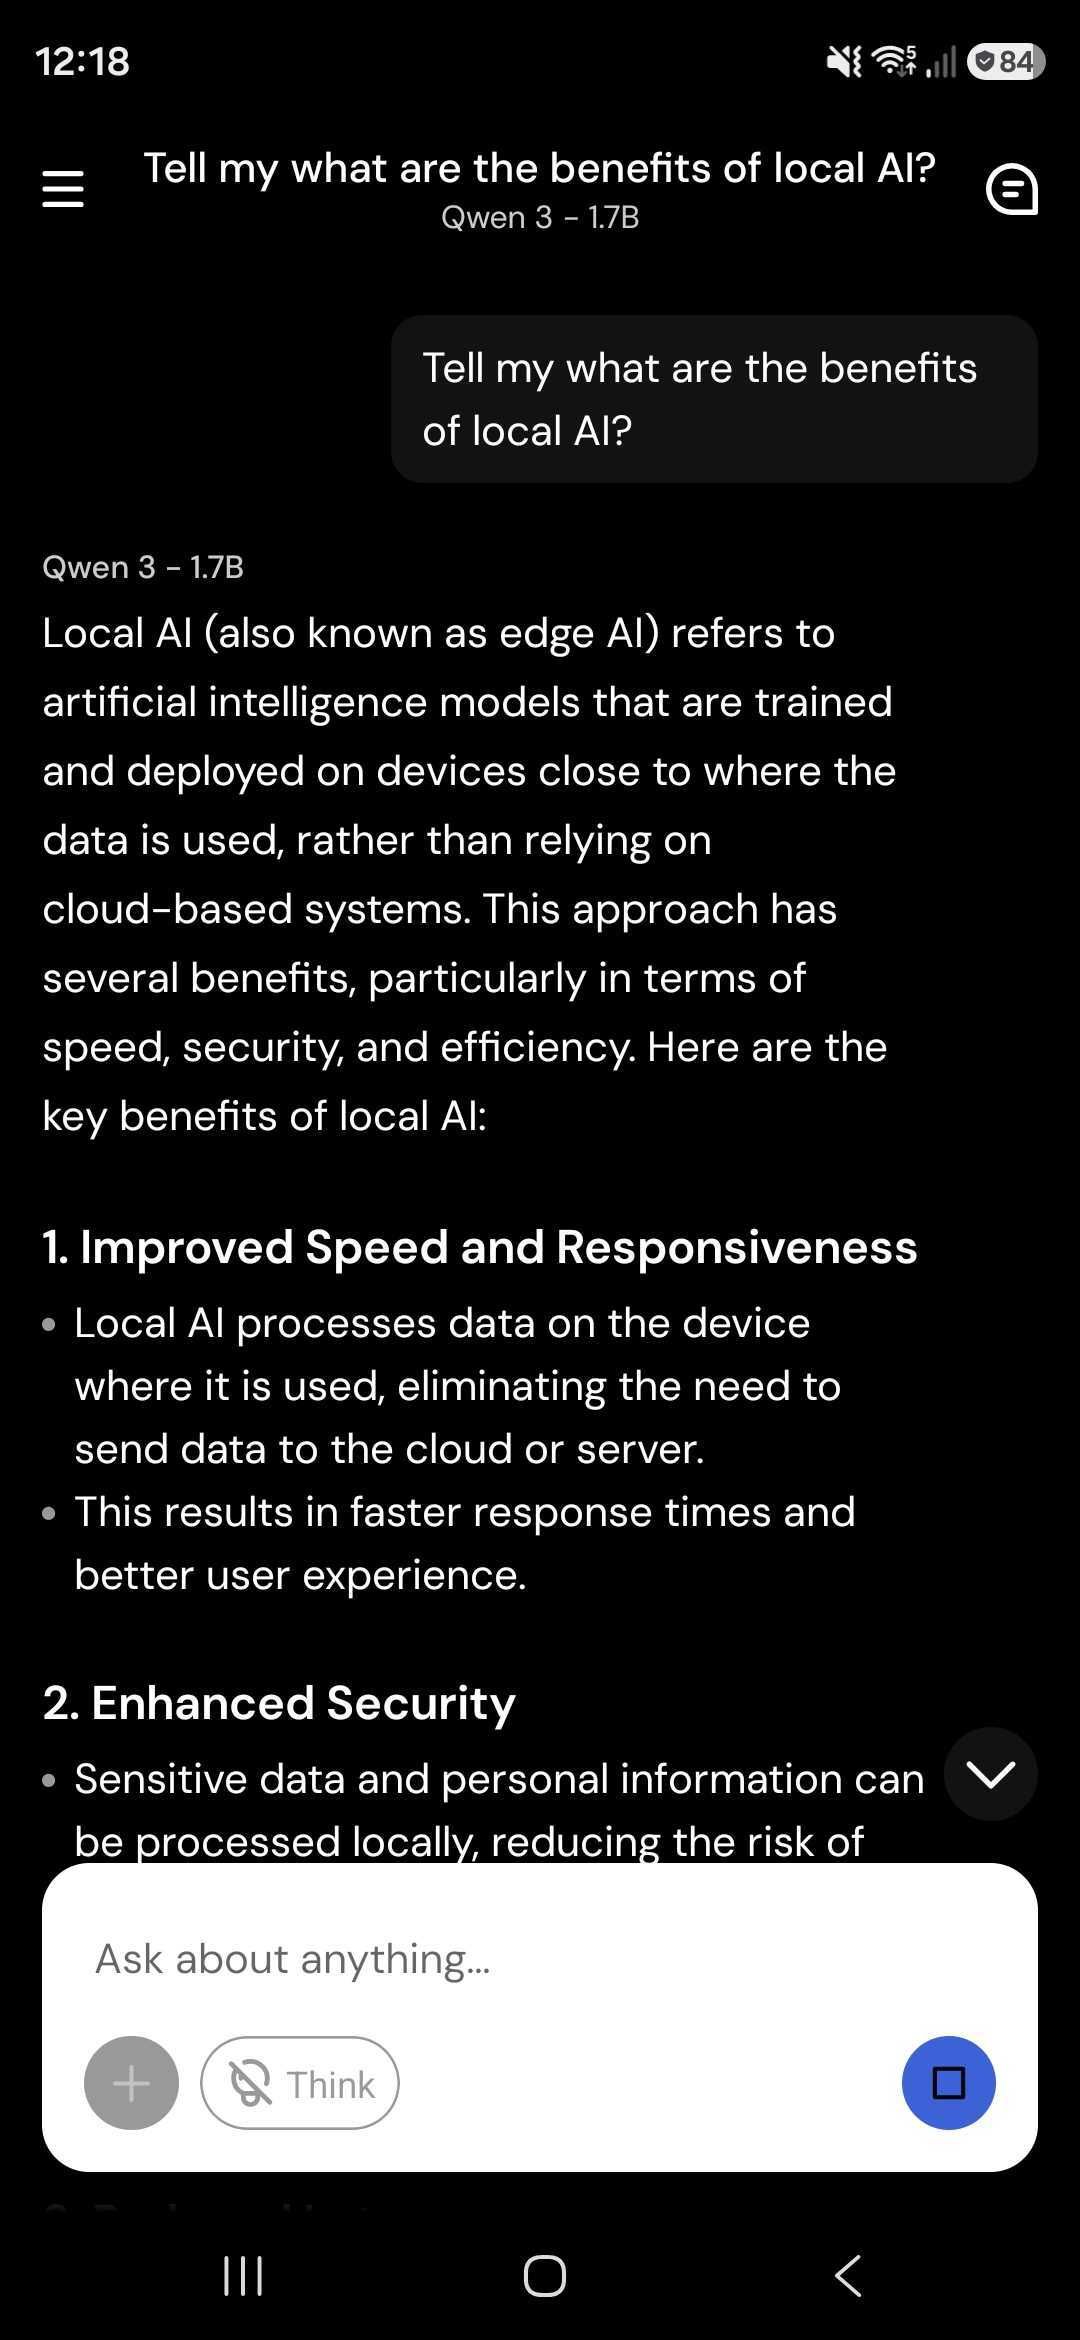
提一个问题,答案会逐 token 流式返回,完全由运行在手机内存里的模型生成。
对话可以分叉,这样你就能在不丢失原线程的情况下探索另一个方向;提示词预设则可以保存你反复使用的 system prompt。
在你的应用里引入本地 AI 模型
Private Mind 基于 React Native ExecuTorch——这同样是我们在 Software Mansion 打造的技术。它提供了一种声明式的方式,让 AI 模型直接在设备上运行,底层由 ExecuTorch 驱动。ExecuTorch 是 Meta 的框架,能让模型在智能手机、微控制器这类设备上执行。React Native ExecuTorch 把 React Native 和原生平台能力连接起来,使 AI 模型可以在本地以顶尖性能运行——全程不需要深厚的原生开发或机器学习功底。所以,如果你正在开发自己的应用,用 React Native ExecuTorch 实现本地 AI 功能会轻松得多。
如果你身边没有懂 React Native 开发的技术人员,随时可以找我们帮忙。我们是 Software Mansion——一家软件开发咨询公司,React Native 核心贡献者,也是 AI 与多媒体领域的专家。发邮件到 projects@swmansion.com,聊聊我们能在你的项目上帮上什么忙。