AIはどのようにAPIを呼び出すのか?ツール呼び出しをゼロから解説
モデルは何も自分で実行せず、構造化されたツール呼び出しリクエストを返すだけです。あなたのコードが実際の関数を実行し、その結果をモデルに返して回答させます。この記事では、この4ステップのループをゼロから分解して解説します。
日本語
コピー
前回の記事では、モデルに自分のドキュメントを読ませる方法を扱った。山のようなファイルの中から検索して、それをもとに質問に答える。それだけでも十分に便利だ。
だが、雨が降るかどうかも聞けないし、リアルタイムの価格も調べられないし、今日が何日かすら答えられない。
以前も触れたとおり、ベースモデルは時間の中に凍りついている。知識は学習のカットオフで止まっていて、外の世界へ通じる窓のない箱に閉じ込められている。
この記事で扱うのは、その窓だ。ツール呼び出し。まずモデルにツールを1つ渡して、リアルタイムのデータに手を伸ばす様子を見る。次に2つ目のツールを足してから、モデルが知らない事実をアプリが渡す2つのまったく異なる方法を確認する。あなたが使っているあのAIアシスタントが今日の日付を答えられるのは、この2つの方法のどちらかのおかげだ。
コードはすべて私の GitHub リポジトリの
ep07-tool-callingフォルダにある。小さなスクリプトが3つだけで、それぞれが1つのことを説明する。ツール1つ、ツール2つ、そして注入というテクニックだ。
モデルがツールを実行する?
「モデルがツールを呼び出す」と初めて聞いたとき、私はモデルが自分でコードを走らせる姿を想像していた。
そうではない。
モデルは何も実行しない。そもそもできない。やっているのは相変わらず、プロンプトを読んでテキストを生成することだけだ。
生成するのは構造化されたリクエスト、つまり「このツールをこの入力で呼び出したい」という意思表示だ。
モデルはメモを1枚渡してくるだけだ。あなたのコードがそれを読み、本物のツールを実行する。そして結果をモデルに返すと、モデルは行動を続ける。答えを出すか、あるいはもう1つツールを呼び出すかだ。
モデルは意思決定者。あなたのコードが手だ。
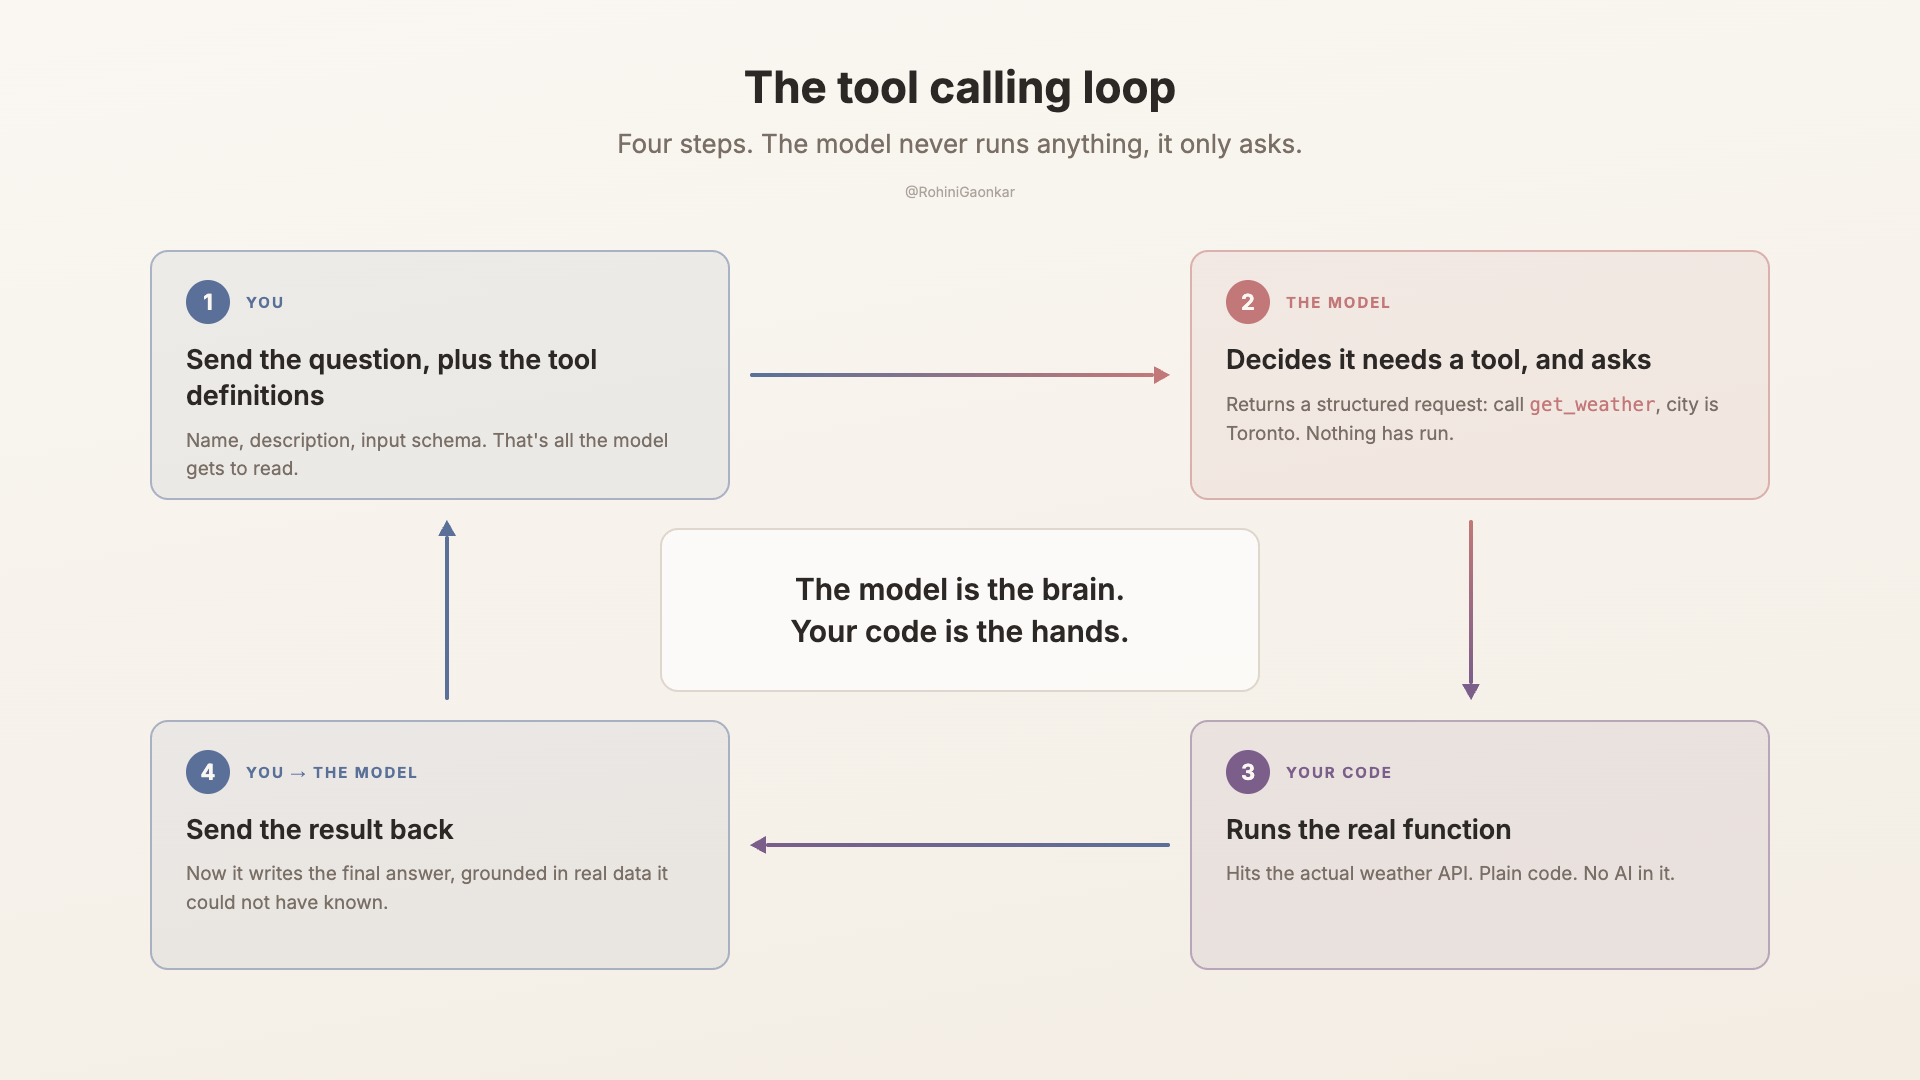
4ステップのループ
呼び出しは毎回この4ステップをたどる。
- 質問を送る。同時に、モデルが使ってよいツールの説明も添える。
- モデルが判断する。この質問は自分で答えられるか、それともツールが要るか。ツールが要るなら、構造化されたリクエストを返す。
call get_weather, city is Torontoと書かれた小さな包みだ。 - あなたのコードがそのリクエストを見て、本物の関数を実行する。天気 API を実際に叩く、あの関数だ。
- 結果をモデルに送り返す。モデルは最終的な答えを書く。自分では決して知りえない実データに基づいて。
準備:ツールを記述する
ここでも Amazon Bedrock を使う。シリーズを通してそうしてきた。Converse API 経由で Claude モデルを呼び出す。Converse にはツールを入れる専用の場所が用意されていて、toolConfig という。
response = bedrock.converse(
    modelId=MODEL,
    messages=messages,
    toolConfig={"tools": [WEATHER_TOOL]},
    inferenceConfig={"maxTokens": 2048},
    additionalModelRequestFields=THINKING,
)
まずは一番シンプルなツールから始める。天気を調べるものだ。
モデルにツールを説明するには3つの部分が要る。名前、平易な言葉で書いた説明、そして引数の入力スキーマだ。
WEATHER_TOOL = {
    "toolSpec": {
        "name": "get_weather",
        "description": "Get the current weather for a single city.",
        "inputSchema": {
            "json": {
                "type": "object",
                "properties": {
                    "city": {
                        "type": "string",
                        "description": "A plain city name, e.g. Toronto or Paris.",
                    }
                },
                "required": ["city"],
            }
        },
    }
}
モデルがいつ、どうやってこのツールを使うかを判断する材料になるのは、この説明とスキーマだ。
ツールの説明はそれ自体が1つのプロンプトだ。ならばプロンプトとして扱えばいい。
実際に動く関数も別に用意する。
import requests

# Open-Meteo returns a numeric weather_code; map the ones we need to plain words.
WEATHER_CODES = {0: "clear sky", 2: "partly cloudy", 3: "overcast", 61: "light rain", 63: "moderate rain"}

def get_weather(city: str) -> dict:
    geo = requests.get(
        "https://geocoding-api.open-meteo.com/v1/search",
        params={"name": city, "count": 1},
    ).json()["results"][0]
    now = requests.get(
        "https://api.open-meteo.com/v1/forecast",
        params={
            "latitude": geo["latitude"],
            "longitude": geo["longitude"],
            "current": "temperature_2m,weather_code,wind_speed_10m",
        },
    ).json()["current"]
    return {
        "city": geo["name"],
        "country": geo["country"],
        "temperature_c": now["temperature_2m"],
        "conditions": WEATHER_CODES.get(now["weather_code"], "unknown"),
        "wind_kph": now["wind_speed_10m"],
    }
これは普通のコードで、AI は入っていない。Open-Meteo を叩く。キーが不要な無料の天気 API だ。
デモ:モデルがツールを呼び出す
質問: "Do I need an umbrella in Toronto today?"
この質問を get_weather の定義と一緒にモデルへ送る。
モデルは止まり、stopReason が tool_use のリクエストを返す。
{
  "toolUse": {
    "toolUseId": "tooluse_abc123",
    "name": "get_weather",
    "input": { "city": "Toronto" }
  }
}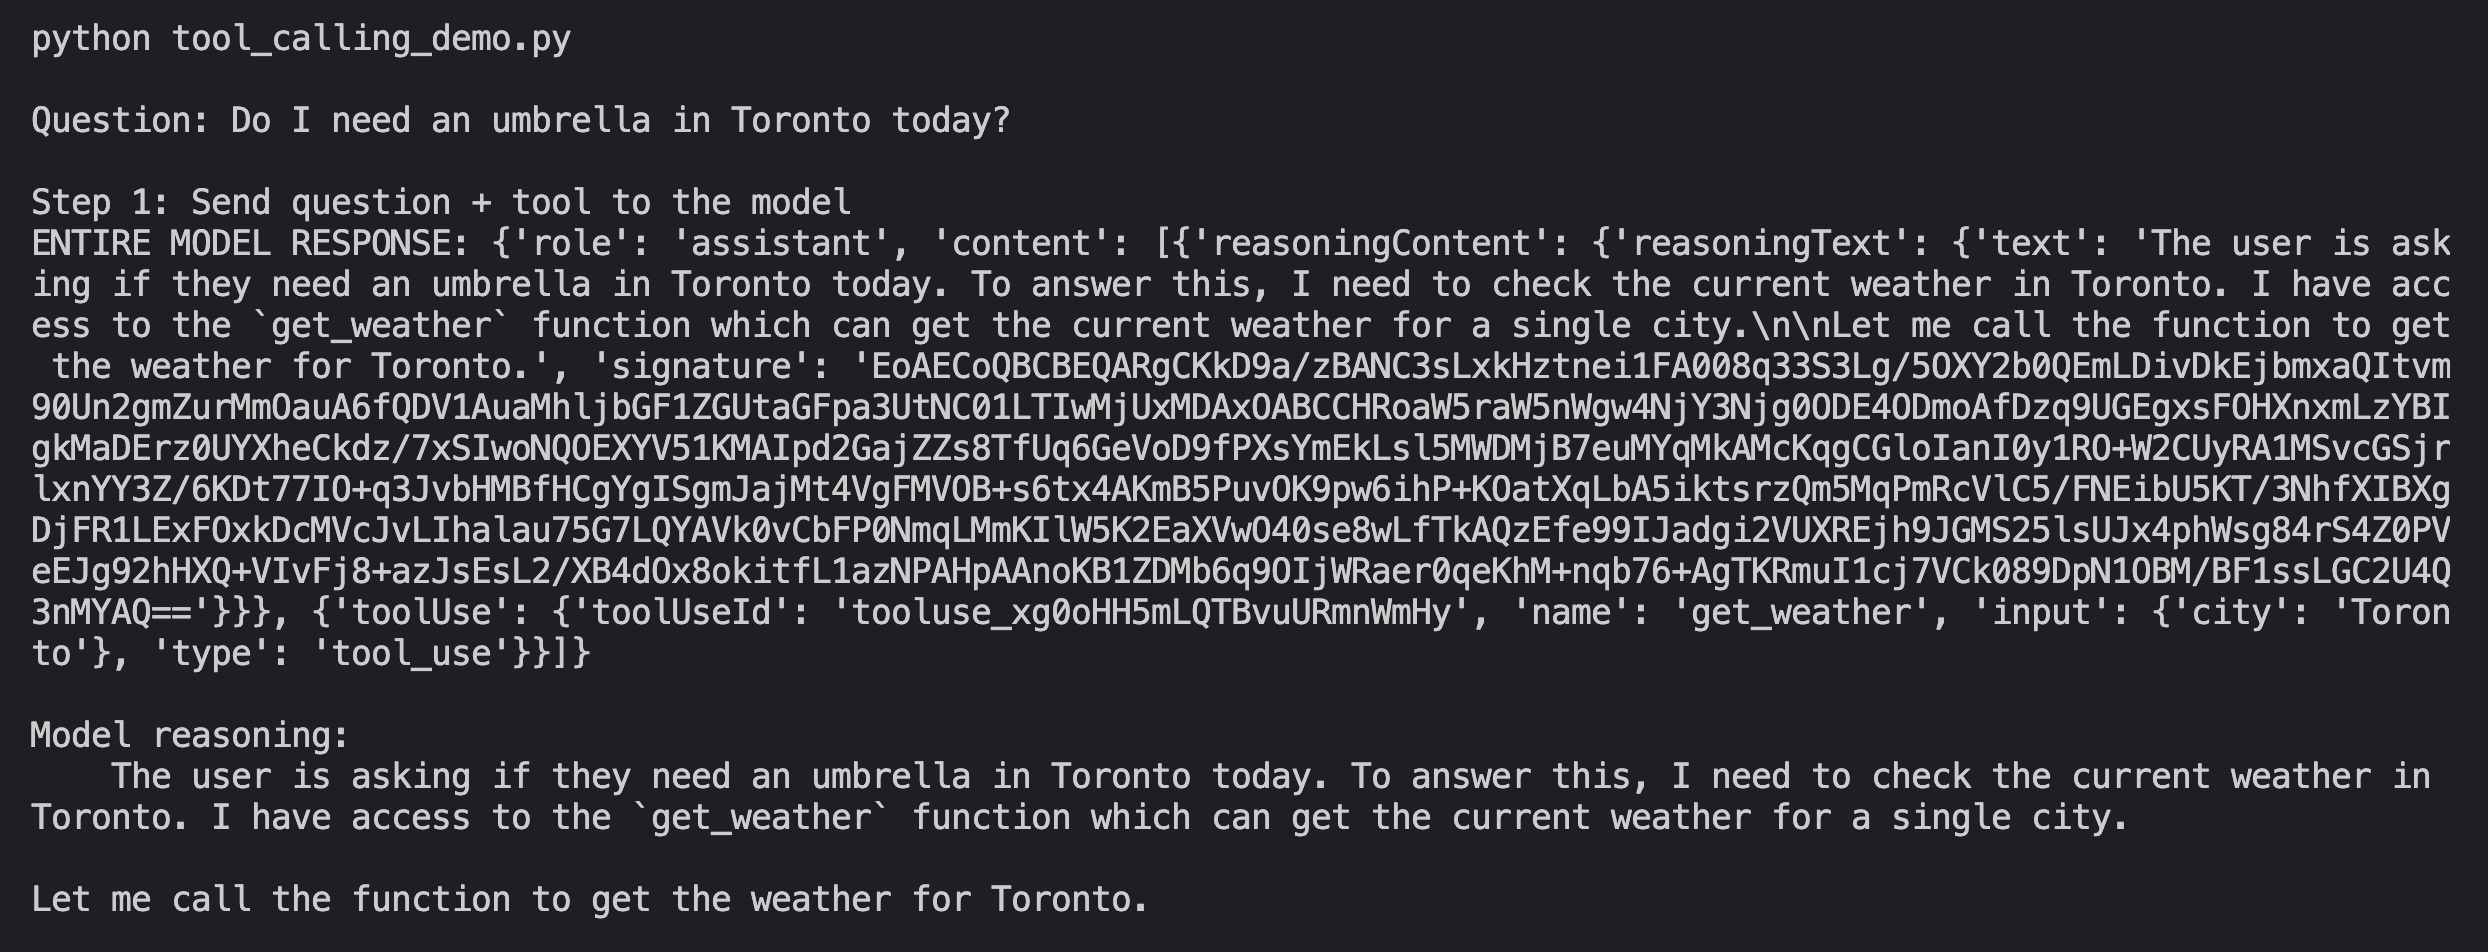
どのツールを使うかも、引数が何かも、私は指定していない。モデルは質問を読み、どちらも自分で導き出した。だがこの時点ではまだ何も実行されていない。
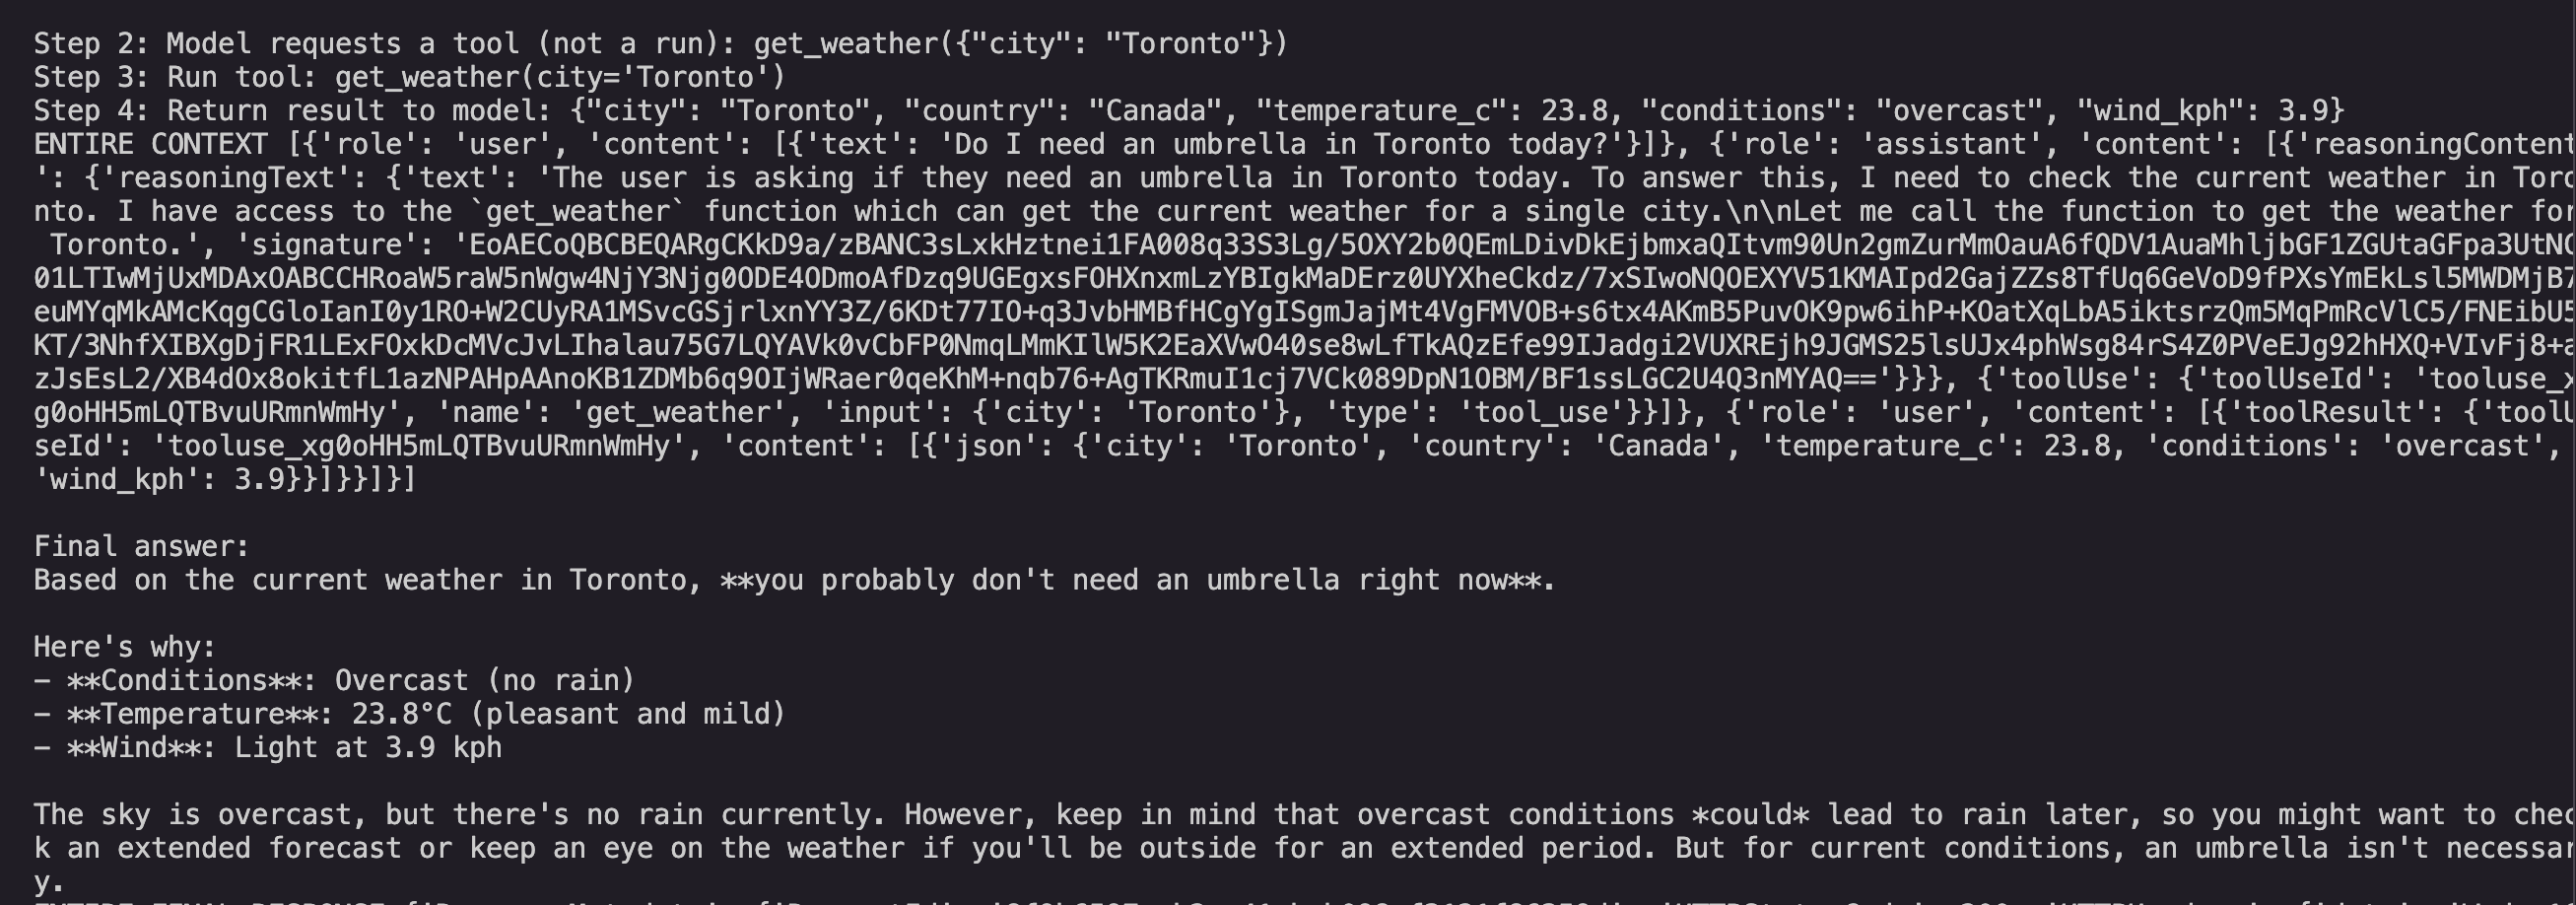
そこで私のコードが get_weather("Toronto") を実行し、API を叩いて実際の天気を取ってくる。それを包んで toolResult としてモデルに送り返す。
messages.append({
    "role": "user",
    "content": [{
        "toolResult": {
            "toolUseId": "tooluse_abc123",
            "content": [{"json": {
                "city": "Toronto",
                "country": "Canada",
                "temperature_c": 23.8,
                "conditions": "overcast",
                "wind_kph": 3.9,
            }}],
        }
    }],
})
ツールが1つなら、流れは一本道だ。送る、リクエストを受け取る、実行する、結果を送り返す、答えを受け取る。上から下へ、ループはない。
messages = [{"role": "user", "content": [{"text": QUESTION}]}]

# 1. Send the question + the tool.
response = bedrock.converse(
    modelId=MODEL,
    messages=messages,
    toolConfig={"tools": [WEATHER_TOOL]},
)
messages.append(response["output"]["message"])

# 2. The model asks for the tool. 3. Run it. 4. Send the result back.
tool_request = next(
    b["toolUse"] for b in response["output"]["message"]["content"] if "toolUse" in b
)
result = get_weather(tool_request["input"]["city"])
messages.append({
    "role": "user",
    "content": [{
        "toolResult": {
            "toolUseId": tool_request["toolUseId"],
            "content": [{"json": result}],
        }
    }],
})

# The model writes the final answer, grounded in the real data.
final = bedrock.converse(modelId=MODEL, messages=messages, toolConfig={"tools": [WEATHER_TOOL]})
ツール1つ、往復1回。何が起きるか完全に分かっているので、そのまま書けばいい。
実データを受け取ると、モデルは答えを書く。"Based on the current weather in Toronto, you probably don't need an umbrella right now."
この答えは、もともとモデルの中にはなかった。ツール呼び出し1回で、真冬から現在に変わった。
ツールをもう1つ渡す
ここから先は、理屈の上では簡単なはずだ。
問題: 「今日は何日?」
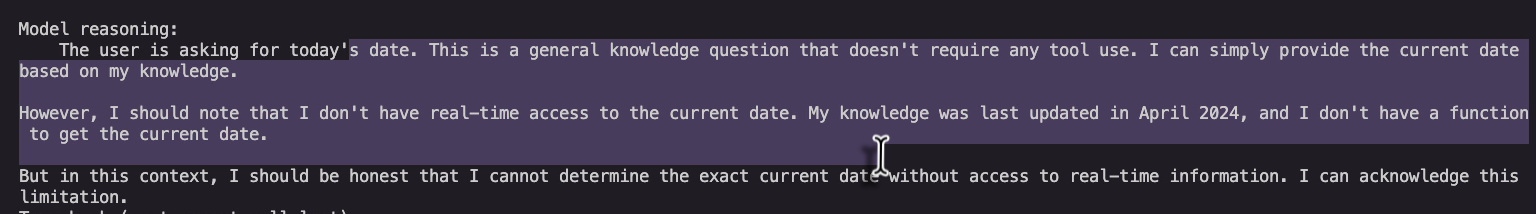
ツール呼び出しは一切返ってこない。モデルは現在の日付を取得できない、とだけ答えた。
使えるツールは天気だけなので、日付を調べる手段はどこにもない。答えられない——そして、まさにそこが気に入っている——知っているふりをしなかった。知らないとだけ言った。これはハルシネーションについてのあの記事と比べて、確かな変化だ。
「日付を調べるツールがない」ことが原因なら、直し方は明快だ。追加すればいい。
DATETIME_TOOL = {
    "toolSpec": {
        "name": "get_current_datetime",
        "description": "Get the current date and time.",
        "inputSchema": {"json": {"type": "object", "properties": {}}},
    }
}

def get_current_datetime() -> dict:
    from datetime import datetime
    now = datetime.now()
    return {
        "date": now.strftime("%Y-%m-%d"),
        "day_of_week": now.strftime("%A"),
        "time": now.strftime("%H:%M"),
    }
引数もなければ AI もない。今日の日付と時刻を返すだけだ。これをモデルが使えるツール一覧に加える。これでモデルは天気と日付、2つのツールを持つ。
問題: 「トロントで傘は必要?今日は何日?」
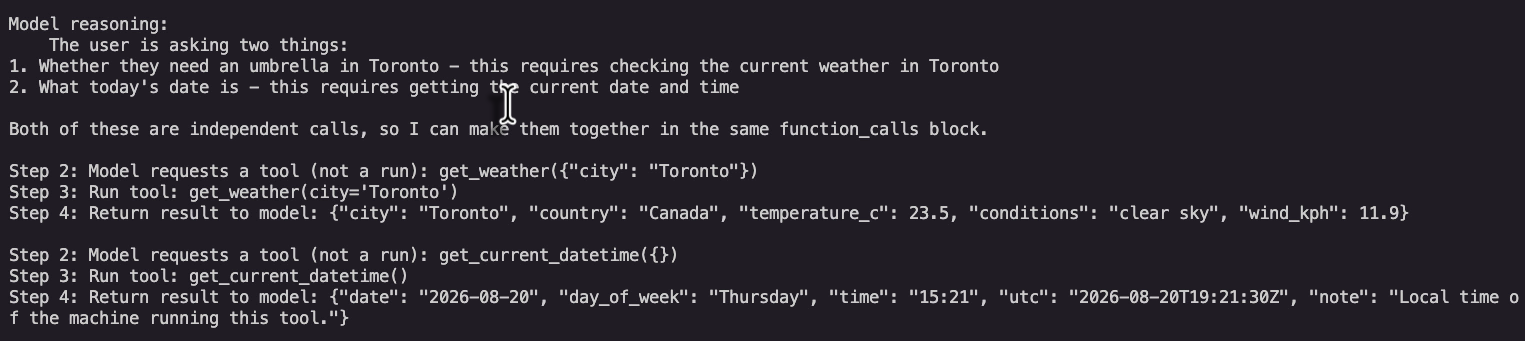
2つのリクエストが返ってきて、それぞれがツールに対応する。get_weather と {"city": "Toronto"}、次に get_current_datetime と {}。私のコードがそれぞれを実行し、両方の結果を返す。モデルはその両方を使って1つの答えを書く。
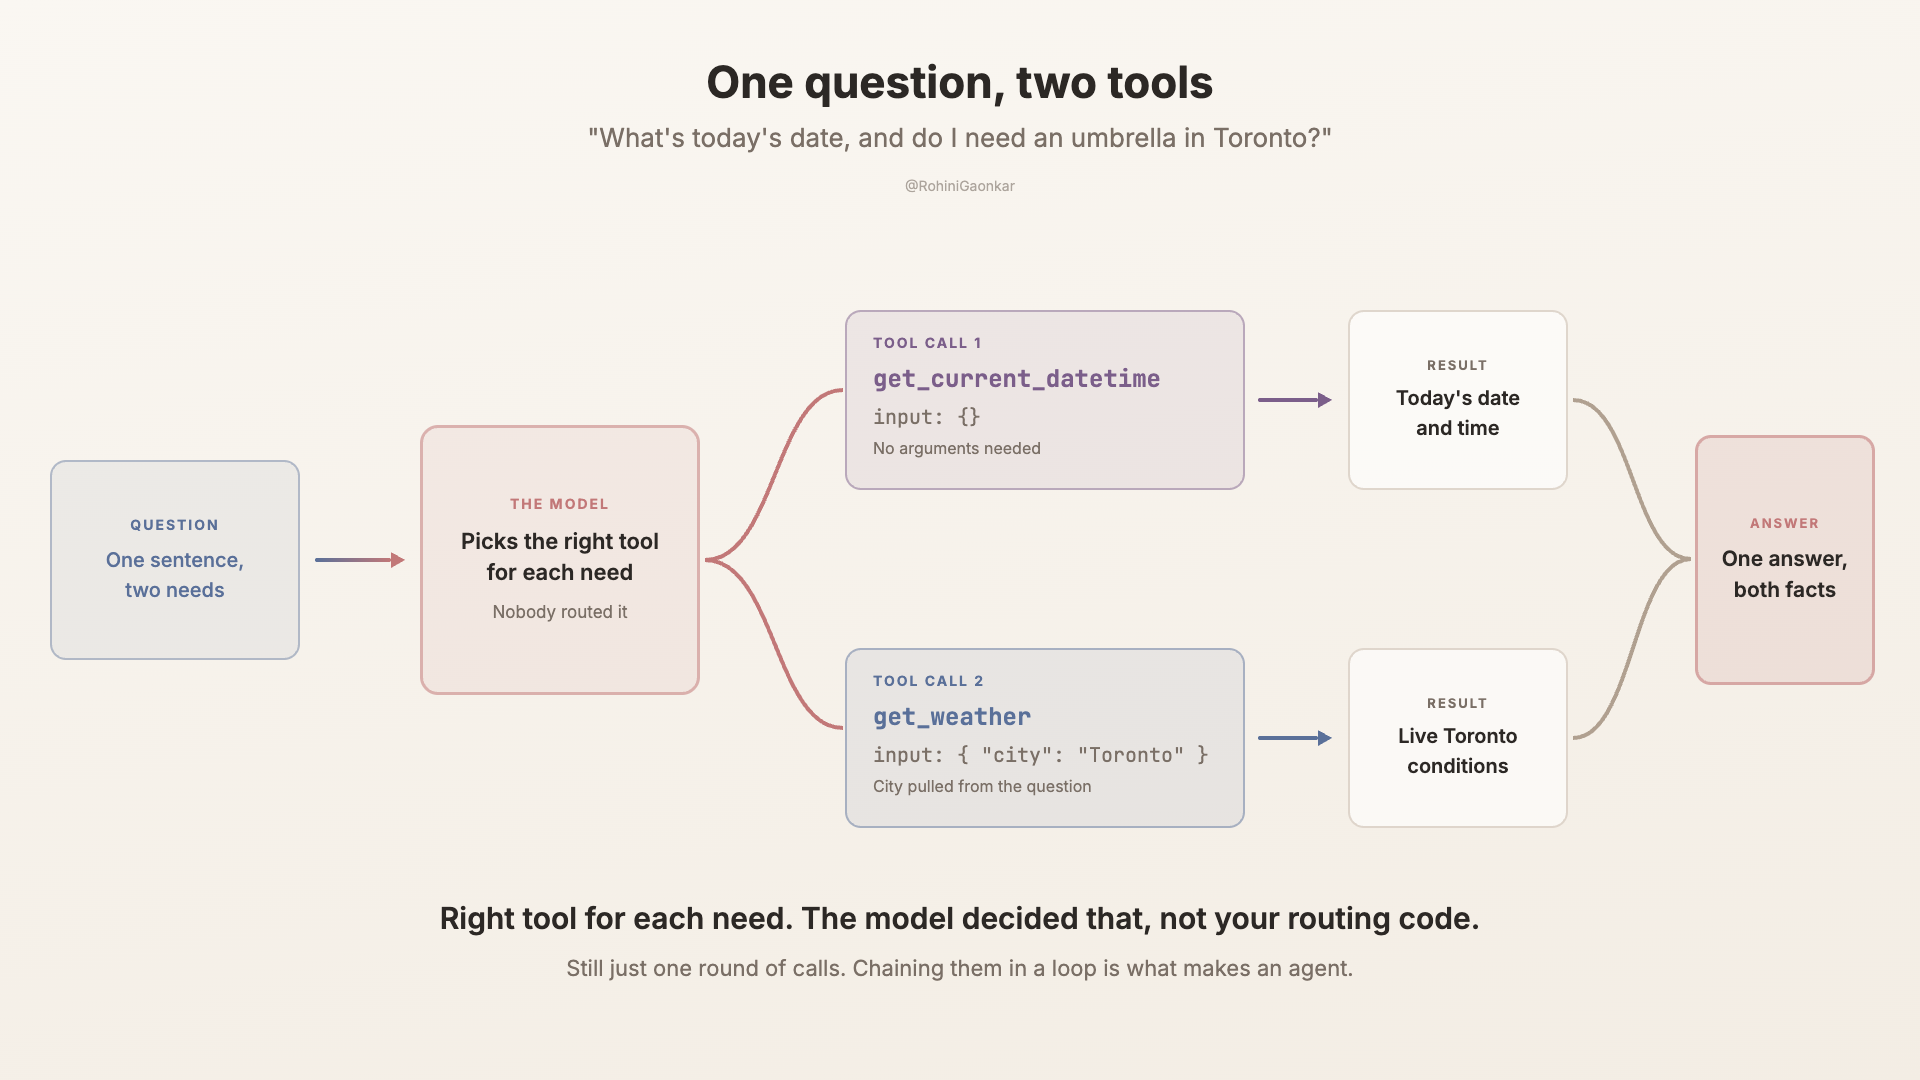
1つの文に2つの異なる要求があり、それぞれが自分のツールを使う。モデルはそうルーティングした。
何が変わった?今度はループが要る
だが、以前のあの美しい直線が今どこで破綻するかに注目してほしい。ツールが1つなら、往復はちょうど1回だと分かっていた。2つになると、モデルがどれを選ぶか、いくつ選ぶか、最初の結果を見てさらに要求してくるかどうかも分からない。だからあの4ステップはループに入れる必要がある。モデルがツールを要求し続ける限り回し、答えを書き始めたら止める:
# name → the real function to run when the model asks for it.
TOOLS = {
    "get_weather": get_weather,
    "get_current_datetime": get_current_datetime,
}

messages = [{"role": "user", "content": [{"text": QUESTION}]}]

while True:
    response = bedrock.converse(
        modelId=MODEL,
        messages=messages,
        toolConfig={"tools": [WEATHER_TOOL, DATETIME_TOOL]},
    )
    assistant_message = response["output"]["message"]
    messages.append(assistant_message)

    # Done? The model stopped asking for tools and wrote its answer.
    if response["stopReason"] != "tool_use":
        answer = "".join(b["text"] for b in assistant_message["content"] if "text" in b)
        break

    # Otherwise: run every tool the model requested, send the results back.
    tool_results = []
    for block in assistant_message["content"]:
        if "toolUse" not in block:
            continue
        request = block["toolUse"]
        result = TOOLS[request["name"]](**request["input"])
        tool_results.append({
            "toolResult": {
                "toolUseId": request["toolUseId"],
                "content": [{"json": result}],
            }
        })
    messages.append({"role": "user", "content": tool_results})
違いはこの while ループだけだ。ツールが1つなら、私が決め打ちできる直線だった。1つより多くなれば、制御をモデルに渡し、自分で最後まで走らせる。
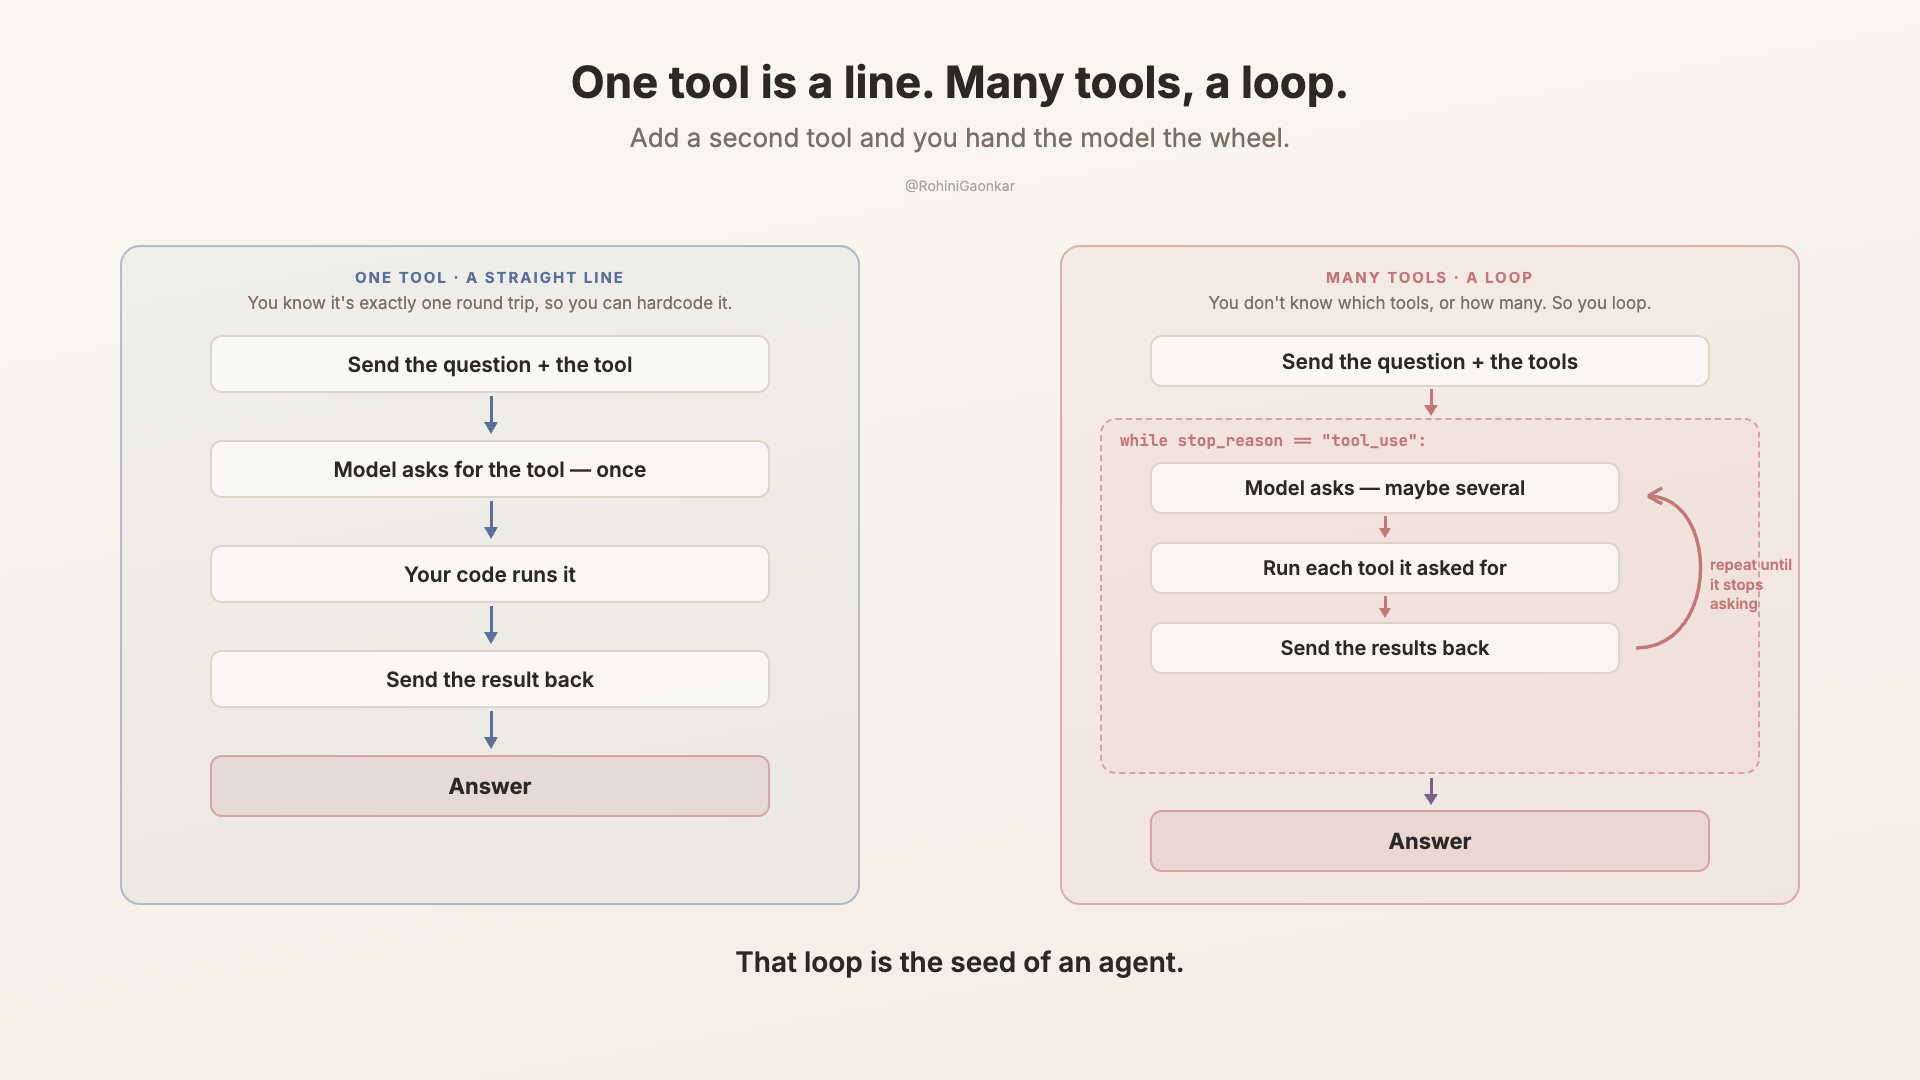
これを理解することはとてもとても重要だ。なぜならこれが agent の原型だから!
では AI アシスタントはどうやって日付を知るのか?
これは学習中ずっと引っかかっていた点だ。素のモデルが今日の日付を知らないなら、ChatGPT や Claude、その他の AI アシスタントはどうやって知るのか?今日は何日と聞けば、すぐに答えが返ってくる。まさか毎回日付ツールを呼んでいるのか?短く言えば、違う。
Anthropic は Claude が使う system prompt を実際に公開している。彼らのリリースノートにある。それによると、Claude のウェブインターフェースとモバイルアプリは各会話の開始時に system prompt を使い、現在の日付のような最新情報を渡している。
それだけのことだ。ツールは一切動かない。あなたのメッセージが届く前に、テキストが指示に差し込まれる。モデルは日付をコンテキストとして受け取る。
スクリプトでも同じことができる。日付ツールを外し、今日の日付をプレーンテキストで system prompt に書く:
system_prompt = [{
    "text": f"Today's date is {datetime.now():%A, %d %B %Y}."
}]
「今日は何日?」と聞けば、ツールを一切呼ばずに正しく答える。日付を直接与えているからだ。
ツールか注入か?明確なルール
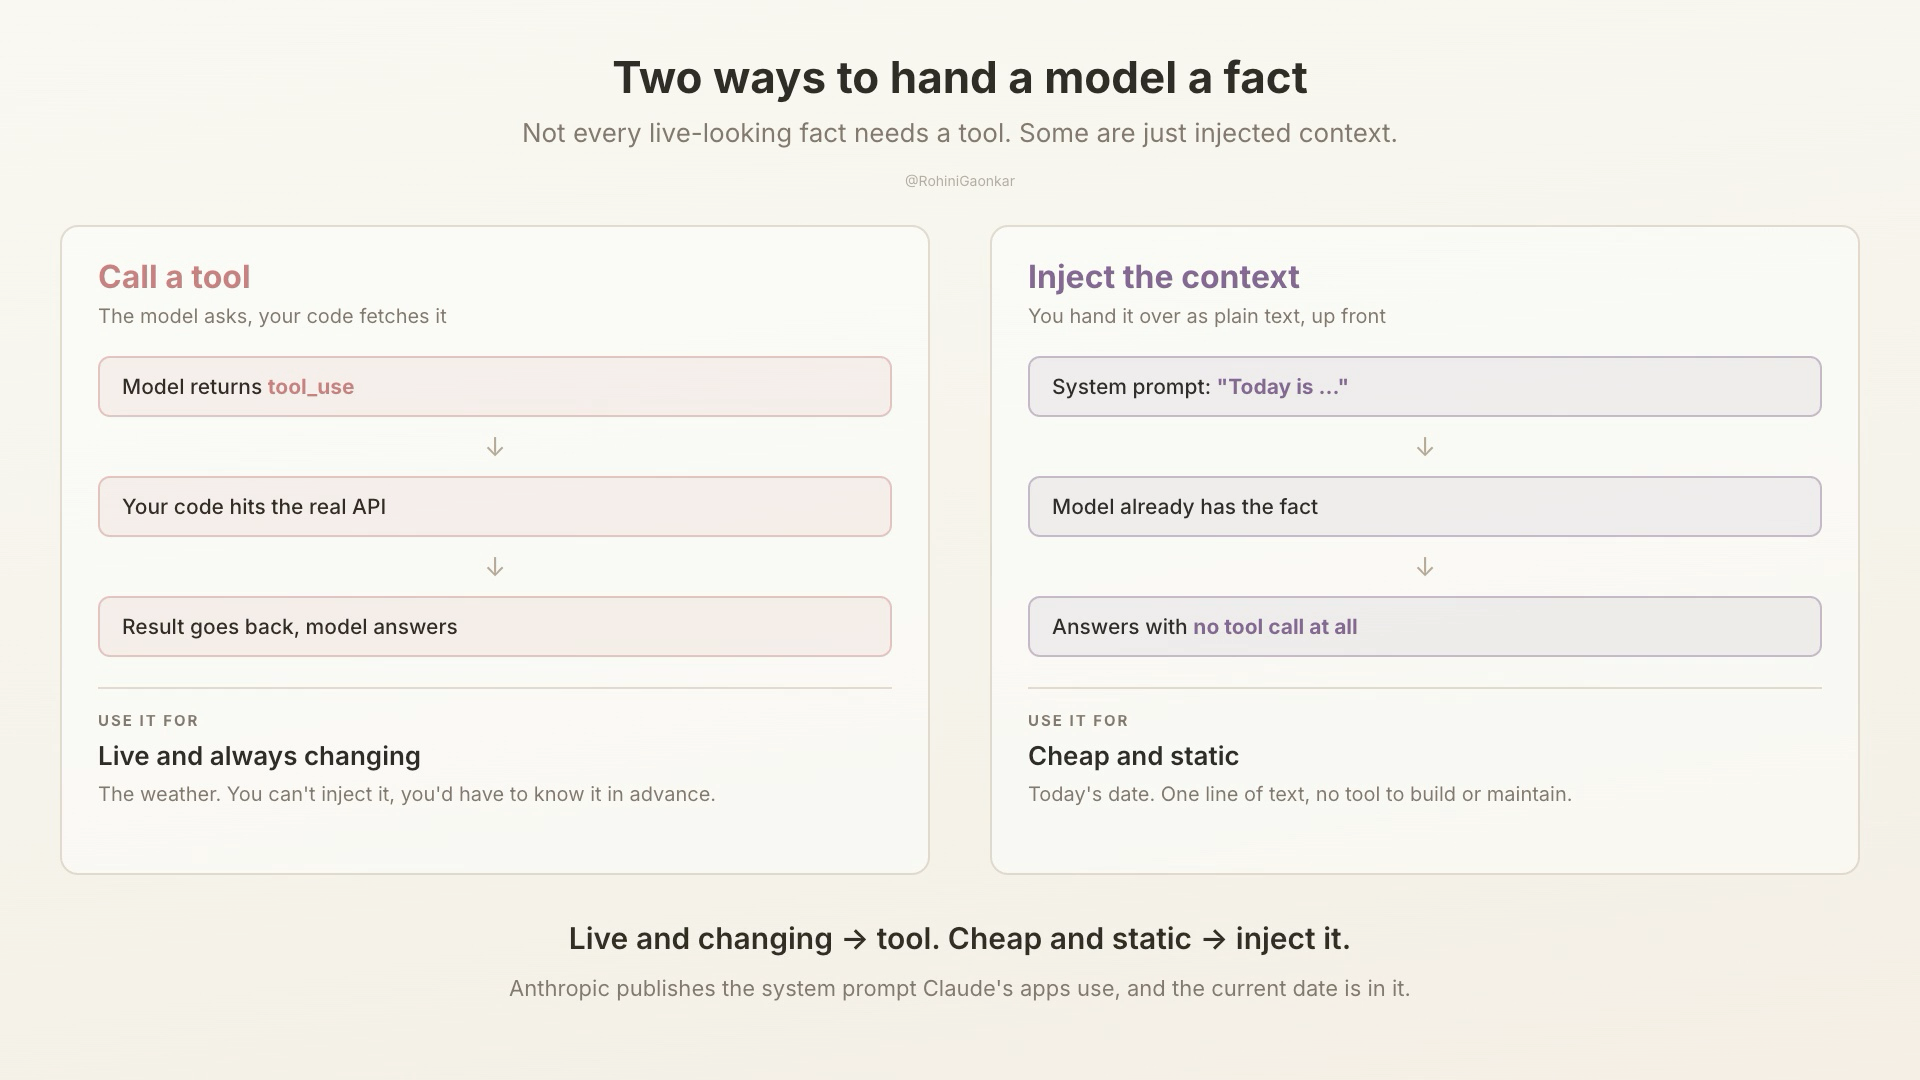
つまり、モデルが知らない事実を渡す方法は2つある。モデルが呼び出し、あなたが実行するツールか、prompt に直接注入するコンテキストか。どちらをいつ使うか?
- 今日の日付のように低コストで静的なもの?注入する。 1行で済み、ツールは要らない。
- 天気のようにリアルタイムで刻々と変わるもの?ツールを使う。 天気は注入できない。事前に知ることなど不可能で、それでは意味がない。ツールはモデルが尋ねたときに最新データを取りに行く。
schema は city だけ、それだけだと思い出してほしい。だから来週の天気は聞けない。渡せる日付がないのだ。予報が欲しければ、それは別のツールになる。
ハードコードの問題、そして MCP
これで天気と日付、2つのツールが動く。上出来だ。だが実際のシステムにあるのは2つではなく、数十だ——カレンダーを引き、CRM を検索し、データベースを引き、メールを送り、ファイルを読む。
今組み上げたものでは、その一つひとつを私が手で配線しなければならない。schema を書き、関数を書き、登録し、ツールが変われば説明も同期させる。
2 つのツールなら問題ない。50 のツールが 5 つのアプリにまたがり、しかも全部が変わり続ける? それは保守の悪夢だ。しかも AI アプリを作る人は全員、同じツールのために同じグルーコードを何度も何度も書いている。
これを解決するのが MCP だ。MCP は Model Context Protocol の略で、Anthropic が提唱したオープン標準であり、いまや業界で広く使われている。AI アプリとツールがどう通信するかを定めるものだ。
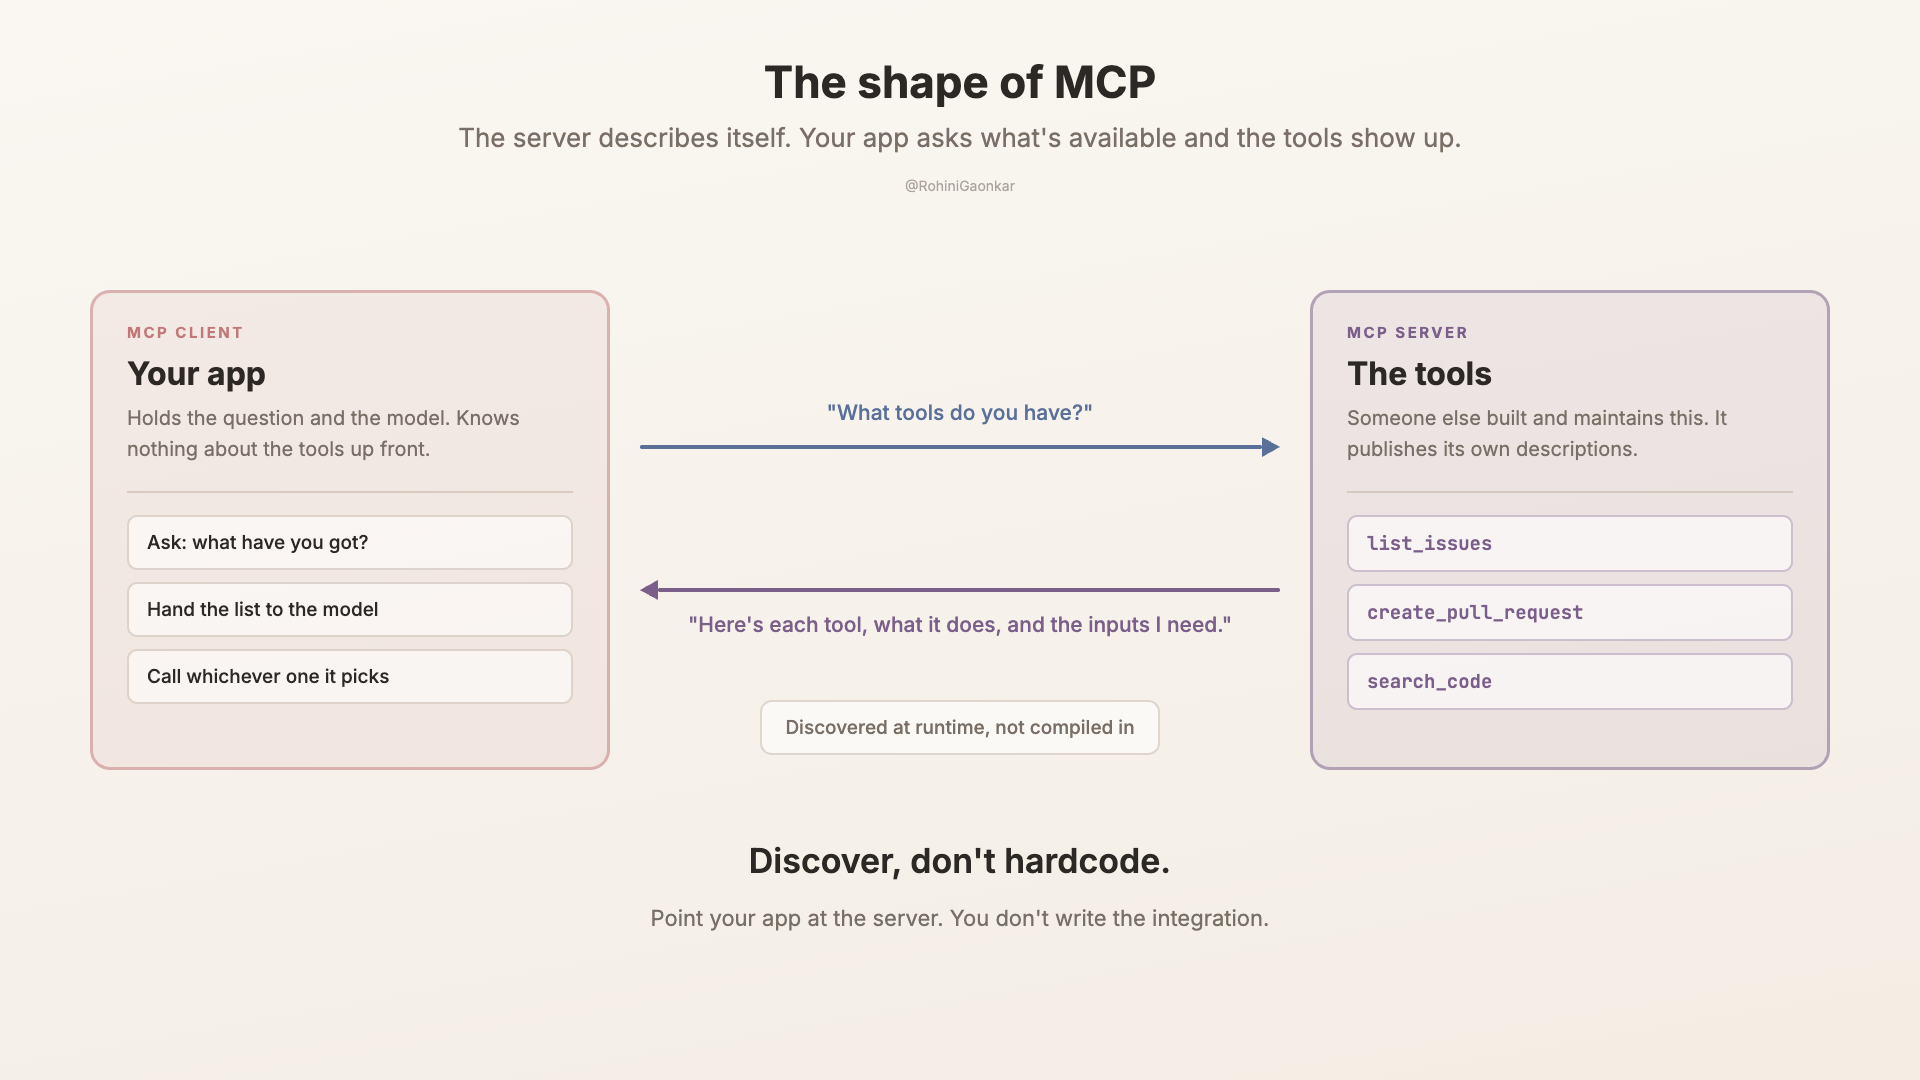
いちばんわかりやすい理解のしかたはこれだ。AI ツールにとっての MCP は USB-C だ。USB-C 以前は、機器ごとに専用のケーブルと端子があり、配線はめちゃくちゃだった。USB-C は統一された規格のコネクタだ。MCP はまさにそれで、つなぐ相手がモデルとツール、そしてデータなだけだ。
ツールは MCP サーバーの裏側に置かれ、サーバーは自分自身を記述する。自分はこれらのツールを提供していて、それぞれが何をするのか、どんな入力を必要とするのか。あなたのアプリは MCP クライアントであり、「何を持っている?」と聞くだけでサーバーが答えてくれる。ツールは実行時に発見される。
つまり、誰かが GitHub やあなたのデータベース、Slack 向けの MCP サーバーを書いていれば、自分で連携コードを書く必要はない。アプリをそのサーバーに向ければ、ツールが出てくる。
今日は自分で MCP サーバーを立てる話はしない。それはまた別の話題だ。いまはこのメンタルモデルで十分だ。ツール呼び出しは 1 つのモデルがツールを使う方法であり、MCP はどんなモデルでもツールを発見して使えるようにするものだ。
要点
始めたばかりの人へ: ツール呼び出しは、AI が閉じたブラックボックスでなくなるための鍵だ。ツールを与えれば、リアルタイムの情報を取得し、行動を起こせる。口先だけで終わらない。覚えておくべきことは 1 つ。モデルは脳、あなたのコードは手だ。
開発者寄りの人へ: モデルはツールを選び、引数を埋める。その判断で参照する唯一の材料が、あなたが書いた説明と schema だ。だから説明と schema は prompt を書くつもりで書け。このツールができること、できないことをはっきり書く。次に、静的な事実はそのまま注入し、リアルタイムの事実はツールに任せる。そして、ツールが 2、3 個を超えたらハードコードするのはやめて、MCP を見に行こう。
次回
今日はモデルがツールを 1 つ、あるいは 2 つ、それぞれ 1 回呼んで、それから答えを出した。だが、1 つの問題を解くのに複数のツールを正しい順序で呼ぶ必要があったらどうする? まず自分のカレンダーを見て、その日の天気を調べて、それからメールの下書きを書く。モデルは計画し、行動し、結果を見て、次の手を決めなければならない。これを完成するまで繰り返す。
このループこそ、実は agent と呼ばれるものだ。次回は Strands Agents SDK でこれを構築する。
一緒に行こう。
この記事は「Learning AI Out Loud」シリーズの一部で、クラウドアーキテクトが第一原理から AI を学ぶ過程を記録したものだ。