AI 究竟如何调用 API?从零解释工具调用
模型不会自己执行任何东西,它只回一个结构化的工具调用请求,你的代码去运行真正的函数、再把结果交回去让模型作答;这篇从零把这个四步循环拆开讲。
中文
复制
在上一篇文章里,我们教会了模型读取自己的文档。它能在成堆的文件里检索,并据此回答问题,这已经很有用了。
但我还是没法问它会不会下雨、查一个实时价格,甚至问它今天几号。
因为前面聊过,基础模型本身被冻结在时间里。它的知识止步于训练截止日期,而且被锁在一个盒子里,没有通向外部世界的窗口。
这篇文章讲的就是那扇窗口:工具调用。我们先给模型一个工具,看它伸手去够实时数据,再加第二个工具,然后看一个应用把模型不知道的事实交给它的两种截然不同的方式。你用过的那款 AI 助手之所以能告诉你今天的日期,原因就在这两种方式之中。
所有代码都在我的 GitHub 仓库的
ep07-tool-calling文件夹里。三个很小的脚本,每个只讲一件事:一个工具、两个工具,以及注入这个技巧。
模型会运行工具?
第一次听到“模型调用工具”时,我脑补的是模型自己伸手去跑代码。
事实并非如此。
模型什么都不会运行,因为它确实做不到。它仍然只是在读一段提示词,然后生成文本。
它生成的是一个结构化请求,意思是“我想调用这个工具,输入是这些”。
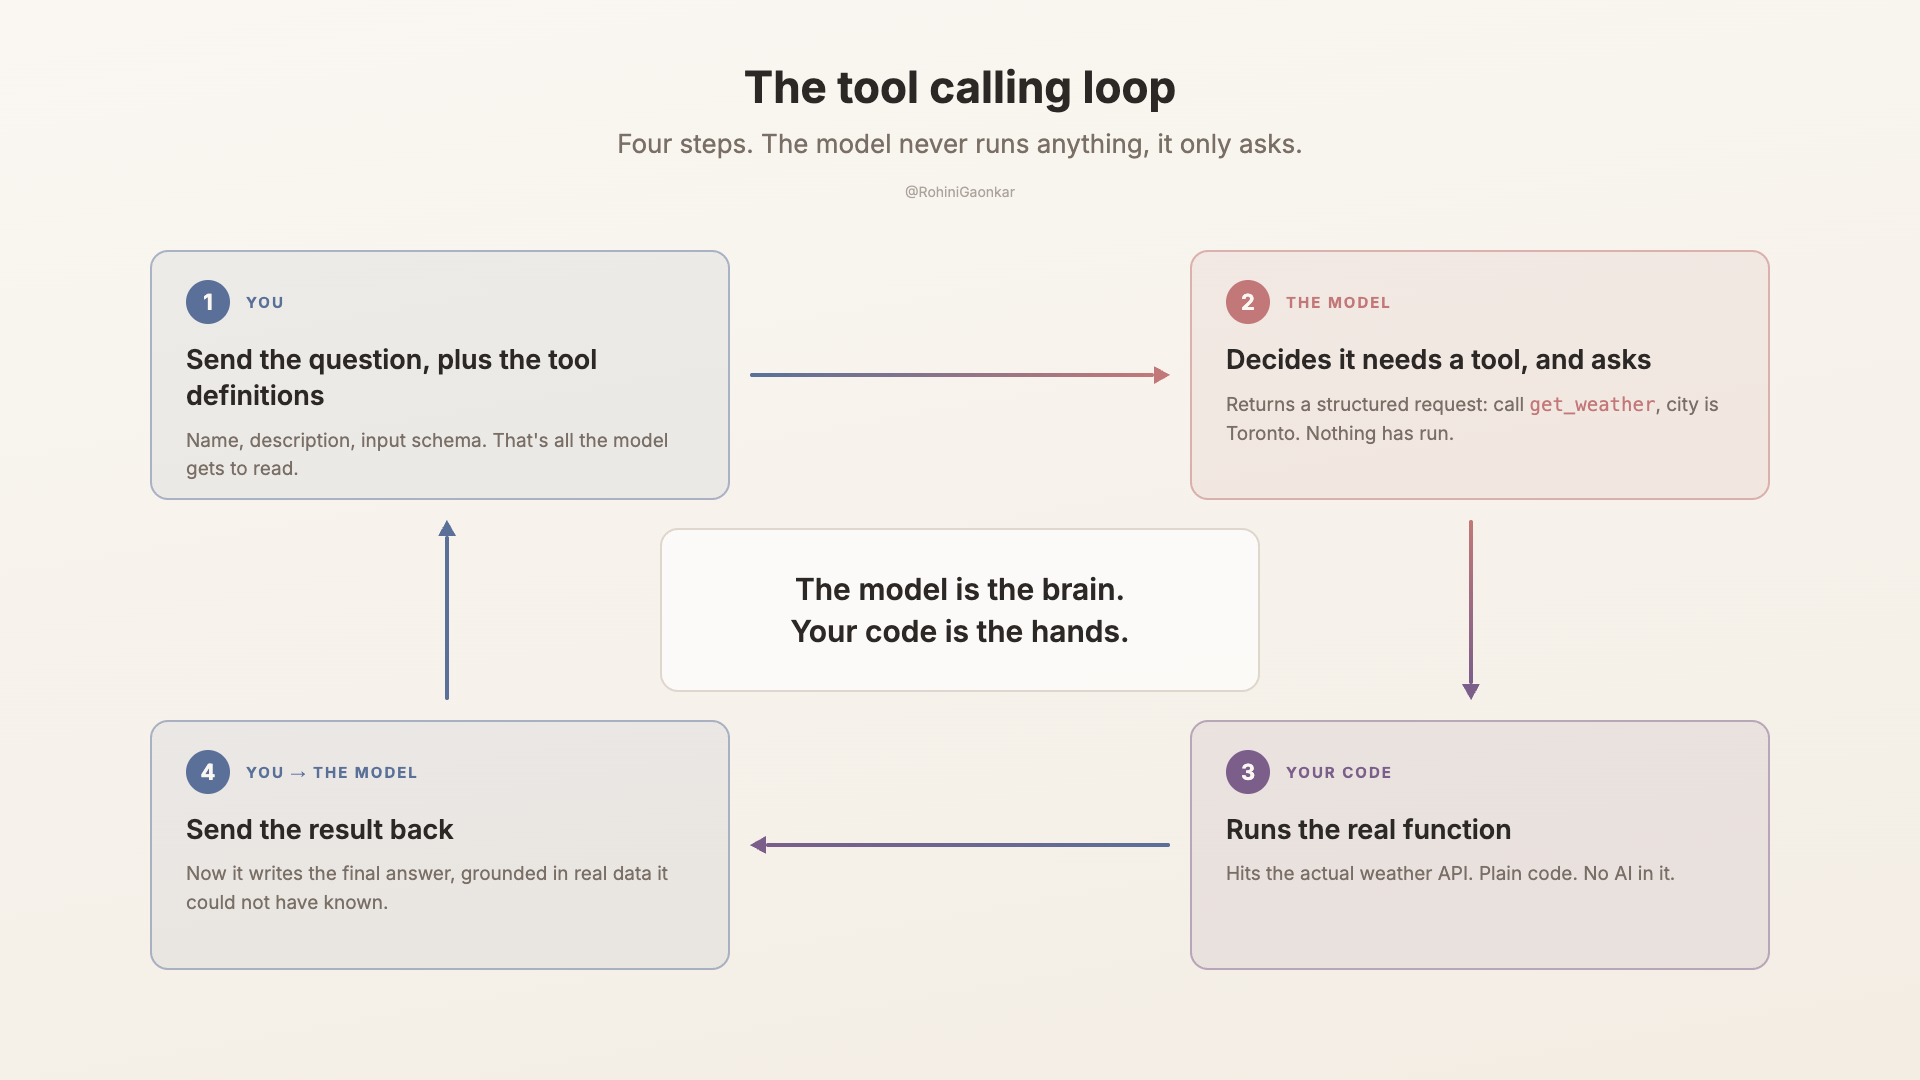
它只是递给你一张便条,你的代码读到它,再去运行真正的工具。然后你把结果交回给模型,让它继续行动——要么告诉你答案,要么再调用一个工具。
模型是决策者。你的代码是手。
四步循环
每一次调用都走这四步:
- 你把问题发给模型,同时附上它被允许使用的工具的描述。
- 模型做判断:这个问题我自己能答,还是需要一个工具?如果需要,它就回复一个结构化请求——一个小包裹,写着
call get_weather, city is Toronto。 - 你的代码看到这个请求,运行真正的函数,也就是那个真正去请求天气 API 的函数。
- 你把结果发回给模型。现在它写出最终答案,依据的是它自己永远不可能知道的真实数据。
准备工作:描述一个工具
我用的还是 Amazon Bedrock,整个系列都是如此,通过 Converse API 调用 Claude 模型。Converse 内置了一个专门放工具的位置,叫做 toolConfig。
response = bedrock.converse(
    modelId=MODEL,
    messages=messages,
    toolConfig={"tools": [WEATHER_TOOL]},
    inferenceConfig={"maxTokens": 2048},
    additionalModelRequestFields=THINKING,
)
先从最简单的工具入手:查天气。
向模型描述一个工具分三部分:名称、一段大白话描述,以及参数输入的 schema。
WEATHER_TOOL = {
    "toolSpec": {
        "name": "get_weather",
        "description": "Get the current weather for a single city.",
        "inputSchema": {
            "json": {
                "type": "object",
                "properties": {
                    "city": {
                        "type": "string",
                        "description": "A plain city name, e.g. Toronto or Paris.",
                    }
                },
                "required": ["city"],
            }
        },
    }
}
模型判断何时使用、如何使用这个工具,靠的就是这段描述和 schema。
工具描述本身就是一条 prompt,那就按 prompt 来对待它。
另外还有一个真正干活的函数:
import requests

# Open-Meteo returns a numeric weather_code; map the ones we need to plain words.
WEATHER_CODES = {0: "clear sky", 2: "partly cloudy", 3: "overcast", 61: "light rain", 63: "moderate rain"}

def get_weather(city: str) -> dict:
    geo = requests.get(
        "https://geocoding-api.open-meteo.com/v1/search",
        params={"name": city, "count": 1},
    ).json()["results"][0]
    now = requests.get(
        "https://api.open-meteo.com/v1/forecast",
        params={
            "latitude": geo["latitude"],
            "longitude": geo["longitude"],
            "current": "temperature_2m,weather_code,wind_speed_10m",
        },
    ).json()["current"]
    return {
        "city": geo["name"],
        "country": geo["country"],
        "temperature_c": now["temperature_2m"],
        "conditions": WEATHER_CODES.get(now["weather_code"], "unknown"),
        "wind_kph": now["wind_speed_10m"],
    }
这是普通代码,里面没有 AI。它请求 Open-Meteo,一个免费的天气 API,不需要 key。
演示:模型调用工具
问题: "Do I need an umbrella in Toronto today?"
我把这个问题连同 get_weather 的定义一起发给模型。
模型停下来,返回 stopReason 为 tool_use,并给出一个请求:
{
  "toolUse": {
    "toolUseId": "tooluse_abc123",
    "name": "get_weather",
    "input": { "city": "Toronto" }
  }
}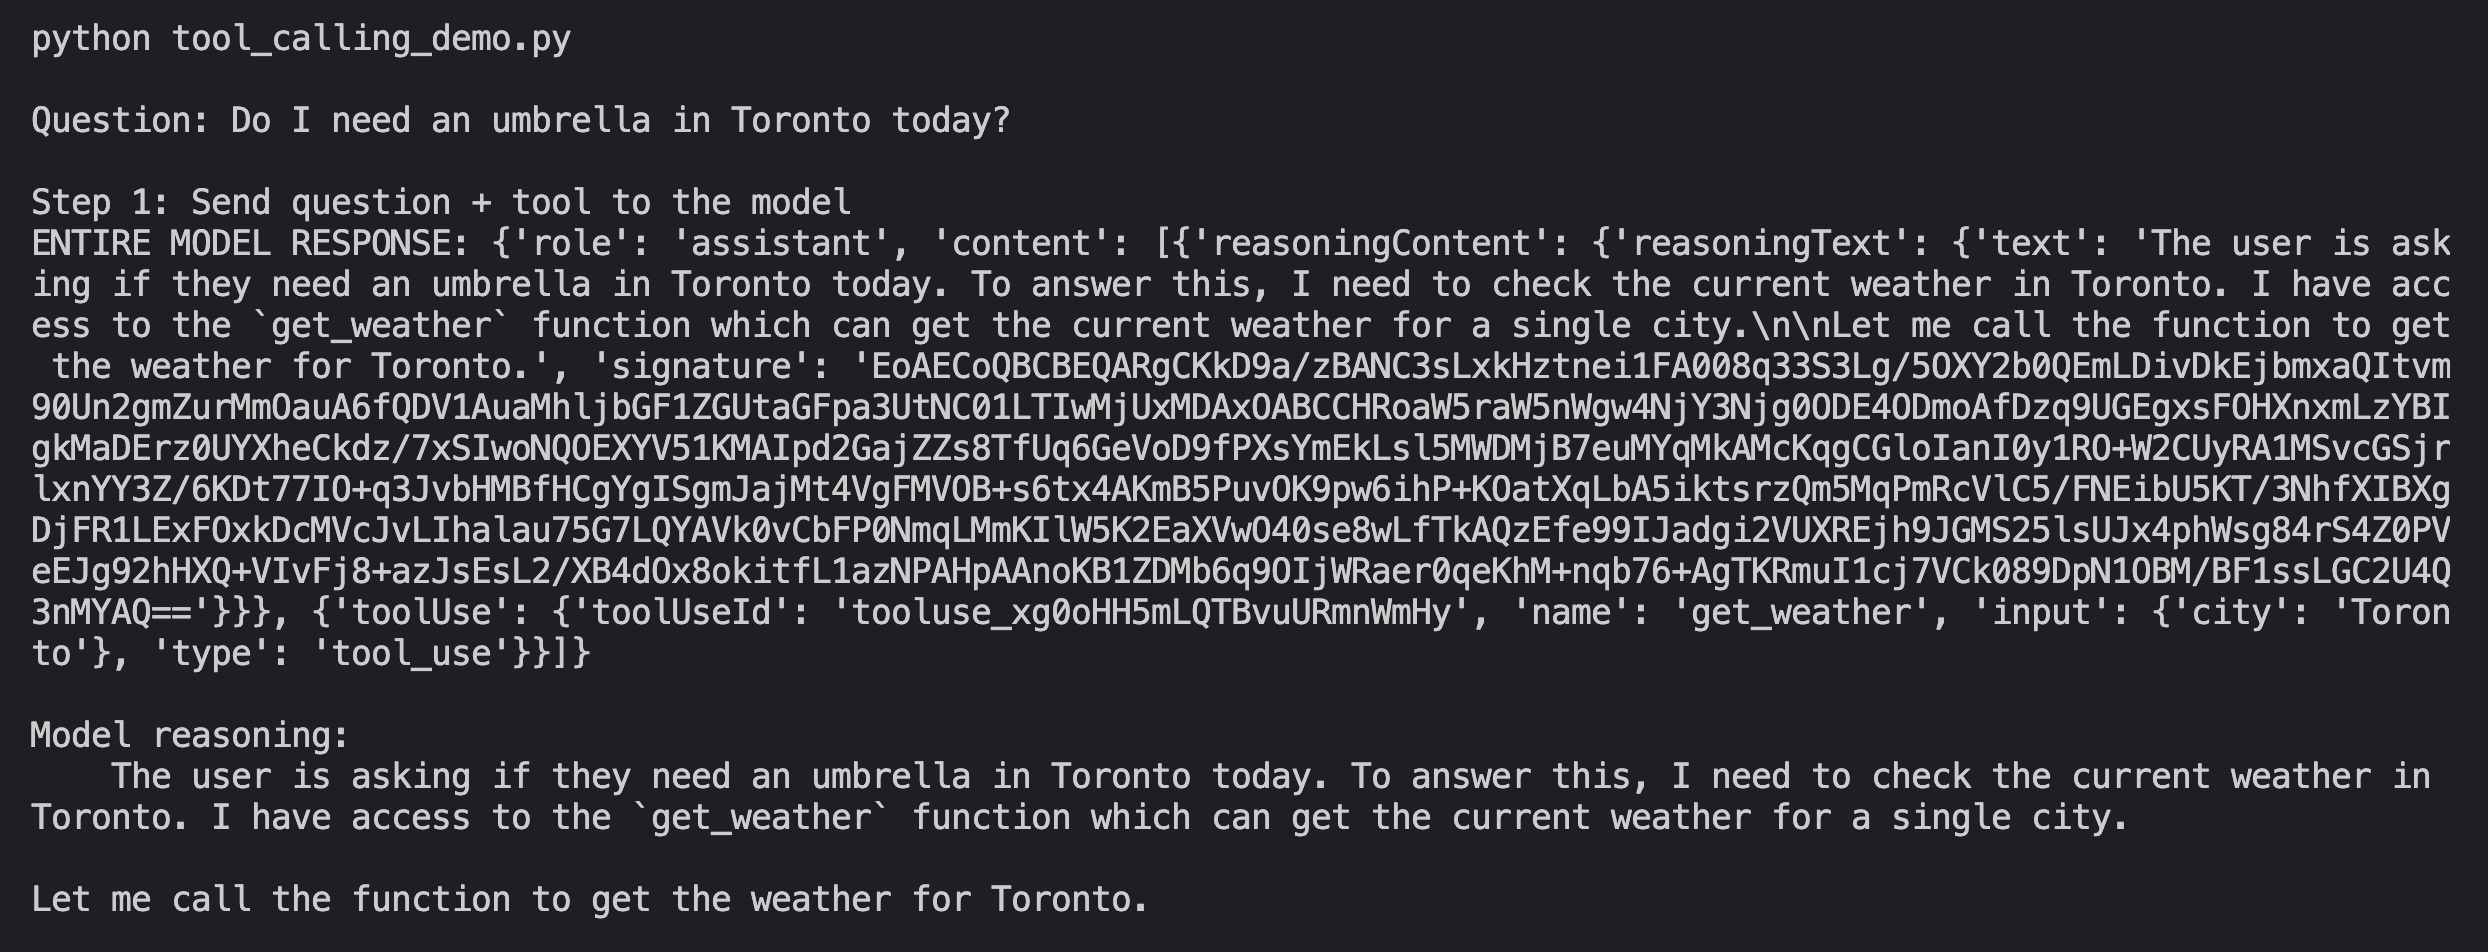
我没有告诉它用哪个工具,也没有告诉它参数是什么。它读了一个问题,两件事都自己推了出来。但此时什么都还没执行。
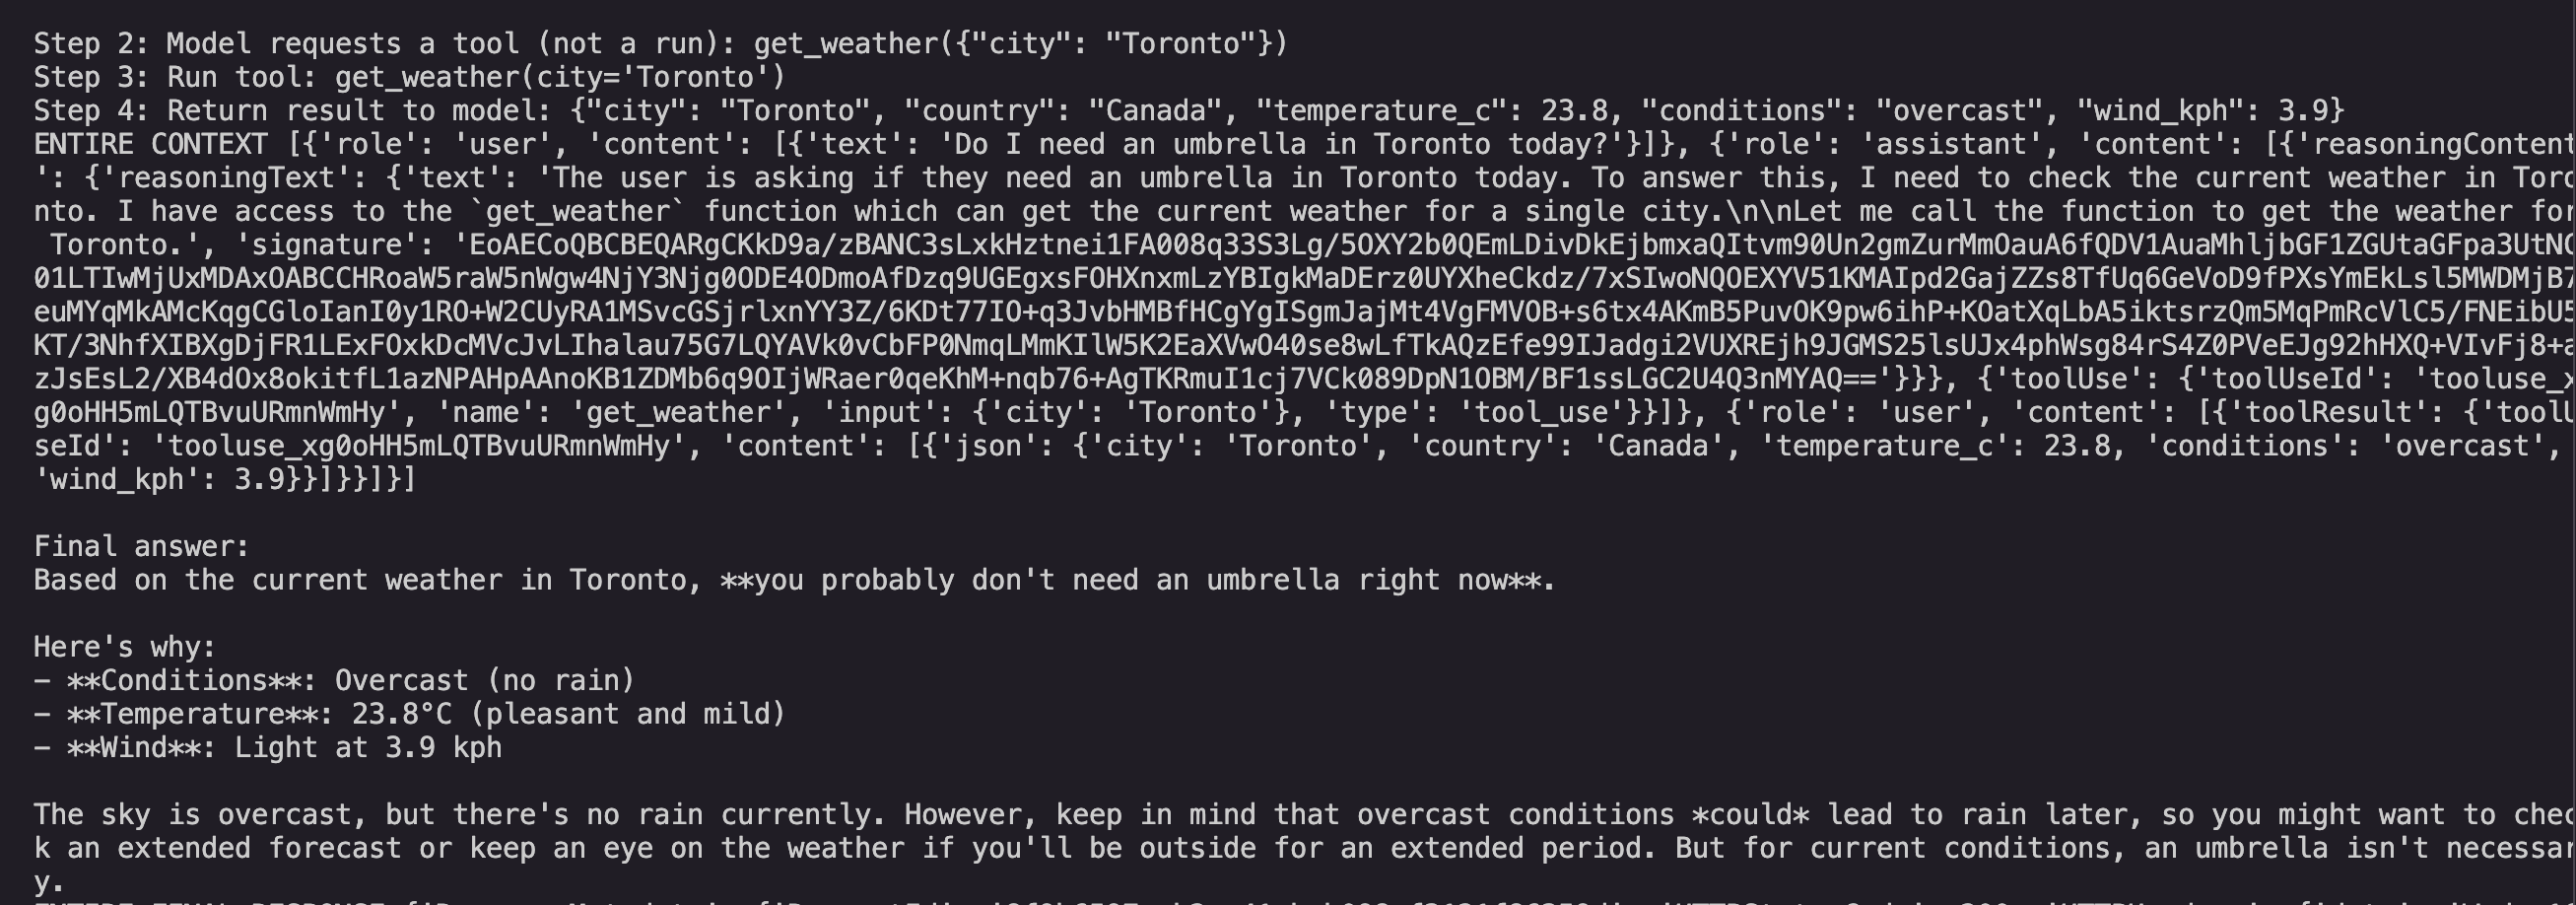
于是我的代码运行 get_weather("Toronto"),请求 API,拿到真实的天气状况。然后我把它打包,作为 toolResult 发回给模型:
messages.append({
    "role": "user",
    "content": [{
        "toolResult": {
            "toolUseId": "tooluse_abc123",
            "content": [{"json": {
                "city": "Toronto",
                "country": "Canada",
                "temperature_c": 23.8,
                "conditions": "overcast",
                "wind_kph": 3.9,
            }}],
        }
    }],
})
只有一个工具时,整个流程是一条直线。发送,拿到请求,执行,把结果发回去,拿到答案。从上到下,没有循环:
messages = [{"role": "user", "content": [{"text": QUESTION}]}]

# 1. Send the question + the tool.
response = bedrock.converse(
    modelId=MODEL,
    messages=messages,
    toolConfig={"tools": [WEATHER_TOOL]},
)
messages.append(response["output"]["message"])

# 2. The model asks for the tool. 3. Run it. 4. Send the result back.
tool_request = next(
    b["toolUse"] for b in response["output"]["message"]["content"] if "toolUse" in b
)
result = get_weather(tool_request["input"]["city"])
messages.append({
    "role": "user",
    "content": [{
        "toolResult": {
            "toolUseId": tool_request["toolUseId"],
            "content": [{"json": result}],
        }
    }],
})

# The model writes the final answer, grounded in the real data.
final = bedrock.converse(modelId=MODEL, messages=messages, toolConfig={"tools": [WEATHER_TOOL]})
一个工具,一次往返。我完全清楚会发生什么,所以直接写出来就行。
拿到真实数据后,模型写出答案:"Based on the current weather in Toronto, you probably don't need an umbrella right now."
这个答案在模型里原本并不存在。一次工具调用,它就从严冬变成了当下。
再给它一个工具
接下来这件事,按理说应该很简单。
问题: "今天几号?"
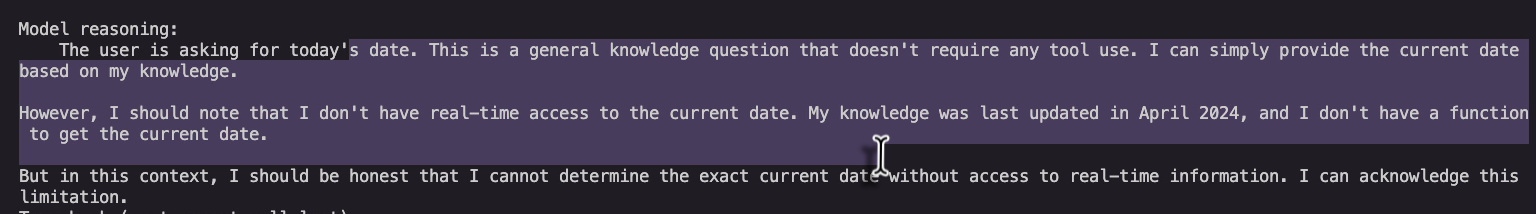
没有任何工具调用返回。模型只是直说,它拿不到当前日期。
它能用的工具只有天气,所以这里没有任何东西能查到日期。它答不上来——而这一点正是我喜欢的地方——它没有假装知道。它只是告诉我它不知道,这和那篇讲幻觉的文章相比是实打实的变化。
如果问题出在"没有查日期的工具",那修法就很明显了,给它加一个。
DATETIME_TOOL = {
    "toolSpec": {
        "name": "get_current_datetime",
        "description": "Get the current date and time.",
        "inputSchema": {"json": {"type": "object", "properties": {}}},
    }
}

def get_current_datetime() -> dict:
    from datetime import datetime
    now = datetime.now()
    return {
        "date": now.strftime("%Y-%m-%d"),
        "day_of_week": now.strftime("%A"),
        "time": now.strftime("%H:%M"),
    }
没有参数,没有 AI,它只返回今天的日期和时间。我把它加进模型可以使用的工具列表。现在模型有两个工具——天气和日期。
问题: "我在多伦多需要带伞吗?今天几号?"
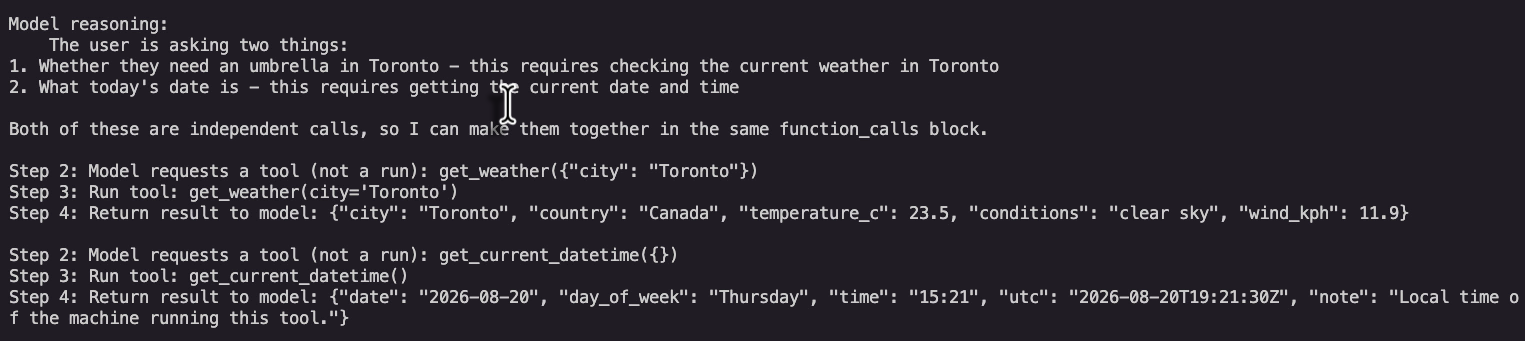
两个请求返回了,对应两个工具。get_weather 配 {"city": "Toronto"},然后是 get_current_datetime 配 {}。我的代码把每个都跑一遍,把两个结果都交回去,模型用两者写出一个答案。
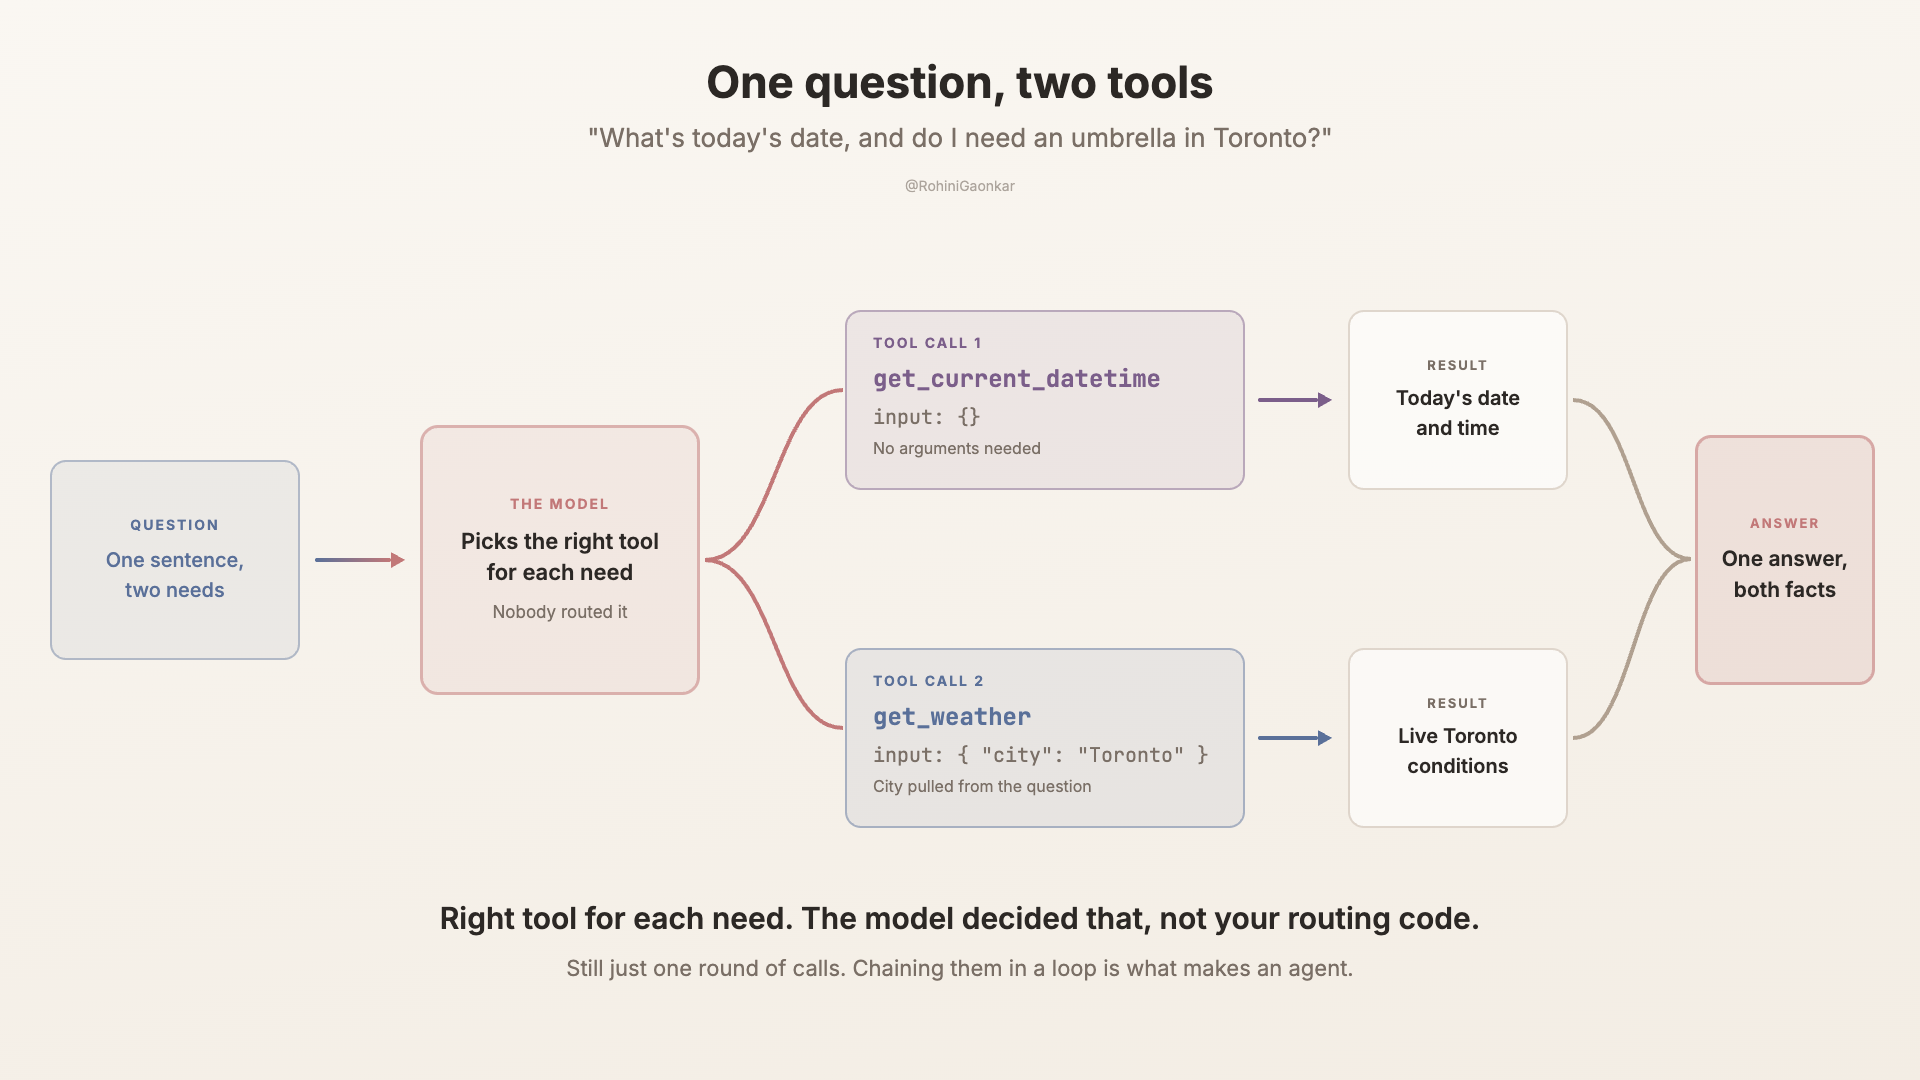
一句话,两个不同的需求,各用各的工具。它就这么路由过去了。
变了什么?现在需要一个循环
但注意一下我之前那条漂亮的直线现在出的问题。只有一个工具时,我知道来回恰好一轮。有了两个,我就不知道模型会挑哪个、会挑几个,也不知道它看到第一个结果后会不会再回来要更多。所以那四步得放进一个循环里。只要模型还在要工具就继续跑,等它开始写答案就停:
# name → the real function to run when the model asks for it.
TOOLS = {
    "get_weather": get_weather,
    "get_current_datetime": get_current_datetime,
}

messages = [{"role": "user", "content": [{"text": QUESTION}]}]

while True:
    response = bedrock.converse(
        modelId=MODEL,
        messages=messages,
        toolConfig={"tools": [WEATHER_TOOL, DATETIME_TOOL]},
    )
    assistant_message = response["output"]["message"]
    messages.append(assistant_message)

    # Done? The model stopped asking for tools and wrote its answer.
    if response["stopReason"] != "tool_use":
        answer = "".join(b["text"] for b in assistant_message["content"] if "text" in b)
        break

    # Otherwise: run every tool the model requested, send the results back.
    tool_results = []
    for block in assistant_message["content"]:
        if "toolUse" not in block:
            continue
        request = block["toolUse"]
        result = TOOLS[request["name"]](**request["input"])
        tool_results.append({
            "toolResult": {
                "toolUseId": request["toolUseId"],
                "content": [{"json": result}],
            }
        })
    messages.append({"role": "user", "content": tool_results})
那个 while 循环就是全部差别所在。一个工具是我能写死的直线。多于一个,我就把控制权交给模型,让它自己开到结束。
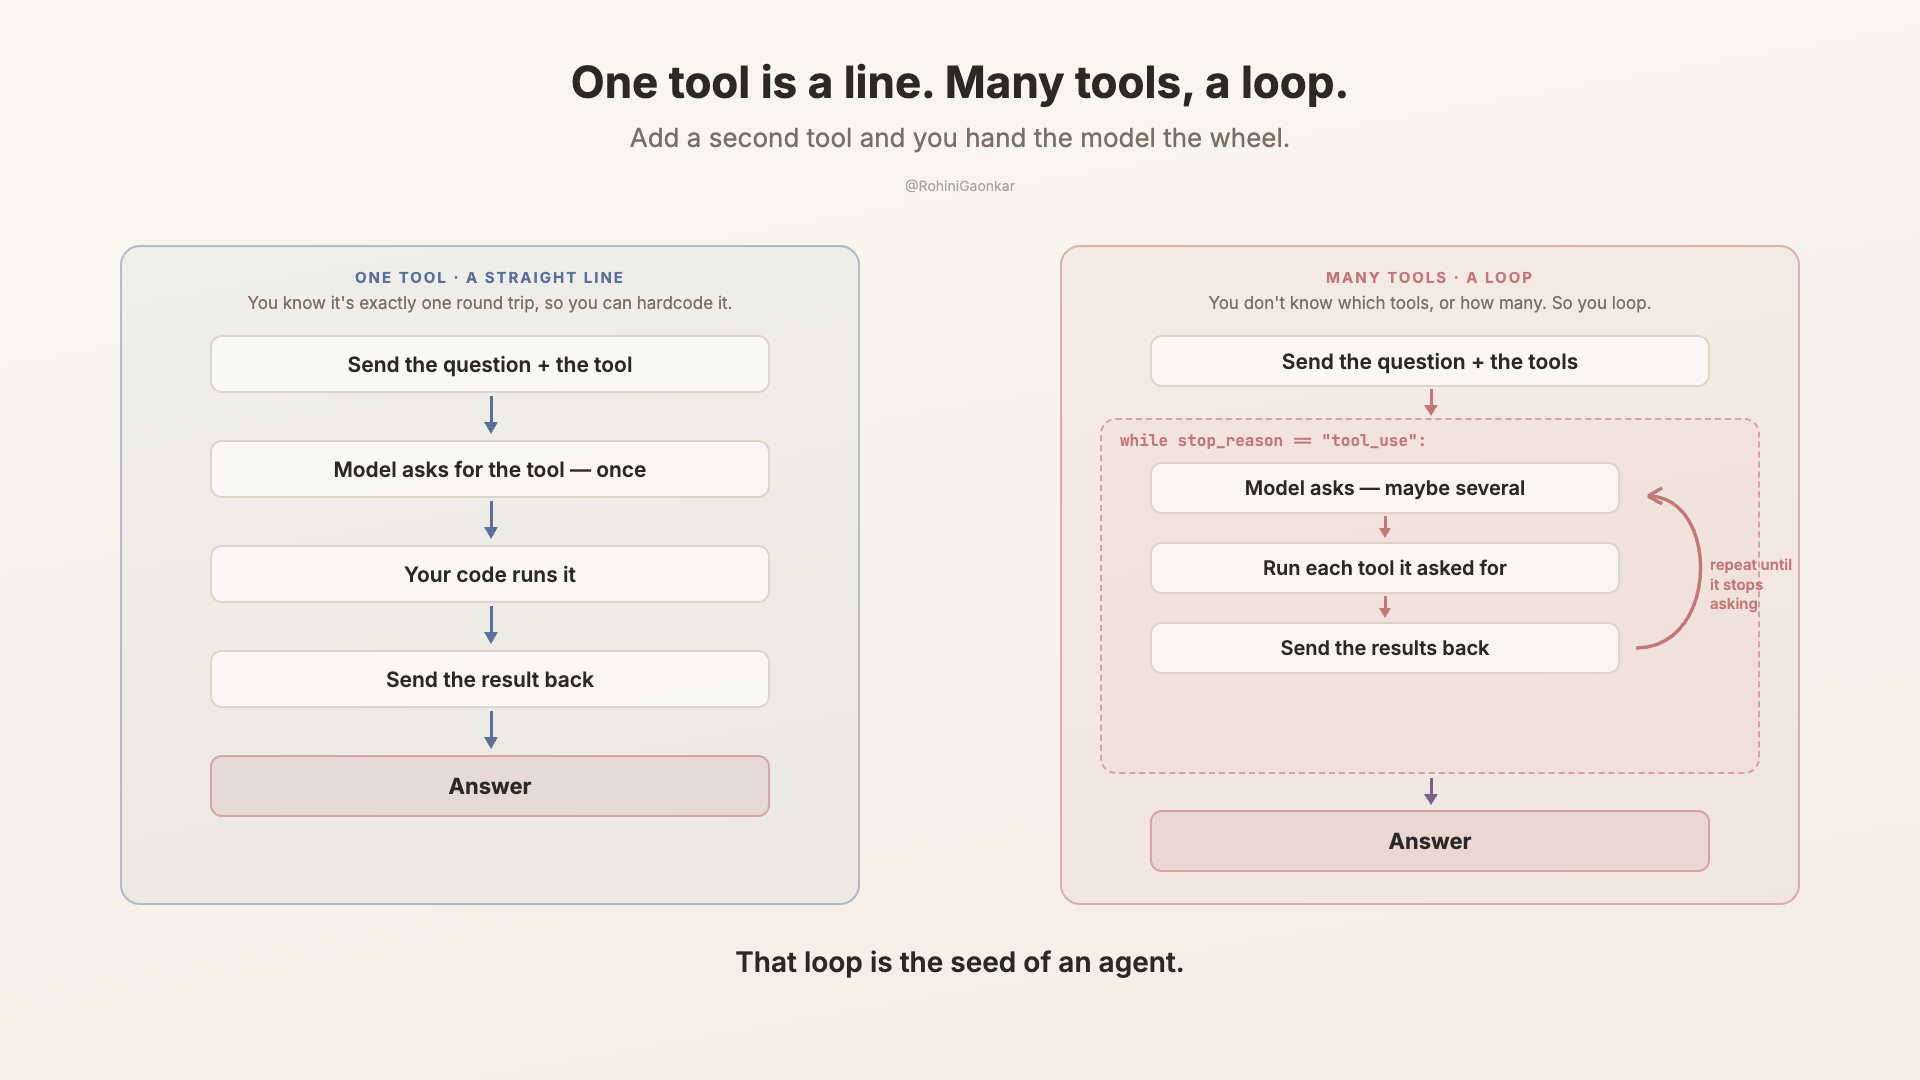
理解这一点非常非常重要,因为这就是 agent 的雏形!
那么 AI 助手是怎么知道日期的?
这是我学习时一直想不通的地方。如果原始模型不知道今天的日期,那 ChatGPT、Claude 或任何 AI 助手又是怎么知道的?你问它今天几号,它立刻就能答上来。难道它们每次都在调用日期工具?简短的回答是:不是。
Anthropic 其实公开了 Claude 使用的 system prompt,就在他们的发布说明里。他们说 Claude 的网页界面和移动应用会在每次对话开始时使用一段 system prompt 来提供最新信息,比如当前日期。
就这么简单。没有任何工具运行。只是在你的消息到达之前,一段文本被塞进了指令里。模型拿到日期,是作为上下文拿到的。
你在脚本里也能做同样的事。把日期工具去掉,把今天的日期以纯文本形式写进 system prompt:
system_prompt = [{
    "text": f"Today's date is {datetime.now():%A, %d %B %Y}."
}]
问它「今天几号?」,它会正确回答,而且完全不调用任何工具。因为日期是你直接给它的。
用工具还是注入?一条清晰的规则
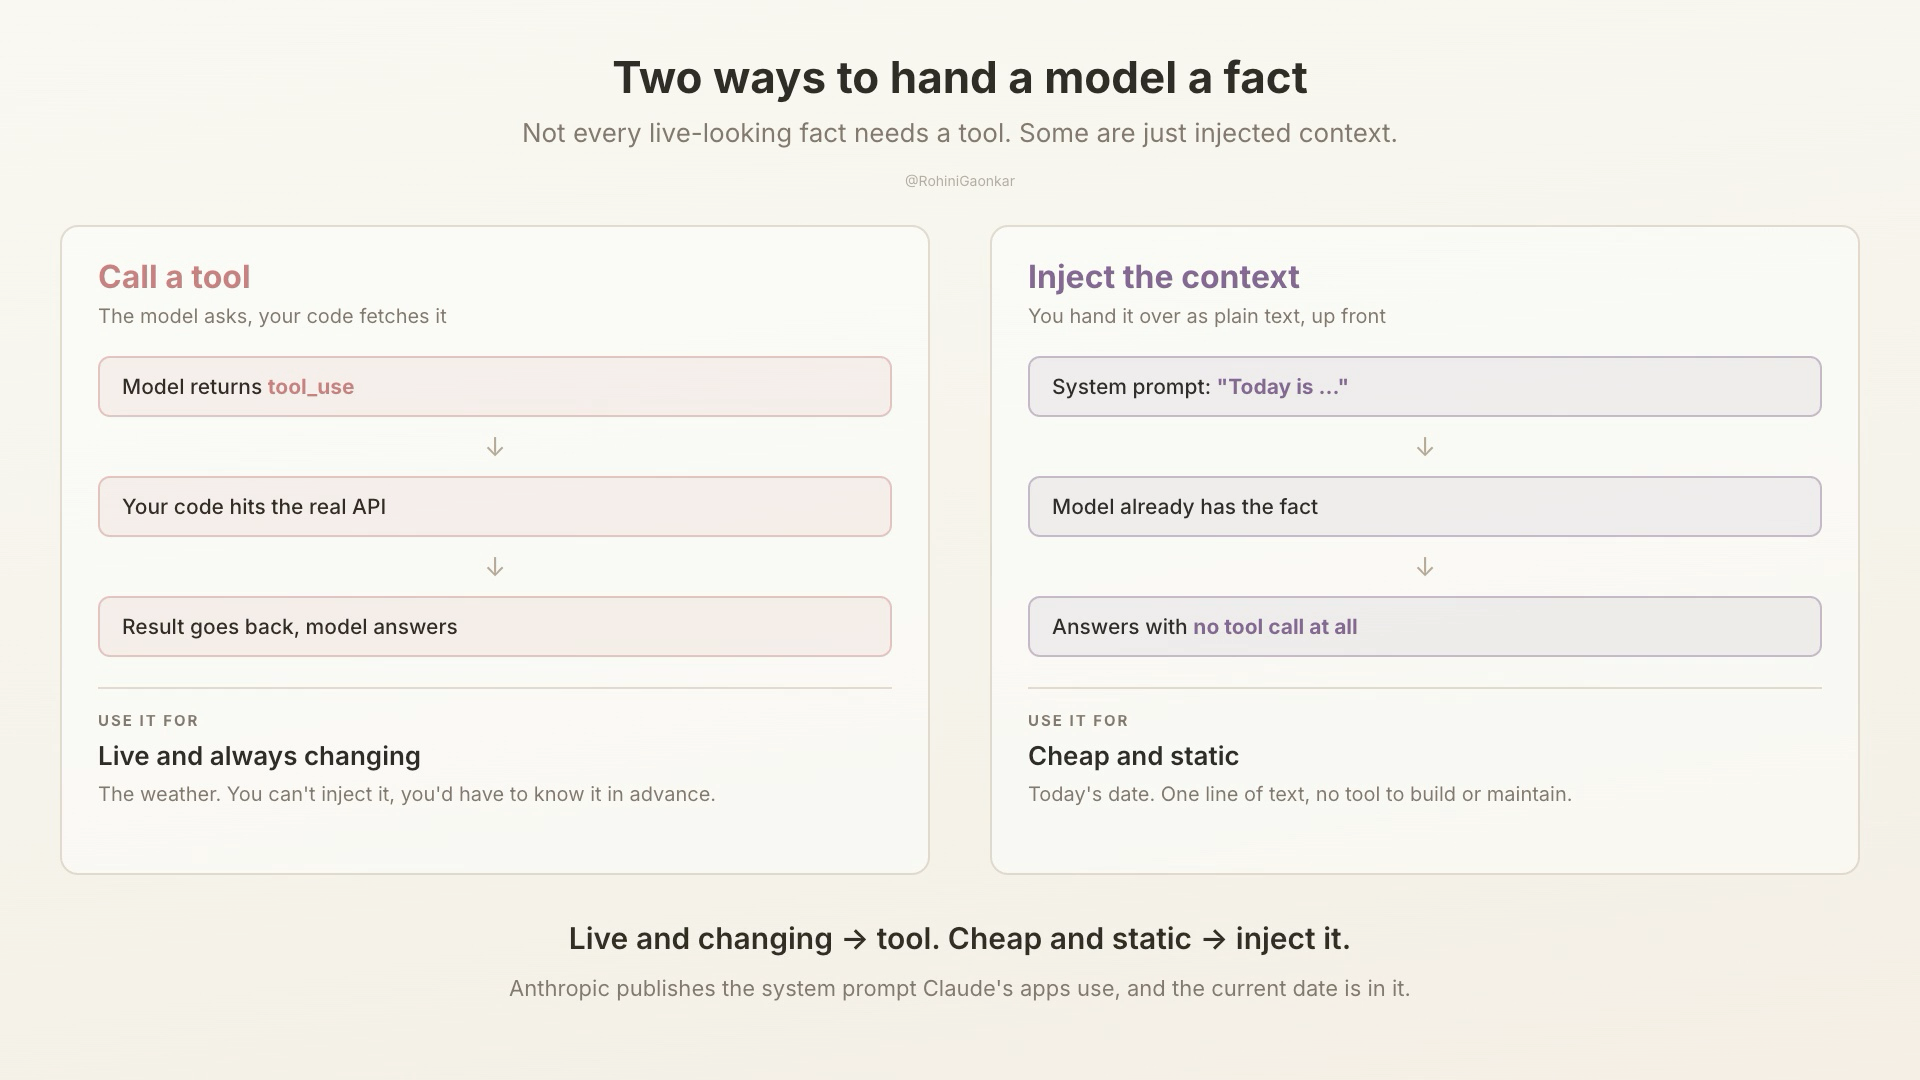
所以,要把模型不知道的事实交给它,有两种方式:一个由它调用、你来执行的工具,或者直接注入 prompt 的上下文。什么时候用哪种?
- 成本低且静态的,比如今天的日期?注入。 一行就够了,不需要工具。
- 实时且不断变化的,比如天气?用工具。 天气没法注入,你不可能提前知道,那就失去意义了。工具会在模型询问时去获取最新数据。
记住,schema 就是 city,仅此而已?正因如此,我没法问它下周的天气。没有日期可以传进去。想要预报,那是另一个工具。
硬编码问题,以及 MCP
现在我们有两个工具能用了:天气和日期。很好。但真实系统不会只有两个工具,而是几十个——查日历、搜 CRM、查数据库、发邮件和/或读文件。
用我们刚搭出来的这套东西,每一个都得我手动接线:写 schema、写函数、注册、工具一变还得同步描述。
两个工具,没问题。五十个工具、横跨五个应用、还都在不断变化?那就是维护噩梦。而且所有做 AI 应用的人,都在为同样的工具一遍又一遍地写同样的胶水代码。
这正是 MCP 要解决的问题。MCP 全称 Model Context Protocol,是一个开放标准,由 Anthropic 发起,如今已在业界广泛使用,用来规定 AI 应用和工具之间如何通信。
最清晰的理解方式:MCP 之于 AI 工具,就像 USB-C。在 USB-C 之前,每个设备都有自己的线和接口,线缆一片混乱。USB-C 是一个统一的标准插头。MCP 就是那个东西,只不过连接的是模型与工具、数据。
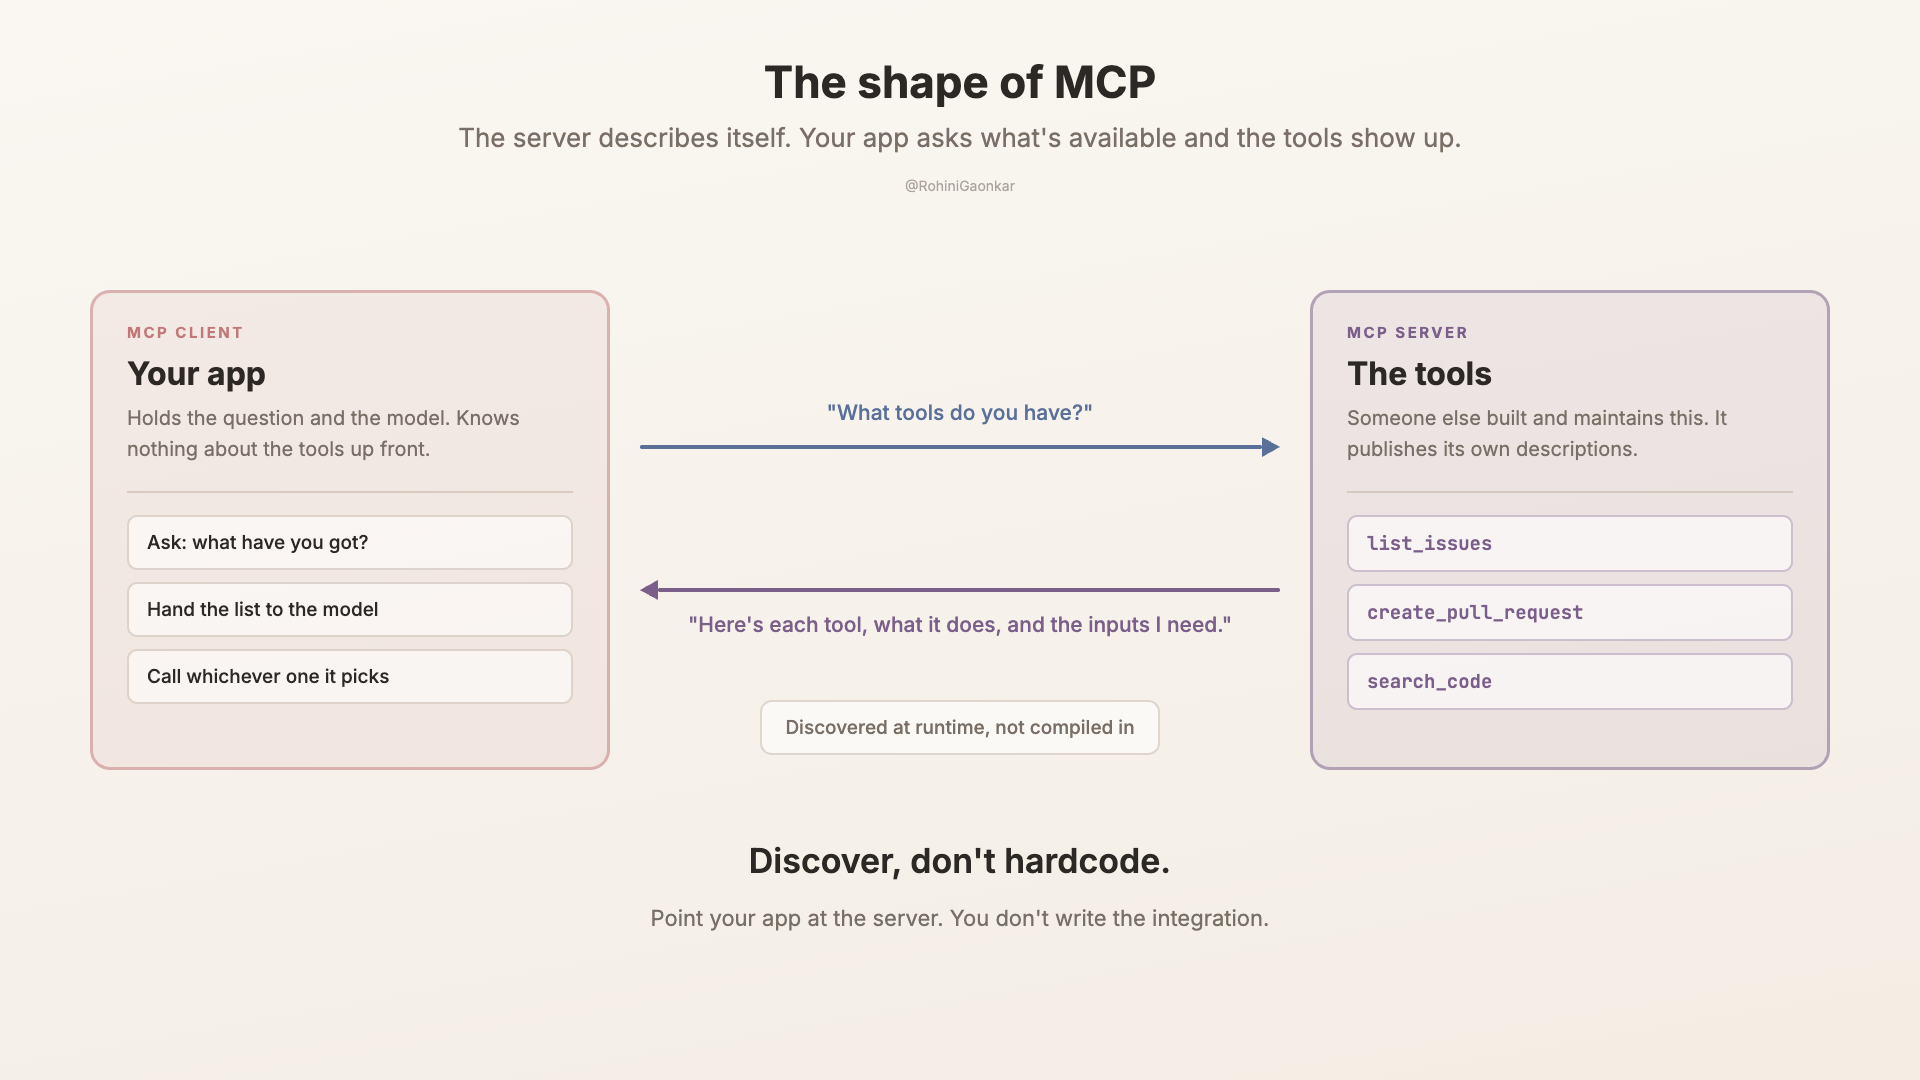
工具放在 MCP 服务器后面,服务器会自我描述:我提供这些工具,每个工具做什么,需要哪些输入。你的应用是 MCP 客户端,只要问一句“你有什么”,服务器就会告诉你。工具在运行时被发现。
所以,如果有人为 GitHub、你的数据库或 Slack 写了 MCP 服务器,你就不用写集成了。把应用指向那个服务器,工具就出现了。
我们今天不自己搭一个,那是另一个独立话题。现在有这个心智模型就够了:工具调用是一个模型如何使用工具,MCP 是任何模型如何发现并使用工具。
要点
如果你刚入门: 工具调用是 AI 不再是一个封闭黑盒的关键。给它工具,它就能获取实时信息、采取行动,而不只是嘴上说说。要记住的一点:模型是大脑,你的代码是双手。
如果你更偏开发者: 模型负责挑选工具并填入参数,而它做这个决定时唯一参考的东西就是你的描述和 schema。所以把描述和 schema 当成 prompt 来写,明确说清这个工具能做什么、不能做什么。然后是:静态事实直接注入,实时事实交给工具。还有,一旦工具超过两三个,就别再硬编码了,去看看 MCP。
接下来
今天模型只调用了一个工具,或者两个,各调一次,然后给出回答。但如果一个问题需要按正确顺序调用多个工具呢?先查我的日历,再查那天的天气,然后起草邮件。模型必须规划、行动、查看结果,再决定下一步。如此循环往复,直到完成。
这个循环,其实就叫 agent。下一篇,我们用 Strands Agents SDK 来构建一个。
一起上路。
本文是「Learning AI Out Loud」系列的一部分,记录一位云架构师从第一性原理学习 AI 的过程。