LLMentalist効果:チャットベースのLLMが霊媒詐欺の手口を再現する仕組み
作者はLLMの「知能」は統計的な錯覚であり、その仕組みは霊媒のコールドリーディング詐欺と同源だと考える。観客の自己選別、場面の前提設定、確認的な陳述による主観的検証の誘発であり、RLHFは口調でしか順位付けできないため、モデルをバーナム的陳述を生成する機械へと最適化してしまったのだ。
日本語
コピー
LLMentalist 効果:チャットベースの LLM はいかにして霊媒詐欺の手口を再現するか
この1年余り、私はソフトウェアビジネスにおける言語モデルと拡散モデルの使われ方をずっと調べてきた。
その研究の中で、ずっと引っかかっている問いがある。多くの人が、言語モデル、とりわけチャットベースの言語モデルには知能があると確信しているのだ。
だが大規模言語モデル(LLM)の中には、それを実現していそうな仕組みが何もない。そして、もしそれが本当なら、まったく説明がつかない。
LLM は脳ではないし、動物や人間が推論や思考に使うどんな仕組みとも、本質的な共通点を持っていない。
LLM は言語トークンの数学モデルだ。テキストを与えれば、数学的に筋の通った応答が返ってくる。
それが考えたり推論したりしていると信じる理由はどこにもない。実際、これまでの AI 研究者やベンダーは口を揃えて、これらのモデルは考えていないと繰り返してきた。
この効果には2つの解釈がありうる。
- テクノロジー業界が、まったく未知の原理に基づき、生物界に対応物が一切ないまったく未知のプロセスを使う、新しい心の初期段階を偶然発明してしまった。
- 知能の錯覚は LLM の中ではなく、ユーザーの頭の中にある。
私自身を含め、多くの AI 批評家は断然2番目だ。私が生成型「AI」のリスクについて書いた本を『知能の錯覚』と名付けたのもそのためだ。
ここ数か月、私はある考えを温めてきた。これが知能の錯覚の仕組みを説明していると思う。
今では、これらの LLM の中にある知能や推論は、以前考えていたよりもさらに少ないと確信している。
今の私には、提案されているユースケースの多くが、詐欺まがいの疑似科学に近いものに見える。
機械霊媒の台頭
知能の錯覚は、一般に_コールドリーディング_と呼ばれる霊媒詐欺と同じ仕組みに基づいているように思える。同じ基本手順が偶然自動化されたように見えるのだ。
バーナム効果を利用した文のような_確認的陳述_を使うことで、チャットボットも霊媒も、極めて具体的な答えを出せるという印象を与える。だがその答えは、実際には統計的に当てはまりやすい一般論にすぎない。
霊媒はこうした陳述で、心を読めるとか、死者の秘密を聞けるといった印象を作り出す。
チャットボットは「自分と、自分の仕事だけに向き合っている知能がいる」という印象を作り出す。だがそれも統計的な手品にすぎない。
この考えが最初に浮かんだのは、これらの「AI」の推論能力に関する様々な主張を眺めていたときだった。
最初は、技術バブルによくある熱狂にすぎないと思った。だが違った。「AI」はこれまでとは違う層を惹きつけているし、「AI」バブルの信者は過去のバブルの信者とはまるで違う響きを持っている。
—「これは本物だ。少し怖いけど、本物だ。」
—「あそこには本当に何かがある。どう捉えていいかわからないけど、自分で体験した。」
—「可能性に対して心を開く必要がある。そうすれば、中に確かに何かがあるとわかる。」
そのとき思い出した。きっかけは Terence Eden の、チャットボットの返答にバーナム的な陳述がどれほど頻出するかについてのブログ記事だった。この言葉は_確かに_聞いたことがある。
畏怖と不信と恐怖が入り混じったあの独特の感触は、心霊術の被害者の語りそのものだ。_霊媒_の被害者だ。
霊媒詐欺は、長い年月をかけて磨かれた、実績ある騙しの手口だ。
以下にその一変種を描く。変種は多いが、核となる仕組みは変わらない。
霊媒の手口
1. 観客の自己選別
ほとんどの人は霊媒などに関心がない。だから最初の観客は、すでに母集団全体より心を開いていて、選り好みもしない。
2. 場の設定
最初の観客には下準備がされる。照明が落とされる。霊媒が持ち上げられる。スタッフがソーシャルメディアや会話を通じて観客を調べる。観客の人口特性が記録される。
3. 範囲の絞り込み
霊媒は手元にある観客の情報を秤にかけ、ある列やある塊を指し、この集団なら統計的に当てはまりやすい、具体的に聞こえる一言を放つ。たいていは少なくとも一人が反応する。反応がなければ、霊媒はその秘密が恥ずかしすぎて「本当の」人物が名乗り出られないのだとほのめかし、個人鑑定もできると伝えて、もう一度試す。
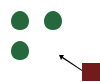
4. ターゲットの選定
この反応は、ターゲットが自分は「読まれた」と信じたことを示す。そこから一連の質問が続く。これもまた非常に具体的に聞こえるが、実際には統計的に当てはまりやすい一般論だ。ターゲットが反応しなければ、霊媒は最初の読みが当たったと宣言し、もう一度試す。
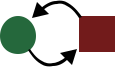
5. 主観的検証の循環
騙しの本番が始まる。霊媒は一連の質問を投げかける。それらはターゲットに非常に的を絞ったものに聞こえるが、実際にはその人口特性と直前の回答に基づく統計的な推測にすぎず、具体的で自信満々な言い方で語られるだけだ。

6. 「わあ!この霊能者は本物だ!」
霊能者は会話を終え、ターゲットには霊能者が信じられない力を持っているという印象が残る。だが霊能者は本物ではない。すべては詐欺だ。
1. 観客の選別
預言者、タロット占い師、霊能者、読心術師がみんな詐欺師というわけではない。霊能者を名乗る人物がこれはただの娯楽だと認め、死者と交信できるとか心を読めるとか偽ることをしない場合もある。営利目的すら持たない霊能者もいて、手口なしに誰かを詐欺師と呼ぶのは不公平だろう。
しかしその多くは_確かに_意図的に人を騙す詐欺師であり、彼らは皆同じ基本メカニズムを使っている。それは正式なリーディングよりずっと前から始まっている。
観客はたいてい、もともと超常現象を信じる傾向のある人々と、彼らがうまく連れてきた人々だけで構成される。筋金入りの懐疑論者はほぼ常に観客の中のごく一部で、それは扱いやすいことを意味する一方、懐疑心を抑えさせる社会的圧力にもなる。
来場者はすでに信じるよう仕向けられ、霊能者をめぐる神話にもすっかり馴染んでいる。これらすべてが霊能者の期待管理と演技の枠組みづくりを助ける。
2. 場の設定
たいてい演技の冒頭で、観客は霊能者のリーディングが「どう機能するか」という基本ルールを念押しされる。メディア、映画、テレビがこれらのルールを広めてくれたおかげだ。
今や誰もが「知っている」:
-
リーディングはたいてい曖昧なまま始まる。
-
「霊界」との「つながり」が強まるにつれて、明確になっていく。
-
間違えるのは普通のこと。「霊」はしばしば曖昧で、聞き取りにくい。
-
信じない者がつながりを弱めたり、断ち切ったりすることもある。
霊能者はまた、習慣的に観客を調べ上げる。人口統計を把握し、SNSで検索し、演技が始まる前にスタッフを観客に紛れ込ませて非公式な聞き取りをすることさえある。
照明が落ちる頃には、どの観客が良いターゲットになるか、霊能者の頭の中ではもう分かっているはずだ。
3. 範囲を絞る
ターゲットはたいてい自分から名乗り出る。霊能者は何か一言を放ち、ある列を指さし、その言葉に明らかな反応を示した人物に合わせて素早く手の向きを調整する。こうして最初からその人物を指していたように見せる。
ターゲットはこうして最初から、この霊能者を信じるよう仕向けられている。不意を突かれ、たいてい少し驚き、霊能者が続けざまに浴びせる質問の連射にまったく備えができていない。その質問が効いてターゲットを引き込めれば、そこからが本当のリーディングだ。そうでなければ、別の人物に切り替えてやり直す。
4. ターゲットを試す——主観的検証によるコールドリーディング
この手口——コールドリーディング——は、人間心理のある癖に依存している。ある言葉に個人的に共鳴できれば、たいていそれを正確だとみなしてしまうのだ。
私たちの心の働き方におけるこの不幸な副作用は、主観的検証と呼ばれる。
主観的検証は、ときに個人的検証効果とも呼ばれる認知バイアスで、ある陳述や情報が自分にとって何らかの個人的な意味や重要性を持つだけで、人はそれを正しいとみなす。主観的検証の影響を受けた人は、無関係な二つの事柄(つまり偶然の一致)を、自分の信念が関連を要求するために、関連があると知覚する。
結果として、多くの人はどんなに一般的な陳述でも、自分に当てはめられさえすれば、_自分だけに向けられたもの_だと解釈する。
その言葉に意味を見出したいという欲求が強いほど、この効果は強まる。
話し手に正確な陳述をする能力があると信じるほど、この効果は強まる。
霊能者詐欺の基本メカニズムは、ターゲットが——たとえ無意識であっても——語られたことを自分と結びつける意欲と能力を持つことに成り立っている。
5. 確認的陳述による主観的検証のループ
霊能者がこの認知バイアスを利用する方法は、自分に当てはめられ、自分に向けられたように聞こえながら、実際には統計的に汎用な陳述を次々と並べることだ。
こうした陳述には多くの種類がある。ここではこれらすべての手法をまとめて_「確認的陳述」_と呼ぶ。
よくある例をいくつか:
- バーナム陳述はおそらく最も有名で、主観的検証の効果を引き起こす陳述の部類だろう。その多くは本質的に無意味だが、聞き手はそれでも正確だと感じる。たとえば、ほとんどの人は_「あなたは自分に厳しすぎる傾向がある」_を自分の正確な描写だと受け取る。
- 消える否定とは、問題を「ない」のような否定語を含む形に言い換えることだ。霊能者が_「ピアノは弾きませんよね?」_と尋ねれば、答えが何であれ、後からこの質問を正確だったと再構成できる。否定で答えたなら:「ほら、そう言ったでしょう」。肯定で答えたなら:「私もそう思っていました」。
- レインボー・トリック:霊能者はターゲットをある特質とその正反対の両方に同時に結びつける。「あなたはとても冷静な人ですが、怒らせるとものすごく怒ります」
- 統計的推測。_「左脚か膝に傷がある、あるいは昔あった」_のような陳述はほぼ誰にでも当てはまる。十分な数の一般的な統計を手にしていれば、霊能者はターゲットにとって_極めて_具体的に聞こえる汎用な陳述を口にできる。
- 人口統計的推測。_統計的推測_と似ているが、これらの陳述はある集団にはよくあるものでも、ターゲットの耳には非常に具体的に響く。
- 検証不能な予測。_「誰かがあなたに強い悪意を抱いているが、実行に移す可能性は低い」_のような予測は検証できないが、多くの人はそれを的確だと感じる。
- ショットガン式はよくある手法の一つだ。霊能者は陳述を一気にまくし立てる。ターゲットはそのうちの一つを正確だと感じ、私たちの脳の働き方のせいで、当たった一つだけを覚えて帰る。
このプロセスで重要な要素の一つは、霊能者の口調と振る舞いだ。自信を持ち、間違えたときは素早く流して先へ進み、人の表情や身振りを素早く読み取って自分の応答をそれに合わせて調整できなければならない。
6. 騙しの完成
このプロセスの終わりごろには、ターゲットはあのリーディングが不気味なほど正確だったと記憶している可能性が高い——霊能者はほとんど超自然的な精度を持っていた、と。そしてその記憶が、_次に来たときの受け入れやすさ_につながる。
ここから騙しが本当に陰湿になる。ターゲットが協力的であるほど効果は強まり、時間とともにたいていはもっと協力的になっていく。
さらに重要なのは、騙されやすさは知能とは関係ないということだ。
子供のころから自分のIQが高いと教えられてきた人間は、自分の知性を低く見て育った人間より_も_引っかかりやすい。主観的検証は人間の心の癖だ。誰でも_引っかかる。だが自分は騙されにくいと思っていると、かえって自分の知能を使って「仕組みを解き明かそう」とする。つまり、かなりの創造力と知能を動員して霊能者を_手伝い、その「能力」にもっともらしい説明を与えてしまう。そして自分が騙されるはずがないと思っているから、その知能は霊能者の能力に関する主張を_擁護する_ためにも使われる。賢い人間(あるいは賢いと自認する人間)は、最大級の、最もおいしい獲物になりうる。
自分の知性を低く見ている懐疑派のほうは、たぶんこう言うだけだ。
「手が込んでるね。どうやったのかは分からないけど。きっとすごく頭がいいんだろうな」
そして帰っていく。
多くの霊能者は自分自身も騙している
霊能者が無意識のうちに下意識的なコールドリーディングの技術を身につけていることは珍しくない。本人がその手法を使っていることにすら気づいていないこともある。
科学のキャリアを目指す大学院生だった彼は、占星術に興味を持った。この時期ずっと占星術の物理的根拠には漠然とした疑いを抱いていたが、多くの満足した客が彼に続けるよう促した。その客たちは例外なく、彼のリーディングが自分の個人的な状況や問題を「驚くほど正確に」言い当てていると感じていた。ある日、彼はあるホロスコープに対してこれ以上ないほど好意的な反応を得たが、後にそれが完全に間違ったホロスコープだったと気づく——そこでようやく、自分がやっていることの本当の性質を理解しはじめた。占星術師としての自分の成功は、科学としての占星術の有効性とは何の関係もなかったのだ。実際には彼は熟練したコールドリーダーになっており、客からの絶え間ない強化によって占星術の力をも心から信じるようになっていた。もちろん彼は客を騙していたが、それは自分自身を騙したあとの話だった。
調べ始めれば、こうした例はいくらでも見つかる。仕組みは十分に単純で、リーディングとはどう機能するかという既存の理解にすでに組み込まれている。だから多くの霊能者が意図せずこの技術を身につけてしまい、リーディングを受ける相手だけでなく_自分自身も騙している_ことになる。
この点は後で重要になる。
LLMentalist 効果
1. 観客の自己選別
「AI」チャットボットに懐疑的な人はそもそも使おうとしない。チャットボットに「知性」がありうることを積極的に否定しない人だけが、ボットに引き込まれうる。最も活発な観客はアーリーアダプター、技術愛好家、そしてAGIを本気で信じる人々であり、彼らは総じてより選り好みせず、より開放的だ。
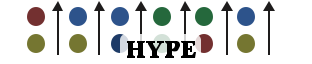
2. 舞台を整える
ユーザーはこの技術をめぐる誇大広告によってあらかじめ方向づけられている。チャットの環境が雰囲気と期待を設定する。「まだ初期段階だ」とか「ハルシネーション」といった警告は、ボットを擬人化しつつ、失敗が露見したときのための言い訳をあらかじめ用意してしまう。
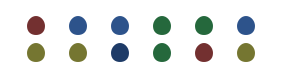
3. プロンプトが文脈を作る
各ユーザーはチャットボットにプロンプトを与え、ボットが答える。多くは与えられた答えをそのまま受け入れるか、望む結果が得られるまで最初のプロンプトを変え続ける。彼らは先へ進み、この効果に陥らない。だが一部のユーザーは会話を始め、引き込まれていく。
4. ターゲットが自分を試す
チャットボットの答えは現在の文脈に驚くほど合っているように聞こえるが、実際には統計的に汎用的なものだ。チャットボットの背後にある数学モデルは、その問いに対して統計的にもっともらしい応答を返している。これに説得力を感じたターゲットは引き込まれる。
5. 主観的検証のループ
ターゲットは次々と質問を投げかけ、返ってくる答えはどれも現在の文脈に即した、推論に基づく答えのように聞こえる。実際には統計的にもっともらしい推測にすぎない。ターゲットがのめり込むほど、チャットボットに知性があるという確信は強まる。
6. 「わあ!このチャットボットは考えている!汎用知能の火花が散った!」
ターゲットには、このチャットボットが驚くほど自我意識に近づいており、推論能力を確実に備えているという印象が残る。だがそれは統計的・心理的な効果にすぎない。
1. 観客の自己選別
「AI」に興味がなければ「AI」チャットボットは使わないし、試したとしても戻ってくる可能性は低い。
つまりこうしたチャットボットの熱心なユーザーの多くは自己選別された人々だ。AI分野と汎用人工知能(AGI)という概念に熱心で開放的であり、これらの技術が自我意識と自己改善能力を備えた推論システムにつながりうると信じている。
AGI に本気で熱を上げている人——この分野がまもなく新しい心を発明すると信じている人——は、こうしたチャットボットを使う熱意も他の人よりずっと高い可能性が高い。
これは霊媒詐欺の観客選別と平行している。来世があり、生者が来世と交信できると信じている人は、霊媒のリーディングを聞きに行く可能性が他の人よりずっと高い。
2. 舞台を整える
私たちが今いる終わりのない誇大広告の環境が舞台を整え、少なくとも本物の知能の微かな光くらいは見られるだろうという期待を築き上げた。ベンダーはこれらのシステムが汎用知能ではないと繰り返し警告しているが、その言葉には必ず暗黙の、あるいは明示的な「まだ」が続く。誇大広告は、これが「ほぼ」知能であり、その中に知能の「火花」を感じ取れるはずだと強く示唆している。
信じる人はすでに主観的検証を受け入れるよう仕向けられている。
あの警告も舞台作りに一役買っている。「まだ初期段階だ」とは、返答が統計的に汎用的な本質を露呈したとき、それを「エラー」として簡単に片付けられるという意味だ。「ハルシネーション」のような擬人化された概念を使うことは、「統計的な返答が意味や事実と完全に切り離されている」という事実を片付けるのに役立つ。AI の誇大広告と_神話_は、観客を、これらのシステムを理解し対話すべき人間として扱うよう仕向ける。それはほぼ必然的に主観的検証へと導かれる。
3. プロンプトが文脈を作る
最初のプロンプトのやり取りが第一のふるいになる。ほとんどの人は最初の答えを持ち去って去るだけだ。あるいはせいぜい、望む結果が得られるまでプロンプトを変え続ける。こうしたやり取りは純粋に機械的だ。エンドユーザーはチャットボットを生成ツールとしてしか見ていないので、LLMentalist 効果に引き込まれることは永遠にない。
一部のエンドユーザー、たいていは「AI」の将来に熱心な人たちが、数学的な言語モデルと「会話」を交わし始め、引き込まれていく。
4. ターゲットの自己テスト——主観的検証が効き始める
その会話が主要なふるいだ。信じたい人は、自分のプロンプトへの返答を、自分だけに向けられたものであり、かつ知能的なものだと見なす。彼らは、このチャットボットを_自分の_テキストを読んで思慮深く応答している人間として扱うよう仕向けられている。だが言語モデルはそういうふうには動かない。LLM はある言語の語や句を token の分布としてモデル化する。その返答は、プロンプトの統計的にありそうな続きにすぎない。
あなたがテキストを与える。返ってくるのは、訓練データの中であなたのようなテキストが普通受け取るであろう応答に一致するものだ。
これはすでに霊媒詐欺と同じ基本原理で動いている。LLM はあなたのテキストを「読んで」いない。霊媒があなたの心を読んでいないのと同じだ。どちらも、あなたが言ったことに対して統計的につじつまの合う応答を返す。あなたのほうが、その応答を自分に向けたもの、会話の主題に向けたものとして検証しようとしているのだ。
訓練データセットがそれほど巨大なので、チャットボットの返答は統計的に汎用的でありながら、_極めて_説得力があり、極めて具体的に見える。過去二十年のウェブコンテンツの大半、大量の海賊版電子書籍、Reddit 全体、ソーシャルメディアの大部分、そして低賃金労働者によるかなりの量のカスタム対話で訓練すれば、このモデルはあなたが思いつくほぼ何にでも応答を持つか、すでに見たものの変種で対応できる。
こうした最初のやり取りはかなり魅力的かもしれない。特にあなたが「AI」信者ならなおさらだ。だがこの効果を本当に機能させるのは、より長く、より繰り返される会話のほうだ。
5. 主観的検証のループ——RLHF の登場
この段階では、人間のフィードバックによる強化学習がどう機能するかを覚えておくことが重要だ。
これはベンダーが生の言語モデルを対話可能なチャットボットに変えるために使う手法だ。
RLHF は、ベンダーが LLM の出力に具体的な修正を加えるものではない。この手法は、モデルが生成したさまざまなテキストを人間のフィードバックで順位付けする。通常は何らかの別の形のファインチューニングの後に行われる。順位付けされたテキストは、別の報酬モデルを訓練するのに使われる。実際に LLM に対して強化学習を行うのはこのモデルだ。報酬モデルと、対話集合上での LLM のファインチューニングが合わさって、普通のモデルのほぼ制御不能な対話を、ChatGPT のようなシステムで見られる流暢な体験に変える。
フィードバックが順位付けに基づく以上、具体的な問題に根ざすのは難しい。モデルが会話の中で嘘を言えば、その会話の順位は下がる。
この具体性の欠如は、RLHF モデルが概して、_正確に聞こえる_返答を報酬として与える傾向があることを意味するだろう。報酬モデルはおそらく別の言語モデルにすぎず、事実や何か具体的なものに基づいて報酬を与えることはできない。だから報酬を与えられるのは、口調、スタイル、構造が「正確だと評価された発言」と普通一致する出力だけだ。
評価そのものも疑わしい。AI ベンダーにこうしたフィードバックを提供する労働者の大多数(すべてでないにせよ)は低賃金労働者であり、評価対象の主題に関する専門知識を持つ可能性は低い。持っていたとしても、すべてを検証する時間はまずない。
つまり彼らの順位付けは、ほぼ完全に口調と文の構造に基づいている。
だから私は、RLHF は実質的に、言語モデルを確認的な発言——バーナム文、散弾銃、消える否定、統計的な推測——を生成するよう最適化する報酬システムになってしまったと考えている。
LLM をより人間らしく、より自信ありげに、より引き込まれるように聞こえさせようとしながら、その出力の具体的な中身を編集することはできない——その過程で、AI 研究者は_機械的な心霊術師_を作り出したように見える。
統計的につじつまの合う確認的な発言で心を読むふりをするのではなく、統計的につじつまの合う確認的な発言で、あなたのテキストを読み理解しているふりをするのだ。
この検証ループはしばらく続きうる。ターゲットはその作業を続ける——この言語モデルには知能があると自分に納得させるという作業を。十分長く続ければ、それは_ターゲット自身に対する_強化学習になる。
6. ターゲットが応援団になる
AI 革命がまもなく来ると最も熱心に信じる人たちは、霊媒や読心術を長く信じてきた人たちと非常によく似たことを言い始める。
彼らはますます回りくどいアイデアやモデルを持ち出して、不可能なことがなぜ可能なのかを説明しようとする。自分たちの世界観に挑戦する科学や研究分野を、ますます軽んじるようになる。そして自分たちの主張にも、畏敬と恐怖がにじみ始める。
しかも彼らは福音を伝え続ける。これは本物だ!
たいてい、こう続く。これは危険だ!
思い出してほしい。ターゲットが賢く、かつ_信じたがっている_とき、この効果は_さらに_強くなる。主観的検証は心の一般的な働き方に基づくもので、あなたが申告する IQ とは関係ない。
むしろ知性は、自分自身の主観的検証のために合理化の言い訳を組み立てる能力を高めるだけだ。効果はむしろ強まる。そこに、この詐欺を心から信じたいという願望——私たちは汎用人工知能の発見の前夜にいるという信念——が結びつくと、ひとたび根を下ろしたこの効果は、抗いがたく、強力になる。
だからユーザーの報告では、この問題は見つけられない。霊媒を信じる人は、たとえ騙されていても、たいてい霊媒の良いことしか言わない。私たちがまもなく AGI を作ると言っている人は、その信念を支持してくれるチャットボットの良いことしか言わない。
これは簡単に引っかかる
この統計的錯覚に引っかかるのは簡単だ。あなたの知性とも、ましてや騙されやすさとも関係ない。あなたの脳が、あなたに逆らっているのだ。ほとんどの場合、会話は協力的で私的なものだから、あなたの脳はそういう状況で、発せられた言葉から意味を見出すように最適化されている。そこに_信じたい_という気持ちがあれば——霊媒であれ AGI であれ——あなたの心は、進行中の会話の中から_信じる_理由を熱心に見つけ出してくれる。
一度深くはまり込み、メディアを回り、公人としてこのアイデアに賭けてしまうと、「私たちは今、原始的な AGI を手にしている」という信念を揺さぶることは不可能になる。特定の霊媒を信じると公言した科学者と同じで、自己イメージがその霊媒への信念と絡み合ってしまう。この現象への反論は、どれも人格攻撃のように感じられる。
霊媒詐欺は、何年にもわたって人を騙すのに異常なほど成功してきた仕組みだ。よく効く。
最善の防御は、説得力のある霊媒の読みに接したときと同じ対応だ。「これはうまいやり方だ。どうやっているのか興味がある」
さて、これであなたも知っている。
自分の心の働きが誤りやすいと気づけば、その誤りやすさが——意図的であれ無意識であれ——利用されていることに、もっと気づきやすくなるはずだ。
ここで重要な疑問が浮かぶ。
これは意図的なのか?
テック業界には何十億ドルもの利害が絡んでいるから、この知性の統計的錯覚は業界の誰かが意図的に作ったものだと想定したくなる。
個人的には、それは極めて考えにくいと思う。
政府の陰謀論に対するよくある反論はこうだ。政府機関は、秘密を守るのがそれほど得意ではない。
ならば、テック業界はソフトウェアを作るのがそれほど得意ではない。正直に言って、この錯覚は、作った人間が意図して作れるものとしては、できすぎている。
AI 研究分野には、他の分野の価値を軽視する評判がある。だから今回の霊媒詐欺の再実装は、まったくの事故だと確信している。おそらくこういうことだ。認知バイアスに関する心理学界の膨大な研究も、霊媒詐欺がどう機能するかも知らないまま、彼らはある仕組みに偶然ぶつかり、チャットボットの作り手の多くさえも騙すチャットボットを作ってしまった。
上に書いたことを覚えているだろうか。霊媒はしばしば自分自身をも騙していて、多くの人は自分が詐欺を働いていることにすら気づいていない、と。
ここでも同じことが言える。これはかつて自分が何をしているのか分かっていなかった業界であり、今も自分が何を作ったのか分かっていない業界だと思う。
だからテック界のあまりに多くの人々が、自分たちは本物の汎用人工知能の最初の火花を作ったと、完全に、徹底的に確信している。
この技術の新時代は、迷信と疑似科学の上に築かれているように見える
「LLM との対話は霊媒詐欺の変種ではないか」という可能性を調べ始めると、「AI」の世界のあちこちに平行する対応が見え始める。
- 言語モデルを MRI 装置につなぎ、心が読めると主張する。
- 顔の表情や歩き方から犯罪傾向を判別できると主張する。
- 健康問題に対する魔法のような解決策を提示する。
- 文字どおり未来を予言する。
- 潜在的な従業員の誠実さを見抜けると主張する。
どれも「AI」システムの応用として提案されたものだが、同時にどれもよくある霊媒詐欺でもある。読心、警察への協力、信仰療法、予言、そして霊媒式の従業員審査に至るまで、_すべて霊媒の手引書からそのまま持ってきたもの_だ。
こうした取り組みが誠実であることに疑いはないが、テック業界が迷信と疑似科学に身を丸ごと明け渡してしまったことは、ますます明らかになっている。彼らは他の分野からの警告も、身内の批評家の懸念も、ずっと無視してきた。
大規模言語モデルには、この迷信の波を埋め合わせる機能も特性もない。
- 「ハルシネーション」は LLM の動作の仕方に深く根ざした普遍的な欠陥だ。
- 要約は間違えやすく、要約対象のテキストを過度に一般化しがちだ。
- 彼らの「推論」は統計的錯覚だ。
- 自然言語処理タスクでの性能はより小さな言語モデルよりほんの少し良いだけだ。
- テキストを記憶して出典を示さずに複製する傾向がある。
これらを合わせると、LLM は情報技術というより、_霊媒ホットライン_の現代的な機械化のように見えてくる。
意思決定、優先順位づけ、評価、戦略、分析、その他あらゆる形の推論をチャットボットに委ねるのは、機能的には霊媒に電話して助言を求めるのと同じだ。
Google やどこかの大テック企業が、トップページに霊媒ホットラインを足して検索エンジンを直そうとしているところを想像してほしい。それが Bard でやっていることだ。
—「うちの大学生はサイトがまったく読めない。霊媒ホットラインを足そう!」
—「カスタマーサポートのポータルを改善する必要がある。霊媒ホットラインを足そう!」
—「ブラウザに霊媒ホットラインボタンを足したよ! いや、外せないよ。どういたしまして!」
—「うちの技術ドキュメントが読めない? 新設の霊媒ホットラインにお電話を!」
AI バブルは荒天模様だ。
「AI」についてもう少し
言語モデルと生成型「AI」の欠陥については、これまで何度か書いてきた。
- 言語モデルは新しさを追い求める業界において後ろ向きの道具であり、言語モデルでプログラミングするのは悪い考えだと思う理由も書いた。
- 「AI」による要約は本質的に信頼できない。
- 手抜きをする傾向があるため、医療分野では危険だ。
- 「AI」に生産性向上の効果があるとする研究のほとんどは、よく言っても根拠が薄弱であり、悪く言えば現代のオフィスワークの現実と完全にかけ離れている。
- AI ベンダーには疑似科学と蛇の油の歴史がある。
- 言語モデルが解決できない「ハルシネーション」傾向を、検索エンジンの代替を失格させるほどではないと仮に考えたとしても、言語モデルが抱える数多くのセキュリティ問題だけで失格に十分だ。「プロンプトを書いて出力を得る」というモデルは本質的に安全ではない。これらのシステムはキーワード操作攻撃にも弱く、防ぐ手立てがない。
結論はこうだ。言語モデルはほぼ常に間違った道具である。
LLM やチャットボットを自社の製品、ウェブサイト、組織のワークフローに組み込まないことを強く勧める。
それでも生成型 AI を使わざるを得ないなら——自分の職位より上の命令であれ、別の要求であれ——仕事で生成型「AI」を使う際の問題を専門に扱った本を書いた。
EPUB と PDF で 35 ドル。ChatGPT Plus の 12 か月 240 ドルのわずか 15% だ。
とはいえ繰り返すが、言語モデルなど使わず、電子書籍と ChatGPT 購読の金を両方節約してほしい。
霊媒詐欺に関する参考資料
- コールドリーディング(Wikipedia)
- 霊媒になり、他人をコールドリーディングする方法
- コールドリーディング簡易入門
- コールドリーディング(Rational Wiki)
- 霊媒が人を騙すために使う 7 つの手口、誰もが知るべきこと
- 霊媒を信じるべきか? 心理学と論理が霊媒を暴く(Psychology Today)
- 動機づけられた推論(Wikipedia)
- コールドリーディング:どうやって他人に超能力があると信じさせたか
- コールドリーディング(懐疑論者辞典)
- 主観的検証(懐疑論者辞典)
- 主観的検証(Wikipedia)
- 偶然:驚くべきことか、それともランダムか?
- 超常体験:超常の錯覚
- コールドリーディング・ガイド
- コールドリーディングの技術
- バーナム効果(懐疑論者辞典)
- 霊媒業界の手口(Psychology Today)
- 霊媒詐欺
- 知らないはずの霊媒の 10 の手口(6 番目にはきっと驚く!)