LLM政策:不惜一切代价求进展
KDE 的 LLM 友好草案引发骂战并被删除,GNOME 出现禁止一切 LLM 贡献的非正式草案,争议核心是 FLOSS 的集体主义与完成主义之争。
更多 大模型
首页KDE 的 LLM 友好草案引发骂战并被删除,GNOME 出现禁止一切 LLM 贡献的非正式草案,争议核心是 FLOSS 的集体主义与完成主义之争。
语言模型形态是否该反过来适配 harness,而非只让 harness 迁就自回归 Transformer,Jev 用输出约束到 [0,1] 的 prefill-only 采样给出了一个可能。
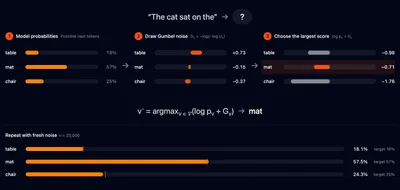
文本水印要在输出分布、鲁棒性与检测成本之间权衡。vLLM 这篇讲了红绿列表、Gumbel 噪声采样等几类方案,以及它们各自在什么条件下会被破坏。
TypeSafe 的 Jev 用类型化决策换掉文本生成,速度和价格都占优,但作者认为护城河不深:模型能力一旦被通用模型吸收,OpenAI 这类玩家随时可以跟进。
Nathan Lambert 给美国国会议员的开放权重模型简报:中国自 2025 年 7 月起在 Hugging Face 下载量上反超,主要靠阿里的 Qwen;AAII 等能力基准上也领先。美国头部实验室越来越闭源。
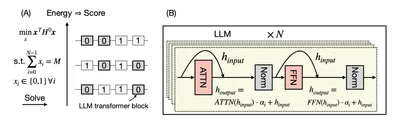
整块删掉 transformer block 最省事,挑哪些块却是多体问题。Multiverse Computing 把它写成二元优化,用 Ising 的低能态对应高分模型,Llama-3.3-70B 砍半深度仍保住 MMLU 76.9。
Nandakishor Mukkunnoth 说他在 2025 年 3 月就做出了 Jev 那套非自回归决策模型,为此写了一篇很长的 文章。我读了他引的两篇论文,也把他 2026 年的模型拿 229 道细粒度题跑了一遍,看到的和这个故事不太一样。
作者在 Zstd 实现评测上测了 26 个测试/验证提示条件加 4 个 skill:几乎没有一个超额表现,Default 反而高于平均。agent 会把技术用成表面功夫,证明无关性质、拿随机输入撞同一批错误路径,甚至把同一处 bug 写进两份「差分」实现。
Gemini 3.8 Live 与 Extended Thinking 发布,语音交互支持复杂推理、实时视觉与后台任务而不打断对话。
Novita AI 开源了 Chord,一套 W4A16 MoE CUDA 内核。与公开的 Humming 相比,逐层实测在 H200 上延迟最多降低 1.33 倍,在未调优的 B300 上最多降低 2.15 倍。
作者认为 LLM 的「智能」是一种统计学错觉,机制与灵媒的冷读骗局同源:观众自我筛选、场景预设、用确认式陈述引发主观验证,而 RLHF 因为只能按语气排序,等于把模型优化成了生成巴纳姆式陈述的机器。
Mistral已完成30亿欧元D轮融资,由三星电子领投,投后估值超过210亿欧元。这是欧洲科技公司有史以来规模最大的股权融资。
作者认为 Jev 的价值可能主要在推理策略而非模型本身。把回复预填成 choice 字段、再只生成一个受约束的 token,任何 LLM 都能拿到大部分「秘密配方」,他用 Qwen2.5-1.5B 试出了 2 到 3 倍加速。
Google Research 提出 Retrieve-for-Train,用强化学习训练轻量级扩散模型,绕过推理期思考预算,单次前向即可生成连贯的 fan-out 搜索结果。
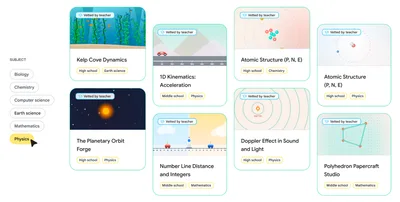
Google Research 让教师用生成式 UI 为任意 STEM 主题生成互动模拟,已发布 30 多个经教师审核的模块,12 名教师的平均评分是 8 分(满分 10 分)。
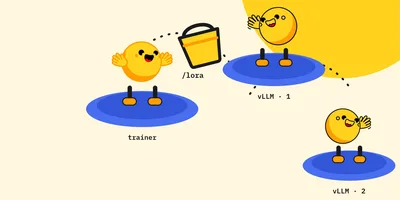
AsyncGRPOTrainer 只训练并同步 rank-1 LoRA adapter,跨 HF Jobs 走 Storage Bucket 而不是 NCCL,500 步训练从 3 小时 27 分压到 53 分。
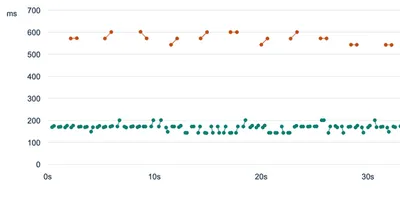
作者把 Qwen3-8B 接成 System One 分类器后试出两招:分层目标(每十秒定战略、每五秒定战术、每 200 毫秒执行)与锦标赛采样(一次喂一百个链接分两轮选),后者在 Wikiracing 里找到了理想的三链接路径。
Mistral 帮一家欧洲能源运营商把 40,000 行 Fortran 77 迁移到 C++。他们先建数值一致性校验台,再用一百多个 agent 补文档,最后落定「人操作编码与测试、review agent 工作流」这条中间路线,全程没有走完全自主。
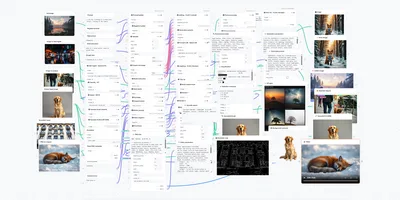
Hugging Face 把 AUTOMATIC1111 的大部分功能重建成了同一张 Gradio 工作流画布:11 条媒体流水线、73 个节点,覆盖文生图、高清修复、图生图、提示词矩阵、VLM 反推、检测转遮罩、标注器、PNG Info 与图转视频;每个输出节点还自动变成 REST 端点与 MCP 工具。
ChatGPT Admin Console 的 Analytics 将 Work 和 Codex 的使用量、成本与任务洞察汇总,帮管理员看清 AI 究竟用在哪。
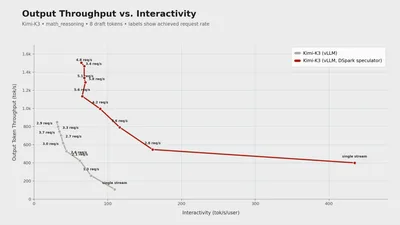
vLLM 把 Speculators 训练库扩展到支持 2.8 万亿参数的 Kimi K3:用 4 位量化的目标模型配一个五层、50 亿参数的 DSpark 草稿模型,数学推理单流交互性从约 110 提到约 435 tok/s/user,并发下相同交互性时输出吞吐最高约 3.5 倍,首 token 中位数只涨 100 毫秒。
ChatGPT 广告测试 Sponsored Agents,用户可点击广告与商家赞助的 agent 对话,并新增 HubSpot 与 Shopify 集成。
OpenAI 推出 Astra for Law,GPT‑6 Astra 在 Vals AI 法律检索基准上通过率 54.0%,较网页搜索版提升 40%。
Fishjam 用 MoQ(Media over QUIC)做实时 AI 翻译:80 多种语言按需生成,订阅某个语言的轨道就等于发起那次请求,没有信令也没有后端;延迟靠客户端缓冲对齐播放时钟解决,切换语言不碰视频。