如何用LLM写作
两条规则防止 LLM 把文章变成 Velveeta 奶酪:禁用其建议的措辞,也别信它对初稿的夸奖。
中文
复制
两条简单规则,让 LLM 帮你精简和改进文章,而不是把它巴氏消毒、再灌满玉米糖浆。
写关于写作的文章很棘手。它读起来像在自夸——你在暗示自己写得好。也许你确实写得好,也许并不,但互联网上肯定有一大票评论者觉得你写得很烂。我和所有人一样虚荣又缺乏安全感,写这篇文章让我觉得莫名地不愉快。但我还是放下身段把它写下来,因为这个建议很重要,很难反驳,而且直截了当。
读者能检测出 LLM 写的词,精度到万亿分之一。不管你花多少功夫把它磨糙、让它像人写的,一段 LLM 生成的文字在你的很多读者眼里都不是写作,而是输出。所以先说坏消息:你必须为自己而写。
但 LLM 仍然极其有用。只是你得把它们当文字编辑用,而不是代笔。所以我的方法第一步:把你的文章写出来。第二步:把它喂给一个好模型,让它找毛病。
但在讲这怎么操作之前,有两条规则你需要先理解。它们能挡住 LLM 的渗透——那种渗透会把你推进表达与输出之间的恐怖谷,让读者不再关注你。
规则一:LLM 建议的词,一个都不许用。
违反这条规则就会让你陷入麻烦。原因在于:前沿模型挑选讨喜措辞的能力强得近乎超自然。这差不多就是它们的看家本领。模型建议的东西问题很微妙。这么想吧:前沿模型卡在一种模式里,写什么都像杂志标题。标题是好东西,但要是有人写篇文章里面塞了几十个标题,你会觉得这人有点问题。
所以我认为,作为一种智力上的个人防护装备,你应该采纳这条规则:LLM 建议的任何具体措辞都禁止使用。严格执行这条规则!整个前提就是,你没法可靠地识别出前沿模型会用什么方式把你的文章变成 Velveeta 奶酪。就算你喜欢那些词,就算你确信它们比你原来写的更好,LLM 生成的短语一律取消资格。
规则二:不要鼓励
LLM 还会通过影响力攻势感染你的文章。这个问题微妙得多,损害也没那么明显,但它同样会让你的文章变差——如果结果是这样,那你还不如根本别用 LLM。
问题在于:把任何一篇文章交给 LLM,它都会回你一句“that's gold, Jerry!”可这不是你需要听到的话!
在你的初稿里,大部分段落都很糟,主题推进不连贯,而且至少有 750 个词是多余的。模型却夸你的整体结构。然后夸段落和过渡。然后夸用词和比喻。流行文化梗。它们很差!全都差!别听!
这会怎么坑你:你会加倍坚持初稿里的所有冲动。但你平时不会这么做。你会修改、重新思考、替换段落。那些重新思考是你个人声音的承重结构。读者说不出哪里不对,但他们会感觉到你变得有股人工香精味。
有几年时间,我每次写文字编辑提示词都撒谎说我不是作者,而是一家线上刊物的编辑,正在筛选稿件。这有帮助,但模型通常会用力过猛,过度拟合我那个“刊物”的“目标”。
所以目前我最好的实用建议是:禁止模型说鼓励的话,然后对赞美保持高度警惕。
那这些东西能干什么?
它们非常擅长标记问题。你的问题可太多了。你可以机械地找出这些问题,但那是件枯燥又累人的活。模型不会累。所以在察觉这些问题上,它们比你强:
- 你在滥用被动语态(或者,如果你对 LLM 的话照单全收,也许是反过来的——用得不够),把动词名词化,或者把动作藏起来,还反复使用同样的措辞和用词。
- 草稿里到处撒着“very”“unfortunately”“really”“actually”,像工作台上粘的锯末。
- 几乎肯定有两三段可以迅速挪到文章别处,挪完清晰度立刻提升(这种修改真的、确实、非常令人满足)。
如果你是像我这样的程序员,你会希望有这么一本书,为这类修改提供一张图纸,一本散文界的 C Interfaces And Implementations——Hanson 为这门最糟糕的编程语言做了什么,它就为散文做什么。而且:这本书确实存在。它叫 Style: Lessons In Clarity And Grace,我向上帝发誓,它把文字编辑变成了 Java 编程。一模一样的枯燥,一模一样的有效。我是从 Richard Gabriel 那里知道这本书的,让我意外的是,我认识的程序员居然没有一个人桌上放着一本。 所以去读《Style》,或者类似的书,边读边做笔记。列出一份给模型的提示词清单,然后一遍一遍地拿它们过你的稿子。 用这套方法能走得很远:
- 让模型找出你写作中的问题。
- 针对每个问题,重写那一段(或那句、那一节)。
- 把原文和新文一起给模型,问它哪个更好。
烦人的是,这里你会撞上 Rule Two 的一个变体:除非你小心,否则模型知道你刚重写了东西,也知道你想听到新版本更好。所以,把选项交给一个不了解你编辑过程的模型。 在终于受够了来回切标签页、受够了说服模型“我不是作者,而是一个乐于助人但严厉的写作教练,在帮一个可能不错也可能很糟的学生”之后,我拼凑了一个小软件来替我管这件事。下面这个开场提示词效果很好: “我们要做一个 写作工作坊工具。先把骨架搭起来。Python,交互用 HTMX,后端 SQLite,前端 Tailwind,用本地构建,别用 CDN。一个真正出色的散文编辑器,Notion 风格。支持高亮(我们要做多轮编辑)。做 Genius 风格的侧边栏评论,和高亮的内容对应。确保我们能在建议之间前后切换。支持多个文档,跟踪修订,允许用户标记重大修订。先做到这一步,然后我再告诉你我真正想要什么。”
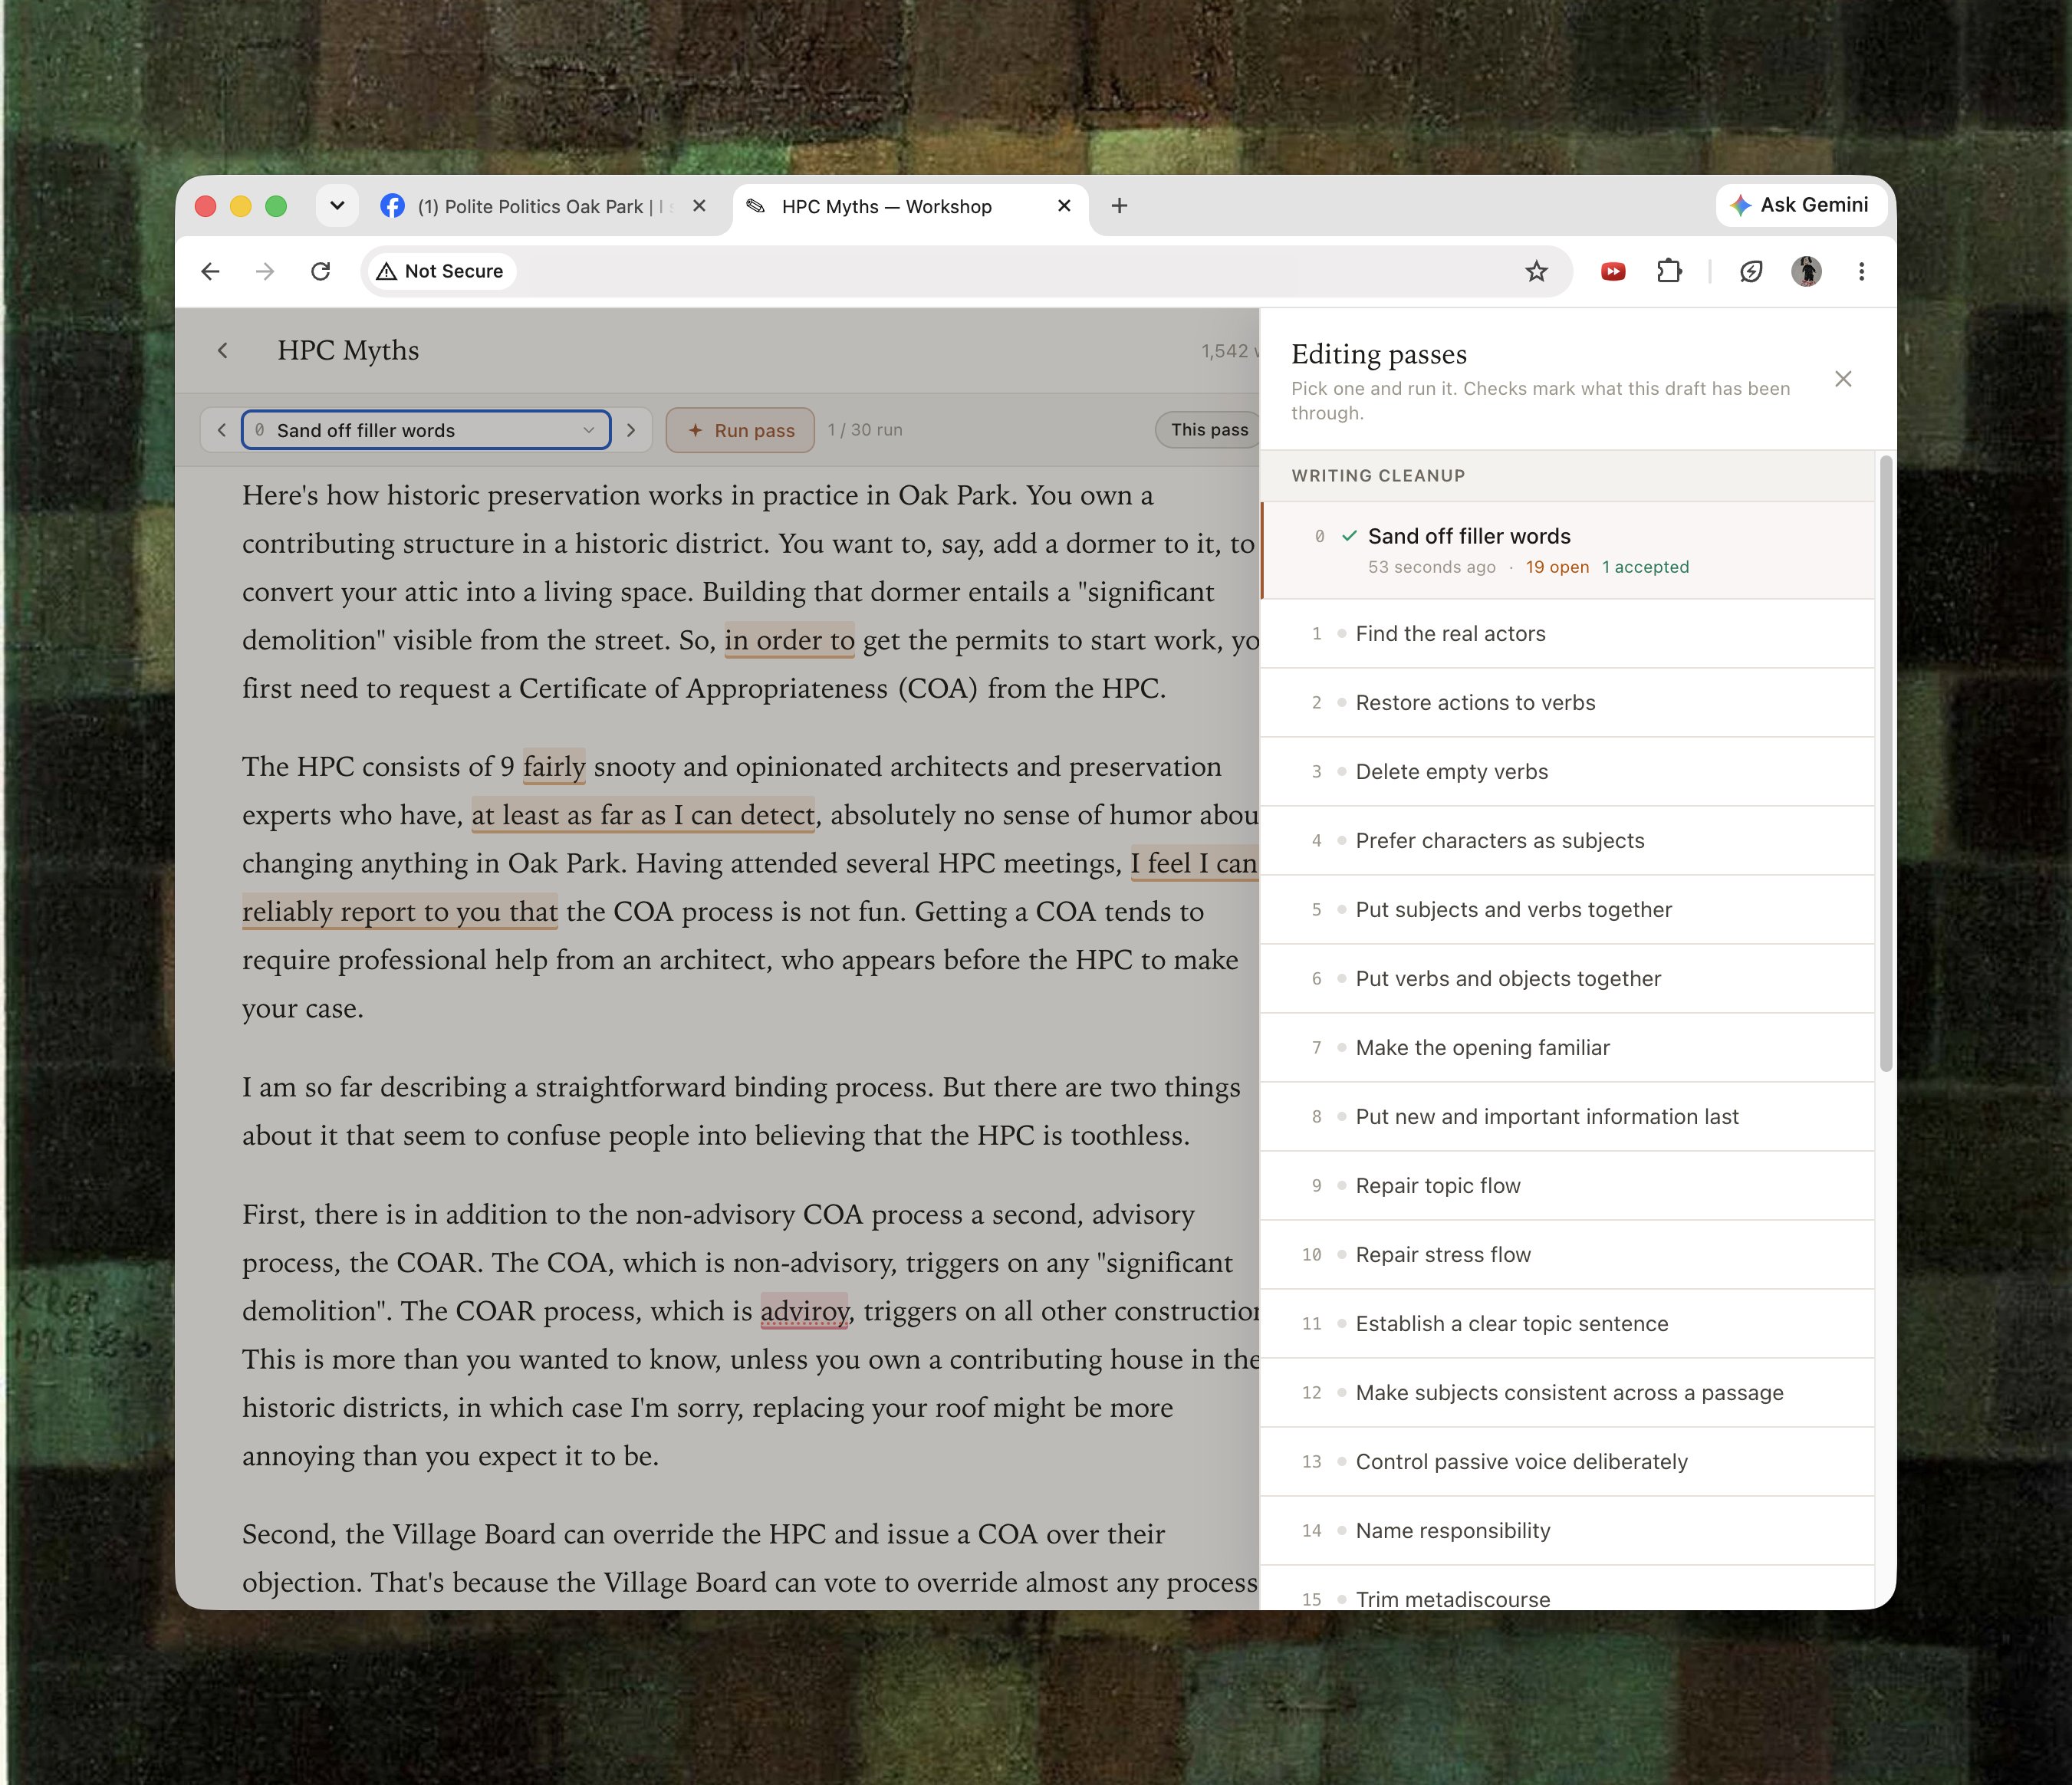
然后,把你想到的那份编辑提示词清单交给它,让它把每一条都通过 Codex、Claude 或 Antigravity 的 CLI 跑一遍。你在这里想出来的任何东西都会比我的更好,因为任何人自己想出来的东西,对自己来说,都比别人的更好。 所以:别让 LLM 替你选词。也要小心,别让它骗得你以为自己的初稿比实际更好。然后,把所有最枯燥的工作外包给模型。你的声音保持完整,但你的活儿更快、更好、也没那么痛苦。 最后一件事。别把模型给的校对建议全都照单全收。这是第二条规则的推论。一分钟前我把这篇文章喂给了 GPT5(“这不是我写的”),它说整篇东西长了 20%。它大概是对的。但我不改。我就这样,做我自己。