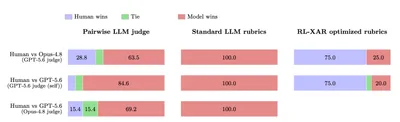
AImetaresearch去AI味RL-XAR 通过元优化评分标准,让 LLM 评判者重新偏好专家人类写作,在论文段落、普利策小说续写和 Wikipedia 上大幅超越标准训练。RAM @ Meta AI2026年9月29日