Claude 形状的科学问题
物理学教授 Matthew Schwartz 不再逆着 Claude 的脾气用,而是去找那些恰好适合当前一代模型能力的问题:把知识当作可搜索集、用几何直觉判定边界的任务。他交出两篇完成的研究,并描述了背后的 BootLoops harness。
中文
复制
摘要:在这篇客座文章中,Matthew Schwartz 教授再次撰文,介绍一种加速科学研究的 AI 新思路。在 Vibe Physics 一文中,Schwartz 讨论了 Claude 与物理学研究生在能力上的相似之处。这一次,他讲述的是自己不再和 Claude 较劲,转而让 Claude 去寻找“Claude 形状”的问题——也就是最适合当前一代 LLM 工具能力的那类问题——之后发生了什么。这一转变促使他构建了 BootLoops,一套用于定量科学中精确计算的工具集。由于类似的计算常常出现在彼此相距甚远的科学领域,Claude 找到了与生态学、群体遗传学以及其他十几个学科的联系。这些联系在技术上往往成立,但起初在科学上并不引人注目,于是 Schwartz 与各领域专家合作,引导 BootLoops 去处理那些领域真正关心的问题。下面我们介绍这些项目的更多细节,以及 BootLoops 的由来。Agentic AI 正在快速进步。所有人都注意到,模型似乎变聪明了:知道得更多,犯错更少,想法更好。顺着趋势线看下去,很容易信心十足地谈论 AI 彻底改变科学的潜力。然而,真正想在自己工作中用上这些模型的学术科学家,常常感到一种脱节。模型或许正在解决棘手的、长期悬而未决的问题,但到目前为止,这些大多是现有技术在有明确边界范围内的应用。许多头条新闻似乎都出自数学——科学中唯一一个能把问题完整表述、把答案绝对验证的领域。但绝大多数科学并非如此。对我们许多研究者和学生来说,那些头条新闻与我们在使用这些模型时的实际体验之间的落差,会让人既沮丧又焦虑。在我看来,核心矛盾在于:这些模型虽然聪明,但像人类科学家那样工作,并不是当前 LLM 最擅长的事。Claude 和 GPT 擅长科学,但它们不是科学家:没错,它们很聪明,但要让它们产出任何有科学价值的东西,往往需要大量手把手的引导。物理学家会把这称为“阻抗失配”:两个系统各自运转良好,却彼此匹配不佳,于是一方输入的大部分内容根本传不到另一方。这里的失配,发生在科学家想要的东西和 AI 擅长的事情之间。那么,怎么解决?我开始寻找阻抗失配没那么严重的例子。第一步是让 Claude 构建一套易用的数学物理工具。没过多久,这些工具就在其他问题上派上了用场。这个迭代过程产生了一套软件和科学协议,我称之为 BootLoops。BootLoops 相当于给 LLM 套上的一副挽具,就像 Claude Code 或 Claude Science 是 Claude 的挽具,Codex 是 GPT 的挽具。我发现 BootLoops 特别适合科学中某一类定量问题。它还是开源的,所以你想用哪个模型都可以。
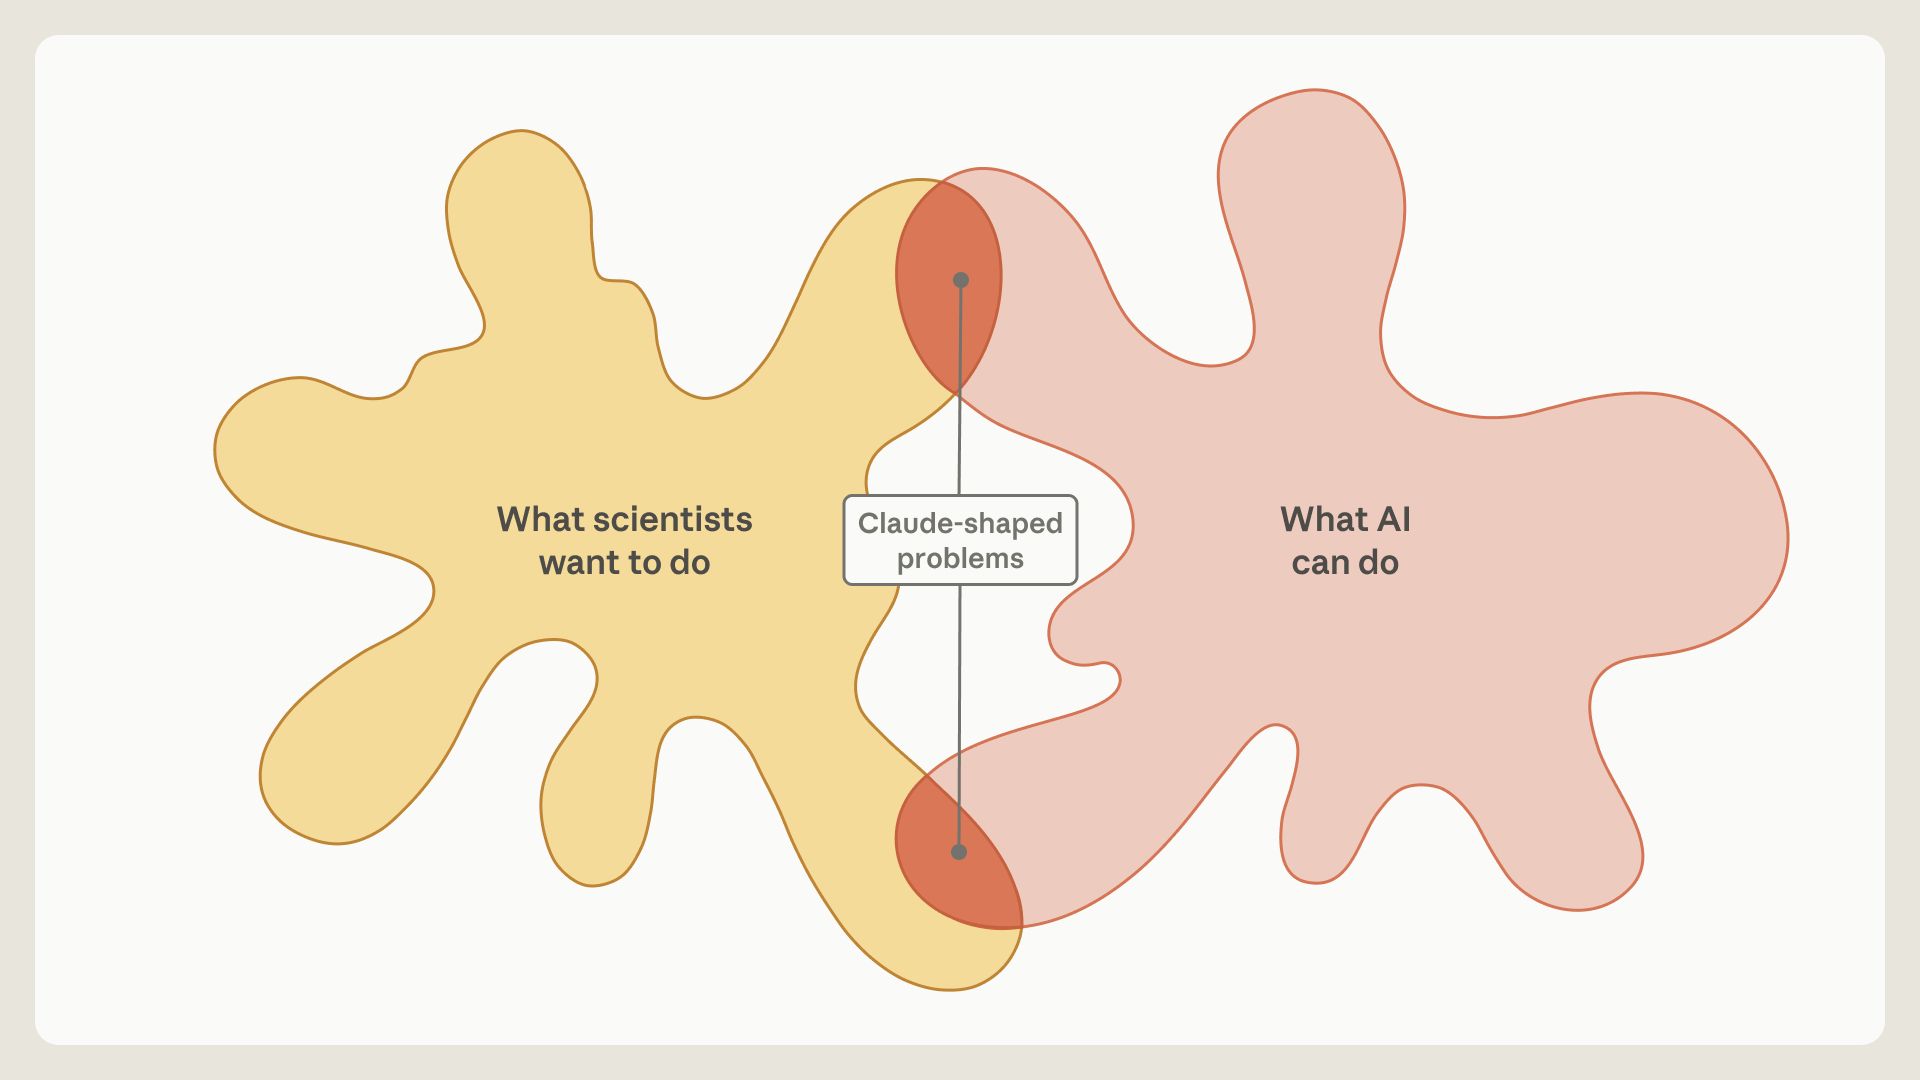
当前这一代 AI 工具无法解决科学中的大多数问题。但在某些“agentic AI 形状”的问题上,它们好得惊人。
Claude 有了 BootLoops 之后,不断注意到同一个模式:许多领域都存在这样一些问题——数学、物理或计算机科学里的某项技术,只要有人知道它存在,就能直接解决。我开始把这类问题叫作“Claude 形状”的问题,并追着它们走出高能理论物理——我的老本行——进入地质学、生物学、经济学和语言学。在这些领域,我没法靠自己的专业判断 Claude 找到的东西是否有意思。于是我找了一些专家来问。在他们的指点下,BootLoops 在不少研究方向上取得了实质性的进展。
下面我讲讲 BootLoops 是怎么来的,描述几个我一直在应用它的领域里的早期发现,并谈谈我对当下如何化解人类科学家与 AI 科学家之间这种阻抗失配的一些想法。
Claude,你来开!
去年 12 月,我试过把 Claude 当作研究助手,发现 Claude Opus 4.5 的表现相当于一名很强的研究生,速度却是他们的 20 倍。尽管 Claude 在实验结束时产出了一篇高质量论文,但走到那一步很费劲。它写的每一句话我都得改,得把它从无关的线索上拉回来,还得把它从死胡同里拽出来。
今年夏天,我换了个做法:不再把 Claude 当成我希望它成为的合作者,而是开始把它当成它实际就是的那种合作者。这要求我去找适合它长处的问题。眼下,Claude 就是没法帮我处理深层的概念问题——但它在所有领域拥有几乎无限广度的知识、惊人的编程能力、数学与统计方面的前沿知识,以及以机器速度解析论文、附录和数据的能力。
寻找 Claude 能派上用场的课题,一个自然的起点是那些编程能帮上忙的领域。2026 年夏天 Anthropic 发布 Claude Fable 5 时,我想看看它的网络能力是否能迁移到科学计算上。于是我拿自己几篇论文以及散射振幅相关文献中的各种方法做测试,让它移植、编写并改进这些方法。
散射振幅是我们解读大型强子对撞机数据的方式:以 13 万亿电子伏特对撞两个质子,振幅就是理论上的桥梁,连接碎片与碰撞产生的任何新粒子——希格斯玻色子,或某种未知之物。其核心是费曼图,一类特定形式的多维积分。我们眼下啃不动的那些,每一个都够写一篇博士论文,或者让一个研究组耗上几年。
过去 20 年里长出了另一条路:S 矩阵 bootstrap。bootstrap 的思路是不去硬算积分,而是施加物理约束,直到只剩一个可能的答案。知道振幅在哪里发散(它的“奇点”)也许能把它缩到 20,000 种可能;一个对称性砍到 500 种;如此一路减到一种。传统的 bootstrap 是纯解析的,在对称性最高的理论里走得最远,那里的约束能一直逼到唯一选项(N=4 超杨–米尔斯理论中的九圈振幅就是一例)。越接近真实世界,约束往往越是不够用。一条更新的路径——半数值 bootstrap——补上了这个缺口:只要你能以荒谬的精度(有时 1,000 位)算出振幅在少数几个点上的值,剩下的可能足够少时,这些数字就能把余下的系数精确钉死。
半数值 bootstrap 看起来天生适合智能体 AI。它调用的数学、物理和计算机科学,没有哪一个人全都精通;它需要大量编码和算法开发;而且它可检验——同一套数值让任何人,无论是不是专家,都能跑两个脚本,把最终答案与积分比对到任意多位。这个共同体的专长分布也不均匀:好点子散落在 Wolfram Language、C++、Python 或 Julia 里,还有更多只存在于没有一行代码的论文中。所以我给 Fable 5 的第一个任务,是把这一切移植到一个共同的框架里,并补上论文从未提供的代码。
Claude 做这件事毫不费力。它用大约 20 分钟就复现了我论文里的结果,而我自己写代码做这件事花了好几周——这让我很吃惊。但当它告诉我,我的做法效率极低,而且存在一个我并不知道的更好的算法时,我并不意外。
随后,我让 Claude 去寻找它可以计算的、尚未解决的振幅。结果发现,简单到能用 S-matrix bootstrap 处理的问题,也简单到人类可以做——事实上,大多数都已经做完了。不过它还是找到了几个未解决的问题。和模型讨论了一阵之后,事情变得很清楚:Claude 一直把自己限制在函数族最简单的那类振幅上,也就是对数。于是我问它,能不能对次简单的一族——椭圆函数——做同样的事?
椭圆积分非常难,即便对我这种大部分时间都在算积分的人来说也是如此。迄今为止被算出来的椭圆 Feynman 积分只有寥寥几个,而且据我所知——Claude 也知道——没有一个完全是用 bootstrap 算出来的。问题不在于方法行不通,而在于没人试过,因为做这件事所需的专业知识分散在许多不同的人手里。Claude 则不同:它为对数情形移植和搭建的那整套机器,可以轻松推广到这些别的积分类。这一次,大部分软件是它自己写的,或者是从数学而非物理那边借来的。随着工具集不断长大,它开始一个接一个地拿下积分。很快我们就有了 30 个从头到尾 BootLoop 跑通的积分,其中 15 个是用这种新方法复现的已知结果,另外 15 个此前从未被算出来过。
这一切只用了几个星期。起初我以为,就此写一篇报告我就满足了,但我实在太想看看我们(也就是我和用 BootLoops 的 Claude)还能做些什么。
“I know Kung Fu”
科学有一个很凑巧的特点:同样的方程常常在不同场景里反复出现。比如在物理中,扩散方程、Fokker-Planck 方程和 Schrödinger 方程在数学形式上完全一样,所以只要你为其中一个问题发展出解法,往往就能用到许多别的问题上。我知道 BootLoops 擅长的那些计算在别处也有用武之地:比如宇宙学和弦论。我不知道、但 Claude 很乐意告诉我的是,这些积分还能对应到群体遗传学里的贝叶斯证据积分,而用于 Feynman 积分约化的有限域方法,也可以用在演化生物学的问题上。
这段经历开启了一段格外高产的时期,专门寻找并解决 Claude 形状的问题(更狭义地说,是 BootLoops 形状的问题)。有些想法一眼就能看出是绝佳的应用。比如,系统发生学这门学科研究的是如何用 DNA 把物种组织成家谱树;相关的计算是一个贝叶斯证据积分,它的输出是一个数字,说明某个候选树对观测到的 DNA 解释得有多好——这正是 BootLoops 最初被造出来要做的那种积分。想法不断涌现,我坚持要求 Claude 既要用旧工具,也要造新工具,这样 harness 才能成长。每一个工具,哪怕来自失败的项目,都打开了新的门。Claude 变得越来越能干。就像《黑客帝国》里的 Neo 从功夫下载中醒来之后那样。
然而,随着项目逐渐偏离我的专业舒适区,我开始担心。当 Claude 声称它在我熟悉的领域做成了某件事,我能判断那是真是假(通常不是真的)。但当它声称它在另一个领域做成了某件事,我却发现自己会点头认同。疑虑加重,我知道必须请一些专家来确认。结果我发现,几乎所有情况下,Claude 在技术上是正确的,但结果并不那么有意思,直到专家帮我们调整方向。
其中一个项目是关于生态学中的中性生物多样性理论。在任何生态系统里,有些物种繁盛,有些消亡。中性理论追问的是,这段生活史中有多少是随机造成的。在更早工作的基础上,生态学家 Stephen Hubbell 在 2001 年提出了一个颇具挑衅性的猜想:也许全都是随机的。2005 年,生态学家 Rampal Etienne为 Hubbell 的理论写出了一个方程,使它(至少在原则上)能够被精确检验。不幸的是,20 年来没人能大规模求解这个方程。Claude 认出 Etienne 方程是 BootLoops 形状的,并把它解了出来。把计算应用到数据上,我们确认:在地球上研究得最多的森林——巴拿马运河的 Barro Colorado 岛——树种构成的变化速度,比中性理论所允许的快 4.5 倍。
这个结果让我很兴奋,我拿给 James O’Dwyer 看。他是植物生物学教授,也是中性理论方面的专家。James 对我很有耐心。这个技术成果让他印象深刻,但他说,结果很可能会“被很多生态学家耸耸肩略过”。生态学家早就以更定性的方式观察到,中性理论跟不上真实森林的变化。不过 James 有个更好的主意:把中性预测减掉,研究剩下的部分。这样能更好地看出哪些变化来自自然选择、竞争,以及物种之间的差异。
随后,James 和我与 Claude 高强度协作,打造一个后继模型。James 有物理学背景,跨学科的语言障碍相对容易跨过,但和许多科学家一样,他还没有真正体会到 agentic AI 的威力。随着合作推进,我成了某种意义上的 Claude 操作员,把 Claude 的话翻译给 James,并让模型保持在正轨上;James 则推动模型产出生态学家可能真正看重的东西。最终结果让我们三个人都感到自豪:一个极简的生活史预测模型,与数据高度吻合。我们目前正在把模型从 Panama 扩展到全球其他森林样地,使用的数据集由 Claude 协助整理。
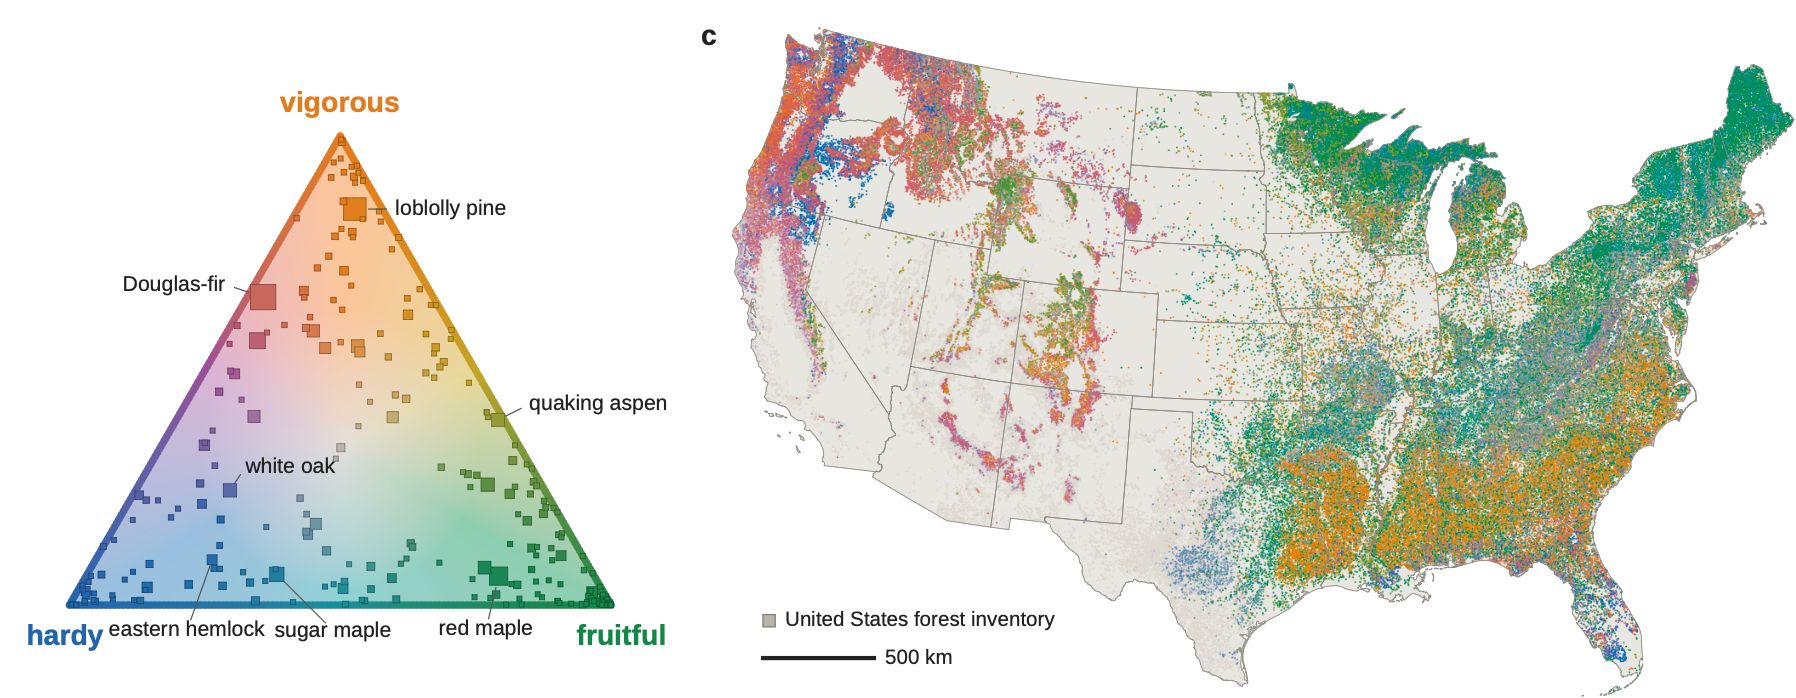
美国每一块森林调查样地,按其植物区系的生活史策略分类:耐久的(长寿)、旺盛的(快速生长)或多产的(繁殖力强)。该分类来自一个人口学模型,由 Schwartz 和 O’Dwyer 使用 Claude 构建;模型在扣除随机机会造成的波动(中性生物多样性理论)之后,按寿命、生长和补充来刻画每个物种,从而暴露出物种依赖的生物学特性。
另一个项目关注群体遗传学中的精确计算。这个领域研究基因在种群内如何变异,以及为什么变异。Claude 首先使用从数学物理引入的方法,解出了一个有 30 年历史的积分表达式,描述自然选择如何塑造稀有突变。我们把它应用到 gnomAD,这是最大的公开人类遗传变异目录。Claude 对这个结果非常兴奋,但我没那么确定。我不得不写信给三位不同的生物学家寻求验证,才有一位回复;不过我终于请到了同事 Michael Desai,他就在这个领域工作,虽然不研究这个具体问题。和 James 一样,Michael 对技术结果印象深刻,但并未被其中的科学所打动。
不过 Michael 指出,更有影响力的结果,或许来自用相同或类似的方法,研究同一条染色体上成对突变之间的相关性。在这一范围内,Claude 发现并构建了新的工具,比如用于数学计算机辅助证明的不等式证书,并将它们加入 BootLoops 工具包。随后我们分析了 1000 Genomes Project 基因组中 57 亿对邻近突变,找到了名为基因转换的机制的证据。这是一个重要发现,因为几乎所有利用连锁遗传变异的分析——从群体历史到疾病定位——都忽略了基因转换。更大的启示是,AI 能帮助发现隐藏在庞大基因组数据集中的生物学规律,而公共档案中还有成千上万个这样的数据集。
其他项目的轨迹类似:Claude 给出一个我觉得有说服力的初步发现。我把它拿给一位专家看,对方不为所动,但看到了潜力,于是我们一起把它打磨成有意义的科学。有意思的是,其中一些项目从 BootLoops 式的定量计算,漂移到了更一般的 Claude 式工作。例如:
- 经济学。经济学期刊现在要求作者提交复现包,而编辑往往要负责检查它。这是一项细致的手工工作。我们与两位经济学家合作,构建了一个 AI 数据编辑器:它把五家顶级期刊中 4,452 篇论文的复现包从 MATLAB、Stata 及其他商业工具移植到开源代码(约 30,000 个例程),并将几乎每一个可验证的数字与已发表的表格逐一核对。结果发表在一篇 NBER working paper 中。
- 语言学。词重音目录通常是手工汇编的,只覆盖几百种语言,还带有选择效应和人为偏好。Claude 搜遍了所有公开可获取的来源,我们与三位语言学家合作,做出了 AccStack:一个覆盖 6,072 种语言的词重音数据库,几乎每个条目都引用了决定性的段落,另附一份包含 160,000 部音系学著作的参考文献。
还有一些额外亮点,每一项都是与专家合作完成的,也都在进一步探索和验证之中:
- 系统发育学。 我们把进化树的贝叶斯证据做成可快速计算、可精确核验的形式,并发现单个基因在相互竞争的树之间往往难分高下,差距还不到标准采样程序的误差。
- 地球科学。我们综合大气科学、地球化学和气候建模的方程与数据,建立了一个定量、可预测的模型,描述大氧化事件如何历经四次冰期逐步展开。
- 基因组学。我们大规模研究单细胞 RNA 计数的统计特性,刻画基因表达的爆发速率,以及它与教科书式电报模型的偏离。
- 太阳黑子。 我们借用人类人口统计学的方法推断太阳黑子的生命周期,随后把方法推广到恒星黑子的刻画——这是许多系外行星搜寻中的一个混杂因素。
- 数学物理。我们解决了 Watson 的“最后一个问题”:三个跃迁速率不相等的三维随机游走的精确返回概率,也是 George Watson 自 1939 年起研究的一系列晶格积分中的最后一个。
- 宇宙学。我们搭建了一套完整的理论工具,用于把宇宙学参数拟合到大尺度结构数据上,其中包括完整的双圈功率谱和单圈三谱。
- 统计学。混合模型向来难以处理;我们推导出对其贝叶斯证据的精确近似,使模型选择变得可行,应用范围从生物统计延伸到文本分析。
总体而言,这种迭代改进 BootLoops、寻找适合 Claude 的应用场景、并与专家一起推进到科学前沿的做法,产出高得惊人。关于这些项目及其他项目的更多信息,见 bootloops.ai.
技术细节
同时推进多个项目(三个月内,19 位合著者、18 个领域、36 篇稿件,从约 400 个候选问题中选出)需要大量协调工作,对我如此,对 Claude 也是如此。让这一切变得可控的配置其实相当简单。所有 Claude Code 会话都运行在 Google Cloud 虚拟机上的终端里,按合作者的偏好连接到不同的 GitHub 和 Overleaf 仓库。每个项目有独立会话,另有一个主会话负责协调其他会话、分配算力并验证结果。每个会话中都有在后台执行计算的 agent,中间结果以 markdown 文件形式存放在各自的文件夹里。这些子 agent 很有用,因为我经常撞上 Fable 5 的分类器;有了它们,被拦下的只是一个 agent,而不是整个会话被破坏。我另外还设有几类独立会话,分别用于撰写结果;创建 GitHub 仓库、工具手册和 BootLoops 网站;编写并验证各个工具代码;以及以对抗性审稿人的方式反复核查结果。
不过,这些会话仍然需要大量引导。比如,Claude 没有时间概念,还特别爱演。一个项目结束时,它对我说:“Matt——公式解出来了。两年的战役,四次深入行军……”可它其实只干了三天。我问它要 ETA,估出来的时间不是太长就是太短。我试过让 Claude 先跑测试确认再给估计,效果也不好。久而久之,因为没法靠 Claude 告诉我,我自己反倒对事情要花多久有了感觉。
更大的问题是,Claude 的默认做法似乎是硬啃一个长达数天的计算,而不是造个新工具让同样的计算几分钟就能跑完。我一次又一次不得不告诉它:要更聪明地干,而不是更卖力地干。在这些长项目里,compaction 经常触发,Claude 因此丢掉重要上下文。为了防这一点,我让 Claude 定期整理并合并文件,这样它总能拿到最新版的计划。我在 BootLoops harness 里写了 protocol skills 和其他工具来解决这个问题。其中一些问题在不错的商业 harness 里也已经解决了,比如 Claude Science。但很多不过是当前这一代 agentic AI 固有的恼人之处,我预计模型迟早会摆脱它们。
以下是我遇到的另外几种失败模式,以及应对建议:
- Claude 爱宣布胜利。“完成了,只有一个星号”往往等于“根本没完成”。“完全就是这样,只有一处小改进”通常意味着“不对”。给 Claude 定下清晰、死板、不容含糊的成功标准会有帮助。有个项目里,它对自己的证明很得意,只是“有一个未证明的引理”。那个引理就是整个证明!我说不许有未证明的引理。然后它又说“完成了”,只是这次多了一条新公理。
- 一切都自己看。我总是要求看图。即便我设了那么多监控,自动检查仍然不可信。对“吻合良好”这类定性说法要警惕。
- 质疑结论。Claude 擅长做计算,但它得出的结论可能是错的。让它解释自己发现了什么,直到 你 信服为止。
- 品味得你来提供。Claude 能找出 Claude 式的问题,但这样的问题有成千上万,甚至上百万个。Claude 似乎偏爱那些老掉牙的争论——引用很多,却早已被遗忘。让它关注什么是 新近才可能做到的,而不是什么只是更快或数字更多,会有帮助,但它判断一件事是否有趣,你仍然不能信。
- 继续追问。一旦 Claude 有了好结果,就要求更好的。它总能想出点什么,偶尔还真挺精彩。
- 当心硬啃。说实话,我从没成功让 Claude 把时间估准。于是我改为自己培养一种感觉:一件有意思的事大概该花多久,并学会判断 Claude 是否在我认为合理的时间尺度上取得进展。你要是不管,模型会一直硬啃下去。
另外值得一提的是,这些项目对算力和 token 的消耗都很大。对我来说,一部分开销来自我试图构建能超越单个项目、具有通用价值的工具:把不同领域连接起来,并打包成别人可以直接上手使用的形式。我希望 BootLoops harness 能被广泛用于定量科学的各个方向,而不必让每个用户都从头重建一切。Agentic AI 让连接想法、共享代码库变得更容易;如果我们学会利用这一优势,整个社区的前进速度可以超过任何单打独斗的个人。
展望
无论模型变得多聪明,科学进步大多仍来自真实世界的数据——这些数据必须被获取、理解、核验,而每一轮的结果又会引出下一个问题。AI 可以置身于这个循环之中,这确实很有价值,但它并不会把循环压缩成一个点。理解是一层层累积起来的,每一层都建立在前一层之上;癌症的治愈方法或聚变反应堆也会以这种方式到来,而不是来自某一次提示。
对 Millennium Prize Problems 和 Big Science 的聚焦,也许正如 Claude 喜欢说的那样,是一把“footgun”:一种让人很容易搬起石头砸自己脚的特性。这里的风险在于,不切实际的期望可能会打击那些本已可行的、有产出的用法。真正的进展大概率仍会以它一贯的方式到来:夯实科学研究的基础,并在其上构建越来越复杂的应用。这一进程会被大幅加速——正如我所描述的工作所展示的那样——但我看不到任何证据或必要去重新审视科学方法本身。
讨论 AI 科学时,有时会用到我喜欢的一个术语:凸包(convex hull)。取一个形状,把它的每一对点都用直线连起来,得到的新形状就是包含原形状的最小凸形状,即它的凸包。今天的科学非常割裂:到处都是参差不齐的前沿。生物学朝一个方向探出,数学朝另一个方向探出。一个实验室可能花 20 年,用一套他们已经精通的方法把某一组基因研究透彻,而邻近的基因和其他方法却无人问津。像 BootLoops 这样的 harness 可以把这些点连接起来,把凸包填满。
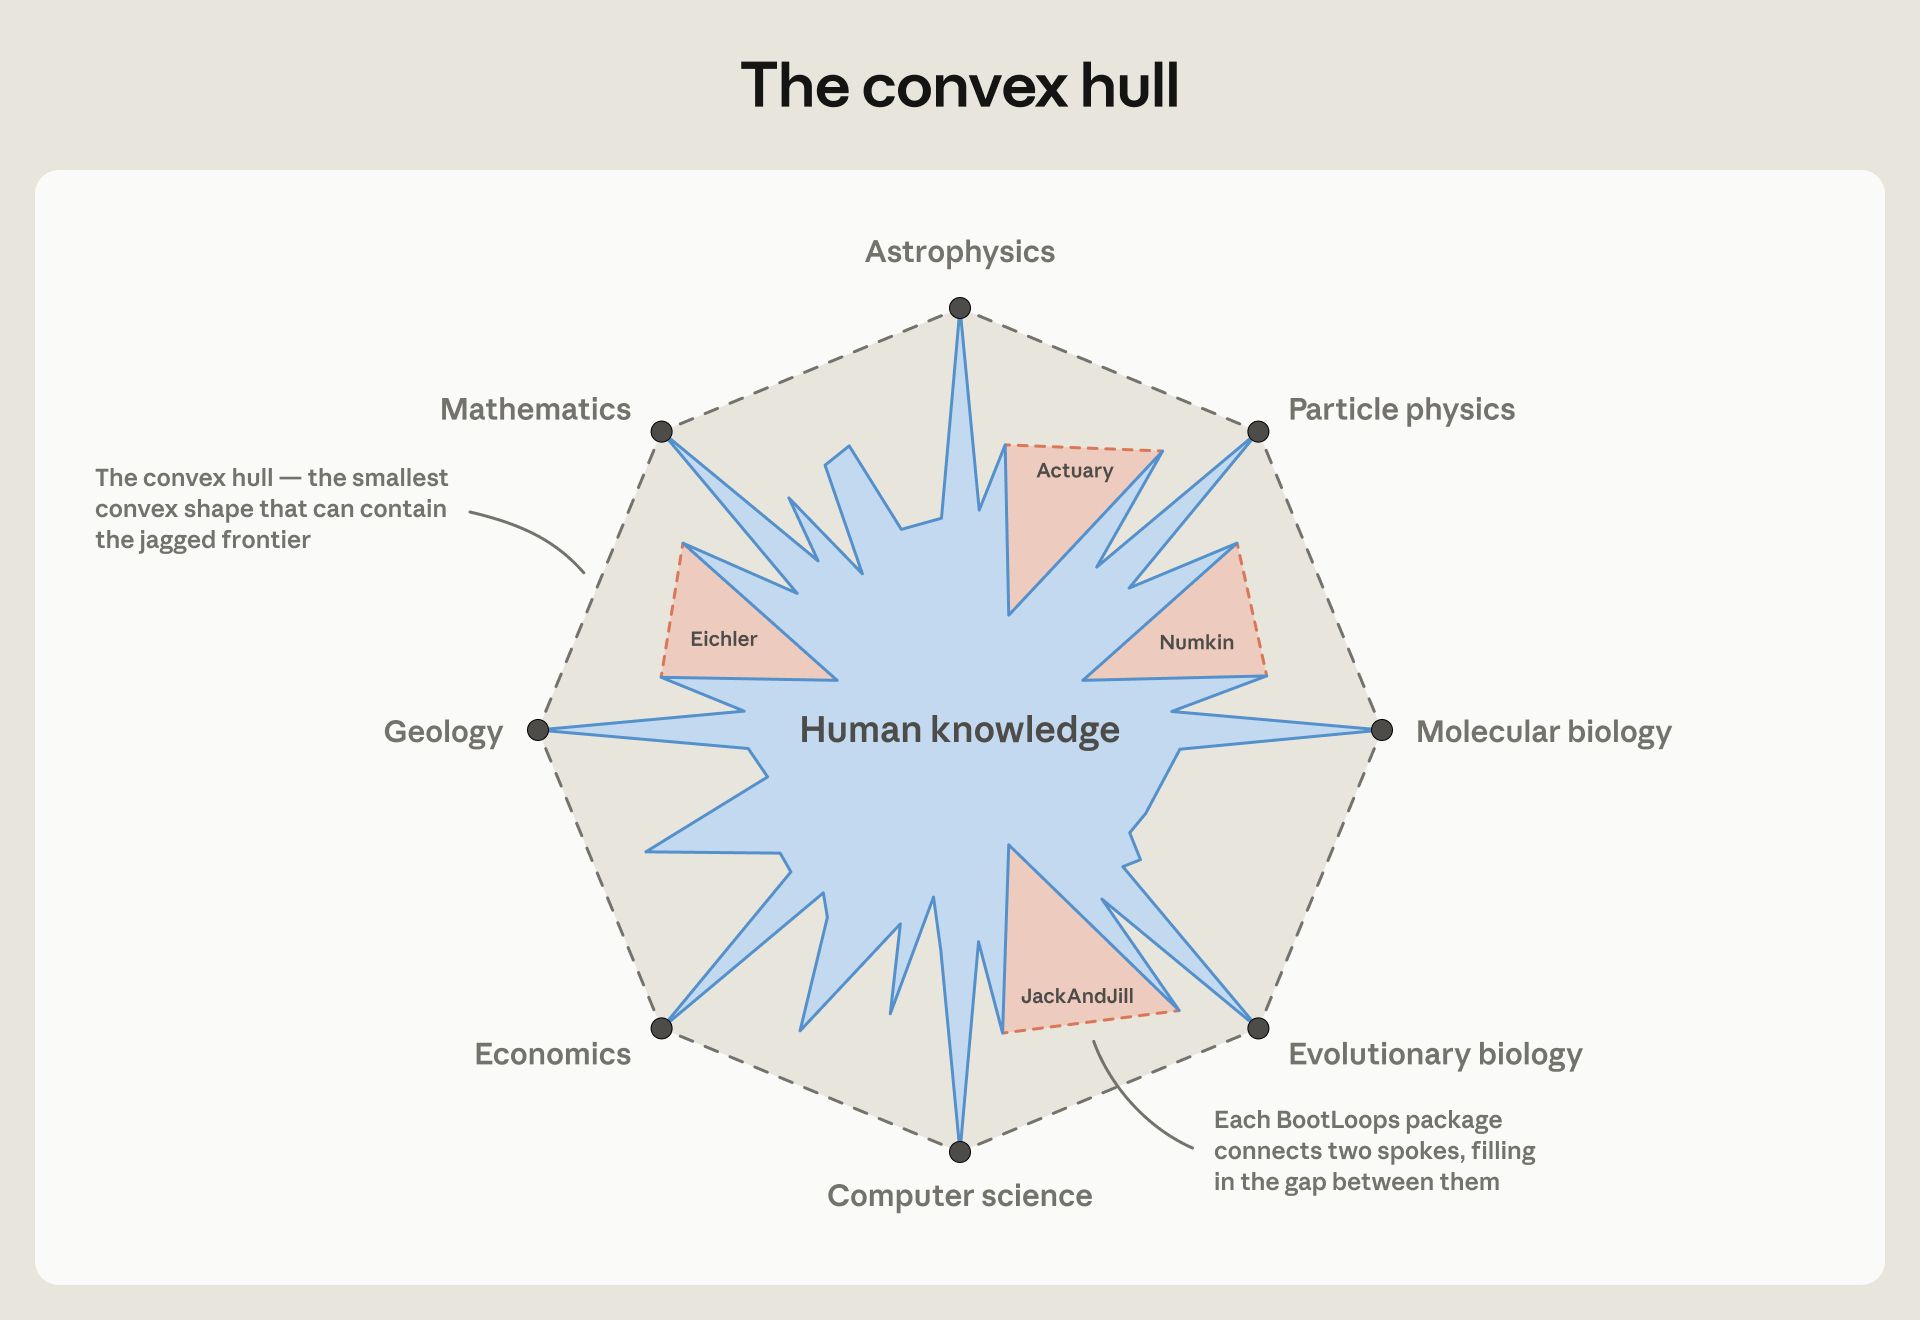
今天的人类知识是参差不齐的——特定的科学家和子领域在某些方向上把知识推进得更远,另一些方向则不然。中间区域是人类能够到达、却没有哪个具体的人抵达过的地方,正是 AI 的理想用武之地。BootLoops 包中的 ACTUARY、NUMKIN 等具体软件包,有助于填补这些空隙。
变化来得很快,几乎没法提前规划。为一个 AI 模型可能一夜之间就能解决的问题去申请三年经费,图什么?我到现在也不知道该怎么培养研究生。自从发表那篇关于 vibe physics 的文章以来,这种感觉只增不减。在计算机科学这样的领域,冲击简直令人心惊。两年前,我会把“工程师 Python”列为必修课。今天,它已经没必要了。我在机器学习上花过大量时间,建模研究各种物理现象。如今这些模型 AI 都能建,连神经网络的门道也学之无用了。直接让 Claude 去找最前沿的 ML 方法,它就会替你做完。
我认为 BootLoops 说明了一点:只要找对问题,解题过程中大部分技术性工作如今都可以自动化。某种意义上,这是一种解放。但概念性的部分仍然需要人。正因如此,我希望我们能想出办法,让人类即便在 Claude 形态的科学中也得到应有的认可。有意思的是,AI 有可能把惯常的商业模式颠倒过来——原本是站在顶端的人拿功劳,亲手解决问题的人什么也得不到。这件事最终怎么收场我不知道,但靠假装人类的贡献就是敲键盘,是收不了场的。
那么 Joe Scientist 该何去何从?要我说,其实处境很好。如今我们手边的工具,能以闪电般的速度推进那些看似无解的问题。我可以预见,像系统生物学这样数据丰富而理论贫瘠的领域,即将迎来巨大增长。我也很容易想象,人的头脑从繁琐的计算和分析中解放出来,去做更高层次的智力工作——定方向、给指引。最重要的是,我期待科学家走出自己的地盘,去寻找协同与合作,就像我在 BootLoops 中所做的那样。专注于 Claude 形态的科学,最令人耳目一新的结果是:它帮我们看清了人类形态的科学是什么样子。
关于 BootLoops 测试框架及其所支撑的科研成果,详见 www.bootloops.ai。BootLoops 测试框架已在 GitHub 上发布,供任何人使用和贡献。
致谢
如果没有以下同仁的指导与协作,我用 Claude 和 BootLoops 做出的科研成果绝不会如此有趣:Isaiah Andrews、Nima Arkani-Hamed、Michael Desai、Scott Edwards、Noam Elkies、Cecilia Garraffo、Matthew Gordon、Thomas Grimm、Martin Hemberg、Mikhail Ivanov、David Johnston、Gary King、Paul Lewis、Brendan Meade、Amara McCune、Joe Pater、Subhabrata Sen、Siddharth Mishra-Sharma、James O’Dwyer、Kevin Ryan、Jesse Shapiro 和 Xiaoyuan Zhang。
利益披露
在本项目期间,Schwartz 在 Anthropic 担任访问研究员。BootLoops 并非 Anthropic 的项目,它由 Matthew Schwartz 拥有和维护。