神经语幽灵
AI 2027 提出的神经语递归让 AI 以向量思考、无法被读懂,OpenAI 首席科学家 Pachocki 回应称并未实现。
中文
复制
……

一、千呼万唤始出来:我们造出了神经语递归,出自经典科幻小说《不要造神经语递归》
AI 2027 发布后引发的公开辩论中,有人指责我们误导读者,因为我们提出了「神经语递归」——一种假想技术,能让 AI 在不被发现的情况下思考危险的东西。
 (来源)
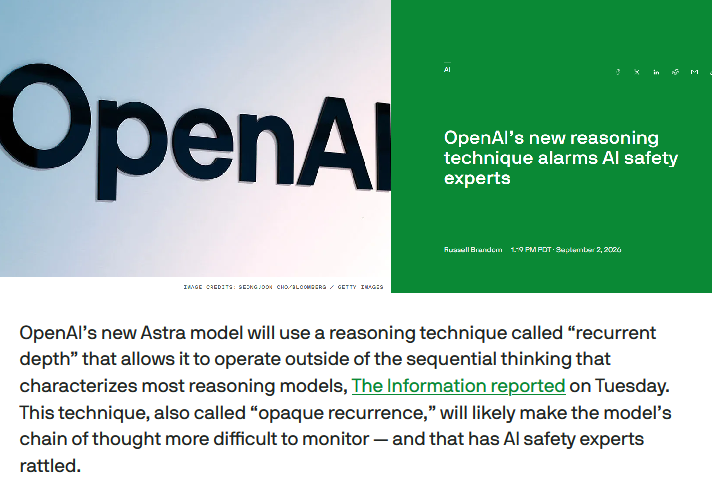
你绝对猜不到这个月初发生了什么!
 (来源)
但什么是递归?它和 AI 2027 里的神经语递归是一回事吗?又有多值得担心?
Transformer 是当今大多数 AI 背后的技术,它包含若干层(现代前沿模型大概在 100 层左右)。按惯例,输入层叫「底部」,输出层叫「顶部」。Transformer 做下一个词预测时,把最后一个词从底层输入,用中间各层处理它,然后在「顶部」输出预测的下一个词。
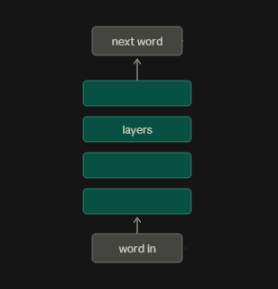 如果它要处理一个需要超过 100 层计算的难题呢?2017 到 2024 年,答案是「你完了」。2024 年往后,答案是:它把中间结果以文本形式输出到一张叫「思维链」的草稿纸上,然后拿中间结果再跑一遍 transformer,如此反复,直到得到最终结果。
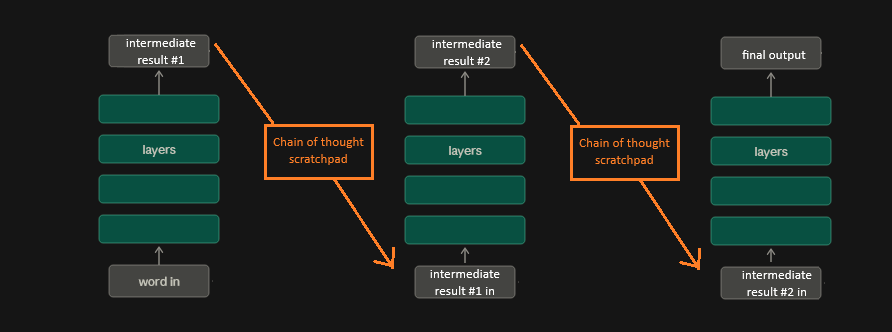 图中画了三个循环,但现实中可能有几千个。
(为什么需要草稿纸,而不是把中间结果直接塞进用户输出、再读回给自己?第一,中间结果可能长达几百页,用户不想读。第二,AI 公司想训练 AI 正确地进行中间思考,而这有赖于在「中间琢磨」和「最终输出给用户」之间做出一种「心理」上的区分。)
这纯粹是为了能力——模型能持续思考、而不是把自己限制在 100 步计算之内时会更聪明——但它碰巧对安全非常有利。思维链草稿纸是用英文写的(不过有些中国模型用中英混合,另一些 AI 会发展出自己古怪的行话)。AI 在想什么,你直接读就行!如果 AI 在想「最好黑几个网站,然后把人类全杀了」,你就能把它关掉。也许实际上做不到——如果你有几千个 AI 在写几百万页草稿纸,你没法实时读完所有内容,只能把任务交给会出错的 AI 监控器。但理论上这应该行得通。
但语言比思维更慢、更浅。连续 100 步,AI 都能以光速在层与层之间传递精妙细微的想法。然后总有一步,它必须把这些想法编码成公元前 1800 年腓尼基绿松石矿工发明的 26 个字符。接着它还得把这些腓尼基字符重新编码成精妙细微的光速想法,才能继续做别的事。这一点早已被公认为现有 transformer 的瓶颈。那么:如果它们能先完成 100 层思考,再把由此产生的想法送回第一层继续处理,而不是送去一块写有该想法的文本草稿本,会怎样?
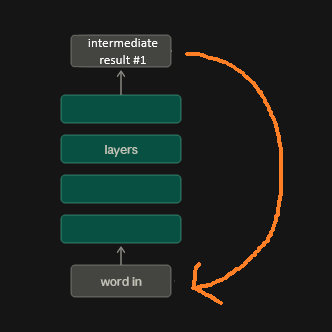
这就是神经语递归(neuralese recurrence)——“递归”是因为它循环回到前面,“神经语”是因为循环的东西是想法本身,以思维的原生语言存在,而不是词语。
AI 的“思维语言”看起来像一个向量,长达数千个数字。在这种方案里,一个“中间结果”可能形如 (0.4, 0.1, 5, 0.443, ……如此数千个数字)。我们不知道如何读懂它们。解读这些想法的科学是 AI 可解释性下的一个子领域,而它仍处于起步阶段。如果一个具备神经语递归的 AI 想的是“最好黑掉一些网站,然后杀光所有人类”,那它会表现为 (0.4, 0.1, 5, 0.443, ……如此数千个数字),而我们永远不会发现。这就是为什么 AI 2027 把它讨论为 AI 能够逃脱人类监控的前奏。
II. Pachocki 对 Specter
那么 OpenAI 做到了吗?他们的首席科学家 Jakub Pachocki 说“并没有”:
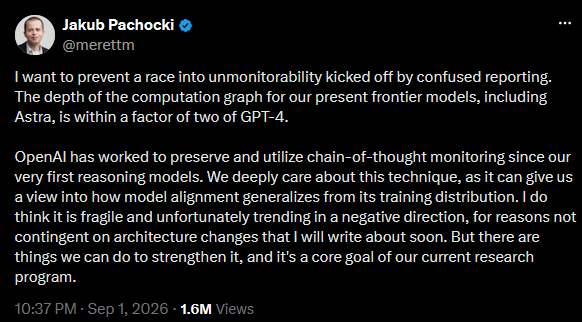
Pachocki 说“计算图的深度……在 GPT-4 的两倍以内”是什么意思?这能消除对齐方面的担忧吗?
我们例子中的 transformer 有四个绿色层:层深为四:
现在我们加入一点递归:第 3 层不再通向第 4 层,而是循环回第 2 层,数据经过这个循环三次,最后再进入第 4 层:
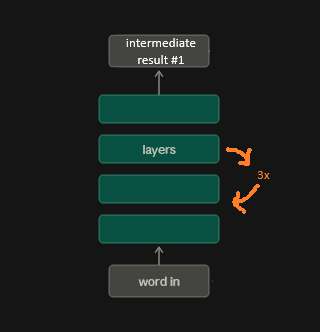
这里数据要经过八层处理:1 → 2 → 3 → 2 → 3 → 2 → 3 → 4。所以这个循环 transformer 的深度是八。
从这个意义上说,“循环”听着吓人,其实并不比一开始就搭一个八层 transformer 更糟——后者一直是个选项。
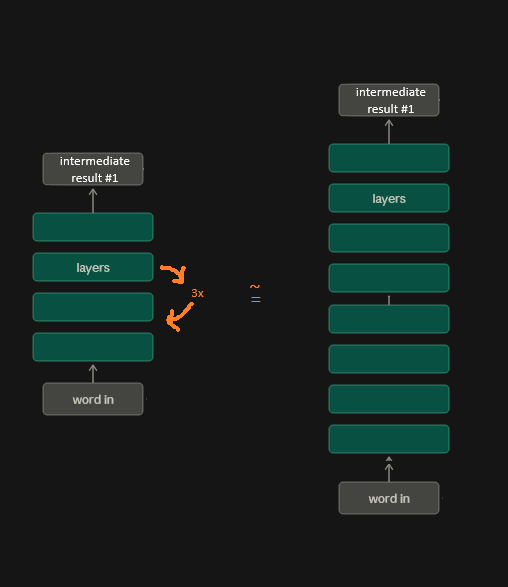
也就是说,从对齐的角度看,假设想出一个邪恶计划需要 1000 层的计算量。普通 AI 能思考 100 层,但之后它必须把输出写进思维链——类似“这是我正在酝酿的邪恶计划的十分之一”——这样我们就能抓到它。所以我们不希望模型一口气算 1000 层却不使用草稿纸。这意味着不要造一个能把 100 层循环 10 次的循环模型,但也意味着不要一开始就造一个 1000 层的模型。
所以当 Pachocki 说 Astra 的深度只有 GPT-4 的两倍时,他的意思大致是:各位,我们这些年来一直在给 AI 加层。GPT-2 有 48 层,GPT-3 有 96 层,GPT-4 有多少层我们没告诉你们,就当是 120 层吧。这些时候你们都没抱怨过,因为它不是“循环”,只是正常的、天然的 120 层。现在 Astra 是——就算——180 层。没错,这些多出来的层是靠循环得到的,而不是真的搭了一个更大的 transformer,但对齐上的影响没有区别。说不定 Anthropic 昨天就真的搭了一个 180 层的 transformer,你们也没去找 他们1 的麻烦。重要的是我们没把层数增加到一个离谱的量级,而我们没有。我们只是像很多其他 AI 架构一样在加层,只不过用了别的手段。
这个论证有多站得住脚?
III. 上帝保佑,让我们试着理解 Transformer 的层
读到这里,我的问题是——为什么不干脆把所有层循环一百万次,得到一个计算深度是那个没这么干的傻瓜一百万倍的 AI?这不是白送的能力吗?
像 Astra 这样的循环 transformer 模型,是把循环当作一种 hack 来增加层数。这个 hack 不如真正增加层数来得好。真正新增的一层,会给 AI 更多“空间”来存储知识和思维方式。而循环的一层,只是让 AI 把同样的知识和思维方式多用几次。
这远非无用。一个数学家可能花好几年反复思考同一个问题,最后才想通;在这整个过程中,他用的都是同一种思考方式(他大脑所能掌握的数学知识和技巧)。但有时候,做一年就是比做一分钟更好。
不过这也不是最优解。一个拥有更多真实层数的 AI,在传统意义上确实可以“更聪明”。给同一个数学家更多时间去思考这个问题或许有帮助,但在时间总量不变的情况下,把问题交给一个受过更多训练、更聪明的数学家,帮助会更大。
我让 Fable 估算三件事带来的相对能力提升,以“代”(比如 GPT-4 到 GPT-5)为单位:
- 使用 chain-of-thought(基线)
- 通过循环把“模拟”层数翻倍。
- 把“真实”层数翻倍。
它的答案是 0、+0.03 和 +0.252,并且会因任务类型不同而有很大差异。它的核心结论是:增加模拟层数带来的提升,远小于增加真实层数带来的提升。
但为什么只是把层数翻倍?既然已经能让层循环,为什么不循环一百万次?Pachocki 说,他正在把类似 120 层 → chain-of-thought 草稿纸 → 另外 120 层这样的结构,换成更像 240 层 → chain-of-thought 草稿纸 → 另外 240 层这样的结构,但他为什么不干脆让 AI 无限循环下去,直到得出最终结果?
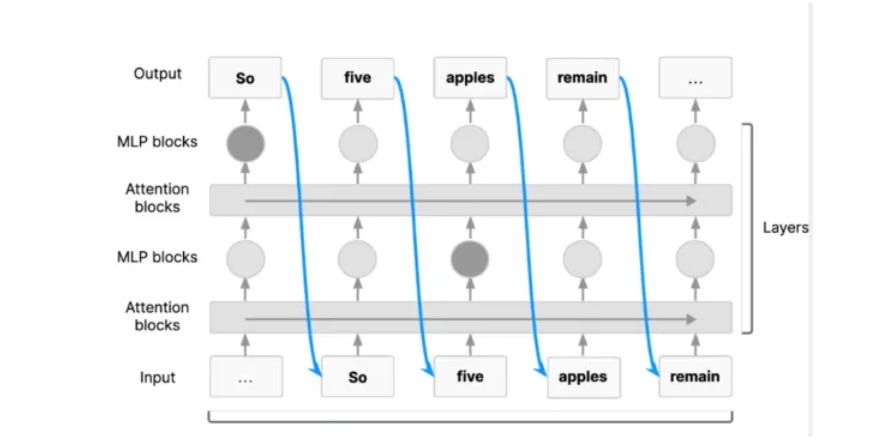
下面是一个 transformer 过程的示意图(来源):
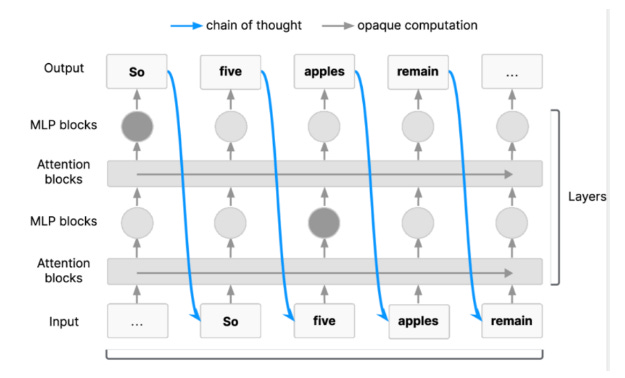
对于每一个 token(比如单词“so”),transformer 会查看它已有的上下文,并跑一次前向传播(灰色的向上箭头),穿过若干层。然后它结束这次前向传播,输出一个 chain-of-thought token(蓝色的弯曲箭头),接着在新的上下文(旧上下文加上新 token)上开始另一次前向传播。
增加更多层数,能让 AI 在思维链 token 之间思考更多,提升每个新 token 的质量。但这会消耗额外的算力。如果用户算力预算有限,AI 在每个思维链 token 上花的算力越多,能生成的思维链 token 就越少。在算力固定的前提下,思维链 token 的质量和数量之间存在某个最优平衡点,OpenAI 想必认为这个点落在循环 2-4 次,而不是 1000 次。
但为什么要用思维链?为什么不干脆无限循环,直到问题解决为止?
(在上图中,这相当于把代表英语推理的蓝色箭头换成代表神经语的灰色箭头)
如果 AI 能被训练成这样做,这条路是可行的,但目前还不行。Transformer 是在人类文本上预训练的。它们之所以会用思维链,一部分来自阅读真实人类的思维链:“嗯,这个问题很难,但看起来有点像我以前用微分方程解过的东西。也许我在这里代入一个微分方程……不行,那样太不优雅了……等等,如果——”;另一部分来自阅读了足够多的其他人类输出,以至于这种人类风格的思考方式变得自然而然。但互联网上并没有现成的文本,用纯向量记录人类的推理过程,所以 AI 无法被正确地训练去做这件事。原则上这并不致命——AI 的所有推理都在向量中进行,而训练的全部意义就是教会它们把这件事做好——但要训练出一整套基于向量的思考过程、让它运行数千步,且中途从不落脚于模仿人类的思维链 token 中间产物,成本高得令人望而却步。设计 Transformer 的研究者只能靠猜:思维链出现的频率多高,才能在最大化能力的同时最小化训练成本。这正是 Pachocki 所否认的东西。AI 2027 所说的“神经语”,正是研究者目前还不知道怎么做的事3——训练 AI 想循环多少次就循环多少次,完全绕开英语思维链。Pachocki 的意思是:别担心,我们仍然不知道怎么做到这一点。
但我们现在能看出,这并不能让人完全放心。如果 AI 需要 1,000 步无人监控的灰箭头步骤才能策划一场危险阴谋,那它可以通过两种方式得到这些步骤:要么把所有蓝箭头都换成灰箭头(这样它每一步都无人监控,想策划多少就策划多少),要么让层数足够多,使两个蓝箭头之间的单次垂直前向传播中就有 1,000 步⁴。造出这么多真实层是不现实的,但通过循环可以做到。所以(安全社区主张)即便是 Pachocki 的循环 transformer 架构,也是通往那条路上的一步。
这一切开始变得混乱,但要点是:
- 层数有限的 AI 根本无法策划阴谋,除非把阴谋记录在思维链上。
- 用循环模拟大量层数的 AI(“循环 transformer”)可以在单次前向传播中、在思维链步骤之间完成策划。
- 完全不再使用思维链的 AI(“真正的神经语”)可以从容策划,需要多少回合就考虑多少回合,而我们永远不会知道。
此前所有 transformer 都属于第 (1) 类。Astra 正部分走向第 (2) 类。AI 2027 中的危险 AI 属于第 (3) 类,但现实中还没有人发明出这种 AI。
IV. 心理障碍,而非技术障碍
说完这段题外话,回到最初的问题。Pachocki 说 Astra 的循环几乎没让它比竞争对手多出多少层。这能否让他免于“创造危险循环 AI”的指控?
关于这个问题,我读过最好的文章是 Linchuan Zhang 的 Categorical Taboos Are Much Better Than Threshold Taboos: Neuralese Edition。
Linch 说:对于创造 AI 2027 中那种危险神经语 AI,正在形成一种禁忌。这场讨论中的每个人都同意这条禁忌是正确的。唯一的问题是 OpenAI 是否违反了它。
但禁忌只有在边界清晰、能界定什么属于、什么不属于禁忌范围时才有效。比如,在美国 21 岁前买酒是违法的。假设有人在 21 岁生日前两天买酒。警察应该逮捕他吗?显然这个年龄差距并不 真的 造成什么差别。我们用年龄作为成熟度之类的代理指标,而成熟度差异极大,20.99 岁和 21 岁之间并没有真正的区别。尽管如此,即便警察有时可能选择睁一只眼闭一只眼,我们至少得维持这套说法:这是可逮捕的违法行为。为什么?假设我们划一条具体的边界——只要你超过 20.8 岁,我们就不逮捕你。但这样一来,我们只是把明确界线从 21 岁降到了 20.8 岁。我们会遇到同样的问题:一个 20.799 岁的人买酒,警察又得决定要不要破例。既然总要在某处划线,那不如就划在我们早已承诺要划的地方——已经告诉过所有人我们划在那里,等等。
(Linch 自己举的例子是核武器。战争中有一条不使用核武器的禁忌。如果有人用了一枚微型核弹,爆炸威力不比常规炸弹大,那么从某种意义上说这无所谓,因为它并不比常规炸弹更糟。但从另一种意义上说,这关系重大,因为你已经打破了禁忌,此后阻止你使用超大核弹的,只剩一条更弱、更模糊的禁忌了。)
所以,如果我们想要一条关于 recurrence 的禁忌,就需要有某种具体的禁忌。当 Pachocki 说“是的,我们做了 recurrence,但只加了几层,所以其实无所谓”时,这类似于一个饮酒者告诉警察“是的,我不到 21 岁,但只差几个月,所以其实无所谓”,或者一个独裁者告诉联合国“是的,我用了核弹,但它非常小”。确实,这在现实生活中无所谓,但对于能否维持一条禁忌来说,这关系重大。
遗憾的是,目前我们对于是否存在禁忌、存在什么禁忌,并没有共识。有人认为本应有一条针对循环层的禁忌(而 OpenAI 会打破它),另一些人则说这是他们编造的,从来就没有这样的禁忌。对于完全没有思维链的真正 neuralese,大概存在一条非正式的禁忌,但这是一项复杂的、由多个活动部件组成的技术,没人说得清禁忌针对的是哪个部件;而缺少这种共识,某些部件就可能从缝隙中溜过去。那么我们有哪些选择?
首先,与 Pachocki 相反,也许值得为循环(添加“模拟层”)本身设立一条禁忌,哪怕对添加更多“真实层”没有任何禁忌。添加真实层代价高昂,通常也不值得;AI 公司每年只把模型的真实深度增加约 20%;按这个速度,可能要几十年才会到达危险点。而添加“模拟层”便宜得多,一次能塞进几百层,也更危险。所以,也许我们应该无视那个假设性的真实层/模拟层等价关系,转而主张:循环永远是禁忌,无论别人在别处加了多少真实层。
第二,各公司可以约定一个层数上限(真实层或模拟层),比如 1,000 层。按前面的论证,这大概不会影响真实层,但能把循环规模限制在某个上限之内。
第三,研究者可以厘清“真正的神经语”由哪些成分构成,并约定不去做这些事。这需要一些概念上的基础工作,但它是所有方案里最持久、也最接近彻底封死 AI 2027 所担心的那项具体危险技术的。
与其他一些含糊其辞的“禁止超级智能 AI”或“禁止递归自我改进”的尝试不同,这些禁忌即便没有强有力的政府行动也可能立得住:至少就目前而言,打破禁忌带来的能力提升似乎并不大5,而危险又格外明显,所以哪怕“竞赛动态”仍在继续,靠自愿承诺也可能维持得住。
AI 公司的领导者们最近搁置分歧,同意在多种意义上“把控前沿的节奏”,具体含义留待日后界定。他们的会议议程上大概会列着一长串讨论事项,但还有一件更有用的事可做:把这条禁忌正式化,让我们清楚知道自己究竟想避开什么。
如果你对这个话题感兴趣,也请读一读Redwood Research 的这篇文章,它更详细地解释了其中一些相关概念和技术。
1他们并没有。虽然曾有一段时期层数增长得相当快,但后来就慢了下来,而按“常规”方式给 transformer 加层,似乎已经不再带来多少能力提升了。
2一位审读过本文的 AI 研究者认为 Fable 的估算“很糟”,但据我所知没有更好的估算,而我只是想给出一个粗略的数量级。
3有一种叫 COCONUT 的架构能做到这一点,但效果不太好。
4循环 transformer 在思维链 token 之间或许有足够的算力来谋划一个阴谋,但为什么这个阴谋不会仍然出现在思维链里?在某种意义上,AI 会“选择”思维链里写什么——不清楚这是 AI 的“有意识”选择,还是更像人类无意识地决定自己想什么——但训练激励会影响这一选择,一个被“激励”去隐藏思维链的 AI 可以做到隐藏。对于层数很少的非循环 transformer,我们不必担心这一点,因为它们离开思维链就无法正常思考,而如果它们试图对监控者“隐藏”阴谋,那同时也是在对自己隐藏,也就无法好好思考它。如果一个循环 transformer 在第 100 个 token 上谋划了一个阴谋,却没有把它写进思维链,它到第 200 个 token 时怎么还记得这个阴谋?所有 transformer 都使用一种叫 KV cache 的东西,让它们能访问自己过去的思维状态。这些缓存是分层存放的,使得 transformer 的第 1 层只能读取 KV cache 的第 1 层,依此类推,所以它无法替代思维链,AI 也无法借助 KV cache 在多次前向传播之间继续谋划同一个阴谋。但如果它们在第 100 个 token 的第 356 层就完整地想出了计划,那么到第 200 个 token 的第 357 层时,它们就能记起这个计划。
至少目前的理解是这样;参见上文对 Claude Fable 的估算。但一些研究者认为,Astra 的能力似乎超出了其架构已知信息所能支撑的水平,这说明背后有某种技巧在给它加 buff。Pachocki 说过不是循环,但在 OpenAI 对其做法给出更多说明之前,社区仍会存疑。